SIOS SANless clusters

SIOS SANless clusters High-availability Machine Learning monitoring

  • Home
  • Products
    • SIOS DataKeeper for Windows
    • SIOS Protection Suite for Linux
  • การทดสอบอาหารสัตว์
  • ข่าวสารและกิจกรรม
  • ทำให้เข้าใจง่ายเซิร์ฟเวอร์คลัสเตอร์
  • เรื่องราวความสำเร็จ
  • ติดต่อเรา
  • English
  • 中文 (中国)
  • 中文 (台灣)
  • 한국어
  • Bahasa Indonesia
  • ไทย

แอพพลิเคชั่นความพร้อมใช้งานสูงสำหรับการดำเนินธุรกิจ – บทสัมภาษณ์

กุมภาพันธ์ 1, 2019 by Jason Aw Leave a Comment

เกี่ยวกับแอปพลิเคชั่นที่มีความพร้อมใช้งานสูงสำหรับการดำเนินธุรกิจ – สัมภาษณ์กับ Jerry Melnick

เรากำลังสนทนากับ Jerry Melnick ประธานและซีอีโอของ SIOS Technology Corp. Jerry รับผิดชอบในการกำกับดูแลกลยุทธ์ขององค์กรโดยรวมสำหรับ SIOS Technology Corp. และเป็นผู้นำการเติบโตและการขยายตัวของ บริษัท เขามีประสบการณ์มากกว่า 25 ปีในตลาดองค์กรและตลาดซอฟต์แวร์ที่มีความพร้อมใช้งานสูง ก่อนที่จะร่วมงานกับ SIOS เขาเคยดำรงตำแหน่ง CTO ที่ Marathon Technologies ซึ่งเป็นผู้นำด้านกลยุทธ์ทางธุรกิจและผลิตภัณฑ์สำหรับโซลูชันการยอมรับข้อบกพร่องของ บริษัท ประสบการณ์ของเขายังรวมถึงตำแหน่งผู้บริหารที่ PPGx, Inc. และ Belmont Research เขามีหน้าที่รับผิดชอบในการสร้างผลิตภัณฑ์ซอฟต์แวร์ที่ทันสมัยและธุรกิจให้คำปรึกษาที่มุ่งเน้นการจัดหาคลังข้อมูลและเครื่องมือวิเคราะห์ เจอร์รี่เริ่มอาชีพของเขาที่ Digital Equipment Corporation เขานำหน่วยธุรกิจผู้ประกอบการที่นำเสนอแพลตฟอร์มฐานข้อมูลที่มีความสำคัญต่อการปรับขนาดได้สูงเพื่อรองรับสภาพแวดล้อมการประมวลผลระดับองค์กรในตลาดการแพทย์การเงินและโทรคมนาคม เขาสำเร็จการศึกษาระดับปริญญาตรีด้านวิทยาศาสตร์จากวิทยาลัยเบลัวต์จบการศึกษาระดับปริญญาตรีสาขาวิศวกรรมคอมพิวเตอร์และวิทยาศาสตร์คอมพิวเตอร์ที่มหาวิทยาลัยบอสตัน

การสำรวจเทคโนโลยี SIOS คืออะไรและวัตถุประสงค์ของการสำรวจคืออะไร?

SIOS Technology Corp. พร้อม ActualTech Media ได้ทำการสำรวจพนักงานไอทีเพื่อทำความเข้าใจแนวโน้มและความท้าทายในปัจจุบันที่เกี่ยวข้องกับสถานะทั่วไปของแอพพลิเคชั่นที่มีความพร้อมใช้งานสูงในองค์กรทุกขนาด โดยทั่วไปแล้วแอปพลิเคชัน HA ขององค์กรจะเป็นแอปพลิเคชั่นที่รับรองว่าธุรกิจยังคงเปิดดำเนินการอยู่ ระบบดังกล่าวมีตั้งแต่การสั่งซื้อระบบไปจนถึงฐานข้อมูล CRM ไปจนถึงสิ่งที่ทำให้พนักงานลูกค้าและคู่ค้าทำงานร่วมกัน เราได้เรียนรู้ว่าข่าวนี้มีความหลากหลายเมื่อพูดถึงว่าแอพพลิเคชั่นรองรับความพร้อมใช้งานสูงมากเพียงใด

ใครตอบการสำรวจ?

สำหรับการสำรวจครั้งนี้เราได้รวบรวมคำตอบจากผู้เชี่ยวชาญด้านไอทีและผู้มีอำนาจตัดสินใจจำนวน 390 คนจากหลากหลาย บริษัท ในสหรัฐอเมริกา ผู้ตอบแบบสอบถามจัดการฐานข้อมูลโครงสร้างพื้นฐานสถาปัตยกรรมระบบและการพัฒนาซอฟต์แวร์รวมถึงบทบาทด้านการจัดการด้านไอที

อะไรคือการค้นพบที่สำคัญที่ค้นพบในผลการสำรวจ?

ต่อไปนี้เป็นข้อค้นพบที่สำคัญจากผลการสำรวจ:

  • องค์กรส่วนใหญ่ (86%) แต่ไม่ใช่ทุกองค์กรกำลังใช้งานแอพพลิเคชั่น HA ด้วยการจัดกลุ่มหรือกลไกความพร้อมใช้งานสูง
  • ผู้ตอบแบบสอบถาม 95% เต็มรายงานว่าพวกเขามีความล้มเหลวเป็นครั้งคราวในบริการ HA พื้นฐานที่สนับสนุนการใช้งานของพวกเขา
  • เก้าสิบแปด (98%) ของผู้ตอบแบบสำรวจของเราระบุว่าพวกเขาเห็นปัญหาประสิทธิภาพการใช้งานปกติหรือเป็นครั้งคราว
  • เมื่อปัญหาดังกล่าวเกิดขึ้นสำหรับองค์กรส่วนใหญ่จะใช้เวลาระหว่างสามถึงห้าชั่วโมงในการระบุสาเหตุและแก้ไขปัญหาและใช้เวลาระหว่างสองถึงสี่เครื่องมือในการทำเช่นนั้น
  • บริษัท ขนาดเล็กกำลังเป็นผู้นำในการใช้งานแอพพลิเคชั่น HA ของพวกเขาในคลาวด์ บริษัท ขนาดเล็กมากกว่าครึ่ง (54%) ตั้งใจที่จะเรียกใช้แอปพลิเคชัน HA ของพวกเขา 50% ขึ้นไปในระบบคลาวด์ภายในสิ้นปี 2018
  • สำหรับ บริษัท ทุกขนาดการควบคุมสภาพแวดล้อมของแอปพลิเคชันยังคงเป็นเหตุผลสำคัญที่ทำให้ปริมาณงานยังคงอยู่ในสถานที่ 60% ของผู้ตอบแบบสอบถามระบุว่าสิ่งนี้มีบทบาทในการรักษาแอปพลิเคชัน HA อย่างน้อยหนึ่งแอปในสถานที่แทนที่จะย้ายแอปพลิเคชันไปยังคลาวด์

บอกให้เราทราบเกี่ยวกับ Enterprise Application Landscape แอปพลิเคชันใดที่มีการใช้งานมากที่สุด และสิ่งที่เราอาจจะประหลาดใจเกี่ยวกับ?

เรามุ่งเน้นไปที่แอปพลิเคชันที่สำคัญสำหรับภารกิจระดับ 1 ได้แก่ Oracle, Microsoft SQL Server, SAP / HANA สำหรับองค์กรส่วนใหญ่ที่ใช้บริการประเภทนี้เป็นส่วนสำคัญ พวกเขาเก็บข้อมูลที่ช่วยให้องค์กรบรรลุเป้าหมาย 56% ของผู้ตอบแบบสำรวจของเราปฏิบัติงานปริมาณงานของออราเคิลในขณะที่ 49% กำลังใช้งาน Microsoft SQL Server รอบการสำรวจ 28% มี SAP / HANA ในการผลิต ทั้งหมดนี้เป็นภาระงานที่สำคัญอย่างชัดเจนในองค์กรส่วนใหญ่ แต่ก็มีงานอื่น ๆ สำหรับการสำรวจครั้งนี้เราได้ให้โอกาสแก่ผู้ตอบแบบสอบถามในการบอกเราว่านอกเหนือจากแอปพลิเคชั่นขนาดใหญ่ทั้งสามนี้พวกเขากำลังปฏิบัติงานซึ่งถือได้ว่าเป็นภารกิจที่สำคัญยิ่ง ผู้ตอบแบบสอบถามที่ใช้ประโยชน์จากตัวเลือกการตอบสนองนี้บ่งชี้ว่าพวกเขายังดำเนินการฐานข้อมูลบนเว็บที่หลากหลายซึ่งส่วนใหญ่มาจาก Amazon รวมถึงฐานข้อมูล MySQL และ PostgresQL ในระดับที่น้อยกว่านั้นองค์กรต่างๆยังดำเนินงานบริการ NoSQL บางอย่างที่ถือว่าเป็นภารกิจที่สำคัญ

ปัญหาประสิทธิภาพของแอปพลิเคชันส่งผลกระทบต่อผู้ใช้บ่อยเพียงใด

ปัญหาประสิทธิภาพการทำงานของแอปพลิเคชั่นเป็นสิ่งสำคัญสำหรับองค์กร 98% ของผู้ตอบแบบสอบถามระบุว่าปัญหาเหล่านี้ส่งผลกระทบต่อผู้ใช้ในบางวิธีตั้งแต่ทุกวัน (มีประสบการณ์ 18% ของผู้ตอบแบบสอบถาม) เพียงหนึ่งครั้งต่อปี (ประสบการณ์ 8% ของผู้ตอบแบบสอบถาม) และทุกที่ในระหว่างนั้น ปัญหาประสิทธิภาพการทำงานของแอปพลิเคชันนำไปสู่ความไม่พอใจของลูกค้าและอาจนำไปสู่การสูญเสียรายได้และค่าใช้จ่ายที่เพิ่มขึ้น แต่ดูเหมือนจะมีความขัดแย้งในเรื่องดังกล่าวขึ้นอยู่กับมุมมองของคุณในองค์กร ผู้ตอบที่มีบทบาทในการตัดสินใจมีมุมมองเชิงบวกต่อสถานการณ์ด้านประสิทธิภาพมากกว่าคนอื่น ๆ มีผู้ตัดสินใจเพียง 11% เท่านั้นที่รายงานความท้าทายในการปฏิบัติงานประจำวันเมื่อเทียบกับผู้ตอบแบบสอบถามอื่นราว 20%

การแก้ไขปัญหาแอปพลิเคชั่นบนคลาวด์ง่ายขึ้นหรือไม่

ผู้เชี่ยวชาญด้านไอทีส่วนใหญ่ต้องการขจัดศักยภาพของปัญหาแอปพลิเคชั่นที่ทำงานในสภาพแวดล้อมคลาวด์อย่างสมบูรณ์ แต่ความจริงก็คือสถานการณ์ดังกล่าวสามารถและจะเกิดขึ้น มีเครื่องมือมากมายในตลาดเพื่อช่วยให้ฝ่ายไอทีเข้าใจและแก้ไขปัญหาเกี่ยวกับประสิทธิภาพของแอปพลิเคชัน ในช่วงหลายปีที่ผ่านมาแผนกไอทีได้ร่วมมือกับชุดเครื่องมือแก้ไขปัญหาร่วมกัน โดยทั่วไปเครื่องมือที่น้อยกว่าที่คุณต้องใช้ในการแก้ไขปัญหายิ่งคุณสามารถนำบริการกลับมาใช้งานได้อย่างรวดเร็วยิ่งขึ้น นั่นเป็นสาเหตุที่ทำให้รู้สึกท้อใจอย่างยิ่งที่ได้เรียนรู้ว่ามีเพียง 19% ของการตอบกลับที่เปลี่ยนเป็นเครื่องมือชิ้นเดียวเพื่อระบุปัญหาประสิทธิภาพแอปพลิเคชันคลาวด์ ทำให้ผู้ตอบแบบสอบถาม 81% ต้องใช้เครื่องมืออย่างน้อยสองเครื่องมือ แต่มันแย่ลงเรื่อย ๆ 11% ของผู้ตอบแบบสอบถามจำเป็นต้องหันไปใช้เครื่องมือห้าตัวขึ้นไปเพื่อระบุปัญหาด้านประสิทธิภาพด้วยแอปพลิเคชันคลาวด์

ดังนั้นตอนนี้เรารู้ว่าปัญหาประสิทธิภาพแอปพลิเคชันบนคลาวด์ไม่สามารถหลีกเลี่ยงได้ทั้งหมดนานแค่ไหนจนกว่าเราจะได้รับการแก้ไข

การทดสอบที่แท้จริงของความสามารถขององค์กรในการจัดการปัญหาดังกล่าวเกิดขึ้นเมื่อทำการวัดเวลาที่ใช้ในการกู้คืนเมื่อมีบางสิ่งผิดพลาด 23% ของผู้ตอบแบบสอบถามสามารถกู้คืนในเวลาน้อยกว่าหนึ่งชั่วโมง ร้อยละห้าสิบหก (56%) ของผู้ตอบแบบสอบถามใช้เวลาระหว่างหนึ่งถึงสามชั่วโมงในการกู้คืน หลังจากนั้น 23% ใช้เวลา 3 ชั่วโมงขึ้นไป นี่ไม่ได้หมายความว่าคนเหล่านี้จะฟื้นตัวจากความล้มเหลวทั้งหมด พวกเขากำลังตอบสนองต่อความผิดพลาดด้านประสิทธิภาพที่ใดที่หนึ่งในแอปพลิเคชัน และเป็นสิ่งที่ร้ายแรงพอที่จะรับประกันความสนใจ เป้าหมายสำหรับองค์กรส่วนใหญ่คือการลดระยะเวลาที่ใช้ในการแก้ไขปัญหา วิธีนี้จะลดระยะเวลาที่ใช้ในการแก้ไขให้ถูกต้อง

แผนการในอนาคตเกี่ยวกับการย้ายแอปพลิเคชั่น HA ไปยังคลาวด์นั้นแสดงให้เห็นถึงการโยกย้ายที่ดีขึ้นหรือไม่?

เราขอข้อมูลจากผู้ตอบแบบสอบถามเกี่ยวกับแผนการในอนาคตของพวกเขาเนื่องจากพวกเขาเกี่ยวข้องกับการย้ายแอปพลิเคชันที่มีความพร้อมใช้งานสูงไปยังระบบคลาวด์ ผู้ตอบแบบสอบถามร้อยละ 9 (9%) ระบุว่าแอปพลิเคชันที่สำคัญที่สุดทั้งหมดของพวกเขาอยู่ในระบบคลาวด์แล้ว ภายในสิ้นปี 2561 ผู้ตอบแบบสอบถามครึ่งหนึ่งคาดว่าจะมีแอพพลิเคชั่น HA มากกว่า 50% ที่ย้ายไปยังคลาวด์ ในขณะที่ 29% กล่าวว่าพวกเขาจะมีแอปพลิเคชัน HA น้อยกว่าครึ่งในสถานที่ดังกล่าว ในที่สุด 12% ของผู้ตอบแบบสอบถามกล่าวว่าพวกเขาจะไม่ย้ายแอปพลิเคชั่น HA ไปยังคลาวด์อีกต่อไปในปี 2018

คุณจะสรุปผลการสำรวจเทคโนโลยี SIOS ได้อย่างไร?

แม้ว่าการสำรวจและรายงานนี้แสดงถึงการคิดของผู้คนในเวลาเดียว แต่ก็มีแนวโน้มที่สำคัญที่เกิดขึ้น ขั้นแรกเป็นที่ชัดเจนว่าองค์กรให้ความสำคัญกับแอปพลิเคชันที่สำคัญต่อภารกิจเนื่องจากพวกเขาปกป้องพวกเขาผ่านการทำคลัสเตอร์หรือเทคโนโลยีความพร้อมใช้งานสูงอื่น ๆ ประเด็นที่สองคือแม้จะมีมาตรการป้องกัน แต่ก็ยังมีงานให้ทำอีกมากเนื่องจากแอปเหล่านั้นยังคงประสบกับความล้มเหลวและปัญหาด้านประสิทธิภาพ บริษัท จำเป็นต้องดูข้อมูลและถามตัวเอง ดังนั้นหากพวกเขาทำทุกอย่างพวกเขาสามารถทำได้เพื่อปกป้องทรัพย์สินที่สำคัญของพวกเขา คุณสามารถดาวน์โหลดรายงานได้ที่นี่ ติดต่อเราหากคุณต้องการเพลิดเพลินกับแอพพลิเคชั่นความพร้อมใช้งานสูงในโครงการ ทำซ้ำจากเป้าหมายด้านเทคนิค
Filed Under: ข่าวสารและกิจกรรม Tagged With: SIOS, แอพพลิเคชั่นที่มีประสิทธิภาพสูง

มั่นใจในความพร้อมใช้งานสูงสำหรับ SQL Server บน Amazon Web Services

มกราคม 30, 2019 by Jason Aw Leave a Comment

มั่นใจในความพร้อมใช้งานสูงสำหรับ SQL Server บน Amazon Web Services

ผู้ดูแลระบบฐานข้อมูลและระบบมีตัวเลือกที่หลากหลายเพื่อให้แน่ใจว่าแอพพลิเคชั่นฐานข้อมูลที่มีความสำคัญต่อภารกิจนั้นยังคงมีอยู่ในระดับสูง โครงสร้างพื้นฐานคลาวด์สาธารณะเช่นเดียวกับที่จัดทำโดย Amazon Web Services มีตัวเลือกความพร้อมใช้งานสูงเพิ่มเติมซึ่งได้รับการสนับสนุนโดยข้อตกลงระดับบริการ แต่การกำหนดค่าที่ทำงานได้ดีในระบบคลาวด์ส่วนตัวอาจเป็นไปไม่ได้ในระบบคลาวด์สาธารณะ ตัวเลือกที่ไม่ดีในบริการ AWS ที่ใช้และ / หรือวิธีการกำหนดค่าเหล่านี้อาจทำให้ข้อกำหนดการเข้าแทนที่ล้มเหลวเมื่อจำเป็นจริง ๆ บทความนี้แสดงตัวเลือกต่าง ๆ ที่พร้อมใช้งานเพื่อให้แน่ใจว่ามีความพร้อมใช้งานสูงสำหรับ SQL Server ในคลาวด์ AWS

ตัวเลือก

สำหรับแอปพลิเคชันฐานข้อมูล AWS ให้ทางเลือกพื้นฐานแก่ผู้ดูแลระบบสองทาง แต่ละข้อมีข้อกำหนดความพร้อมใช้งานสูง (HA) และการกู้คืนความเสียหาย (DR) ที่แตกต่างกัน: บริการฐานข้อมูลเชิงสัมพันธ์ของ Amazon (RDS) และ Amazon Elastic Compute Cloud (EC2)

RDS

RDS เป็นบริการที่มีการจัดการอย่างสมบูรณ์เหมาะสำหรับการใช้งานที่มีความสำคัญต่อภารกิจ มันมีตัวเลือกของเอ็นจิ้นฐานข้อมูลหกแบบที่แตกต่างกัน แต่การรองรับ SQL Server นั้นไม่แข็งแกร่งเท่าที่ควรสำหรับตัวเลือกอื่น ๆ เช่น Amazon Aurora, My SQL และ MariaDB ต่อไปนี้เป็นข้อกังวลทั่วไปที่ผู้ดูแลระบบมีเกี่ยวกับการใช้ RDS สำหรับแอปพลิเคชัน SQL Server ที่มีความสำคัญต่อภารกิจ:

  • สนับสนุนอินสแตนซ์สแตนด์บายแบบมิรเรอร์เดียวเท่านั้น
  • งานตัวแทนไม่ได้ถูกมิร์เรอร์ดังนั้นจึงต้องสร้างแยกต่างหากในอินสแตนซ์สแตนด์บาย
  • ตรวจไม่พบความล้มเหลวที่เกิดจากซอฟต์แวร์แอปพลิเคชันฐานข้อมูล
  • ไม่รองรับอินสแตนซ์ฐานข้อมูลในหน่วยความจำที่ได้รับการเพิ่มประสิทธิภาพ
  • ขึ้นอยู่กับการมอบหมายโซนความพร้อมใช้งาน (ซึ่งลูกค้าไม่มีการควบคุม) ประสิทธิภาพอาจได้รับผลกระทบ
  • Enterprise Edition ที่มีราคาแพงกว่าของ SQL Server นั้นจำเป็นสำหรับคุณสมบัติการมิเรอร์ข้อมูลที่มีเฉพาะในกลุ่มความพร้อมใช้งานตลอดเวลาเท่านั้น

Elastic Compute Cloud

ตัวเลือกพื้นฐานอื่น ๆ คือ Elastic Compute Cloud ที่มีความสามารถที่มากขึ้น สิ่งนี้ทำให้เป็นตัวเลือกที่ต้องการเมื่อ HA และ DR มีความสำคัญยิ่ง ข้อได้เปรียบที่สำคัญของ EC2 คือการควบคุมที่สมบูรณ์ซึ่งจะให้ผู้ดูแลระบบในการกำหนดค่าและนำเสนอผู้ดูแลระบบด้วยตัวเลือกเพิ่มเติมบางอย่าง

การเลือกระบบปฏิบัติการ

บางทีตัวเลือกที่สำคัญที่สุดคือระบบปฏิบัติการที่ใช้: Windows หรือ Linux Windows Server Failover Clustering เป็นความสามารถที่ทรงพลังพิสูจน์แล้วและเป็นที่นิยมซึ่งมาพร้อมกับมาตรฐานของ Windows แต่ WSFC ต้องการพื้นที่เก็บข้อมูลที่ใช้ร่วมกันและไม่มีอยู่ใน EC2 เนื่องจาก Multi-AZ และ Multi-Region จำเป็นต้องมีการกำหนดค่าสำหรับการป้องกัน HA / DR ที่แข็งแกร่งจึงจำเป็นต้องใช้ซอฟต์แวร์เชิงพาณิชย์หรือกำหนดเองแยกต่างหากเพื่อทำซ้ำข้อมูลในคลัสเตอร์ของอินสแตนซ์ของเซิร์ฟเวอร์ Storage Spaces Direct (S2D) ของ Microsoft ไม่ใช่ตัวเลือกที่นี่เนื่องจากไม่รองรับการกำหนดค่าที่ครอบคลุมโซนความพร้อมใช้งาน ความต้องการบทบัญญัติ HA / DR เพิ่มเติมนั้นยิ่งใหญ่กว่าสำหรับ Linux ซึ่งขาดความสามารถในการทำคลัสเตอร์พื้นฐานเช่น WSFC Linux ให้ผู้ดูแลระบบสองตัวเลือกที่ไม่ดีเท่า ๆ กันสำหรับความพร้อมใช้งานสูง: จ่ายเพิ่มเติมสำหรับ Enterprise Edition ของ SQL Server ที่มีราคาแพงกว่า หรือพยายามทำให้การกำหนดค่า HA Linux ที่ต้องทำด้วยตัวเองที่ซับซ้อนโดยใช้ซอฟต์แวร์โอเพ่นซอร์สทำงานได้ดี

เปรียบเทียบ

ตัวเลือกทั้งสองนี้จะทำลายเหตุผลที่ประหยัดต้นทุนในการใช้ซอฟต์แวร์โอเพ่นซอร์สบนฮาร์ดแวร์สินค้าโภคภัณฑ์ในบริการคลาวด์สาธารณะ SQL Server สำหรับ Linux พร้อมใช้งานสำหรับรุ่นที่ใหม่กว่า (และราคาแพงกว่า) เริ่มต้นในปี 2560 และทางเลือก DIY HA อาจมีราคาแพงสำหรับองค์กรส่วนใหญ่ อันที่จริงแล้วการทำให้ Distributed Replicated Block Device, Corosync, Pacemaker และซอฟต์แวร์โอเพนซอร์ซอื่น ๆ ทำงานได้ตามที่ต้องการในระดับแอปพลิเคชันภายใต้สถานการณ์ความล้มเหลวทั้งหมด นี่คือเหตุผลว่าทำไมองค์กรขนาดใหญ่มากเท่านั้นจึงจำเป็นต้องมี (ชุดทักษะและการจัดบุคลากร) ที่จำเป็นในการพิจารณาดำเนินการ เนื่องจากปัญหาที่เกี่ยวข้องกับการบังคับใช้บทบัญญัติ HA / DR ที่สำคัญต่อภารกิจสำหรับ Linux AWS แนะนำให้ใช้การรวมกันของ Elastic Load Balancing และ Auto Scaling เพื่อปรับปรุงความพร้อมใช้งาน แต่บริการเหล่านี้มีข้อ จำกัด ของตนเองที่คล้ายคลึงกับบริการการจัดการฐานข้อมูลเชิงสัมพันธ์ ทั้งหมดนี้อธิบายว่าทำไมผู้ดูแลระบบจึงเลือกใช้โซลูชันการทำคลัสเตอร์แบบล้มเหลวมากขึ้นซึ่งออกแบบมาโดยเฉพาะเพื่อรับรองการปกป้อง HA และ DR ในสภาพแวดล้อมคลาวด์

Failover Clustering สร้างขึ้นสำหรับคลาวด์

ความนิยมที่เพิ่มขึ้นของคลาวด์ส่วนบุคคลสาธารณะและไฮบริดได้นำไปสู่การถือกำเนิดของโซลูชั่นการจัดกลุ่มความล้มเหลวที่สร้างขึ้นสำหรับสภาพแวดล้อมคลาวด์ โซลูชั่น HA / DR เหล่านี้มีการใช้งานอย่างสมบูรณ์ในซอฟต์แวร์ที่สร้างขึ้นตามชื่อกลุ่มของเซิร์ฟเวอร์และหน่วยเก็บข้อมูลที่มีการเฟลโอเวอร์อัตโนมัติเพื่อรับรองความพร้อมใช้งานสูงในระดับแอปพลิเคชัน โซลูชันเหล่านี้ส่วนใหญ่มีโซลูชัน HA / DR ที่สมบูรณ์ซึ่งรวมการรวมกันของการจำลองข้อมูลบล็อกระดับเรียลไทม์การตรวจสอบแอปพลิเคชันอย่างต่อเนื่องและนโยบายการกู้คืนความล้มเหลว / ล้มเหลวที่กำหนดค่าได้ โซลูชันที่ซับซ้อนยิ่งขึ้นบางตัวยังมีความสามารถขั้นสูงเช่นการสนับสนุน Always on Cluster Instance ใน SQL Server Standard Edition ที่ราคาไม่แพงทั้งสำหรับ Windows และ Linux พวกเขายังมีการเพิ่มประสิทธิภาพ WAN เพื่อเพิ่มประสิทธิภาพการทำงานในหลายภูมิภาค นอกจากนี้ยังมีการสลับการกำหนดเซิร์ฟเวอร์หลักและรองด้วยตนเองเพื่ออำนวยความสะดวกในการบำรุงรักษาตามแผน รวมถึงความสามารถในการสำรองข้อมูลปกติโดยไม่ทำให้แอปพลิเคชันหยุดชะงัก ซอฟต์แวร์การทำคลัสเตอร์การเฟลโอเวอร์ส่วนใหญ่นั้นเป็นแอพพลิเคชั่นที่ไม่เชื่อเรื่องพระเจ้าทำให้องค์กรมีโซลูชัน HA / DR เดียวที่เป็นสากล ความสามารถเดียวกันนี้ยังช่วยป้องกันแอปพลิเคชันเซิร์ฟเวอร์ SQL ทั้งหมด และนั่นรวมถึงฐานข้อมูลการเข้าสู่ระบบงานตัวแทนและอื่น ๆ ทั้งหมดในรูปแบบบูรณาการ แม้ว่าโดยทั่วไปโซลูชันเหล่านี้จะเป็นระบบจัดเก็บข้อมูลที่ไม่เชื่อเรื่องพระเจ้า แต่ช่วยให้สามารถทำงานร่วมกับเครือข่ายพื้นที่เก็บข้อมูลที่ใช้ร่วมกันได้ แต่การแบ่งกลุ่ม SANless failover แบบไม่มีอะไรที่ใช้ร่วมกันมักเป็นที่ต้องการสำหรับความสามารถในการกำจัด การสนับสนุนอินสแตนซ์ Failover Cluster Instances (FCIs) ในรุ่น Standard Edition ที่ถูกกว่าของ SQL Server โดยไม่กระทบกับความพร้อมใช้งานหรือประสิทธิภาพเป็นข้อได้เปรียบที่สำคัญ ในสภาพแวดล้อม Windows ซอฟต์แวร์การทำคลัสเตอร์ล้มเหลวส่วนใหญ่รองรับ FCIs โดยใช้ประโยชน์จากคุณสมบัติ WSFC ในตัว มันทำให้การใช้งานค่อนข้างตรงไปตรงมาสำหรับทั้งผู้ดูแลระบบฐานข้อมูลและ Linux กำลังเป็นที่นิยมมากขึ้นสำหรับ SQL Server และแอปพลิเคชันระดับองค์กรอื่น ๆ โซลูชันการทำคลัสเตอร์ล้มเหลวบางตัวในขณะนี้ทำให้การใช้งาน HA / DR เป็นเรื่องง่ายเหมือนที่ใช้กับ Windows โดยเสนอการรวมเฉพาะแอปพลิเคชัน

โดยทั่วไปสามโหนด SANless Failover Cluster

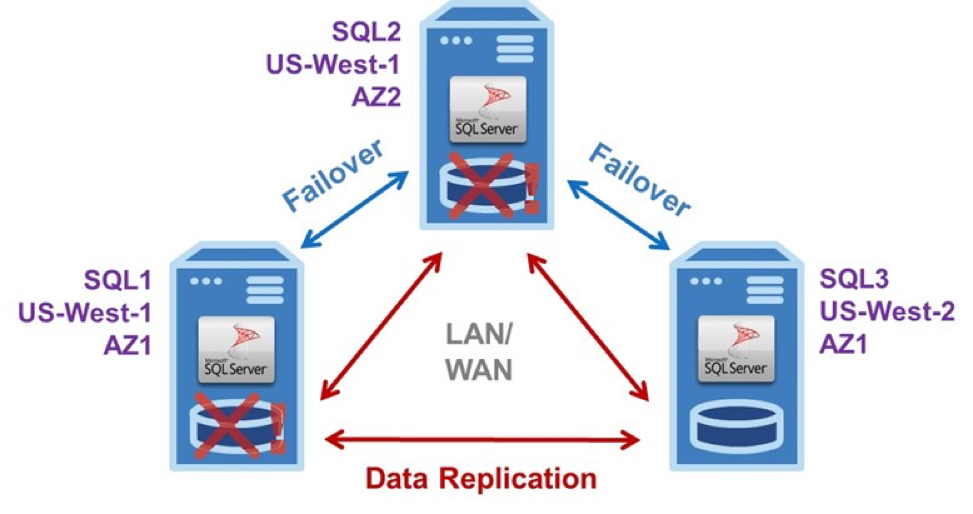
ตัวอย่างการกำหนดค่า EC2 ในแผนภาพแสดงคลัสเตอร์ล้มเหลวสามโหนด SANless ทั่วไปที่กำหนดค่าเป็น Virtual Private Cloud (VPC) พร้อมอินสแตนซ์ของ SQL Server ทั้งสามในโซนความพร้อมใช้งานที่แตกต่างกัน เพื่อกำจัดโอกาสที่จะเกิดไฟดับในภัยพิบัติในท้องถิ่นที่ส่งผลกระทบต่อทั้งภูมิภาคหนึ่งใน AZs ตั้งอยู่ในภูมิภาค AWS ที่แตกต่างกัน

ความพร้อมใช้งานสูงสำหรับ SQL Server

คลัสเตอร์ล้มเหลว SANless สามโหนดนี้ที่มีหนึ่งอินสแตนซ์ของเซิร์ฟเวอร์ที่ใช้งานอยู่และสองอินสแตนซ์สามารถจัดการกับความล้มเหลวที่เกิดขึ้นพร้อมกันสองครั้งด้วยการหยุดทำงานน้อยที่สุดและไม่มีการสูญเสียข้อมูล

คลัสเตอร์ล้มเหลว SANless สามโหนดมีการปกป้อง HA และ DR ระดับผู้ให้บริการ การดำเนินการขั้นพื้นฐานจะเหมือนกันใน LAN และ / หรือ WAN สำหรับ Windows หรือ Linux เซิร์ฟเวอร์ # 1 เป็นอินสแตนซ์หลักหรืออินสแตนซ์ที่ใช้งานอยู่ซึ่งทำซ้ำข้อมูลอย่างต่อเนื่องไปยังเซิร์ฟเวอร์ # 2 และ # 3 มันประสบปัญหา จากนั้นจะทริกเกอร์การ failover อัตโนมัติไปยังเซิร์ฟเวอร์ # 2 ซึ่งตอนนี้กลายเป็นข้อมูลการเรพลิเคทหลักไปยังเซิร์ฟเวอร์ # 3

ตรวจพบความล้มเหลว

หากความล้มเหลวเกิดจากการหยุดทำงานของโครงสร้างพื้นฐานเจ้าหน้าที่ AWS จะเริ่มวินิจฉัยและซ่อมแซมทันทีที่เกิดปัญหา เมื่อแก้ไขแล้วจะสามารถกู้คืนเป็นเซิร์ฟเวอร์หลักหรือเซิร์ฟเวอร์ # 2 สามารถดำเนินการต่อในความสามารถในการจำลองข้อมูลไปยังเซิร์ฟเวอร์ # 1 และ # 3 หากเซิร์ฟเวอร์ # 2 ล้มเหลวก่อนที่เซิร์ฟเวอร์ # 1 จะกลับสู่การดำเนินการดังที่แสดงเซิร์ฟเวอร์ # 3 จะกลายเป็นเซิร์ฟเวอร์หลักหลังจากเกิดความล้มเหลวด้วยตนเอง แน่นอนหากความล้มเหลวเกิดจากแอพพลิเคชั่นซอฟต์แวร์หรือด้านอื่น ๆ ของการกำหนดค่ามันจะขึ้นอยู่กับลูกค้าที่จะค้นหาและแก้ไขปัญหา คลัสเตอร์ล้มเหลว SANless สามารถกำหนดค่าได้ด้วยอินสแตนซ์สแตนด์บายเดียวเท่านั้นแน่นอน แต่การกำหนดค่าขั้นต่ำเช่นนี้ต้องการโหนดที่สามเพื่อใช้เป็นพยาน จำเป็นต้องมีพยานเพื่อให้ครบองค์ประชุมเพื่อพิจารณาการมอบหมายงานหลัก โดยปกติแล้วงานที่สำคัญนี้จะดำเนินการโดยตัวควบคุมโดเมนใน AZ แยกต่างหาก การเก็บทั้งสามโหนด (หลักรองและพยาน) ใน AZ ที่แตกต่างกันช่วยลดความเป็นไปได้ที่จะสูญเสียการโหวตมากกว่าหนึ่งคะแนนหากโซนใดออฟไลน์ นอกจากนี้ยังเป็นไปได้ที่จะมีคลัสเตอร์ล้มเหลว SANless failover สองและสามโหนดในคอนฟิกูเรชันไฮบริดของคลาวด์สำหรับ HA และ / หรือ DR หนึ่งการกำหนดค่าสามโหนดดังกล่าวคือคลัสเตอร์ HA สองโหนดที่อยู่ในศูนย์ข้อมูลขององค์กรพร้อมการจำลองข้อมูลแบบอะซิงโครนัสไปยัง AWS หรือบริการคลาวด์อื่นสำหรับการป้องกัน DR หรือในทางกลับกัน ในกลุ่มภายในภูมิภาคเดียวซึ่งการจำลองข้อมูลเป็นแบบซิงโครนัสความล้มเหลวจะถูกกำหนดค่าให้เกิดขึ้นโดยอัตโนมัติ สำหรับกลุ่มที่มีโหนดที่ขยายหลายภูมิภาคโดยที่การเรพลิเคทข้อมูลแบบอะซิงโครนัสความล้มเหลวมักถูกควบคุมด้วยตนเองเพื่อหลีกเลี่ยงโอกาสในการสูญหายของข้อมูล คลัสเตอร์สามโหนดโดยไม่คำนึงถึงภูมิภาคที่ใช้ยังสามารถอำนวยความสะดวกในการบำรุงรักษาฮาร์ดแวร์และซอฟต์แวร์ตามแผนสำหรับเซิร์ฟเวอร์ทั้งสามในขณะที่ให้การป้องกัน DR อย่างต่อเนื่องสำหรับแอปพลิเคชันและข้อมูล

เพิ่มความพร้อมใช้งานสูงให้สูงสุดสำหรับ SQL Server

ด้วยการนำเสนอความพร้อมใช้งาน 55 โซนที่กระจายอยู่ใน 18 ภูมิภาคทำให้ AWS Global Infrastructure มีโอกาสมหาศาลในการเพิ่มความพร้อมใช้งานสูงให้กับ SQL Server โดยการกำหนดค่าคลัสเตอร์ล้มเหลว SANless ด้วยการสำรองข้อมูลซ้ำซ้อนที่กระจายอยู่ในพื้นที่หลายแห่ง รอยเท้าทั่วโลกนี้ยังช่วยให้แอปพลิเคชันและข้อมูลเซิร์ฟเวอร์ SQL ทั้งหมดอยู่ใกล้กับผู้ใช้ปลายทางเพื่อให้ได้ประสิทธิภาพที่น่าพอใจ ด้วยโซลูชันที่ออกแบบมาเพื่อวัตถุประสงค์ความพร้อมใช้งานระดับสูงของผู้ให้บริการไม่จำเป็นต้องหมายถึงการจ่ายค่าใช้จ่ายสูงเช่นเดียวกับผู้ให้บริการ เนื่องจากซอฟต์แวร์การทำคลัสเตอร์ล้มเหลวที่สร้างขึ้นโดยมีจุดประสงค์ทำให้การใช้ทรัพยากรการคำนวณการจัดเก็บและเครือข่ายของ EC2 มีประสิทธิภาพและประสิทธิผลในขณะที่ติดตั้งและใช้งานง่ายโซลูชันเหล่านี้จะลดต้นทุนและค่าใช้จ่ายในการดำเนินงานทั้งหมด เคย ทำซ้ำจาก TheNewStack

Filed Under: ข่าวสารและกิจกรรม Tagged With: ความพร้อมใช้งานสูงสำหรับเซิร์ฟเวอร์ sql

ตัวเลือกสำหรับเมื่อระดับบริการคลาวด์สาธารณะลดลง

มกราคม 27, 2019 by Jason Aw Leave a Comment

ตัวเลือกสำหรับเมื่อระดับบริการคลาวด์สาธารณะลดลง

ตัวเลือกสำหรับเมื่อระดับบริการคลาวด์สาธารณะลดลง

ผู้ให้บริการคลาวด์สาธารณะทั้งหมดเสนอการรับประกันบางรูปแบบเกี่ยวกับความพร้อมให้บริการ สิ่งเหล่านี้อาจหรือไม่เพียงพอทั้งนี้ขึ้นอยู่กับข้อกำหนดของแต่ละแอปพลิเคชันสำหรับเวลาที่ใช้งานได้ การรับประกันเหล่านี้มักจะอยู่ในช่วงจาก 95.00% ถึง 99.99% ของเวลาทำงานในช่วงเดือน ส่วนใหญ่กำหนด "การลงโทษ" บางประเภทกับผู้ให้บริการสำหรับการล้มลงของเกณฑ์เหล่านั้น โดยทั่วไปผู้ให้บริการคลาวด์ส่วนใหญ่จะเสนอช่วงเวลาที่ใช้งานได้ 99.00% นี่เท่ากับเวลาหยุดทำงานประมาณเจ็ดชั่วโมงต่อเดือน และสำหรับแอปพลิเคชั่นมากมายสอง -9 เหล่านั้นอาจเพียงพอ แต่สำหรับแอปพลิเคชันที่มีความสำคัญต่อภารกิจจำเป็นต้องมีเพิ่มอีก 9 รายการ โดยเฉพาะอย่างยิ่งความจริงที่ว่าสาเหตุทั่วไปหลายประการของการหยุดทำงานไม่รวมอยู่ในการรับประกัน แน่นอนว่ามีวิธีการประหยัดค่าใช้จ่ายเพื่อให้ได้ความพร้อมใช้งานสูงห้าถึง 9 และการป้องกันการกู้คืนความเสียหายที่แข็งแกร่งในการกำหนดค่าโดยใช้บริการคลาวด์สาธารณะ บทความนี้เน้นข้อ จำกัด ที่เกี่ยวข้องกับบทบัญญัติ HA และ DR ในคลาวด์สาธารณะ มันสำรวจสามตัวเลือกสำหรับการเอาชนะข้อ จำกัด เหล่านี้และอธิบายการกำหนดค่าทั่วไปสองอย่างสำหรับคลัสเตอร์ล้มเหลว

Caveat Emptor ในก้อนเมฆ

ในขณะที่ผู้ให้บริการคลาวด์ทั้งหมด (CSPs) กำหนด“ หยุดทำงาน” หรือ“ ไม่พร้อมใช้งาน” แตกต่างกันบ้างคำจำกัดความเหล่านี้มีเพียงชุด จำกัด ของสาเหตุที่เป็นไปได้ทั้งหมดของความล้มเหลวในระดับแอปพลิเคชัน โดยทั่วไปแล้วรวมถึงความล้มเหลวที่มีผลต่อโซนหรือภูมิภาคหรือการเชื่อมต่อภายนอก CSP ทั้งหมดยังเสนอเครดิตตั้งแต่ 10% สำหรับความล้มเหลวในการตอบสนองความพร้อมในการใช้งานของสี่ถึง 9 ถึง 25% สำหรับความล้มเหลวในการตอบสนองความพร้อมของสองถึง 9 ทรัพยากรที่ซ้ำซ้อนสามารถกำหนดค่าเพื่อขยายโซนและ / หรือภูมิภาคภายในโครงสร้างพื้นฐานของ CSP มันจะช่วยปรับปรุงความพร้อมใช้งานระดับแอปพลิเคชัน แต่ถึงแม้จะมีความซ้ำซ้อนดังกล่าวก็ยังมีข้อ จำกัด บางประการที่มักจะยอมรับไม่ได้สำหรับแอปพลิเคชันที่สำคัญต่อภารกิจ โดยเฉพาะผู้ที่ต้องการประสิทธิภาพของทรานแซคชั่นทรานแซคชันที่สูง ข้อ จำกัด เหล่านี้รวมถึงต้นแบบแต่ละตัวที่สามารถสร้างแบบจำลองความล้มเหลวได้เพียงครั้งเดียว และมันต้องการการใช้ชุดข้อมูลหลักสำหรับการสำรองข้อมูลและการใช้บันทึกเหตุการณ์เพื่อทำซ้ำข้อมูล ข้อ จำกัด เหล่านี้และอื่น ๆ สามารถเพิ่มเวลาการกู้คืนในระหว่างความล้มเหลวและทำให้จำเป็นต้องกำหนดเวลาหยุดทำงานตามแผนอย่างน้อย

ข้อ จำกัด ที่สำคัญ

ข้อ จำกัด ที่สำคัญยิ่งกว่านั้นเกี่ยวข้องกับการยกเว้นจำนวนมากสำหรับสิ่งที่ก่อให้เกิดการหยุดทำงาน นี่เป็นเพียงตัวอย่างเล็ก ๆ น้อย ๆ จากข้อตกลงระดับบริการคลาวด์สาธารณะจริงของสิ่งที่ถูกแยกออกจาก“ การหยุดทำงาน” หรือ“ ไม่พร้อมใช้งาน” ที่ทำให้เกิดความล้มเหลวระดับแอปพลิเคชันที่เกิดจาก:

  • ปัจจัยที่อยู่นอกเหนือการควบคุมที่สมเหตุสมผลของ CSP (กล่าวอีกนัยหนึ่งคือบางสิ่งที่เกิดขึ้นเป็นประจำเช่นเครือข่ายผู้ให้บริการไม่ทำงานและภัยธรรมชาติ)
  • ซอฟต์แวร์ของลูกค้าหรือซอฟต์แวร์หรือเทคโนโลยีของบุคคลที่สามรวมถึงซอฟต์แวร์แอปพลิเคชัน
  • การป้อนข้อมูลที่ผิดพลาดหรือคำแนะนำหรือการกระทำใด ๆ ที่ขาดหายไปเมื่อจำเป็น (ในคำอื่น ๆ ความผิดพลาดที่หลีกเลี่ยงไม่ได้ที่เกิดจากความผิดพลาดของมนุษย์)
  • ปัญหากับแต่ละอินสแตนซ์หรือไดรฟ์ข้อมูลที่ไม่ได้เกิดจากสถานการณ์ที่เฉพาะเจาะจงของ“ ไม่พร้อมใช้งาน”
  • การบำรุงรักษาฮาร์ดแวร์หรือซอฟต์แวร์ใด ๆ ที่จัดทำขึ้นตามข้อตกลง

เพื่อให้แน่ใจว่ามีเหตุผลที่ CSP จะยกเว้นสาเหตุของความล้มเหลวบางอย่าง แต่มันจะไม่รับผิดชอบสำหรับผู้ดูแลระบบที่จะใช้สิ่งเหล่านี้เป็นข้อแก้ตัว มีความจำเป็นเพื่อให้แน่ใจว่ามีความพร้อมใช้งานระดับแอปพลิเคชันด้วยวิธีการอื่น

มีบริการระดับคลาวด์สาธารณะอะไรบ้าง

การจัดเตรียมทรัพยากรสำหรับความพร้อมใช้งานสูงในลักษณะที่ไม่ลดทอนความปลอดภัยหรือประสิทธิภาพไม่เคยมีความพยายามเล็กน้อย ความท้าทายเป็นเรื่องยากโดยเฉพาะอย่างยิ่งในสภาพแวดล้อมคลาวด์ไฮบริดที่โครงสร้างพื้นฐานคลาวด์ส่วนบุคคลและสาธารณะสามารถแตกต่างกันอย่างมีนัยสำคัญ ทำให้การกำหนดค่ายากต่อการทดสอบและบำรุงรักษา นอกจากนี้ยังสามารถส่งผลให้บทบัญญัติการล้มเหลวล้มเหลวเมื่อจำเป็นจริง สำหรับแอปพลิเคชันที่ระดับการให้บริการโดย CSP ขาดสั้นมีสามตัวเลือกเพิ่มเติมตามแอปพลิเคชันตัวเองคุณสมบัติในระบบปฏิบัติการหรือผ่านการใช้ซอฟต์แวร์การทำคลัสเตอร์การเฟลโอเวอร์ที่สร้างขึ้นโดยมีวัตถุประสงค์

สามตัวเลือกสำหรับการปรับปรุงความพร้อมใช้งานระดับแอปพลิเคชัน

HA / DR

ตัวเลือก HA / DR ที่อาจดูเหมือนว่าง่ายที่สุดในการนำไปใช้นั้นเป็นตัวเลือกที่ออกแบบมาเฉพาะสำหรับแต่ละแอปพลิเคชัน ตัวอย่างที่ดีคือฐานข้อมูล SQL Server ของ Microsoft พร้อมคุณสมบัติ Always On Availability Group ของผู้ให้บริการ อย่างไรก็ตามมีข้อเสียสองประการสำหรับวิธีการนี้ ค่าธรรมเนียมใบอนุญาตที่สูงขึ้นในกรณีนี้สำหรับ Enterprise Edition สามารถทำให้มีราคาแพงสำหรับความต้องการมากมาย และข้อเสียยิ่งกว่านั้นคือความต้องการบทบัญญัติ HA / DR ที่แตกต่างกันสำหรับการใช้งานที่แตกต่างกันซึ่งทำให้การจัดการอย่างต่อเนื่องเป็นการต่อสู้ที่ต่อเนื่อง (และมีค่าใช้จ่าย)

คุณสมบัติที่เกี่ยวข้องกับสถานะการออนไลน์รวมอยู่ในระบบปฏิบัติการ

ตัวเลือกที่สองเพื่อปรับปรุงระดับบริการคลาวด์สาธารณะเกี่ยวข้องกับการใช้คุณสมบัติที่เกี่ยวข้องกับช่วงเวลาที่รวมเข้ากับระบบปฏิบัติการ ยกตัวอย่างเช่นการทำคลัสเตอร์ Windows Server Failover เป็นคุณลักษณะที่ทรงพลังและได้รับการพิสูจน์แล้วซึ่งสร้างไว้ในระบบปฏิบัติการ แต่ด้วยตัวของมันเอง WSFC อาจไม่มีโซลูชัน HA / DR ที่สมบูรณ์เนื่องจากไม่มีคุณสมบัติการจำลองข้อมูล ในระบบคลาวด์ส่วนตัวการจำลองข้อมูลสามารถให้บริการโดยใช้รูปแบบของการจัดเก็บข้อมูลที่ใช้ร่วมกันบางอย่างเช่นเครือข่ายพื้นที่จัดเก็บ แต่เนื่องจากที่เก็บข้อมูลที่ใช้ร่วมกันไม่สามารถใช้ได้ในระบบคลาวด์สาธารณะการใช้การจำลองแบบข้อมูลที่มีประสิทธิภาพจึงต้องใช้ซอฟต์แวร์เชิงพาณิชย์หรือซอฟต์แวร์ที่พัฒนาขึ้นเอง สำหรับ Linux ซึ่งขาดคุณสมบัติเช่น WSFC ความต้องการบทบัญญัติ HA / DR เพิ่มเติมและ / หรือการพัฒนาแบบกำหนดเองนั้นยิ่งใหญ่กว่ามาก การใช้ซอฟต์แวร์โอเพนซอร์สเช่น Pacemaker และ Corosync ต้องมีการสร้าง (และทดสอบ) สคริปต์ที่กำหนดเองสำหรับแต่ละแอปพลิเคชัน สคริปต์เหล่านี้มักจะต้องได้รับการปรับปรุงและทดสอบซ้ำหลังจากมีการเปลี่ยนแปลงเล็กน้อยกับซอฟต์แวร์หรือฮาร์ดแวร์ที่ใช้ แต่เนื่องจากการทำให้ HA สแต็คเต็มรูปแบบทำงานได้ดีสำหรับทุกแอปพลิเคชันอาจเป็นเรื่องยากเป็นพิเศษองค์กรขนาดใหญ่เท่านั้นจึงมีความจำเป็นที่จะต้องพิจารณาความพยายามด้วยซ้ำ

คลัสเตอร์ Failover ที่สร้างขึ้นตามวัตถุประสงค์

จะเป็นการดีที่จะมีวิธีการที่เป็นสากลสำหรับ HA / DR ที่สามารถทำงานได้อย่างคุ้มค่าสำหรับแอพพลิเคชั่นทั้งหมดที่ทำงานบน Windows หรือ Linux ในระบบคลาวด์สาธารณะส่วนตัวและคลาวด์ไฮบริด ในบรรดาโซลูชันที่หลากหลายและราคาไม่แพงที่สุดคือตัวเลือกที่สาม: คลัสเตอร์ล้มเหลวที่สร้างขึ้นตามวัตถุประสงค์ โซลูชัน HA / DR เหล่านี้มีการใช้งานอย่างสมบูรณ์ในซอฟต์แวร์ที่ได้รับการออกแบบมาโดยเฉพาะเพื่อสร้างตามที่ระบุโดยนัยกลุ่มของเซิร์ฟเวอร์เสมือนหรือฟิสิคัลและหน่วยเก็บข้อมูลที่มีความล้มเหลวจากอินสแตนซ์ที่ใช้งานหรือหลัก ชั้น

ประโยชน์ของการแก้ปัญหาเหล่านี้

โซลูชั่นเหล่านี้มีการรวมกันของการจำลองข้อมูลตามเวลาจริงการตรวจสอบแอปพลิเคชันอย่างต่อเนื่องและนโยบายการกู้คืนความล้มเหลว / ล้มเหลวที่กำหนดค่าได้ บางอันที่แข็งแกร่งกว่านั้นมีความสามารถขั้นสูงเพิ่มเติมเช่นตัวเลือกการซิงโครนัสระดับบล็อกหรือแบบอะซิงโครนัสการสนับสนุน Failover Cluster Instances (FCIs) ใน SQL Server Standard Edition ที่ราคาไม่แพงการเพิ่มประสิทธิภาพ WAN การใช้ประโยชน์และการสลับการทำงานด้วยตนเองของการกำหนดเซิร์ฟเวอร์หลักและรองเพื่ออำนวยความสะดวกในการบำรุงรักษาตามแผน แม้ว่าโซลูชันที่ใช้งานทั่วไปเหล่านี้โดยทั่วไปเป็นผู้ไม่เชื่อเรื่องการจัดเก็บ แต่ช่วยให้พวกเขาสามารถทำงานกับเครือข่ายพื้นที่จัดเก็บได้โดยทั่วไปคลัสเตอร์ SAN ล้มเหลวแบบไม่มีอะไรที่ใช้ร่วมกันจะเป็นที่ต้องการโดยขึ้นอยู่กับความสามารถของพวกเขา

การกำหนดค่าการทำคลัสเตอร์แบบล้มเหลวทั่วไปสองแบบ

ทุกคลัสเตอร์ล้มเหลวประกอบด้วยสองโหนดขึ้นไป การค้นหาอย่างน้อยหนึ่งโหนดในดาต้าเซ็นเตอร์ที่แตกต่างกันเป็นสิ่งจำเป็นเพื่อป้องกันภัยพิบัติในท้องถิ่น นำเสนอที่นี่มีสองการกำหนดค่าที่เป็นที่นิยม: หนึ่งสำหรับวัตถุประสงค์ในการกู้คืนระบบ อีกสิ่งหนึ่งที่ให้ทั้งความพร้อมใช้งานสูงเป็นภารกิจสำคัญและการกู้คืนความเสียหาย ประสิทธิภาพของธุรกรรมสูงมักเป็นข้อกำหนดสำหรับการกำหนดค่าที่พร้อมใช้งานสูง แอปพลิเคชันตัวอย่างคือฐานข้อมูล คลัสเตอร์ล้มเหลว SANless ขั้นพื้นฐานสำหรับการกู้คืนระบบมีสองโหนดที่มีหนึ่งเซิร์ฟเวอร์หลักและเซิร์ฟเวอร์รองหรือสแตนด์บายหรือเซิร์ฟเวอร์อินสแตนซ์หนึ่งเซิร์ฟเวอร์ การกำหนดค่าขั้นต่ำนี้ยังต้องการโหนดหรืออินสแตนซ์ที่สามเพื่อทำหน้าที่เป็นพยานซึ่งจำเป็นต้องมีเพื่อให้บรรลุองค์ประชุมในการพิจารณาการมอบหมายหลัก สำหรับแอ็พพลิเคชันฐานข้อมูลการเรพลิเคทไปยังอินสแตนซ์สแตนด์บายข้าม WAN นั้นไม่ตรงกันเพื่อรักษาประสิทธิภาพสูงในอินสแตนซ์หลัก คลัสเตอร์ล้มเหลว SANless กำบังการกู้คืนอย่างรวดเร็วในกรณีที่เกิดความล้มเหลวในหลัก ส่งผลให้การกำหนดค่า DR พื้นฐานเหมาะสำหรับการใช้งานหลายอย่าง มันสามารถตรวจจับความล้มเหลวที่เป็นไปได้ทั้งหมดรวมถึงสิ่งที่ไม่ได้นับว่าเป็นการหยุดทำงานในบริการคลาวด์สาธารณะ เช่นนี้จะทำงานในสภาพแวดล้อมคลาวด์ส่วนตัวสาธารณะหรือไฮบริด ตัวอย่างเช่นหลักอาจอยู่ในดาต้าเซ็นเตอร์ขององค์กรที่มีการใช้งานรองในระบบคลาวด์สาธารณะ เนื่องจากอินสแตนซ์คลาวด์สาธารณะจะต้องการเฉพาะในระหว่างการบำรุงรักษาตามแผนหลักหรือในกรณีที่เกิดความล้มเหลว – เงื่อนไขที่สามารถแก้ไขได้อย่างรวดเร็ว – ข้อ จำกัด การบริการและการยกเว้นที่อ้างถึงข้างต้นอาจเป็นที่ยอมรับสำหรับทุกคน ของแอปพลิเคชัน

คลัสเตอร์ล้มเหลว SANless Failover สามโหนด

คลัสเตอร์ล้มเหลว SANless สามโหนดนี้มีหนึ่งอินสแตนซ์ของเซิร์ฟเวอร์ที่ใช้งานอยู่และสองอินสแตนซ์ สามารถจัดการกับสองความล้มเหลวพร้อมกันโดยมีเวลาหยุดทำงานน้อยที่สุดและไม่มีการสูญเสียข้อมูล [/ caption] รูปแสดงคลัสเตอร์ล้มเหลว SANless สามโหนดที่ได้รับการปรับปรุงซึ่งให้ความพร้อมใช้งานสูงทั้งห้าและ 9 เช่นเดียวกับคลัสเตอร์สองโหนดการกำหนดค่านี้จะทำงานในสภาพแวดล้อมคลาวด์ส่วนตัวสาธารณะหรือไฮบริด ในตัวอย่างนี้เซิร์ฟเวอร์ # 1 และ # 2 ตั้งอยู่ในดาต้าเซ็นเตอร์องค์กรพร้อมเซิร์ฟเวอร์ # 3 ในคลาวด์สาธารณะ ภายในดาต้าเซ็นเตอร์การจำลองแบบข้าม LAN สามารถซิงโครนัสอย่างเต็มที่เพื่อลดเวลาที่ใช้ในการทำ failover ให้เสร็จสมบูรณ์ ดังนั้นเพิ่มความพร้อมใช้งานสูงสุด เมื่อกำหนดค่าอย่างเหมาะสมคลัสเตอร์ล้มเหลวสามโหนด SANless จะจ่าย HA และ DR ระดับผู้ให้บริการอย่างแท้จริง การดำเนินการขั้นพื้นฐานนั้นไม่เชื่อเรื่องแอปพลิเคชันและทำงานเหมือนกันสำหรับ Windows หรือ Linux เซิร์ฟเวอร์ # 1 เป็นอินสแตนซ์หลักหรืออินสแตนซ์ที่ใช้งานอยู่ซึ่งทำซ้ำข้อมูลอย่างต่อเนื่องไปยังเซิร์ฟเวอร์ # 2 และ # 3 หากพบความล้มเหลวแอปพลิเคชันจะล้มเหลวโดยอัตโนมัติไปยังเซิร์ฟเวอร์ # 2 ซึ่งจะกลายเป็นข้อมูลการเรพลิเคทหลักไปยังเซิร์ฟเวอร์ # 3 โดยอัตโนมัติ

การฟื้นตัว

ทันทีหลังจากความล้มเหลวในเซิร์ฟเวอร์ # 1 เจ้าหน้าที่ IT จะเริ่มวินิจฉัยและซ่อมแซมสิ่งที่ทำให้เกิดปัญหา เมื่อแก้ไขแล้วเซิร์ฟเวอร์ # 1 สามารถเรียกคืนเป็นอุปกรณ์หลักที่มีความล้มเหลวด้วยตนเองหรือเซิร์ฟเวอร์ # 2 สามารถทำงานต่อได้ในฐานะข้อมูลจำลองหลักไปยังเซิร์ฟเวอร์ # 1 และ # 3 หากเซิร์ฟเวอร์ # 2 ล้มเหลวก่อนที่เซิร์ฟเวอร์ # 1 จะกลับสู่การดำเนินการตามที่แสดงเซิร์ฟเวอร์ # 3 จะกลายเป็นเซิร์ฟเวอร์หลัก เนื่องจากเซิร์ฟเวอร์ # 3 อยู่ฝั่ง WAN ในคลาวด์สาธารณะการเรพลิเคทข้อมูลแบบอะซิงโครนัสและการเฟลโอเวอร์เป็นคู่มือเพื่อป้องกัน "การจำลองแบบล่าช้า" จากการสูญเสียข้อมูลใด ๆ ซอฟต์แวร์การทำคลัสเตอร์ failover SANless สามารถตรวจสอบความล้มเหลวที่เป็นไปได้ทั้งหมดในระดับแอปพลิเคชัน สามารถเอาชนะข้อ จำกัด และการยกเว้น CSP ที่กล่าวถึงข้างต้นได้อย่างง่ายดาย ดังนั้นจึงเป็นไปได้ที่การกำหนดค่าสามโหนดนี้จะถูกปรับใช้ทั้งหมดภายในคลาวด์สาธารณะ เพื่อให้มีความพร้อมใช้งานสูง 5-9 ของเดียวกันโดยพิจารณาจากความล้มเหลวทันทีและอัตโนมัติเซิร์ฟเวอร์ # 1 และ # 2 จะต้องอยู่ภายในโซนเดียวหรือภูมิภาคที่ LAN รองรับการจำลองแบบซิงโครนัส สำหรับการป้องกัน DR ที่เหมาะสมเซิร์ฟเวอร์ # 3 ควรอยู่ในดาต้าเซ็นเตอร์หรือภูมิภาคอื่นซึ่งจำเป็นต้องใช้การจำลองแบบอะซิงโครนัสและการเฟลโอเวอร์ / ความล้มเหลวด้วยตนเองซึ่งจำเป็นสำหรับแอปพลิเคชันที่ต้องการปริมาณงานสูง คลัสเตอร์สามโหนดยังสามารถอำนวยความสะดวกในการบำรุงรักษาฮาร์ดแวร์และซอฟต์แวร์ที่วางแผนไว้สำหรับเซิร์ฟเวอร์ทั้งสามเครื่อง ในขณะเดียวกันก็ให้การป้องกัน DR อย่างต่อเนื่องสำหรับแอปพลิเคชันและข้อมูลของมัน ด้วยการนำเสนอดาต้าเซ็นเตอร์ที่กระจายตัวอยู่ในพื้นที่หลายแห่งทำให้ระบบคลาวด์สาธารณะสามารถสร้างโอกาสมากมายในการปรับปรุงความพร้อมใช้งาน ซอฟต์แวร์การทำคลัสเตอร์ล้มเหลวของ SANless ทำให้การใช้ทรัพยากรการคำนวณการจัดเก็บและเครือข่ายทั้งหมดมีประสิทธิภาพและประสิทธิผล มันยังง่ายต่อการติดตั้งและใช้งาน โซลูชั่นที่สร้างขึ้นตามวัตถุประสงค์เหล่านี้จะลดค่าใช้จ่ายด้านทุนและการดำเนินงานทั้งหมด ในที่สุดส่งผลให้มีความพร้อมใช้งานสูงมีประสิทธิภาพมากขึ้นและราคาไม่แพงมากขึ้นกว่าเดิม # # #

เกี่ยวกับผู้แต่ง

Cassius Rhue เป็นผู้อำนวยการฝ่ายวิศวกรรมของ SIOS Technology  เขาเป็นผู้นำการพัฒนาผลิตภัณฑ์ซอฟต์แวร์และทีมวิศวกรรมในเล็กซิงตัน Cassius มีประสบการณ์ด้านวิศวกรรมการพัฒนาและการทดสอบมากกว่า 17 ปี นอกจากนี้เขายังสำเร็จการศึกษาระดับปริญญาตรีสาขาวิศวกรรมคอมพิวเตอร์จากมหาวิทยาลัยเซาท์แคโรไลนา

บทความจาก DRJ.com

Filed Under: ข่าวสารและกิจกรรม Tagged With: ระดับบริการคลาวด์สาธารณะ

การจัดการต้นทุนของคลาวด์สำหรับแอปพลิเคชันที่มีความพร้อมใช้งานสูง

มกราคม 23, 2019 by Jason Aw Leave a Comment

ต้นทุนของคลาวด์สำหรับแอปพลิเคชันที่มีความพร้อมใช้งานสูง - SIOS APAC

ต้นทุนคลาวด์สำหรับแอปพลิเคชันที่มีความพร้อมใช้งานสูง

หลังจากทำสัญญากับผู้ให้บริการคลาวด์ไม่นานบิลจะมาถึงที่ทำให้เกิดการกระแทกสติ๊กเกอร์ มีค่าใช้จ่ายที่ไม่คาดคิดและดูเหมือนมากเกินไป ดูเหมือนว่าผู้รับผิดชอบไม่สามารถอธิบายได้ว่าจะเกิดอะไรขึ้น สถานการณ์เร่งด่วนเนื่องจากจำนวนเงินที่คุกคามงบประมาณด้านไอทีเว้นแต่ว่าจะมีการเปลี่ยนแปลงการประหยัดต้นทุนทันที ดังนั้นเราจะจัดการต้นทุนของคลาวด์สำหรับแอปพลิเคชันที่มีความพร้อมใช้งานสูงได้อย่างไร ช็อตสติกเกอร์บริการบนคลาวด์มักเกิดจากแอปพลิเคชันฐานข้อมูลที่มีความสำคัญยิ่ง โดยเฉพาะอย่างยิ่งสิ่งเหล่านี้มักจะมีราคาแพงที่สุดด้วยเหตุผลหลายประการ แอปพลิเคชั่นเหล่านี้ต้องเรียกใช้ 24/7 พวกเขาต้องการความซ้ำซ้อนซึ่งเกี่ยวข้องกับการจำลองข้อมูลและการเตรียมอินสแตนซ์เซิร์ฟเวอร์สแตนด์บาย การจำลองข้อมูลต้องมีการเคลื่อนย้ายข้อมูลรวมทั้งทั่วทั้งเครือข่ายบริเวณกว้าง (WAN) และการให้ความพร้อมใช้งานสูงอาจส่งผลให้ต้นทุนสูงขึ้นในการให้สิทธิ์ใช้งาน Windows เพื่อรับ Windows Server Failover Clustering (เทียบกับ Linux แบบโอเพ่นซอร์สฟรี) หรือให้สิทธิ์ Enterprise Edition ของ SQL Server เพื่อให้ได้กลุ่มความพร้อมใช้งานเสมอ ก่อนที่จะเสนอคำแนะนำสำหรับการจัดการต้นทุนของคลาวด์สำหรับแอพพลิเคชั่นที่มีความพร้อมใช้งานสูงเป็นสิ่งสำคัญที่จะต้องทราบว่าเป้าหมายที่นี่ไม่ได้ลดค่าใช้จ่ายเหล่านั้น แต่แทนที่จะปรับราคา / ประสิทธิภาพให้เหมาะสมสำหรับแต่ละแอปพลิเคชัน กล่าวอีกอย่างหนึ่งก็คือเหมาะสมที่จะจ่ายมากขึ้นเมื่อจัดสรรทรัพยากรสำหรับแอปพลิเคชันเหล่านั้นที่ต้องการประสิทธิภาพการทำงานที่สูงขึ้นและปริมาณงานที่สูงขึ้น เป็นสิ่งสำคัญที่จะต้องทราบว่าโครงสร้างพื้นฐานคลาวด์ไฮบริด – ซึ่งมีแอพพลิเคชั่นที่ทำงานอยู่ทั้งหมดหรือบางส่วนในระบบคลาวด์ส่วนตัวและสาธารณะ – จะเป็นวิธีที่ดีที่สุดในการบรรลุราคา / ประสิทธิภาพที่ดีที่สุด

การทำความเข้าใจรูปแบบธุรกิจและราคาของผู้ให้บริการคลาวด์

ประสบการณ์ช็อตสติกเกอร์แสดงให้เห็นถึงความต้องการที่จะเข้าใจอย่างถ่องแท้ว่าบริการคลาวด์มีราคาและการจัดการต้นทุนของคลาวด์สำหรับแอพพลิเคชั่นที่มีความพร้อมใช้งานสูง บริการที่มีอยู่เท่านั้นจึงจะสามารถใช้ประโยชน์ได้อย่างคุ้มค่าที่สุด ผู้ให้บริการคลาวด์ทั้งหมด (CSPs) เผยแพร่การกำหนดราคา เว้นแต่จะระบุไว้ในข้อตกลงการบริการการกำหนดราคานั้นเปลี่ยนแปลงตลอดเวลา ทรัพยากรบนฮาร์ดแวร์ทั้งหมดรวมถึงการคำนวณทางกายภาพและเสมือนการเก็บข้อมูลและบริการเครือข่ายย่อมมีต้นทุนทางตรงหรือทางอ้อม สิ่งเหล่านี้ล้วนมีพื้นฐานอยู่บนขอบเขตพลังงานและการทำความเย็นของระบบเหล่านี้ สำหรับซอฟต์แวร์โอเพ่นซอร์สนั้นฟรี แต่ระบบปฏิบัติการเชิงพาณิชย์และ / หรือซอฟต์แวร์แอปพลิเคชันทั้งหมดจะต้องเสียค่าธรรมเนียมใบอนุญาต และได้รับการเตือนล่วงหน้าว่าการออกใบอนุญาตใช้ซอฟต์แวร์และรูปแบบการกำหนดราคาบางอย่างอาจค่อนข้างซับซ้อน ดังนั้นโปรดศึกษาด้วยความระมัดระวัง นอกเหนือจากค่าใช้จ่ายพื้นฐานเหล่านี้สำหรับฮาร์ดแวร์และซอฟต์แวร์แล้วยังมีค่าใช้จ่ายตามสั่งสำหรับบริการเสริมต่างๆ ซึ่งรวมถึงข้อกำหนดด้านความปลอดภัยสมดุลภาระและการป้องกันข้อมูล นอกจากนี้ยังอาจมีค่าใช้จ่าย "ซ่อนเร้น" สำหรับ I / O สำหรับการจัดเก็บหรือในไมโครไซต์ที่แจกจ่ายหรือสำหรับการใช้ประโยชน์สูงสุดที่เกิดขึ้นเพียงเล็กน้อยในช่วง "ระเบิด" เนื่องจาก CSP ทุกแห่งมีรูปแบบธุรกิจและการกำหนดราคาที่ไม่เหมือนใคร . และโดยทั่วไปทรัพยากรที่มีราคาแพงที่สุดนั้นเกี่ยวข้องกับการคำนวณการออกใบอนุญาตใช้ซอฟต์แวร์และการเคลื่อนย้ายข้อมูล พวกเขาช่วยกันคิดเป็น 80% หรือมากกว่าของค่าใช้จ่ายทั้งหมด การเคลื่อนย้ายข้อมูลอาจมีค่าใช้จ่าย WAN แยกต่างหากซึ่งไม่รวมอยู่ในใบเรียกเก็บเงินจาก CSP การจัดเก็บและระบบเครือข่ายภายในโครงสร้างพื้นฐานของ CSP มักเป็นทรัพยากรที่มีค่าใช้จ่ายน้อยที่สุด โซลิดสเตทไดรฟ์ (SSDs) โดยทั่วไปจะมีราคาสูงกว่าสื่อแบบหมุนได้ต่อหนึ่งเทราไบต์ แต่ SSD ยังมอบประสิทธิภาพที่เหนือกว่าดังนั้นราคา / ประสิทธิภาพอาจเปรียบเทียบหรือดีกว่า และในขณะที่การย้ายข้อมูลกลับไปยังองค์กรอาจมีราคาแพงการย้ายข้อมูลจากองค์กรไปยังระบบคลาวด์สาธารณะสามารถทำได้โดยไม่เสียค่าใช้จ่าย (แม้จะมีค่าใช้จ่าย WAN แยกต่างหาก)

การกำหนดกลยุทธ์เพื่อเพิ่มประสิทธิภาพราคา / ประสิทธิภาพ

การครอบคลุมค่าใช้จ่ายของคลาวด์สำหรับแอพพลิเคชั่นที่มีความพร้อมใช้งานสูงจำเป็นต้องมีการตรวจสอบอย่างพิถีพิถัน ต่อไปนี้เป็นคำแนะนำสำหรับการจัดการการใช้ทรัพยากรในระบบคลาวด์สาธารณะด้วยวิธีการที่สามารถลดต้นทุนในขณะที่รักษาระดับการบริการที่เหมาะสมสำหรับแอปพลิเคชันทั้งหมด ซึ่งรวมถึงผู้ที่ต้องการภารกิจที่สำคัญเวลาทำงานสูงและปริมาณงาน โดยทั่วไปการกำหนดขนาดที่เหมาะสมเป็นหลักการพื้นฐานสำหรับการจัดการการใช้ทรัพยากรเพื่อให้ได้ราคา / ประสิทธิภาพที่เหมาะสม เมื่อวิลลี่ซัตตันถูกถามว่าทำไมเขาถึงปล้นธนาคารเขาจึงตอบว่า“ เพราะนั่นคือที่ที่เงินอยู่” ในคลาวด์เงินอยู่ในการคำนวณทรัพยากรดังนั้นสิ่งที่ควรให้ความสำคัญสูงสุดสำหรับการปรับขนาดให้เหมาะสม สำหรับแอปพลิเคชันใหม่ให้เริ่มต้นด้วยการกำหนดค่าเครื่องเสมือนน้อยที่สุดเพื่อคำนวณทรัพยากร เพิ่มแกน CPU, หน่วยความจำและ / หรือ I / O เท่านั้นตามต้องการเพื่อให้ได้ประสิทธิภาพที่น่าพอใจ เครื่องเสมือนทั้งหมดสำหรับแอปพลิเคชันที่มีอยู่ควรมีขนาดที่เหมาะสม เริ่มต้นด้วยสิ่งที่คุ้มค่าที่สุด ลดการจัดสรรทีละน้อยในขณะที่ตรวจสอบประสิทธิภาพอย่างต่อเนื่องจนกว่าจะได้รับผลตอบแทนลดลง เป็นที่น่าสังเกตว่าความเสี่ยงที่สำคัญที่เกี่ยวข้องกับการปรับขนาดที่เหมาะสมคือโอกาสในการปรับขนาด อย่างไรก็ตามอาจส่งผลให้ประสิทธิภาพต่ำ น่าเสียดายวิธีที่ดีที่สุดในการประเมินประสิทธิภาพที่แท้จริงของแอปพลิเคชันคือปริมาณงานการผลิตทำให้โลกแห่งความจริงเป็นสถานที่ที่เหมาะสมกับขนาดที่เหมาะสม โชคดีที่ระบบคลาวด์ช่วยลดความเสี่ยงนี้ด้วยการทำให้การปรับขนาดการกำหนดค่าตามความต้องการเป็นเรื่องง่าย ดังนั้นขนาดที่เหมาะสมอุกอาจในกรณีที่จำเป็น อย่างไรก็ตามเตรียมพร้อมที่จะตอบสนองอย่างรวดเร็วในการตอบสนองต่อการเปลี่ยนแปลงแต่ละอย่าง การจัดเก็บในทางตรงกันข้ามกับการคำนวณโดยตรงนั้นโดยทั่วไปจะมีราคาไม่แพงในระบบคลาวด์ แต่ต้องระวังการใช้ที่เก็บข้อมูลราคาถูกเพราะ I / O อาจต้องเสียค่าใช้จ่ายแยกต่างหากและเสียค่าใช้จ่ายกับบริการบางอย่าง หากเป็นเช่นนั้นให้ใช้ประโยชน์จากเทคโนโลยีการเพิ่มประสิทธิภาพที่คุ้มค่ามากขึ้นเช่นการจัดเก็บข้อมูลแบบทำเป็นชั้นการแคชและ / หรือฐานข้อมูลในหน่วยความจำ (ถ้ามี) เพื่อเพิ่มประสิทธิภาพการใช้ประโยชน์จากทรัพยากรทั้งหมด ลิขสิทธิ์ซอฟต์แวร์อาจเป็นค่าใช้จ่ายจำนวนมากทั้งในระบบคลาวด์ส่วนตัวและสาธารณะ ด้วยเหตุนี้องค์กรจำนวนมากจึงย้ายจาก Windows ไปยัง Linux และจาก SQL Server ไปยังฐานข้อมูลเชิงพาณิชย์และ / หรือโอเพ่นซอร์สที่ราคาไม่แพง แต่สำหรับแอพพลิเคชั่นเหล่านั้นที่รับประกันระบบปฏิบัติการ“ พรีเมี่ยม” และ / หรือแอพพลิเคชั่นซอฟต์แวร์ให้ตรวจสอบ CSP ต่างๆเพื่อดูว่ารูปแบบการกำหนดราคาใด ๆ อาจประหยัดค่าใช้จ่ายสำหรับการกำหนดค่าที่ต้องการ สุดท้าย CSP ทั้งหมดเสนอส่วนลดและการรวมกันของสิ่งเหล่านี้บางครั้งสามารถบรรลุการประหยัดสูงสุดถึง 50% ตัวอย่างรวมถึงการชำระเงินล่วงหน้าสำหรับบริการการทำสัญญาบริการและ / หรือย้ายแอพพลิเคชั่นไปยังภูมิภาคอื่น

การสร้างและบังคับใช้การควบคุมการควบคุมต้นทุน

การจัดเตรียมตนเองสำหรับบริการคลาวด์อาจเป็นที่นิยมของผู้ใช้ แต่หากไม่มีการควบคุมที่เหมาะสมความสะดวกนี้ทำให้ง่ายต่อการใช้ทรัพยากรมากเกินไปรวมถึงสิ่งที่มีค่าใช้จ่ายมากที่สุด เริ่มต้นความพยายามที่จะได้รับการควบคุมที่ดีขึ้นโดยการใช้ประโยชน์อย่างเต็มที่จากเครื่องมือการตรวจสอบและการจัดการ CSP ทั้งหมดที่มีให้ นี้มีแนวโน้มที่จะพบกับช่วงการเรียนรู้ของหลักสูตร เนื่องจากเครื่องมือของ CSP อาจแตกต่างจากและอาจซับซ้อนกว่าเครื่องมือที่ใช้ในคลาวด์ส่วนตัว หนึ่งในเครื่องมือการ จำกัด ต้นทุนที่มีประโยชน์นั้นเกี่ยวข้องกับการติดแท็กทรัพยากร แท็กประกอบด้วยคู่ของคีย์ / ค่าและข้อมูลเมตาที่เชื่อมโยงกับทรัพยากรแต่ละรายการ และบางอย่างอาจเป็นเม็ดเล็ก ๆ ตัวอย่างเช่นเครื่องเสมือนแต่ละเครื่องพร้อมกับ CPU หน่วยความจำ I / O และทรัพยากรที่เรียกเก็บเงินได้อื่น ๆ ที่ใช้อาจมีแท็ก แท็กที่มีประโยชน์อื่น ๆ อาจแสดงว่าแอปพลิเคชันใดอยู่ในสภาพแวดล้อมการผลิตเทียบกับสภาพแวดล้อมการพัฒนาหรือแต่ละศูนย์ต้นทุนหรือแผนกใดได้รับมอบหมาย โดยรวมแล้วแท็กเหล่านี้อาจเป็นการใช้ทรัพยากรโดยรวมที่แสดงในใบเรียกเก็บเงิน องค์กรที่ใช้บริการคลาวด์สาธารณะอย่างกว้างขวางอาจได้รับการบริการอย่างดีเพื่อสร้างสคริปต์ รวมข้อมูลการโหลดจากเครื่องมือตรวจสอบการจัดการและการติดแท็กที่มีอยู่ทั้งหมดลงในสเปรดชีตหรือแอปพลิเคชันที่คล้ายกันสำหรับการวิเคราะห์โดยละเอียดและการใช้งานอื่น ๆ เช่นการเรียกเก็บเงินคืนการปฏิบัติตามข้อกำหนดและแนวโน้ม / งบประมาณ ตามหลักการแล้วข้อมูลจาก CSP ทั้งหมดและคลาวด์ส่วนตัวจะถูกทำให้เป็นมาตรฐานสำหรับการรวมไว้ในมุมมองแบบองค์รวมเพื่อเปิดใช้งานการปรับราคา / ประสิทธิภาพสำหรับแอปพลิเคชันทั้งหมดที่ทำงานทั่วทั้งระบบคลาวด์ไฮบริด

การจัดการกรณีการใช้เคสที่แย่ที่สุด: แอปพลิเคชั่นที่มีความพร้อมใช้งานสูง

นอกเหนือจากเหตุผลที่อ้างถึงในการแนะนำว่าทำไมแอปพลิเคชันที่มีความพร้อมใช้งานสูงมักจะมีราคาแพงที่สุด CSP หลักทั้งสามคือ Google, Microsoft และ Amazon มีข้อ จำกัด เกี่ยวกับความพร้อมใช้งานสูงอย่างน้อย ตัวอย่างรวมถึงความล้มเหลวที่เกิดจากการขัดข้องของโซนและไม่ได้เกิดจากความล้มเหลวทั่วไปอื่น ๆ อีกมากมาย อินสแตนซ์หลักสามารถสร้างแบบจำลองการเฟลโอเวอร์เพียงครั้งเดียวเท่านั้น และการใช้บันทึกเหตุการณ์เพื่อทำซ้ำข้อมูลซึ่งสร้าง“ ความล่าช้าในการจำลองแบบ” ซึ่งอาจส่งผลให้เกิดการหยุดทำงานชั่วคราวในระหว่างที่เกิดความล้มเหลว แน่นอนว่าไม่มีข้อ จำกัด ใด ๆ ที่จะผ่านไม่ได้และมีงบประมาณมากพอสมควร ความท้าทายคือการค้นหาโซลูชันทั่วไปและคุ้มค่าสำหรับการใช้งานความพร้อมใช้งานสูงในระบบคลาวด์สาธารณะส่วนตัวและไฮบริด ในบรรดาโซลูชันที่หลากหลายและราคาไม่แพงที่สุดก็คือคลัสเตอร์พื้นที่จัดเก็บข้อมูล (SAN) ที่ไม่มีการทำงานล้มเหลว โซลูชันความพร้อมใช้งานสูงเหล่านี้มีการใช้งานอย่างสมบูรณ์ในซอฟต์แวร์ที่สร้างขึ้นโดยมีจุดประสงค์เพื่อสร้าง ตามที่ระบุโดยชื่อคลัสเตอร์ที่ไม่มีอะไรที่แบ่งใช้ของเซิร์ฟเวอร์และหน่วยเก็บข้อมูลที่มี failover อัตโนมัติทั่วทั้งเครือข่ายท้องถิ่นและ / หรือ WAN เพื่อรับรองความพร้อมใช้งานสูงในระดับแอปพลิเคชัน โซลูชันเหล่านี้ส่วนใหญ่มีการรวมกันของการจำลองข้อมูลระดับบล็อกแบบเรียลไทม์การตรวจสอบแอปพลิเคชันอย่างต่อเนื่องและนโยบายการกู้คืนความล้มเหลว / ล้มเหลวที่กำหนดค่าได้ คลัสเตอร์ failover SAN ที่มีความทนทานน้อยกว่าบางตัวยังมีความสามารถขั้นสูง ตัวอย่างเช่นการปรับให้เหมาะสม WAN เพื่อเพิ่มประสิทธิภาพและลดการใช้แบนด์วิดท์การสนับสนุนที่แข็งแกร่งสำหรับ SQL Server Standard Edition ที่ราคาถูกกว่า และอย่าลืมการสลับการทำงานด้วยตนเองของการกำหนดเซิร์ฟเวอร์หลักและรองสำหรับการบำรุงรักษาตามแผนและความสามารถในการสำรองข้อมูลตามปกติโดยไม่ทำให้แอปพลิเคชันหยุดชะงัก

การรักษามุมมองที่เหมาะสม

ในขณะที่ลองใช้คำแนะนำเหล่านี้ในระบบคลาวด์ไฮบริดของคุณพยายามที่จะรักษาค่า CSP รายเดือนไว้ในมุมมองที่เหมาะสม ด้วยคลาวด์สาธารณะค่าใช้จ่ายทั้งหมดจะปรากฏในใบแจ้งหนี้ใบเดียว ในทางตรงกันข้ามค่าใช้จ่ายทั้งหมดในการใช้งานระบบคลาวด์ส่วนตัวนั้นแทบจะไม่ถูกนำเสนอในรูปแบบที่สมบูรณ์และรวมกัน และถ้าเป็นเช่นนั้นค่าใช้จ่ายทั้งหมดอาจทำให้เกิดการกระแทกของสติกเกอร์ ดังนั้นการออกกำลังกายที่มีประโยชน์อาจเข้าใจค่าใช้จ่ายทั้งหมดในการใช้งานระบบคลาวด์ส่วนตัวโดยไม่ต้องเสียค่าใช้จ่ายใด ๆ ราวกับว่าเป็นธุรกิจเดี่ยวเช่นผู้ให้บริการคลาวด์ ดังนั้นค่าใช้จ่ายเหล่านั้นจาก CSP สำหรับแอปพลิเคชันที่สำคัญต่อภารกิจของคุณอาจไม่น่าตกใจนัก บทความจาก www.dbta.com

Filed Under: ข่าวสารและกิจกรรม Tagged With: ต้นทุนคลาวด์สำหรับแอพพลิเคชั่นที่มีความพร้อมใช้งานสูง

ความท้าทายในความพร้อมใช้งานสูงสำหรับการใช้งานที่มีความสำคัญต่อภารกิจใน SME

มกราคม 20, 2019 by Jason Aw Leave a Comment

ความพร้อมใช้งานสูง

สำรวจสถานะของประสิทธิภาพและความพร้อมใช้งานสูงสำหรับแอปพลิเคชันที่มีความสำคัญต่อธุรกิจใน SME

จากการสำรวจครั้งใหม่โดย SIOS Technology โดยความร่วมมือกับ ActualTech Media Research พบว่าการติดตั้งระบบคลาวด์เต็มรูปแบบ 98% ประสบปัญหาด้านประสิทธิภาพบางประเภททุกปี การสำรวจถูกออกแบบมาเพื่อทำความเข้าใจกับความท้าทายและแนวโน้มในปัจจุบันที่เกี่ยวข้องกับสถานะของประสิทธิภาพและความพร้อมใช้งานสูงสำหรับแอปพลิเคชันที่สำคัญต่อภารกิจใน บริษัท ขนาดเล็กกลางและใหญ่ ผู้เชี่ยวชาญด้านไอทีและผู้มีอำนาจตัดสินใจจำนวน 390 คนได้ตอบสนองโดยรวมเป็นตัวแทนของแผนกที่รับผิดชอบการจัดการฐานข้อมูลโครงสร้างพื้นฐานสถาปัตยกรรมบริการคลาวด์และการพัฒนาซอฟต์แวร์ แอปพลิเคชัน Tier-1 ที่ระบุอย่างชัดเจนรวมถึง Oracle, Microsoft SQL Server และ SAP / HANA มีแนวโน้มที่ชัดเจน ความประหลาดใจเล็กน้อยที่เราไม่ได้เห็นมาและอาจทำให้คุณประหลาดใจเช่นกัน ■ บริษัท ขนาดเล็กกำลังนำทางไปสู่คลาวด์สาธารณะด้วยการวางแผน 54% เพื่อย้ายแอพพลิเคชั่นที่สำคัญยิ่งไปกว่าครึ่งในปลายปี 2561 ซึ่งเปรียบเทียบกับ 42% ของ บริษัท ขนาดใหญ่■สำหรับ บริษัท ทุกขนาดมีการควบคุมที่สมบูรณ์ สภาพแวดล้อมของแอปพลิเคชันได้รับการอ้างถึง 60% ของผู้ตอบแบบสอบถามว่าเป็นเหตุผลสำคัญว่าทำไมภาระงานที่มีความสำคัญต่อภารกิจยังคงอยู่ในสถานที่■องค์กรส่วนใหญ่ (86%) ใช้รูปแบบการเข้าแทนที่แบบล้มเหลว แอปพลิเคชั่น■เกือบจะมากที่สุด (95%) รายงานว่าประสบกับความล้มเหลวของบทบัญญัติการเฟลโอเวอร์มันเห็นได้ชัดว่าในที่สุดองค์กรต่างๆก็กำลังย้ายแอพพลิเคชั่นที่สำคัญไปสู่คลาวด์ และก้าวที่ยิ่งใหญ่กว่าที่เราจะจินตนาการได้ไม่กี่ปีที่ผ่านมา แต่พวกเขายังอยู่ในช่วงเริ่มต้นของการนำไปใช้วางการดำเนินงานที่เป็นผู้ใหญ่ไม่กี่ปี นี่คือรายละเอียดเพิ่มเติมบางส่วน

Misery รัก บริษัท

ผู้ตอบแบบสอบถามเพียง 2% อ้างว่าพวกเขาไม่เคยประสบปัญหาประสิทธิภาพการทำงานของแอปพลิเคชั่นใด ๆ ที่ส่งผลกระทบต่อผู้ใช้ปลายทาง พวกเราที่เหลือเป็นแค่มนุษย์เท่านั้นที่อ้างว่าประสบปัญหาดังกล่าว นี่คือสถิติโดยเฉลี่ย

  • ทุกวัน (18%)
  • 2-3 ครั้งต่อสัปดาห์ (17%)
  • หนึ่งครั้งต่อสัปดาห์ (10%)
  • 2-3 ครั้งต่อเดือน (15%)
  • เดือนละครั้ง (11%)
  • 3-5 ครั้งต่อปี (18%)
  • ปีละครั้งเท่านั้น (8%)

คำตอบมีความสอดคล้องกันอย่างสมเหตุสมผลในกลุ่มผู้มีอำนาจตัดสินใจเจ้าหน้าที่ด้านไอทีและพนักงานฝ่ายข้อมูลและพัฒนาโดยมีข้อยกเว้นที่โดดเด่นอย่างหนึ่งคือผู้ตัดสินใจจะรับรู้ปัญหาการปฏิบัติงานที่ต่ำกว่าที่พนักงานทำ เกือบครึ่ง (46%) ของผู้มีอำนาจตัดสินใจตอบว่าปัญหาเรื่องประสิทธิภาพเกิดขึ้น 3-5 ครั้งต่อปีหรือน้อยกว่า (เทียบกับ 23-25% สำหรับพนักงาน) มีเพียง 11% เท่านั้นที่ตอบว่าปัญหาเกิดขึ้นทุกวัน (เทียบกับ 20-21% สำหรับพนักงาน)

การตอบสนองอย่างรวดเร็วต่อการช่วยเหลือ

คำอธิบายที่เป็นไปได้หนึ่งข้อสำหรับความคลาดเคลื่อนที่เห็นได้ชัดนี้คือเจ้าหน้าที่ไอทีกำลังรับรู้ถึงปัญหาที่ส่งผลต่อประสิทธิภาพด้วยการแจ้งเตือนอัตโนมัติ ตามด้วยการตอบสนองอย่างรวดเร็วเพื่อค้นหาและแก้ไขสาเหตุ แบบสำรวจถามเกี่ยวกับข้อกำหนดความพร้อมใช้งานสูงที่ล้มเหลว (บางสิ่งที่แน่นอนที่ส่งผลต่อประสิทธิภาพ!) เรียนรู้ปัญหา 77% ผ่านการเตือนจากเครื่องมือตรวจสอบ อีก 39% เรียนรู้จากการร้องเรียนของผู้ใช้ (โปรดทราบว่าอนุญาตการตอบกลับหลายครั้ง) สำหรับการแก้ไขจะใช้เวลานานกว่า 5 ชั่วโมงในการแก้ไขปัญหาเพียง 3% ของเวลา เกือบหนึ่งในสี่ (23%) ได้รับการแก้ไขในเวลาน้อยกว่าหนึ่งชั่วโมงและมากกว่าครึ่งหนึ่ง (56%) ได้รับการแก้ไขใน 1-3 ชั่วโมง ในที่สุด 18% จะได้รับการแก้ไขใน 3-5 ชั่วโมง บริษัท ขนาดเล็กสามารถแก้ไขปัญหาได้เร็วขึ้น (31% ในเวลาน้อยกว่าหนึ่งชั่วโมง) มากกว่า บริษัท ขนาดใหญ่ (เพียง 11% ในเวลาน้อยกว่าหนึ่งชั่วโมง) สิ่งนี้น่าจะเป็นเพราะในอดีตนั้นใช้ระบบคลาวด์สาธารณะอย่างกว้างขวางมากขึ้นและมีการกำหนดค่าที่ซับซ้อนน้อยกว่า

ผู้ร้ายในคลาวด์

เมื่อถามถึงสาเหตุของปัญหาประสิทธิภาพที่เกิดขึ้นในระบบคลาวด์ผู้ร้ายหลักคือแอปพลิเคชันหรือฐานข้อมูลที่ใช้ พวกเขาช่วยกันคิดเป็น 64% ของปัญหา เป็นสิ่งสำคัญที่จะต้องทราบว่าคำถามนี้ไม่ได้แยกแยะว่าใครเป็นผู้รับผิดชอบการจัดการแอปพลิเคชันและ / หรือฐานข้อมูล สาเหตุเพิ่มเติมรวมถึงปัญหากับผู้ให้บริการ (17%) หรือโครงสร้างพื้นฐาน (15%) ใน 4% ของกรณีปัญหายังคงเป็นปริศนา

เขียนโดย Jerry Melnick ประธานและซีอีโอของ SIOS Technology
ทำซ้ำจาก APMdigest

Filed Under: ข่าวสารและกิจกรรม

  • « Previous Page
  • 1
  • …
  • 19
  • 20
  • 21
  • 22
  • 23
  • …
  • 77
  • Next Page »

โพสต์ล่าสุด

  • ระบบความพร้อมใช้งานสูง (High Availability หรือ HA) คืออะไร?
  • เอาตัวรอดจากวิกฤตการณ์วันศุกร์: จากระบบคอมพิวเตอร์แบบดิบๆ สู่การจำลองข้อมูลที่ราบรื่น
  • ติดดิน: สิ่งที่การพลาดชม Percona Live Amsterdam สอนฉันเกี่ยวกับ HA
  • เปรียบเทียบ SIOS LifeKeeper กับ Red Hat High Availability Add-On:
  • สถานะของความยืดหยุ่นของแอปพลิเคชัน: ผลสำรวจความพร้อมใช้งานสูงของ SIOS ปี 2026

กระทู้ยอดนิยม

เข้าร่วมรายชื่อผู้รับจดหมายของเรา

Copyright © 2026 · Enterprise Pro Theme on Genesis Framework · WordPress · Log in