SIOS SANless clusters

SIOS SANless clusters High-availability Machine Learning monitoring

  • Home
  • Products
    • SIOS DataKeeper for Windows
    • SIOS Protection Suite for Linux
  • การทดสอบอาหารสัตว์
  • ข่าวสารและกิจกรรม
  • ทำให้เข้าใจง่ายเซิร์ฟเวอร์คลัสเตอร์
  • เรื่องราวความสำเร็จ
  • ติดต่อเรา
  • English
  • 中文 (中国)
  • 中文 (台灣)
  • 한국어
  • Bahasa Indonesia
  • ไทย

การจัดการการกู้คืนตามเวลาจริงใน Cloud Outage ที่สำคัญ

มกราคม 19, 2019 by Jason Aw Leave a Comment

การจัดการการกู้คืนตามเวลาจริงใน Cloud Outage ที่สำคัญ

การจัดการการกู้คืนตามเวลาจริงใน Cloud Outage ที่สำคัญ

ภัยพิบัติเกิดขึ้นทำให้ความเป็นจริงหยุดทำงานกะทันหัน แต่มีหลายสิ่งที่ลูกค้าทุกคนสามารถทำได้เพื่อความอยู่รอดของระบบคลาวด์ สิ่งที่เกิดขึ้น ความล้มเหลว – ทั้งเล็กและใหญ่ – หลีกเลี่ยงไม่ได้ สิ่งที่หลีกเลี่ยงไม่ได้คือการขยายเวลาหยุดทำงาน พิจารณาวันที่ภาคกลางของสหรัฐอเมริกาทางใต้ของ Azure cloud ของ Microsoft ประสบความล้มเหลวอย่างรุนแรง พายุฝนฟ้าคะนองรุนแรงนำไปสู่การเรียงลำดับของปัญหาที่ในที่สุดก็ทำให้ศูนย์ข้อมูลทั้งหมดล้มเหลว ในสิ่งที่บางคนเรียกว่า "The Day the Azure Cloud Fell from the Sky" ลูกค้าส่วนใหญ่ออฟไลน์ไม่ใช่เพียงแค่ไม่กี่วินาทีหรือนาที แต่สำหรับทั้งวัน บางคนออฟไลน์นานกว่าสองวัน ในขณะที่ไมโครซอฟท์ได้กล่าวถึงปัญหาต่าง ๆ ที่นำไปสู่การหยุดทำงาน แต่ผู้เชี่ยวชาญด้านไอทีจะจดจำเหตุการณ์นี้ได้นาน นั่นเป็นข่าวร้าย ข่าวดีก็คือ: มีทุกสิ่งที่ลูกค้า Azure ทุกคนสามารถทำได้เพื่อให้สามารถอยู่รอดได้ในทุกสถานการณ์ อาจมาจากเซิร์ฟเวอร์เดียวที่ล้มเหลวไปจนถึงศูนย์ข้อมูลทั้งหมดที่ออฟไลน์ ในความเป็นจริงลูกค้า Azure ที่ใช้ข้อกำหนดด้านความพร้อมใช้งานสูงและ / หรือการกู้คืนความเสียหายที่สมบูรณ์พร้อมด้วยการจำลองข้อมูลตามเวลาจริงและการล้มเหลวอัตโนมัติที่รวดเร็วสามารถคาดหวังว่าจะไม่มีการสูญหายของข้อมูล ดูเพิ่มเติมที่: Nutanix มองเห็นคลาวด์ขององค์กรที่ชนะการแข่งขันคลาวด์

การจัดการ The Cloud Outage

บทความนี้ตรวจสอบสี่ตัวเลือกสำหรับการให้การกู้คืนความเสียหาย (DR) และความพร้อมใช้งานสูง (HA) ในการกำหนดค่าระบบคลาวด์แบบไฮบริดและ Azure ล้วนๆ ตัวเลือกสองตัวเลือกเฉพาะสำหรับฐานข้อมูล Microsoft SQL Server ซึ่งเป็นแอปพลิเคชั่นยอดนิยมในระบบคลาวด์ Azure อีกสองตัวเลือกคือโปรแกรมไม่เชื่อเรื่องพระเจ้า ตัวเลือกสี่ตัวเลือกซึ่งสามารถใช้ในชุดค่าผสมต่าง ๆ เปรียบเทียบในตารางและรวมถึง:

  • บริการ Azure Site Recovery (ASR)
  • SQL Server Failover Cluster อินสแตนซ์ที่มีพื้นที่เก็บข้อมูลโดยตรง
  • SQL Server บนกลุ่มความพร้อมใช้งานเสมอ
  • ซอฟต์แวร์การทำคลัสเตอร์ Failover บุคคลที่สาม
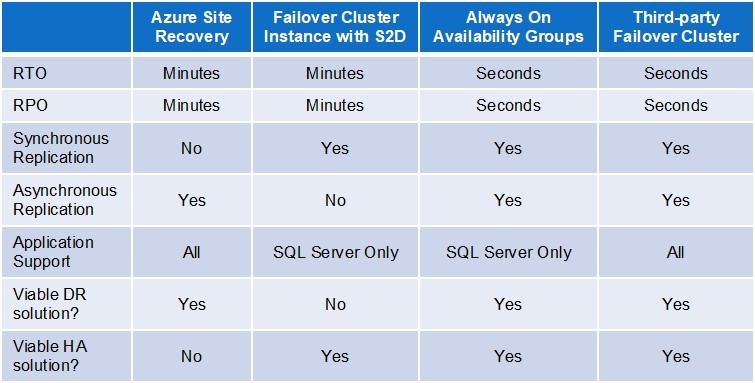
RT Insights SIOS_Real-timeRecovery สำหรับ Cloud Outage_181119

RTO และ RPO 101

ก่อนที่จะอธิบายถึงสี่ตัวเลือกจำเป็นต้องมีความเข้าใจพื้นฐานของตัวชี้วัดสองตัวที่ใช้ในการประเมินประสิทธิภาพของบทบัญญัติ DR และ HA: เวลาในการกู้คืนวัตถุประสงค์และวัตถุประสงค์ของจุดกู้คืน ผู้ที่คุ้นเคยกับ RTO และ RPO สามารถข้ามส่วนนี้ได้ RTO เป็นระยะเวลาที่ยอมรับได้สูงสุดของการหยุดทำงาน โดยทั่วไปแอปพลิเคชันการประมวลผลธุรกรรมออนไลน์มี RTO ที่ต่ำที่สุดและแอปพลิเคชันที่สำคัญต่อภารกิจมักมี RTO เพียงไม่กี่วินาที RPO เป็นช่วงเวลาสูงสุดในระหว่างที่สามารถทนต่อการสูญเสียข้อมูล หากไม่มีการสูญเสียข้อมูลที่ยอมรับได้ RPO จะเป็นศูนย์ ปกติแล้ว RTO จะกำหนดประเภทของการป้องกัน HA และ / หรือ DR ที่จำเป็น เวลาในการกู้คืนที่ต่ำมักจะต้องการบทบัญญัติ HA ที่แข็งแกร่งซึ่งป้องกันระบบปกติและความล้มเหลวของซอฟต์แวร์ในขณะที่ RTOs อีกต่อไปสามารถพึงพอใจกับบทบัญญัติ DR พื้นฐานที่ออกแบบมาเพื่อป้องกันการแพร่กระจายที่แพร่หลายมากขึ้น การจำลองข้อมูลที่ใช้กับบทบัญญัติ HA และ DR สามารถสร้างความต้องการการแลกเปลี่ยนที่เป็นไปได้ระหว่าง RTO และ RPO ในสภาพแวดล้อม LAN ที่มีความหน่วงต่ำซึ่งการจำลองข้อมูลสามารถซิงโครไนซ์ชุดข้อมูลหลักและชุดรองสามารถอัปเดตพร้อมกันได้ สิ่งนี้ช่วยให้การกู้คืนเต็มรูปแบบเกิดขึ้นโดยอัตโนมัติและในเวลาจริงทำให้สามารถตอบสนองเวลาการกู้คืนและวัตถุประสงค์ของจุดกู้คืนที่ต้องการได้มากที่สุด (ไม่กี่วินาทีและศูนย์ตามลำดับ) โดยไม่จำเป็นต้องแลกเปลี่ยน ในทางตรงกันข้ามการบังคับให้หลักรอให้รองเพื่อยืนยันความสมบูรณ์ของการอัปเดตสำหรับทุกธุรกรรมจะส่งผลเสียต่อประสิทธิภาพการทำงาน ด้วยเหตุนี้การจำลองข้อมูลใน WAN จึงมักจะไม่ตรงกัน สิ่งนี้สามารถสร้างการแลกเปลี่ยนระหว่างการรองรับ RTO และ RPO ซึ่งโดยปกติแล้วจะส่งผลให้เวลาการกู้คืนเพิ่มขึ้น นี่คือเหตุผล: เพื่อให้เป็นไปตาม RPO ศูนย์ต้องดำเนินการด้วยตนเองเพื่อให้แน่ใจว่าข้อมูลทั้งหมด (เช่นจากบันทึกธุรกรรม) ได้รับการทำซ้ำอย่างสมบูรณ์ในลำดับที่สองก่อนที่จะเกิดความล้มเหลวเกิดขึ้นความพยายามพิเศษนี้ มักใช้สำหรับ DR ไม่ใช่ HA

บริการ Azure Site Recovery (ASR)

ASR เป็นการนำเสนอ DR-as-a-service (DRaaS) ของ Azure ASR จำลองทั้งเครื่องจริงและเสมือนไปยังไซต์ Azure อื่น ๆ ที่อาจเกิดขึ้นในภูมิภาคอื่น ๆ หรือจากอินสแตนซ์ในสถานที่ไปยังคลาวด์ Azure บริการนี้ให้การกู้คืนที่รวดเร็วพอสมควรจากระบบและสถานที่เกิดเหตุขัดข้องและยังอำนวยความสะดวกในการบำรุงรักษาตามแผนโดยไม่ต้องหยุดทำงานในระหว่างการอัพเกรดซอฟต์แวร์ เช่นเดียวกับข้อเสนอ DRaaS ทั้งหมด ASR มีข้อ จำกัด บางประการการที่ร้ายแรงที่สุดคือการไม่สามารถตรวจจับและล้มเหลวจากความล้มเหลวจำนวนมากที่ทำให้แอปพลิเคชันหยุดทำงานโดยอัตโนมัติ แน่นอนนี่คือเหตุผลที่บริการนี้มีลักษณะเป็น DR และไม่ใช่สำหรับ HA ด้วย ASR เวลาในการกู้คืนจะอยู่ที่ประมาณ 3-4 นาทีซึ่งแน่นอนว่าผู้ดูแลระบบสามารถตรวจจับและตอบสนองต่อปัญหาได้อย่างรวดเร็วด้วยตนเองอย่างไร ตามที่อธิบายไว้ข้างต้นความจำเป็นในการจำลองข้อมูลแบบอะซิงโครนัสข้าม WAN สามารถเพิ่มเวลาการกู้คืนสำหรับแอปพลิเคชันที่มี RPO เป็นศูนย์ต่อไป

SQL Server Failover Cluster Instance พร้อมที่เก็บ Spaces โดยตรง

SQL Server มีตัวเลือก HA / DR ของตัวเองสองตัวเลือก: Failover Cluster Instances (ที่กล่าวถึงที่นี่) และ Always On Groups Availability (ที่กล่าวถึงถัดไป) FCIs มีข้อดีสองประการ: คุณสมบัตินี้มีอยู่ใน Standard Edition ที่ราคาถูกกว่าของ SQL Server และไม่ได้ขึ้นอยู่กับการมีพื้นที่เก็บข้อมูลที่ใช้ร่วมกันเหมือนคลัสเตอร์ HA ดั้งเดิม ข้อได้เปรียบหลังนี้มีความสำคัญเนื่องจากพื้นที่เก็บข้อมูลที่ใช้ร่วมกันนั้นไม่มีอยู่ในระบบคลาวด์ – จาก Microsoft หรือผู้ให้บริการคลาวด์อื่น ๆ ทางเลือกที่ได้รับความนิยมสำหรับการจัดเก็บใน Azure cloud คือ Storage Spaces Direct (S2D) ซึ่งรองรับแอพพลิเคชั่นหลากหลายและการสนับสนุนสำหรับ SQL Server จะปกป้องอินสแตนซ์ทั้งหมด ข้อเสียที่สำคัญของ S2D คือเซิร์ฟเวอร์จะต้องอยู่ในดาต้าเซ็นเตอร์เดียวทำให้ตัวเลือกนี้เหมาะสำหรับความต้องการ HA บางอย่าง แต่ไม่ใช่สำหรับ DR สำหรับการปกป้อง HA และ DR แบบหลายไซต์การจำลองข้อมูลที่จำเป็นจะต้องได้รับจากการจัดส่งบันทึกหรือโซลูชันการทำคลัสเตอร์ล้มเหลวของบุคคลที่สาม

SQL Server บนกลุ่มความพร้อมใช้งานเสมอ

ในขณะที่กลุ่มความพร้อมใช้งานตลอดเวลาเป็นข้อเสนอที่มีความสามารถมากที่สุดของ SQL Server สำหรับทั้ง HA และ DR แต่ต้องมีการออกใบอนุญาต Enterprise Edition ที่มีราคาแพงกว่า ตัวเลือกนี้สามารถส่งมอบเวลาการกู้คืน 5-10 วินาทีและจุดการกู้คืนของวินาทีหรือน้อยกว่า นอกจากนี้ยังมีคุณสมบัติที่สองที่สามารถอ่านได้สำหรับการสืบค้นฐานข้อมูล (ด้วยสิทธิ์ใช้งานที่เหมาะสม) และไม่มีข้อ จำกัด เกี่ยวกับขนาดของฐานข้อมูลหรือจำนวนอินสแตนซ์รอง การกำหนดค่ากลุ่มความพร้อมใช้ตลอดเวลาที่ให้การปกป้องทั้ง HA และ DR ประกอบด้วยการจัดเรียงสามโหนดที่มีสองโหนดในชุดความพร้อมใช้งานหรือโซนเดียวและที่สามในภูมิภาค Azure ที่แยกต่างหาก ข้อ จำกัด หนึ่งที่น่าสังเกตคือมีเพียงฐานข้อมูลเท่านั้นที่ถูกจำลองและไม่ใช่อินสแตนซ์ SQL ทั้งหมดซึ่งต้องได้รับการปกป้องด้วยวิธีการอื่น นอกเหนือจากการเป็นฐานข้อมูลที่ต้องห้ามสำหรับแอพพลิเคชั่นฐานข้อมูลบางตัวแล้วแนวทางนี้ก็มีข้อเสียอีกประการหนึ่ง การใช้งานเฉพาะแอพพลิเคชั่นนั้นต้องใช้แผนกไอทีในการบังคับใช้ข้อกำหนด HA และ DR อื่น ๆ สำหรับแอปพลิเคชันอื่นทั้งหมด การใช้โซลูชัน HA / DR หลายตัวสามารถเพิ่มความซับซ้อนและค่าใช้จ่ายได้อย่างมาก (สำหรับการออกใบอนุญาตการฝึกอบรมการติดตั้งและการใช้งานอย่างต่อเนื่อง) จึงเป็นอีกสาเหตุหนึ่งที่ทำให้องค์กรต้องการใช้โซลูชันของบุคคลที่สาม

ซอฟต์แวร์การทำคลัสเตอร์ Failover บุคคลที่สาม

ด้วยการออกแบบแอพพลิเคชั่นที่ไม่เชื่อเรื่องพระเจ้าและแพลตฟอร์มที่ไม่เชื่อเรื่องพระเจ้าซอฟต์แวร์การทำคลัสเตอร์ล้มเหลวสามารถให้บริการโซลูชั่น HA และ DR ที่สมบูรณ์แบบสำหรับการใช้งานแทบทุกประเภทในสภาพแวดล้อมคลาวด์ส่วนตัวสาธารณะและไฮบริด ซึ่งรวมถึงทั้ง Windows และ Linux การเป็นผู้ไม่เชื่อเรื่องการประยุกต์ใช้ทำให้ไม่จำเป็นต้องมีบทบัญญัติ HA / DR ที่แตกต่างกันสำหรับการใช้งานที่แตกต่างกัน การเป็นผู้ไม่เชื่อเรื่องพระเจ้าบนแพลตฟอร์มทำให้สามารถใช้ประโยชน์จากความสามารถและบริการต่าง ๆ ในระบบคลาวด์ Azure รวมถึง Fault Domains, ชุดความพร้อมใช้งานและเขตพื้นที่, คู่ของภูมิภาคและ Azure Site Recovery ในฐานะที่เป็นโซลูชันที่สมบูรณ์ซอฟต์แวร์จะรวมการจำลองข้อมูลอย่างน้อยตามเวลาจริงการตรวจสอบอย่างต่อเนื่องสามารถตรวจจับความล้มเหลวในระดับแอปพลิเคชันและนโยบายที่กำหนดค่าได้สำหรับการเข้าแทนที่และความล้มเหลว โซลูชันส่วนใหญ่ยังมีความสามารถที่เพิ่มมูลค่าหลากหลายที่ช่วยให้คลัสเตอร์ล้มเหลวสามารถส่งมอบการกู้คืนได้ต่ำกว่า 20 วินาทีโดยมีการสูญเสียข้อมูลน้อยที่สุดหรือไม่มีเลยเพื่อตอบสนองความต้องการ HA / DR ทั้งหมด

ทำให้เป็นจริง

ตัวเลือกทั้งสี่ไม่ว่าจะทำงานแยกกันหรืออยู่ในคอนเสิร์ตสามารถมีบทบาทในการปกป้อง DR และ HA อย่างต่อเนื่องมีประสิทธิภาพมากขึ้นและราคาไม่แพงสำหรับแอพพลิเคชั่นขององค์กรอย่างเต็มรูปแบบ ซึ่งรวมถึงผู้ที่สามารถทนต่อการสูญเสียข้อมูลและช่วงเวลาที่หยุดทำงานนานไปจนถึงผู้ที่ต้องการกู้คืนแบบเรียลไทม์เพื่อให้เกิดความพร้อมในการทำงานห้าถึง 9 โดยมีการสูญเสียข้อมูลน้อยที่สุดหรือไม่มีเลย เพื่อความอยู่รอดของระบบคลาวด์ต่อไปในโลกแห่งความเป็นจริงให้ตรวจสอบให้แน่ใจว่าบทบัญญัติ DR และ / หรือ HA ใดที่คุณเลือกได้รับการกำหนดค่าโดยมีโหนดอย่างน้อยสองโหนดกระจายอยู่ทั่วทั้งสองไซต์ นอกจากนี้ต้องแน่ใจว่าเข้าใจว่าบทบัญญัตินั้นสอดคล้องกับเวลาในการกู้คืนและวัตถุประสงค์ของจุดกู้คืนของแต่ละแอปพลิเคชันอย่างไร รวมถึงข้อ จำกัด ใด ๆ ที่อาจมีอยู่รวมถึงความต้องการกระบวนการที่ต้องดำเนินการด้วยตนเองที่จำเป็นในการตรวจสอบความล้มเหลวที่เป็นไปได้ทั้งหมดและทำให้เกิดความล้มเหลวในรูปแบบที่รับประกันความต่อเนื่องของทั้งแอปพลิเคชัน

เกี่ยวกับ Jonathan Meltzer

Jonathan Meltzer เป็นผู้อำนวยการฝ่ายจัดการผลิตภัณฑ์ของ SIOS Technology เขามีประสบการณ์กว่า 20 ปีในการจัดการผลิตภัณฑ์และการตลาดสำหรับซอฟต์แวร์และผลิตภัณฑ์ SaaS ที่ช่วยให้ลูกค้าสามารถจัดการเปลี่ยนแปลงและเพิ่มประสิทธิภาพทุนมนุษย์และทรัพยากรไอทีของพวกเขา ทำซ้ำจาก RTinsights
Filed Under: ข่าวสารและกิจกรรม Tagged With: หลายเมฆ, เซิร์ฟเวอร์ล้มเหลว, โลกไซเบอร์, ไฟดับเมฆ, ไมโครซอฟท์สีฟ้า

การใช้แบบไดนามิก – ความพร้อมใช้งานสูงราคาไม่แพงมากขึ้นการโยกย้ายไปยังคลาวด์

มกราคม 18, 2019 by Jason Aw Leave a Comment

การใช้งานแบบไดนามิกจะทำให้มีความพร้อมใช้งานสูงราคาไม่แพงและการโยกย้ายไปยัง Cloud.jpg

การใช้งานแบบไดนามิกจะทำให้มีความพร้อมใช้งานสูงราคาไม่แพงและการขับเคลื่อนการโยกย้ายไปยังคลาวด์เพิ่มเติม

การจัดสรรตามความต้องการในคลาวด์นั้นไม่มีอะไรใหม่ สิ่งใหม่จะเป็นตัวเลือกที่ประหยัดค่าใช้จ่ายมากขึ้นสำหรับความพร้อมใช้งานสูงและการกู้คืนความเสียหายในไฮบริดและการกำหนดค่าระบบคลาวด์สาธารณะอย่างแท้จริง HA และ DR แบบออนดีมานด์ดังกล่าวจะใช้ประโยชน์จากการใช้ทรัพยากรแบบไดนามิกที่แพร่กระจายไปยังดาต้าเซ็นเตอร์หลายแห่งและภูมิภาคทางภูมิศาสตร์และทำให้การบริการระดับสูงมีราคาไม่แพงสำหรับแอพพลิเคชั่นมากขึ้น

ทั้ง HA และ DR ต้องการความซ้ำซ้อนเพื่อให้มั่นใจได้ว่าจะสามารถกู้คืนได้อย่างรวดเร็วจากความล้มเหลว

การทำคลัสเตอร์ล้มเหลว HA จะทำซ้ำสภาพแวดล้อมการทำงานเต็มรูปแบบของ VM หลักรวมถึง CPU หน่วยความจำและทรัพยากรหน่วยความจำใน VM รอง ข้อมูลทั้งหมดจะถูกเรพลิเคตแบบเรียลไทม์ไปยังข้อมูลรองซึ่งยังคงไม่ได้ทำงานจนกว่าจะมีข้อมูลหลักล้มเหลว การมี VM รองสำรองอย่างน้อยหนึ่งรายการขึ้นไปจะสร้างคลัสเตอร์ที่มีประสิทธิภาพในสถานะการทดสอบตัวเองอย่างต่อเนื่องดังนั้นจึงมั่นใจได้ว่ามีการเตรียมพร้อมสำหรับการ failover อัตโนมัติและรวดเร็ว

ตรงกันข้ามการกำหนดค่า DR พื้นฐานขาดความสามารถที่จำเป็นสำหรับการล้มเหลวอย่างรวดเร็ว

พิจารณาการกู้คืนไซต์ Azure Microsoft วางตำแหน่ง ASR ในฐานะ DR-as-a-service และตอนนี้ตลาด DRaaS ที่กำลังเติบโตรวมถึงข้อเสนอจากผู้ให้บริการเกือบโหล ด้วย ASR VMs หลักจะถูกจำลองแบบไปยังรุ่นที่สองในภูมิภาค Azure อื่น ๆ หรือจากอินสแตนซ์ในสถานที่ไปยังคลาวด์ Azure แต่ข้อมูลจะไม่ถูกจำลองแบบเรียลไทม์ บริการไม่สามารถตรวจจับและล้มเหลวโดยอัตโนมัติจากสาเหตุหลายประการของการหยุดทำงานในระดับแอปพลิเคชัน

ปัญหาพื้นฐาน

DRaaS และบริการความพร้อมใช้งานบนคลาวด์อื่น ๆ โดยทั่วไปตรวจพบการสูญเสียบริการทั้งหมด แต่ข้อผิดพลาดอันเนื่องมาจากแอพพลิเคชั่นหรือซอฟต์แวร์ระบบปฏิบัติการรวมถึงความล้มเหลวในทรัพยากรที่ไม่ต่อเนื่องเช่นเครือข่ายหรือที่จัดเก็บข้อมูลจะไม่ถูกตรวจจับ ดังนั้นแอปพลิเคชันบริการอาจถูกรบกวน – อาจเป็นระยะเวลานาน – โดยไม่ถูกตรวจพบโดยศูนย์กู้คืนข้อมูลของคลาวด์

SIOS DataKeeper และ SIOS Protection Suite จาก SIOS Technology

เมื่อความพร้อมใช้งานสูงมีความสำคัญยิ่งการตรวจหาข้อผิดพลาดที่ครอบคลุมนั้นเป็นสิ่งจำเป็นเพื่อหลีกเลี่ยงการหยุดทำงานของระดับแอปพลิเคชัน วัตถุประสงค์นี้เกิดขึ้นได้อย่างง่ายดายด้วยเทคโนโลยีการทำคลัสเตอร์การเฟลโอเวอร์ที่สร้างขึ้นตามวัตถุประสงค์เช่น SIOS DataKeeper และ SIOS Protection Suite จาก SIOS Technology ซึ่งสามารถตรวจจับสาเหตุการหยุดทำงานที่หลากหลายทั้งในซอฟต์แวร์ กลุ่มที่ใช้ซอฟต์แวร์เท่านั้นเหล่านี้อยู่บนชั้นบนคลาวด์เพื่อมอบโซลูชั่น HA / DR ที่สมบูรณ์ซึ่งรวมถึงการจำลองข้อมูลการตรวจสอบระดับแอปพลิเคชันอย่างต่อเนื่องและนโยบายการกู้คืนความล้มเหลว / ล้มเหลวที่กำหนดค่าได้

ข้อเสนอ DRaaS

ซอฟต์แวร์การทำคลัสเตอร์ล้มเหลวสามารถกำหนดค่าสำหรับ HA หรือ DR เพียงอย่างเดียวหรือสำหรับการรวมกันของ HA และ DR ปกติแล้ว DR จะมี VM สแตนด์บายในภูมิภาคอื่นในการกำหนดค่าที่เรียกว่า GeoCluster เช่นเดียวกับข้อเสนอ DRaaS ข้อ จำกัด แบนด์วิดท์ WAN ทำให้เกิด "ความล่าช้าในการจำลองแบบ" สำหรับข้อมูลและอาจสูญเสียข้อมูลบางอย่างภายใต้สถานการณ์ความล้มเหลวบางอย่าง แต่แตกต่างจาก DRaaS ความล้มเหลวในวงกว้างจะถูกตรวจพบโดยอัตโนมัติในแพลตฟอร์มคลาวด์และระดับแอปพลิเคชันและสามารถแก้ไขได้ทันทีเพื่อให้มั่นใจว่าบริการจะได้รับความต่อเนื่อง ในขณะที่การทำคลัสเตอร์ล้มเหลวด้วยความสามารถในการลดทั้งจุดกู้คืนและวัตถุประสงค์เวลาในการกู้คืน (RPO / RTO) ให้การปกป้องการบริการที่ครอบคลุมเมื่อเทียบกับ DRaaS จำเป็นที่จะต้องกำหนดค่าทรัพยากรซ้ำซ้อน โชคดีที่ปัญหานี้ได้รับการแก้ไขด้วยเทคนิคการจัดการคลัสเตอร์ที่สามารถจัดการการกู้คืนเต็มรูปแบบผ่านการจัดสรรทรัพยากรแบบไดนามิกในเวลาที่เกิดความล้มเหลว

แนวทางใหม่

VM แสตนด์บายขณะที่ทำงานในโหมดสแตนด์บายนั้นจะได้รับการกำหนดค่าเฉพาะกับทรัพยากรที่จำเป็นในการจัดการกับบทบาทที่เรียบง่ายของเป้าหมายการจำลองแบบข้อมูลสำหรับ VM หลัก เมื่อเกิดความล้มเหลวคลัสเตอร์ทันทีและตั้งค่า VM สแตนด์บายใหม่แบบไดนามิกพร้อมส่วนประกอบที่สมบูรณ์ของทรัพยากรที่จำเป็นในการส่งมอบระดับของประสิทธิภาพที่จำเป็นสำหรับบทบาทการดำเนินงานทั้งหมดของ VM หลัก การใช้ประโยชน์แบบไดนามิกนี้ช่วยให้การปกป้อง HA และ DR ได้รับประโยชน์จากการประหยัดต้นทุนอย่างมีนัยสำคัญโดยไม่ลดทอนความพร้อมใช้งานและประโยชน์ด้านความน่าเชื่อถือของการรวมกลุ่ม

ข้อสรุป

ทั้ง HA failover clusters และ DRaaS ไม่ว่าจะทำงานแยกกันหรืออยู่ในคอนเสิร์ตก็สามารถมีบทบาทในการทำให้การปกป้อง HA และ DR อย่างต่อเนื่องในราคาที่เหมาะสมสำหรับแอพพลิเคชั่นระดับองค์กรที่ครอบคลุม การหยุดทำงานสำหรับผู้ที่ต้องการ RPO เป็นศูนย์ (ไม่มีข้อมูลสูญหาย) และ RTO น้อยกว่าห้านาทีภายใต้สถานการณ์ความล้มเหลวที่อาจเกิดขึ้นทั้งหมด  

เกี่ยวกับผู้แต่ง

Jerry Melnick เป็นประธานและซีอีโอของ SIOS Technology ซึ่งเขามีหน้าที่รับผิดชอบในการกำกับดูแลกลยุทธ์ขององค์กรโดยรวมและเป็นผู้นำในการเติบโตและขยายตัวของ บริษัท อย่างต่อเนื่อง เขามีประสบการณ์มากกว่า 25 ปีในตลาดองค์กรและตลาดซอฟต์แวร์ที่มีความพร้อมใช้งานสูง ก่อนที่จะร่วมงานกับ SIOS เขาเคยดำรงตำแหน่ง CTO ที่ Marathon Technologies ซึ่งเขาเป็นผู้นำด้านกลยุทธ์ทางธุรกิจและผลิตภัณฑ์สำหรับโซลูชั่นการป้องกันความผิดพลาดของ บริษัท ประสบการณ์ของเขายังรวมถึงตำแหน่งผู้บริหารที่ PPGx, Inc. และ Belmont Research ซึ่งเขารับผิดชอบในการสร้างผลิตภัณฑ์ซอฟต์แวร์ที่ทันสมัยและธุรกิจให้คำปรึกษาที่มุ่งเน้นการจัดหาคลังข้อมูลและเครื่องมือในการวิเคราะห์ เจอร์รี่เริ่มอาชีพของเขาที่ Digital Equipment Corporation ซึ่งเขาเป็นผู้นำหน่วยธุรกิจผู้ประกอบการที่นำเสนอแพลตฟอร์มฐานข้อมูลที่มีความสำคัญในการปรับขนาดได้สูงเพื่อรองรับสภาพแวดล้อมการประมวลผลขององค์กรในตลาดทางการแพทย์การเงินและโทรคมนาคม เขาสำเร็จการศึกษาระดับปริญญาตรีด้านวิทยาศาสตร์จากวิทยาลัยเบลัวต์จบการศึกษาระดับปริญญาตรีสาขาวิศวกรรมคอมพิวเตอร์และวิทยาศาสตร์คอมพิวเตอร์ที่มหาวิทยาลัยบอสตัน
Filed Under: ข่าวสารและกิจกรรม

Five Cloud Predictions สำหรับปี 2019 โดย SIOS

มกราคม 17, 2019 by Jason Aw Leave a Comment

Five Cloud Predictions สำหรับปี 2019 โดย SIOS

จาก HA และการจัดการบริการไอทีไปจนถึงการวิเคราะห์การดำเนินงาน DevOps และไอที

Jerry Melnick ประธานและซีอีโอของ SIOS Technology Corp. เปิดเผยการคาดการณ์บนคลาวด์ของเขาในปี 2019

คลาวด์มีประวัติอันยาวนานของการปรับปรุงอย่างต่อเนื่อง 2019 จะนำในบางสิ่งที่มีความสำคัญพอสมควรซึ่งเพิ่มความสามารถทำให้การดำเนินงานง่ายขึ้นและลดต้นทุน

ห้าแนวโน้มสำคัญที่ชี้นำการพยากรณ์เมฆของเขาสำหรับปี 2562:

1 ความก้าวหน้าทางเทคโนโลยีจะทำให้คลาวด์มีความเหมาะสมยิ่งขึ้นสำหรับการใช้งานที่สำคัญ

ตอนนี้พนักงานไอทีรู้สึกสะดวกสบายมากขึ้นกับคลาวด์สำหรับแอปพลิเคชันที่สำคัญ ความกังวลของพวกเขาเกี่ยวกับความปลอดภัยและความน่าเชื่อถือโดยเฉพาะอย่างยิ่งสำหรับช่วงเวลาห้าถึงเก้าปีของได้ลดลงอย่างมาก เริ่มแรกองค์กรต่างๆต้องการใช้เทคโนโลยีการทำคลัสเตอร์ล้มเหลวของ HA ที่ใช้อยู่ในศูนย์ข้อมูลเพื่อปกป้องแอปพลิเคชันที่สำคัญที่ถูกย้ายไปยังคลาวด์ เทคโนโลยีการจัดกลุ่มนี้จะได้รับการดัดแปลงและปรับให้เหมาะสมสำหรับการทำงานที่ปรับปรุงใหม่ในคลาวด์ ในเวลาเดียวกันผู้ให้บริการคลาวด์จะยังคงพัฒนาความสามารถในการให้บริการในระดับที่สูงขึ้นต่อไปซึ่งนำไปสู่คลาวด์ในที่สุดกลายเป็นแพลตฟอร์มที่ต้องการสำหรับแอพพลิเคชั่นระดับองค์กรทั้งหมด

2 การใช้แบบไดนามิกจะทำให้ HA และ DR คุ้มค่ามากขึ้นสำหรับแอพพลิเคชั่นเพิ่มเติมการขับเคลื่อนการโยกย้ายไปยังคลาวด์

ด้วยทรัพยากรที่ไม่ จำกัด อย่างแท้จริงกระจายไปทั่วโลกคลาวด์จึงเป็นแพลตฟอร์มที่เหมาะสำหรับการส่งมอบเวลาทำงานที่สูง แต่การเตรียมทรัพยากรสแตนด์บายที่ไม่ได้ใช้งานเป็นส่วนใหญ่นั้นมีข้อห้ามด้านต้นทุนสำหรับแอปพลิเคชั่นจำนวนมาก ความซับซ้อนที่เพิ่มขึ้นของทรัพยากรคลาวด์ของระบบคลาวด์ที่ปรับใช้ในหลายโซนและภูมิภาคทั้งหมดเชื่อมต่อผ่านการใช้งานอินเทอร์เน็ตคุณภาพสูงตอนนี้เปิดใช้งานทรัพยากรสแตนด์บายเพื่อจัดสรรแบบไดนามิกเฉพาะเมื่อจำเป็น สิ่งนี้จะช่วยลดค่าใช้จ่ายในการเตรียมการป้องกัน HA และ DR ได้อย่างมาก

3 คลาวด์จะกลายเป็นแพลตฟอร์มที่ต้องการสำหรับการปรับใช้ SAP

เนื่องจากแพลตฟอร์มของผู้ให้บริการคลาวด์ยังคงเติบโตต่อไปความสามารถในการโฮสต์แอปพลิเคชันของ SAP จะกลายเป็นเชิงพาณิชย์และมีความสำคัญเชิงกลยุทธ์ สำหรับ CSP นั้นการโฮสต์ของ SAP จะเป็นวิธีการรักษาความปลอดภัยการนัดหมายระยะยาวกับลูกค้าองค์กร สำหรับองค์กร "SAP-as-a-Service" จะเป็นวิธีการใช้ประโยชน์อย่างเต็มที่จากการประหยัดต่อขนาดในระบบคลาวด์โดยไม่ลดทอนประสิทธิภาพหรือความพร้อมใช้งาน

4 เทมเพลต 'เริ่มต้นอย่างรวดเร็ว' ของคลาวด์จะกลายเป็นมาตรฐานสำหรับการปรับใช้ซอฟต์แวร์และบริการที่ซับซ้อน

เท็มเพลตเริ่มต้นอย่างรวดเร็วเป็นอินเตอร์เฟสที่ใช้ตัวช่วยสร้าง ใช้สคริปต์อัตโนมัติเพื่อจัดเตรียมกำหนดค่าและปรับแต่งทรัพยากรและบริการที่จำเป็นในการเรียกใช้แอปพลิเคชันเฉพาะ ประโยชน์ที่สำคัญของพวกเขาคือความต้องการการฝึกอบรมที่ลดลงความเร็วที่เพิ่มขึ้นและความแม่นยำ ไม่ลืมความสามารถในการย่อหรือกำจัดข้อผิดพลาดของมนุษย์ให้เป็นสาเหตุสำคัญของปัญหา เทมเพลตเริ่มต้นอย่างรวดเร็วจะช่วยลดเวลาและความพยายามอย่างมากสำหรับเจ้าหน้าที่ DevOps ในการติดตั้งทดสอบและกำหนดค่าที่เชื่อถือได้

5 การวิเคราะห์ขั้นสูงและ AI จะอยู่ทุกหนทุกแห่งและในทุกสิ่งรวมถึงการดำเนินงานด้านโครงสร้างพื้นฐาน

การวิเคราะห์ขั้นสูงและปัญญาประดิษฐ์จะทำให้การทำงานด้านไอทีง่ายขึ้นและปรับปรุงโครงสร้างพื้นฐาน ในที่สุดมันจะช่วยให้แอพพลิเคชั่นมีความทนทานและลดต้นทุนโดยรวม ตามแนวโน้มนี้ AI และการวิเคราะห์จะถูกฝังอยู่ในโซลูชั่น HA และ DR รวมถึงข้อเสนอของผู้ให้บริการคลาวด์เพื่อปรับปรุงระดับการให้บริการ ด้วยความสามารถในการได้อย่างรวดเร็วโดยอัตโนมัติและถูกต้องเข้าใจปัญหาและวินิจฉัยปัญหาในการกำหนดค่าที่ซับซ้อนความน่าเชื่อถือและความพร้อมใช้งานของบริการสำคัญที่ส่งมอบจากคลาวด์จะปรับปรุงอย่างมากมาย

จากการสรุปการคาดการณ์คลาวด์ของเขาสำหรับปี 2019 ตาม Melnick, "2019 ถูกกำหนดให้เป็นปีที่น่าตื่นเต้นสำหรับคลาวด์ที่มีความสามารถใหม่และการปรับปรุงการขับเคลื่อนการโยกย้ายไปยังคลาวด์ต่อไป  ด้วยการปรับปรุงใหม่เหล่านี้สร้างขึ้นบนรากฐานที่แข็งแกร่งอยู่แล้วคลาวด์อาจบรรลุจุดเปลี่ยนที่คาดว่าจะเป็นแพลตฟอร์มที่ต้องการสำหรับแอพพลิเคชั่นองค์กรส่วนใหญ่สำหรับองค์กรส่วนใหญ่ "

SIOS Technology Corp. ประธานและซีอีโอของ Jerry Melnick การคาดการณ์คลาวด์สำหรับปี 2019 ได้รับการทำซ้ำโดยได้รับอนุญาตจาก SIOS อ่านเรื่องราวความสำเร็จของ SIOS เพื่อเรียนรู้ว่า SIOS จะเป็นประโยชน์ต่อโครงการของคุณอย่างไร

Filed Under: ข่าวสารและกิจกรรม Tagged With: SIOS, การคาดการณ์คลาวด์สำหรับ 2019

เชื่อมต่อกับ iSCSI เป้าหมายโดยใช้ซอฟต์แวร์ Open-iSCSI initiator

มกราคม 6, 2019 by Jason Aw Leave a Comment

คำแนะนำในการเชื่อมต่อกับเป้าหมายของ iSCSI โดยใช้ซอฟต์แวร์ผู้ริเริ่ม Open-iSCSI

ทีละขั้นตอน: เชื่อมต่อกับเป้าหมาย iSCSI โดยใช้ซอฟต์แวร์ Open-iSCSI initiator

บทความนี้จะแสดงวิธีกำหนดค่า Open-iSCSI initiator (ไคลเอนต์) เพื่อเชื่อมต่อกับเป้าหมาย iSCSI ที่มีอยู่ (เซิร์ฟเวอร์)  ฉันจะไม่ตรวจสอบวิธีตั้งค่าเป้าหมาย iSCSI จริง ๆ ในบทความนี้   หากคุณยังไม่มีเป้าหมาย iSCSI อยู่ในสภาพแวดล้อมของคุณคุณอาจดูที่ OpenFiler

ในคู่มือนี้ฉันใช้ระบบ CentOS 6.5 เป็น iSCSI initiator (ไคลเอนต์) และจะเชื่อมต่อกับเป้าหมาย iSCSI ที่มีอยู่ ติดตั้งซอฟต์แวร์ Open-iSCSI บนระบบ CentOS 6.5 ของฉันแพ็คเกจ Open-iSCSI จะไม่ถูกติดตั้งตามค่าเริ่มต้น  คุณสามารถตรวจสอบเพื่อดูว่าระบบของคุณมีแพ็คเกจที่ติดตั้งหรือไม่โดยการรันคำสั่งต่อไปนี้: [root @ linux ~] # rpm -qa | grep iscsi-initiator-utils หากแพ็คเกจ iscsi-initiator-utils ยังไม่ได้ติดตั้งให้ใช้คำสั่ง“ yum” เพื่อติดตั้ง: [root @ linux ~] # yum การติดตั้ง iscsi-initiator-utils เริ่มบริการ iSCSI หลังจากติดตั้ง iscsi-initiator-utils แพ็คเริ่มบริการ iscsid และกำหนดค่าทั้งบริการ iscsid และ iscsi ให้เริ่มโดยอัตโนมัติทุกครั้งที่บูทระบบ: [root @ linux ~] # /etc/init.d/iscsid start [root @ linux ~] # chkconfig iscsid บน [root @ linux ~] # chkconfig iscsi บน Discover iSCSI เป้าหมายใช้คำสั่ง iscsiadm เพื่อค้นหาเป้าหมาย iSCSI ทั้งหมดบนเซิร์ฟเวอร์เป้าหมาย iSCSI ของคุณ (เช่น iSCSI SAN ของคุณ  ในกรณีนี้เซิร์ฟเวอร์ของฉันใช้ OpenFiler): [root @ linux ~] # iscsiadm - การค้นพบ -t sendtargets -p 192.168.197.201 192.168.197.201:3260,1 iqn.2006-01.com.openfiler: tsn.target1 หมายเหตุ: ในตัวอย่างของฉันชื่อโฮสต์ของ iSCSI Target (SAN) ของฉันคือ "openfiler.mydomain.com" และมีที่อยู่ IP เป็น 192.168.197.201 เข้าสู่เป้าหมาย iSCSI และกำหนดค่าการเข้าสู่ระบบอัตโนมัติในเวลาบูต [root @ linux ~] # iscsiadm -m node -T iqn.2006-01.com.openfiler: tsn.target1 -p 192.168.197.201 - ล็อก [root @ linux ~] # iscsiadm โหนด -m -t iqn.2006-01.com.openfiler: tsn .target1 -p 192.168.197.201 - อัพเดตล่าสุด -n node.startup -v อัตโนมัติตรวจสอบเซสชัน iSCSI ใช้งานอยู่ [root @ linux ~] # iscsiadm -m เซสชัน tcp: [1] 192.168.197.201:3260,1 iqn.2006 -01.com.openfiler: tsn.target1 ระบุอุปกรณ์ที่แผนที่เป้าหมาย iSCSI ไปที่ [root @ linux ~] # # (cd / dev / disk / by-path; ls -l * iscsi * | awk '{FS = "" พิมพ์ $ 9 "" $ 10 "" $ 11} ') ip-192.168.197.201: 3260-iscsi-iqn.2006-01.com.openfiler: tsn.target1-lun-0 -> ../../sdc เราว่า เป้าหมาย iSCSI ของเขาถูกแมปไปยัง / dev / sdc บนระบบ  จากที่นี่ใช้คำสั่งการแบ่งพาร์ติชัน / การจัดรูปแบบมาตรฐาน (fdisk, mkfs ฯลฯ ) เพื่อตั้งค่าดิสก์ตามที่ต้องการ! ทำซ้ำโดยได้รับอนุญาตจาก Linuxclustering

Filed Under: ข่าวสารและกิจกรรม

SQL Server on Linux คุณลักษณะและข้อควรพิจารณาด้านความพร้อมใช้งานสูง

สิงหาคม 17, 2018 by Jason Aw Leave a Comment

SIOS จะพูดในงาน Microsoft SQLSaturday

ลำโพง Jason Aw การพัฒนาธุรกิจเชิงกลยุทธ์ SIOS Technology Corp จะแบ่งปันในเซสชั่นหนึ่งชั่วโมงเกี่ยวกับ SQL Server on Linux สิ่งอำนวยความสะดวกและความพร้อมในการใช้งานสูง

ด้วย SQL Server บน Linux Microsoft นำเครื่องมือฐานข้อมูลเชิงสัมพันธ์ที่สำคัญของ SQL Server ไปใช้กับระบบนิเวศขององค์กร Linux ที่กำลังเติบโต ความพร้อมใช้งานสูงและการกู้คืนภัยพิบัติ (HADR) เป็นส่วนของ SQL Server ที่มีความสำคัญอย่างยิ่งและในเซสชั่นนี้เราจะพูดถึงคุณสมบัติข้อ จำกัด และทางเลือกสำหรับความพร้อมสูงและวิธีการจัดกลุ่มแบบ SANless สามารถมั่นใจได้ว่าฟังก์ชันการทำงานที่พร้อมใช้งานและความน่าเชื่อถือสำหรับ SQL Server บน Linux, บน premise และในเมฆ Azure

เจสันเป็นผู้นำทางด้าน IT ที่มีประสบการณ์ด้านเทคโนโลยีโครงสร้างพื้นฐานและระบบคลาวด์มานานกว่า 20 ปีโดยเฉพาะอย่างยิ่งกับโซลูชันการกู้คืนและความพร้อมใช้งานที่มีประสิทธิภาพสูงสำหรับสถาปัตยกรรมที่แตกต่างกันรวมถึงแอพพลิเคชันฐานข้อมูล SQL หากต้องการข้อมูลเพิ่มเติมเกี่ยวกับ SIOS กรุณาติดต่อที่นี่

แทร็ก: แทร็ก 3

ระดับ: ระดับกลาง

คุณได้รับเชิญเข้าร่วมกับเราที่ SQLSaturday

SQLSaturday เป็นกิจกรรมการฝึกอบรมฟรีสำหรับผู้เชี่ยวชาญด้านแพลตฟอร์มข้อมูลของ Microsoft และผู้ที่ต้องการเรียนรู้เกี่ยวกับ SQL Server, Business Intelligence และ Analytics

งานนี้จะจัดขึ้นในวันที่ 18 สิงหาคม 2018 ที่ Microsoft Singapore Operations Pte Ltd, # 22-01 One Marina Boulevard, Singapore, Singapore, 018989, Singapore

สมัครตอนนี้

เกี่ยวกับกิจกรรม

ยินดีต้อนรับสู่ SQLSaturday

เราภูมิใจที่ได้เป็นเจ้าภาพจัดงาน SQLSaturday เป็นปีที่ 3 ติดต่อกันที่สิงคโปร์ SQLSaturday เป็นกิจกรรมการฝึกอบรมสำหรับ SQL Server และผู้เชี่ยวชาญด้านข้อมูลที่ต้องการเรียนรู้วิธียกระดับอาชีพไปสู่ระดับต่อไป

การรับเข้าร่วมกิจกรรมนี้ฟรีค่าใช้จ่ายทั้งหมดจะครอบคลุมโดยการบริจาคและการสนับสนุน โปรดลงทะเบียนเร็ว ๆ นี้เนื่องจากที่นั่งมีจำนวน จำกัด และแจ้งให้เพื่อนและเพื่อนร่วมงานทราบเกี่ยวกับกิจกรรมนี้

เป็นโอกาสที่ดีในการเรียนรู้จาก Microsoft Product Team, Microsoft MVPs, ผู้เขียน SQL Server และผู้เชี่ยวชาญที่ได้รับผ่านและสามารถเกี่ยวข้องกับอุปสรรคที่คุณมีอยู่ได้ทุกวัน งานวันฝึกอบรมนี้หนึ่งวันจะแตกต่างจากงานอื่น ๆ ที่ให้บริการอาหารฟรีฝึกอบรมระบบเครือข่ายและยังมีโอกาสที่จะได้รับรางวัลอีกสองสามรางวัล!

วันที่และเวลา: วันเสาร์ 18 สิงหาคม 2018 – 8:30 น. ถึง 5:30 น

ค่าใช้จ่าย: ฟรี

สถานที่: # 21-01 One Marina Boulevard, Singapore – 018989

Filed Under: ข่าวสารและกิจกรรม Tagged With:  

  • « Previous Page
  • 1
  • …
  • 20
  • 21
  • 22
  • 23
  • 24
  • …
  • 77
  • Next Page »

โพสต์ล่าสุด

  • ระบบความพร้อมใช้งานสูง (High Availability หรือ HA) คืออะไร?
  • เอาตัวรอดจากวิกฤตการณ์วันศุกร์: จากระบบคอมพิวเตอร์แบบดิบๆ สู่การจำลองข้อมูลที่ราบรื่น
  • ติดดิน: สิ่งที่การพลาดชม Percona Live Amsterdam สอนฉันเกี่ยวกับ HA
  • เปรียบเทียบ SIOS LifeKeeper กับ Red Hat High Availability Add-On:
  • สถานะของความยืดหยุ่นของแอปพลิเคชัน: ผลสำรวจความพร้อมใช้งานสูงของ SIOS ปี 2026

กระทู้ยอดนิยม

เข้าร่วมรายชื่อผู้รับจดหมายของเรา

Copyright © 2026 · Enterprise Pro Theme on Genesis Framework · WordPress · Log in