SIOS SANless clusters

SIOS SANless clusters High-availability Machine Learning monitoring

  • Home
  • 제작품
    • SIOS DataKeeper for Windows
    • SIOS Protection Suite for Linux
  • 뉴스 및 이벤트
  • 서버 클러스터 단순화
  • 성공 사례
  • 저희에 게 연락
  • English
  • 中文 (中国)
  • 中文 (台灣)
  • 한국어
  • Bahasa Indonesia
  • ไทย

단계별 : Windows Server 2008 R2의 2 노드 다중 사이트 클러스터 구성 – 1 부

1월 22, 2018 by Jason Aw Leave a Comment

클러스터 생성 및 QUORUM 구성 : 노드 및 파일 공유 주요 부분

 소개

시리즈 "Step by by Step : Windows Server 2008 R2에서 2 노드 다중 사이트 클러스터 구성"의 1 부에 오신 것을 환영합니다. 세부 사항으로 바로 들어가기 전에 잠시 시간을내어 정확히 멀티 사이트 클러스터가 무엇인지, 왜 구현해야 하는지를 논의 해 보겠습니다. Microsoft는 세부 정보를 얻으려는 훌륭한 웹 페이지 및 백서를 다운로드하고 싶으므로 여기서는 모든 내용을 반복하지 않겠습니다. 그러나 기본적으로 멀티 사이트 클러스터는 재해 복구 솔루션이며 고 가용성 솔루션이 하나로 통합되어 있습니다. 다중 사이트 클러스터를 통해 중요한 응용 프로그램에 사용할 수있는 RTO (복구 지점 목표)와 RTO (복구 시간 목표)를 가장 많이 제공합니다. Windows Server 2008 장애 조치 (failover) 클러스터링이 도입됨에 따라 다중 사이트 클러스터는 교차 서브넷 장애 조치 (cross subnet failover) 도입 및 대기 시간이 긴 네트워크 통신 지원으로 훨씬 더 적합 해졌습니다.

Windows Server 2008 장애 조치 (Failover) 클러스터링의 새로운 기능인 "교차 서브넷 장애 조치 (cross-subnet failover)"에 대해 언급했으며 이는 대단한 새로운 기능입니다. 그러나 SQL Server는 아직이 기능을 채택하지 않았으므로 SQL Server 다중 사이트 클러스터의 사이트에서 서브넷을 확장해야합니다. SQL Server 팀은 Tech-Ed 2009에서이 기능을 지원할 계획이라고보고했으나 SQL Server 2008 R2가 출시 된 이후에 출시 될 예정이라고합니다. 가까운 미래에 SQL Server 다중 사이트 클러스터의 여러 사이트에서 서브넷을 확장 할 수 있습니다. 중복 통신 경로, 대역폭 및 파일 공유 감시 위치와 같이 고려해야 할 다른 몇 가지 네트워크 관련 문제가 있습니다.

네트워크 고려 사항

모든 Microsoft 장애 조치 클러스터에는 중복 네트워크 통신 경로가 있어야합니다. 이렇게하면 어느 한 통신 경로에 오류가 발생해도 오류가 발생하지 않으며 클러스터 가용성을 높일 수 있습니다. 다중 사이트 클러스터에는 이러한 요구 사항이 있으므로 네트워크를 염두에두고 계획해야합니다. 일반적으로 노드간에 이동해야 할 두 가지가 있습니다 : 복제 트래픽과 클러스터 하트 비트. 그 외에도 클라이언트 연결 및 클러스터 관리 작업을 고려해야합니다. 당신은 당신이 자리 잡은 네트워크가 무엇이든, 당신이 네트워크를 압도하지 않거나 당신이 신뢰할 수없는 행동을 할 것이라는 것을 확신하고 싶을 것입니다. 복제 트래픽에는 가장 많은 대역폭이 필요합니다. 얼마나 많은 대역폭이 필요한지 판별하려면 복제 공급 업체와 협력해야합니다.

중복 통신 경로가 마련되어 있으므로 고려해야 할 마지막 사항은 쿼럼 모델입니다. 2 노드 다중 사이트 클러스터 구성의 경우 Microsoft에서 권장하는 구성은 노드 및 파일 공유 과반수 쿼럼입니다. 정족수 유형에 대한 자세한 설명은이 기사를 참조하십시오.

노드 및 파일 공유 과반수 쿼럼과 혼동을 일으키는 가장 일반적인 원인은 파일 공유 감시의 배치입니다. 파일 공유를 호스팅하는 서버는 어디에 두어야합니까? 옵션을 살펴 보겠습니다.

옵션 1 – 기본 사이트에 파일 공유 위치.

이는 재해 복구를위한 확실한 옵션이지만 높은 가용성을 보장하는 것은 아닙니다. 주 사이트 및 파일 공유 감시를 포함하여 전체 사이트가 실패하는 경우 보조 사이트의 보조 노드가 자동으로 서비스되지 않으므로 수동으로 쿼럼을 온라인 상태로 설정해야합니다. 이것은 클러스터에서 유일하게 남은 투표 일 것입니다. 3 명 중 1 명이 과반수가되지 않습니다! 재해 발생시 복구를 위해 수작업 단계로 참여할 수 있다면이 구성이 도움이 될 것입니다.

옵션 2 – 두 번째 사이트에서 파일 공유 위치.

이것은 좋은 생각이 아닙니다. 사이트가 완전히 손실되는 경우 자동 복구 문제를 해결하지만 오류가 발생하면 장애 조치가 발생할 위험이 있습니다. 이것을 고려해보십시오 … 보조 사이트가 다운되면 어떻게됩니까? 이 경우 기본 사이트 (노드 1)는 기본 사이트의 단일 노드이기 때문에 오프라인 상태가되어 더 이상 노드가 다수 존재하지 않게됩니다. 너무 많은 위험이 관련되어 있으므로이 구성을 구현할 충분한 이유가 없습니다.

옵션 3 – 3 지리적 위치에있는 파일 공유 증인 놓기

사이트 전체가 손실되는 경우 자동 장애 조치를 허용하고 보조 사이트가 기본 노드를 오프라인 상태로 만드는 데 실패 할 가능성을 없애기 때문에 기본 구성입니다. 세 번째 사이트 호스트에서 파일 공유 감시를하면 한 사이트가 단일 실패 지점으로 제거되므로 이제 클러스터가 예상대로 작동하고 사이트 손실이 발생할 경우 자동 장애 조치가 가능합니다. 세 번째 지리적 위치를 확인하는 것은 일부 기업에게는 어려울 수 있지만 Amazon EC2 및 GoGrid와 같은 클라우드 기반 유틸리티 컴퓨팅의 출현으로 모든 회사가 클라우드에 파일 공유 증인을 배치하고 탄력성을 요구할 수 있습니다 효과적인 다중 사이트 클러스터. 사실, 클라우드 자체를 보조 데이터 센터로 간주하고 재난 발생시 클라우드로 페일 오버 할 수 있습니다. 클라우드 기반 컴퓨팅 및 재해 복구 구성의 가능성은 극도로 매력적이며 실제로 가까운 장래에 바로 블로그 게시물을 다룰 계획입니다.

클러스터 구성

이제 기본 개념을 살펴 보았으므로 클러스터의 실제 구성을 시작합시다. 클러스터의 두 노드에 장애 조치 클러스터링 기능을 추가하려고합니다. 간단하게하기 위해, 나는 PRIMARY와 SECONDARY 노드를 호출했다. 아래 그림과 같이 기능 추가 마법사를 통해 매우 쉽게 수행 할 수 있습니다.
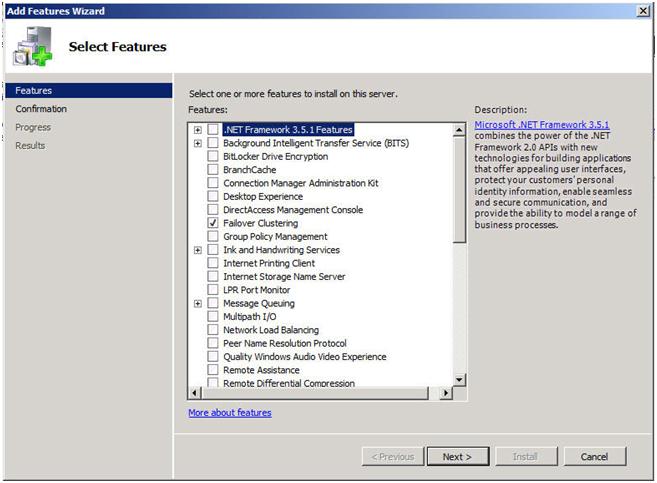
그림 1 - 장애 조치 클러스터링 역할 추가
그림 1 – 장애 조치 클러스터링 역할 추가

다음으로는 네트워크 연결을 확인해야합니다. 각 서버의 연결 이름을 변경하여 해당 네트워크가 반영되도록하는 것이 가장 좋습니다. 이렇게하면 나중에 쉽게 기억할 수 있습니다.

그림 2- 네트워크 연결 이름 변경
그림 2- 네트워크 연결 이름 변경

또한 각 서버의 네트워크 연결 고급 설정 (Alt 키를 눌러 고급 설정 메뉴 참조)으로 이동하여 공용 네트워크가 목록의 첫 번째인지 확인하십시오.
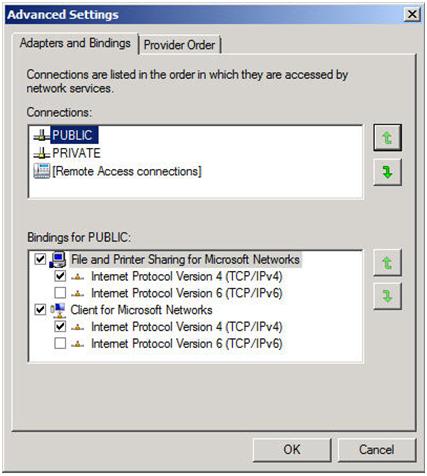
그림 3- 공용 네트워크가 첫 번째인지 확인

개인 네트워크에는 IP 주소와 서브넷 마스크 만 있어야합니다. 기본 게이트웨이 또는 DNS 서버를 정의하지 않아야합니다. 노드가이 네트워크에서 통신 할 수 있어야하므로 서버가이 네트워크에서 통신 할 수 있어야합니다. 필요한 경우 고정 경로를 추가하십시오.
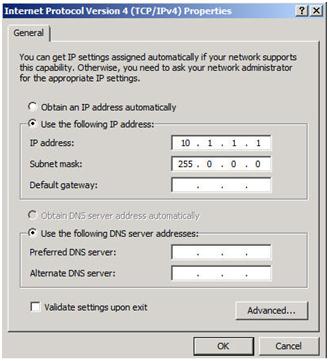
그림 4 - 개인 네트워크 설정
그림 4 – 개인 네트워크 설정

네트워크를 구성했으면 클러스터를 빌드 할 준비가 된 것입니다. 첫 번째 단계는 "구성 유효성 검사"입니다. 장애 조치 (failover) 클러스터 관리자를 열고 구성 유효성 검사를 클릭하십시오.
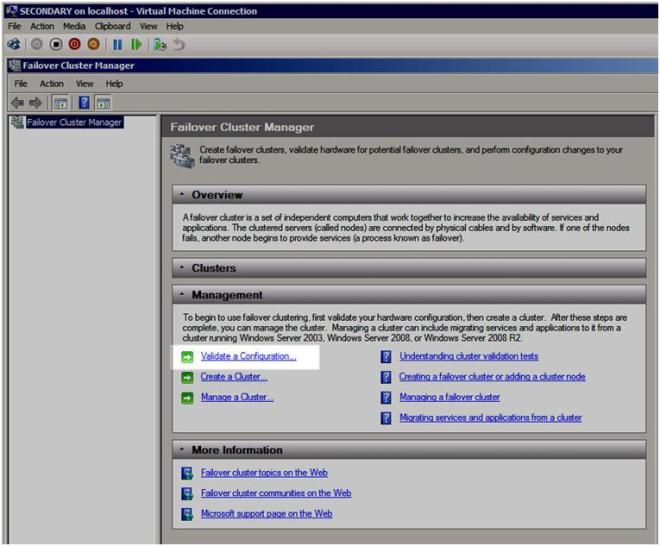
그림 5 - 구성 유효성 검사
그림 5 – 구성 유효성 검사

유효성 검사 마법사가 시작되어 아래와 같이 첫 번째 화면을 표시합니다. 클러스터에 두 개의 서버를 추가하고 계속하려면 다음을 클릭하십시오.
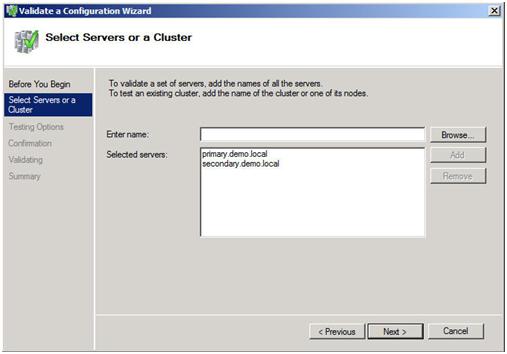
그림 6 - 클러스터 노드 추가
그림 6 – 클러스터 노드 추가

다중 사이트 클러스터는 저장소 유효성 검사를 통과 할 필요가 없습니다 (Microsoft 기술 자료 참조). 스토리지 유효성 검사 프로세스를 Toskip하고 "선택한 테스트 만 실행"을 클릭 한 다음 계속을 클릭하십시오.
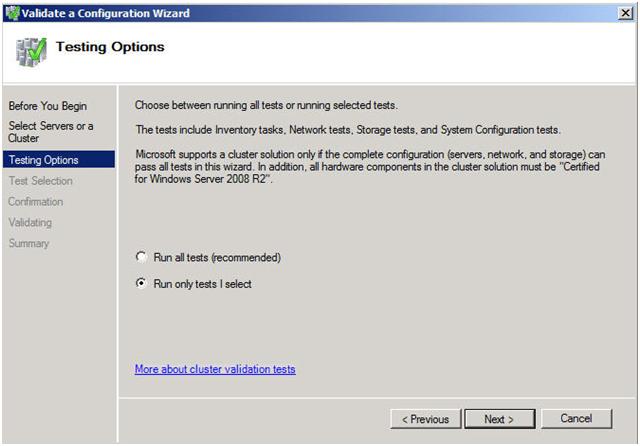
그림 7 - "선택한 테스트 만 실행"선택
그림 7 – "선택한 테스트 만 실행"선택

테스트 선택 화면에서 스토리지를 선택 해제하고 다음을 클릭하십시오.
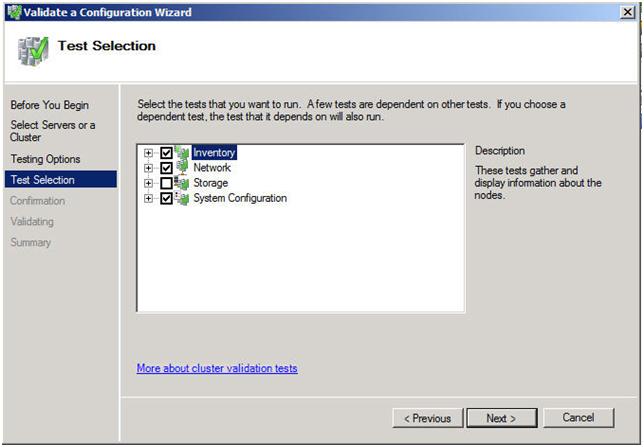
그림 8 - 저장 테스트 선택 취소
그림 8 – 저장 테스트 선택 취소

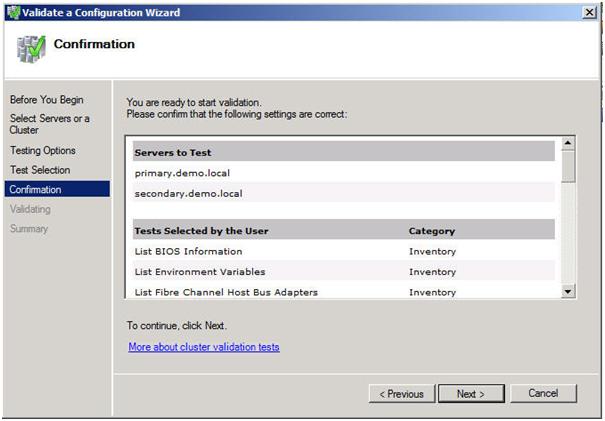
다음 확인 화면이 나타납니다. 다음을 클릭하여 계속하십시오.

그림 9 - 선택 사항 확인
그림 9 – 선택 사항 확인

모든 작업을 올바르게 완료했다면 다음과 같은 요약 페이지가 나타납니다. 노란색 느낌표는 모든 테스트가 실행되지 않았 음을 나타냅니다. 이 테스트는 저장 테스트를 건너 뛰므로 다중 사이트 클러스터에서 예상됩니다. 다른 모든 것들이 OK를 확인하는 한 계속 진행할 수 있습니다. 보고서에 다른 오류가 표시되면 문제점을 수정하고 테스트를 다시 실행 한 후 계속하십시오.
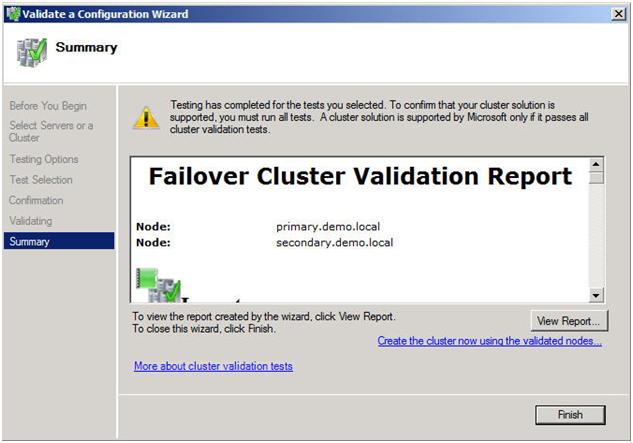
그림 10 - 유효성 검사 보고서보기
그림 10 – 유효성 검사 보고서보기

이제 클러스터를 만들 준비가되었습니다. 장애 조치 (Failover) 클러스터 관리자에서 클러스터 만들기를 클릭합니다.
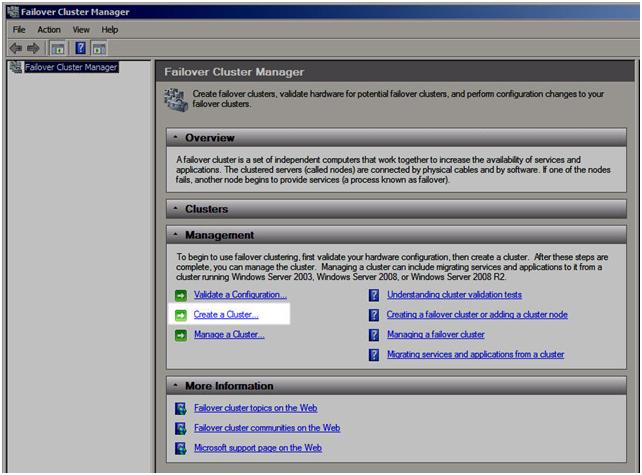
그림 11 - 클러스터 만들기
그림 11 – 클러스터 만들기

다음 단계에서는 클러스터의 유효성을 검사할지 여부를 묻습니다. 이미이 작업을 수행 했으므로이 단계를 건너 뛸 수 있습니다. 계속 진행하기 전에 클러스터가 유효성 검사를 통과해야하므로 SQL을 설치하는 경우 나중에 약간의 문제가 발생합니다. 이 시점에 이르면 SQL Server 설치의 명령 줄 옵션을 통해이 검사를 우회하는 방법을 보여줍니다. 지금은 아니오 및 다음을 선택하십시오.
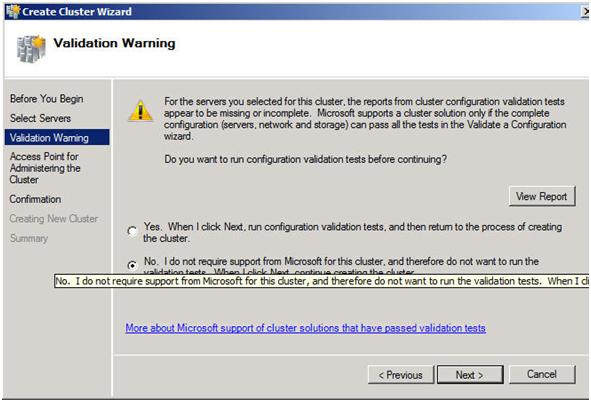
그림 12 - 유효성 검사 테스트 건너 뛰기
그림 12 – 유효성 검사 테스트 건너 뛰기

다음 단계는이 클러스터를 관리하기 위해이 클러스터와 IP의 이름을 만들어야한다는 것입니다. 이 이름은 나중에 작성할 SQL 클러스터 자원의 이름이 아니라 클러스터 관리에 사용할 이름입니다. 고유 한 이름과 IP 주소를 입력하고 다음을 클릭하십시오.

참고 :이 문서의 뒷부분에서 설명하는대로 파일 공유 감시에 대한 권한이 필요한 컴퓨터 이름이기도합니다.
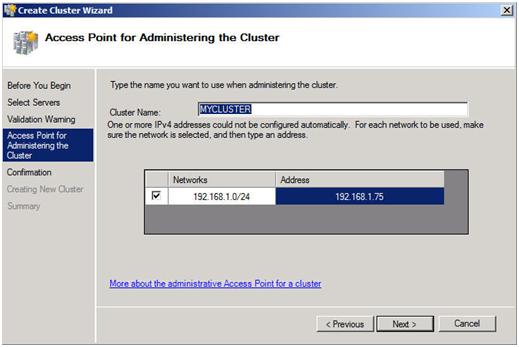
그림 13 - 고유 한 이름과 IP 주소 선택
그림 13 – 고유 한 이름과 IP 주소 선택

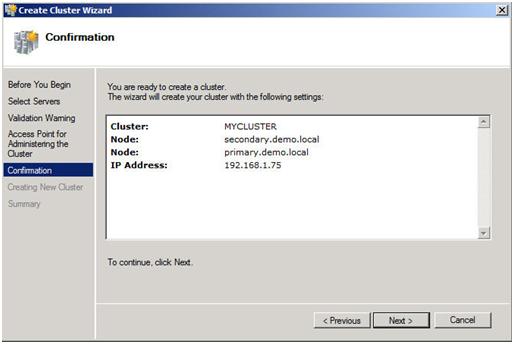
선택 사항을 확인하고 다음을 클릭하십시오.

그림 14 - 선택 사항 확인
그림 14 – 선택 사항 확인

축하합니다. 모든 것이 올바르게 끝난 경우 다음 요약 페이지가 표시됩니다. 노란색 느낌표를 확인하십시오. 분명히 뭔가 완벽하지는 않습니다. 보고서보기를 클릭하여 문제의 원인을 찾으십시오.
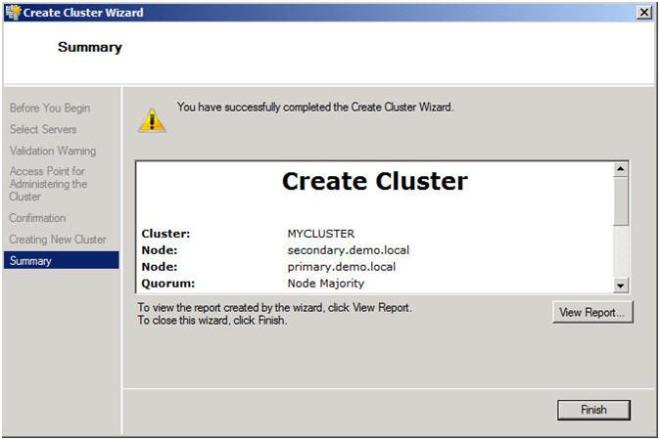
그림 15 - 경고를 확인하는 보고서보기
그림 15 – 경고를 확인하는 보고서보기

보고서를 보면 다음과 같은 몇 줄을보아야합니다.

그림 16 - 오류 보고서
그림 16 – 오류 보고서

두려워하지 마라. 이는 다중 사이트 클러스터에서 예상됩니다. 앞서 노드와 파일 공유 과반수 쿼럼을 구현할 것이라고 말한 것을 기억하십시오. 쿼럼 유형을 현재 노드 대다수 클러스터 (2 노드 클러스터에서는 좋지 않음)에서 노드 및 파일 공유 과반수 쿼럼으로 변경합니다.

NODE 및 FILE SHARE MAJORITY QUORUM 구현

먼저 파일 공유 감시 서버를 확인해야합니다. 앞에서 설명한 것처럼이 파일 공유 감시는 세 번째 위치에 있어야하며 클러스터의 두 노드에서 액세스 할 수 있어야합니다. 서버를 식별하면 일반적으로 폴더를 공유하는 것처럼 폴더를 공유하십시오. 필자의 경우 DEMODC라는 서버에 MYCLUSTER라는 공유를 생성합니다.
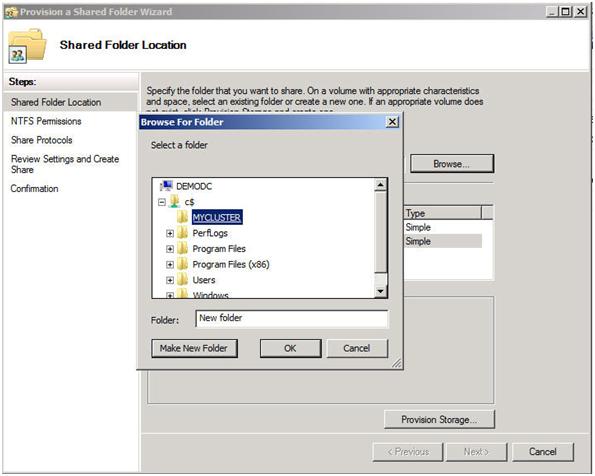
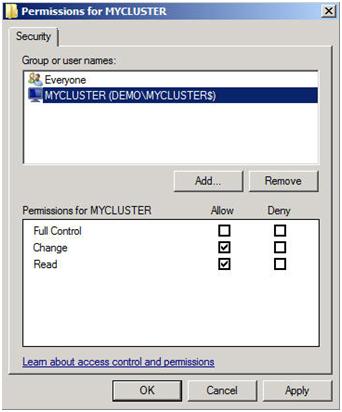
이 공유에 대해 기억해야 할 핵심 사항은 공유 수준과 NTFS 수준 사용 권한 모두에서 클러스터 컴퓨터 이름에 공유에 대한 읽기 / 쓰기 권한을 부여해야한다는 것입니다. 그림 13을 다시 회상하면 클러스터를 생성하고 "MYCLUSTER"라는 이름을 부여했습니다. 다음 스크린 샷과 같이 클러스터 컴퓨터 계정에 읽기 / 쓰기 권한을 부여해야합니다.
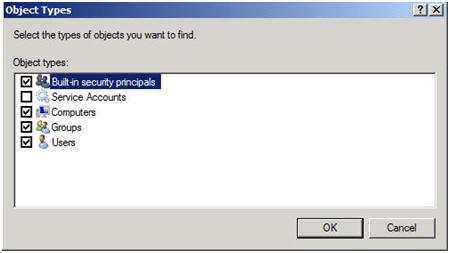
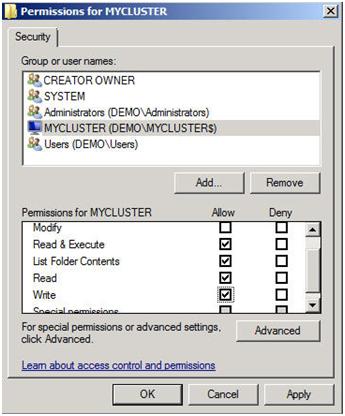
그림 17 - 컴퓨터를 검색했는지 확인하십시오.
그림 17 – 컴퓨터를 검색했는지 확인하십시오.
그림 18 - 클러스터 컴퓨터 계정에 NTFS 사용 권한 부여
그림 18 – 클러스터 컴퓨터 계정에 NTFS 사용 권한 부여
그림 19 - 클러스터 컴퓨터 계정 공유 수준 권한 부여
그림 19 – 클러스터 컴퓨터 계정 공유 수준 권한 부여

이제 공유 폴더가 있고 적절한 권한이 할당되면 쿼럼 유형을 변경할 준비가 된 것입니다. 장애 조치 (failover) 클러스터 관리자에서 클러스터를 마우스 오른쪽 단추로 클릭하고 추가 작업 및 클러스터 쿼럼 설정 구성을 선택합니다.
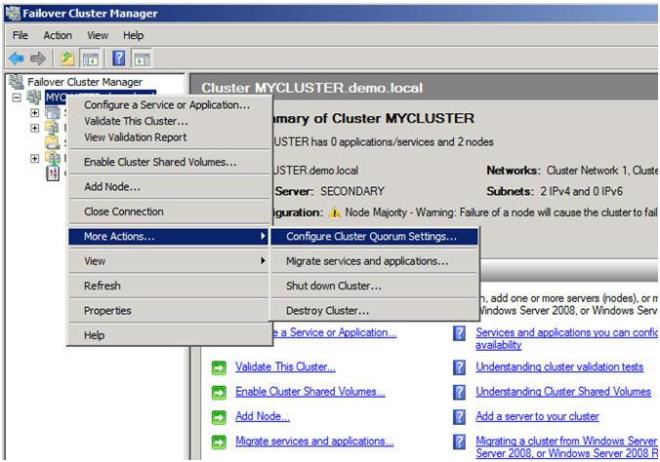
그림 20 - 쿼럼 유형 변경
그림 20 – 쿼럼 유형 변경

다음 화면에서 노드 및 파일 공유 과반수를 선택하고 다음을 클릭하십시오.
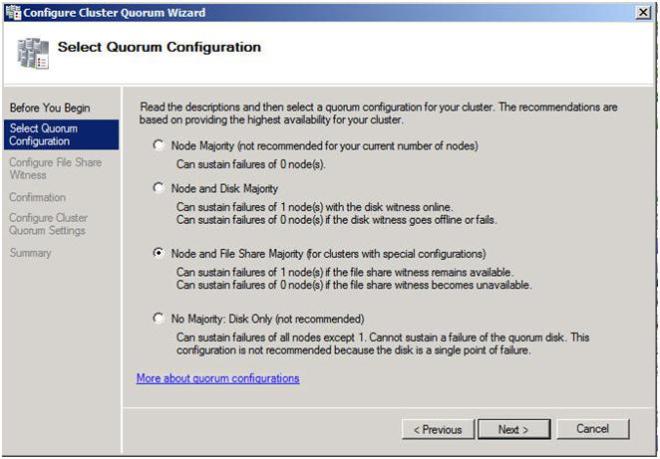
그림 21 - 노드 및 파일 공유 과반수 선택
그림 21 – 노드 및 파일 공유 과반수 선택

이 화면에서 이전에 생성 한 파일 공유 경로를 입력하고 다음을 클릭하십시오.
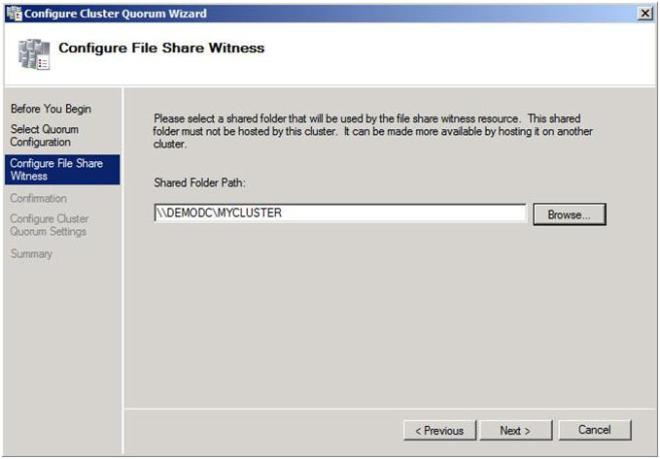
그림 22 - 파일 공유 감시를 선택하십시오.
그림 22 – 파일 공유 감시를 선택하십시오.

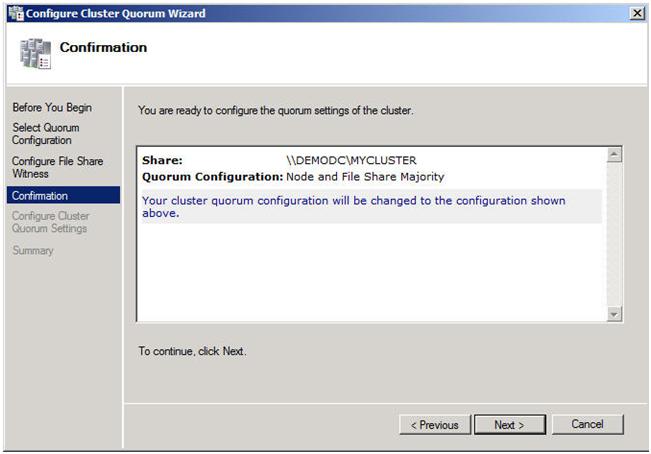
정보가 올바른지 확인하고 다음을 클릭하십시오.

그림 23 - 노드 및 파일 공유 과반수로 쿼럼 변경을 확인하려면 다음을 클릭하십시오.
그림 23 – 노드 및 파일 공유 과반수로 쿼럼 변경을 확인하려면 다음을 클릭하십시오.

모든 것을 올바르게했다고 가정하면 다음 요약 페이지를 볼 수 있습니다.
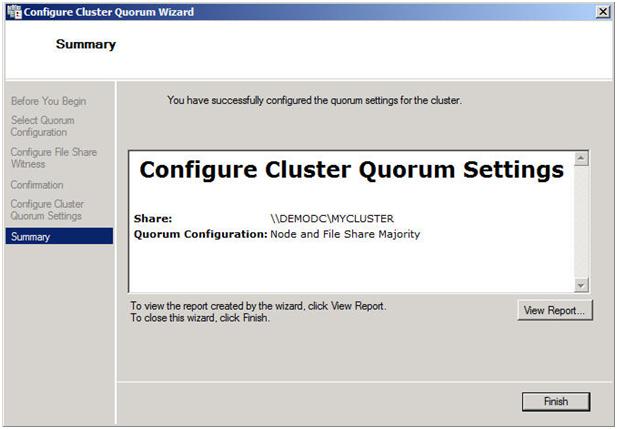
그림 24 - 성공적인 쿼럼 변경
그림 24 – 성공적인 쿼럼 변경

이제 클러스터를 볼 때 쿼럼 구성에 아래와 같이 "노드 및 파일 공유 과반수"가 표시되어야합니다.

그림 25 - 이제 노드 및 파일 공유 과반수 쿼럼이 있습니다.
그림 25 – 이제 노드 및 파일 공유 과반수 쿼럼이 있습니다.

SQL, Exchange, 파일 서버 또는 다른 유형의 장애 조치 (failover) 클러스터에 관계없이이 지점까지 다중 사이트 클러스터에 적용 할 때까지 설명한 단계가 있습니다. 다중 사이트 클러스터를 만드는 다음 단계는 스토리지 및 복제 솔루션을 장애 조치 클러스터에 통합하는 것입니다. 이 단계는 복제 솔루션에 따라 다르므로 실제로 복제 공급 업체와 긴밀한 관계를 유지해야합니다. 제 2 부에서는 SteelEye DataKeeper Cluster Edition이 Windows Server 장애 조치 (Failover) 클러스터링과 통합되어 복제 공급 업체 솔루션 중 하나가 어떻게 작동 하는지를 설명합니다.

이 시리즈의 다른 부분에서는 SQL, 파일 서버 및 Hyper-V를 다중 사이트 클러스터에 설치하는 방법에 대해 자세히 설명합니다. 또한 세 개 이상의 노드로 구성된 다중 노드 클러스터에 대한 고려 사항에 대한 게시물을 게시 할 예정입니다.

https://clusteringformeremortals.com/2009/09/15/step-by-step-configuring-a-2-node-multi-site-cluster-on-windows-server-2008-r2-%E2의 허락을 얻어 재현했습니다. % 80 % 93-part-1 /
Filed Under: 서버 클러스터 단순화

Hyper-V 통과 디스크 성능 대. 고정 크기 VHD 파일 및 Windows Server 2008 R2의 동적 VHD 파일

1월 21, 2018 by Jason Aw Leave a Comment

Windows Server 2008 R2가 출시되면서 동적 VHD 파일의 성능이 향상되었습니다. R2 이전에는 동적 확장 VHD 파일에 쓰기가 제한된 메타 데이터 캐싱으로 인해 고정 크기 VHD 파일에 쓰는 것보다 3 배 느려질 수있었습니다. 전반적으로 Microsoft는 동적 VHD 파일과 고정 크기 VHD 파일의 성능이 거의 동일하다고 주장합니다. Hyper-V VM을 구성 할 때 패스 스루 디스크가 다른 옵션입니다. 내 결과에 따르면 통과 디스크의 성능은 VHD 파일의 성능보다 약간 우수합니다. 그러나 통과 디스크를 사용하면 이식성, 스냅 샷 및 씬 프로비저닝과 같은 VHD 파일의 모든 이점을 잃게됩니다. 이러한 절충 사항을 고려할 때 통과 디스크를 사용하는 것은 실제로 크기가 2TB보다 큰 디스크가 필요하거나 응용 프로그램이 I / O 경계에 있고 실제로 다른 디스크에서 이익을 얻을 수있는 경우에만 고려해야합니다. 귀하의 평균 응답 시간.

필자는 마이크로 소프트의 말을 듣기보다는 다른 종류의 디스크를 직접 테스트 해 보았습니다. Windows Server 2008 R2에서 실행되는 Hyper-V Windows Server 2008 R2 가상 컴퓨터를 설정했습니다. 하이퍼 바이저의 경우 필자는 Dell AX150 SAN에 연결된 Dell PowerEdge 1950 서버를 사용하여 테스트에 사용할 10GB LUN 3 개를 조각했습니다. Hyper-V 관리자에서 패스 스루 한 개, 동적 VHD 한 개, 고정 크기 VHD 한 개를 추가했습니다. 그런 다음 IOMeter를 사용하여 디스크의 성능을 테스트했습니다. 테스트 매개 변수 및 원시 데이터는이 CSV 파일에서 찾을 수 있습니다.

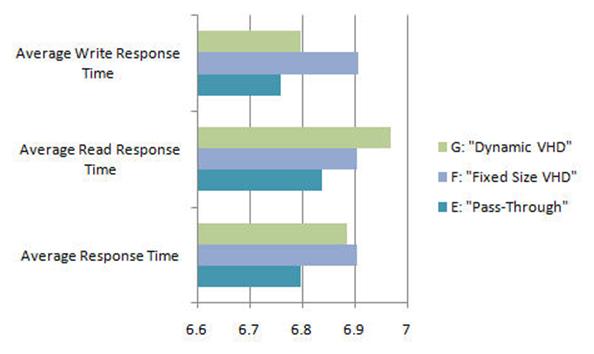
아래 차트는 내 결과를 요약 한 것입니다. 극한 상황 (최대 / 최소)에서 볼 수 있듯이 대부분의 경우 통과 디스크가 이깁니다. 그러나 평균적으로 세 가지 디스크 유형의 성능 간에는 거의 차이가 없습니다.


세 가지 디스크 유형의 성능 - 동적 VHD, 고정 크기 VHD, 통과

세 가지 디스크 유형의 성능 - 동적 VHD, 고정 크기 VHD, 통과

세 가지 디스크 유형의 성능 - 동적 VHD, 고정 크기 VHD, 통과

VHD 파일 또는 사용 가능한 디스크 공간보다 큰 결합 된 크기의 여러 VHD 파일을 만드는 씬 프로비저닝의 이점과 VHD 파일의 이식성으로 인해 동적으로 확장되는 VHD 파일이 대부분의 Windows Server 2008 R2 가상 컴퓨터에서 확실한 선택입니다 .

요약하면 Windows Server 2008 R2에서 다음 Hyper-V 배포를 위해 동적으로 확장되는 VHD 파일을 사용하는 것이 좋습니다.

https://clusteringformeremortals.com/2009/09/25/hyper-v-pass-through-disk-performance-vs-fixed-size-vhd-files-and-dynamic-vhd-files-in-에서 허락을 받아 복제했습니다. windows-server-2008-r2 /

Filed Under: 서버 클러스터 단순화

가상화 가용성 옵션 만들기

1월 21, 2018 by Jason Aw Leave a Comment

가상화 가용성 옵션이란 무엇입니까?

Microsoft Windows Server 2008 R2 및 vSphere 4.0이 새로 출시되었습니다. 가상 서버와 가상 서버에서 실행되는 응용 프로그램의 가용성을 고려할 때 일부 가상화 가용성 옵션을 살펴 보겠습니다.

또한이 기회에 가상 컴퓨터 가용성을 가능하게하는 몇 가지 기능을 설명 할 것입니다. 또한 이러한 기능을 기능별 역할로 그룹화하여 용도를 강조했습니다.

계획된 다운 타임

Live Migration 및 VMware의 VMotion은 관리자가 중단 시간을 인식하지 않고도 한 대의 물리적 서버에서 다른 서버로 가상 시스템을 이동할 수있는 솔루션입니다. 기억해야 할 핵심 사항이 하나 있습니다. 다운 타임없이 가상 시스템을 한 서버에서 다른 서버로 이동하기 위해서는 계획된 이벤트 여야합니다. 계획된 이벤트는 실제 전환이 발생하기 전에 가상 시스템의 메모리가 서버간에 동기화된다는 것입니다. 이는 Microsoft와 VMware의 솔루션 모두에 해당됩니다. 또한이 두 기술을 모두 사용하려면 라이브 마이그레이션 및 VMotion을 로컬 영역 네트워크로 제한하는 가상 하드 디스크 (VMDK 및 VHD 파일)를 보관하기 위해 공유 저장소를 사용해야합니다. 또한 스토리지 배열에 대해 계획된 모든 중단 시간을 다른 방식으로 처리해야 함을 의미합니다. 가상 컴퓨터에 미치는 영향을 제한하려는 경우 중요합니다.

계획되지 않은 중단 시간

Microsoft의 Windows Server 장애 조치 (failover) 클러스터링 및 VMware의 고 가용성 (HA)은 예기치 않은 시스템 정지시 가상 컴퓨터를 보호하는 데 사용할 수있는 솔루션입니다. 두 솔루션 모두 유사합니다. 가상 컴퓨터에서 가용성을 모니터링합니다. 장애가 발생하면 VM을 대기 노드로 이동합니다. 그런 다음이 복구 프로세스를 위해 컴퓨터가 재부팅됩니다. 장애 조치 전에 메모리를 동기화 할 시간이 없었습니다.

재해 복구

사이트가 완전히 손실되는 경우 가상 컴퓨터를 어떻게 복구합니까? 좋은 소식은 가상화가이 프로세스를 훨씬 쉽게 만들어 준다는 것입니다. 가상 머신은 단순히 픽업하여 다른 서버로 이동할 수있는 파일입니다. 지금까지 VMware와 Microsoft는 가용성 기능과 기능면에서 꽤 유사합니다. 그러나 여기가 Microsoft가 실제로 빛나는 곳입니다. VMware는 훌륭한 제품인 Site Recovery Manager를 제공합니다. 그러나 SRM 인증 어레이 기반 복제 솔루션에 한해 지원이 제한됩니다. 또한 페일 오버 및 페일 백 프로세스는 드문 일이 아니며 DR 사이트에서 기본 데이터 센터로 돌아 오는 완벽한 왕복 여행을 하루 중 더 잘 수행 할 수 있습니다. DR 테스트와 같은 좋은 기능이 있습니다. 재해 복구를위한 Microsoft 솔루션을 사용한 경험으로 재해 복구와 관련하여 훨씬 나은 솔루션을 제공합니다.

Microsoft의 Hyper-V DR 솔루션

Microsoft의 Hyper-V DR 솔루션은 다중 사이트 클러스터 구성에서 Windows Server 장애 조치 (Failover) 클러스터링입니다 (비디오 데모 참조). 이 구성에서 성능 및 동작은 로컬 영역 클러스터와 동일하지만 데이터 센터를 확장 할 수 있습니다. 기본적으로 가상 시스템을 인식 할 수있는 중단 시간이 거의없이 데이터 센터간에 이동할 수 있습니다. 페일 백은 동일한 프로세스이므로 포인트하고 클릭하여 가상 시스템 리소스를 기본 데이터 센터로 다시 이동하십시오. 내장 된 "DR 테스트"가 없습니다. 감지 할 수있는 중단 시간이없는 순간 1 ~ 2 분 만에 실제 DR 테스트를 수행하는 것이 좋습니다.

호스트 기반 복제 공급 업체

WSFC 멀티 사이트 클러스터에 대한 또 다른 장점 중 하나는 복제 옵션에 배열 기반 복제 공급 업체뿐만 아니라 호스트 기반 복제 공급 업체도 포함된다는 것입니다. 이는 모든 가격 범위에서 광범위한 복제 솔루션을 제공하며 기존 스토리지 인프라를 업그레이드 할 필요가 없습니다.

결함 허용

내결함성은 예기치 않은 오류가 발생할 경우 기본적으로 가상 컴퓨터를 다시 부팅 할 필요를 없애줍니다. VMware는 VMware FT를 제공한다는 점에서 여기서 가장 우위를 점하고 있습니다. 이 공간에서 플레이하는 다른 타사 하드웨어 및 소프트웨어 공급 업체도 있습니다. FT 시스템을 구현할 때는 많은 한계와 요구 사항이 있습니다. 하드웨어 구성 요소 오류가 발생하면 표준 HA 구성에서 VM을 부팅하는 데 몇 분 또는 2 분의 가동 중지 시간을 초래해야하는 경우이 옵션이 있습니다. 기존 서버가 이미 핫 대기 CPU, RAM, 전원 공급 장치 등으로 가득 차 있는지 확인해야합니다. 또한 네트워크와 스토리지에 대한 중복 경로가 있습니다. 그렇지 않으면 나쁜 후에 좋은 돈을 던질 수 있습니다. 내결함성은 하드웨어 오류로부터 보호하기에 좋습니다. 응용 프로그램이나 가상 컴퓨터의 운영 체제가 잘못 작동하면 어떻게됩니까? 즉, 아래에 설명 된대로 애플리케이션 레벨 클러스터링이 필요할 때입니다.

애플리케이션 가용성

지금까지 제가 논의한 모든 내용은 물리적 서버와 가상 컴퓨터의 전반적인 상태를 고려했습니다. 이 모든 것이 훌륭하지만 가상 시스템이 파란색 화면을 표시하면 어떻게됩니까? 또는 최신 SQL 서비스 팩으로 응용 프로그램이 손상된 경우 어떻게해야합니까? 그러한 경우,이 솔루션들 중 어느 것도 당신에게 좋은 일을하지 않을 것입니다. 가장 중요한 응용 프로그램의 경우 실제로 응용 프로그램 계층에서 클러스터해야합니다. 하이퍼 바이저 내에서 가상 시스템의 OS 내에서 실행되는 클러스터링 솔루션을 살펴보십시오. Microsoft 세계에서 이것은 MSCS / WSFC 또는 타사 클러스터링 솔루션을 의미합니다. 가상 시스템 내에서 클러스터링 할 때 스토리지 옵션은 iSCSI 대상 또는 호스트 기반 복제 솔루션으로 범위가 제한됩니다.  현재 VMware는이 문제에 대한 해결책이 없습니다. 응용 프로그램 계층 모니터링을 위해 가상 컴퓨터 내에서 실행되는 솔루션이 지연됩니다.

개요

가상화의 출현으로 인해 가용성이 필요한지 여부는 문제가되지 않습니다. 가상화 가용성 옵션이 SLA 및 / 또는 DR 요구 사항을 충족시키는 데 도움이 될 것입니다. 이 정보를 통해 사용 가능한 가용성 옵션을 이해하는 데 도움이되기를 바랍니다.

https://clusteringformeremortals.com/2009/08/14/making-sense-of-virtualization-availability-options-2/의 허락을 받아 재현

SIOS가 어떻게 당신을 도울 수 있는지 이해하기 위해 성공 사례를 읽어보십시오.

Filed Under: 서버 클러스터 단순화

가장 취약한 링크 제거, 고 가용성 클러스터 구성 보장

1월 21, 2018 by Jason Aw Leave a Comment

고 가용성 클러스터 구성 만들기

고 가용성 클러스터 구성을 구축 할 때 응용 프로그램 가용성은 가장 약한 링크만큼 좋습니다. 이것이 의미하는 바는 중복 된 모든 것 (CPU, 팬, 전원, RAID, RAM 등)을 갖춘 훌륭한 서버와 다중 경로 연결성을 갖춘 수퍼 디럭스 SAN을 구입 한 경우입니다. 여러 SAN 스위치와 결합하여 선호하는 클러스터링 소프트웨어로 애플리케이션을 클러스터링했습니다. 아마도 매우 신뢰할만한 응용 프로그램 일 것입니다 – 맞습니까? 음, 반드시 그런 것은 아닙니다. 서버가 동일한 UPS에 연결되어 있습니까? 그들은 동일한 네트워크 스위치에 있습니까? 동일한 AC 장치로 냉각 되었습니까? 그들은 같은 건물에 있습니까? SAN이 진정으로 신뢰할 수 있습니까? 이러한 문제 중 하나는 고 가용성 클러스터 구성의 단일 실패 지점입니다.

클러스터 구성에서 가장 약한 링크 찾기 및 제거

물론, "충분 함"이 "충분히 만족 스러울 때"를 알아야합니다. 예산과 SLA가 정확히 무엇이 좋은지 결정하는 데 도움이됩니다. 그러나 사람들이 저격 할 우려가있는 부분 중 하나는 저장 영역에 있습니다. 저렴한 또는 무료 iSCSI 대상 소프트웨어 솔루션의 출현으로 일부 사용자는 여분의 서버에 일부 iSCSI 대상 소프트웨어를 던져 즉시 공유 저장소에 보관할 것을 권장합니다.

페일 오버 기술 및 / 또는 기타 가용성 기능을 내장 한 OEM iSCSI 솔루션에 대해 언급하는 것이 아닙니다. FalconStor와 같은 스토리지 가상화 솔루션을 제공합니다. Windows Server 2008을 실행하는 서버를 가지고있는 사람이 스토리지를로드하고 iSCSI 대상으로 전환하려고합니다. 이것은 실험실에서 훌륭합니다. 그러나 당신이 HA에 대해 진지하다면 다시 생각해야합니다. 마이크로 소프트조차도 엔터프라이즈 급 스토리지 어레이 제공 경험이 풍부한 유능한 OEM 업체에게만 iSCSI 대상 소프트웨어를 제공합니다.

실제로 무엇을하고 있습니까?

우선, 이것은 Windows입니다. 스토리지를 제공하기 위해 만들어진 일부 강화 된 OS가 아닙니다. 유지 관리, 보안 업데이트, 하드웨어 수정 등이 필요합니다. 기본적으로 보호하려는 응용 프로그램 서버와 동일한 안정성을가집니다. 응용 프로그램 서버를 클러스터링하는 것이 합리적입니까? 그러나 서버 및 OS의 동일한 클래스를 사용하여 스토리지를 호스팅 할 수 있습니까? 기본적으로 단일 실패 지점을 응용 프로그램 서버 밖으로 옮기고이를 저장소 서버로 이동했습니다. 내가 염려하는 한 똑똑한 움직임이 아닙니다.

일부 엔터프라이즈 클래스 iSCSI 대상 소프트웨어에는 동기 및 / 또는 비동기 복제 소프트웨어 및 스냅 샷 기능이 포함되어 있습니다. 이 기능은 복구 지점 목표 (RPO) 측면에서 도움이됩니다. 페일 오버가 자동으로 클러스터링 소프트웨어에 원활하지 않으면 RTO (복구 시간 목표)에 도움이되지 않습니다. 한밤중에 기본 iSCSI 스토리지 배열이 실패했다고 가정 해 봅시다. 누가 복제 된 사본을 활성화 할 것입니까? 문제가 있음을 깨닫기까지 꽤 오랜 시간 동안 다운 될 수도 있습니다. 다시 말하지만, 이것은 "충분히 좋다"; 당신은 당신이 가입하고있는 것을 인식하고 있어야합니다. 원하는 고 가용성 클러스터 구성입니까?

SIOS 데이터 키퍼

iSCSI 대상 서버의 안정성을 향상시키기 위해 할 수있는 한 가지 방법은 SteelEye DataKeeper Cluster Edition과 같은 복제 제품을 사용하여 단일 실패 지점을 제거하는 것입니다. 설명해 드리겠습니다.

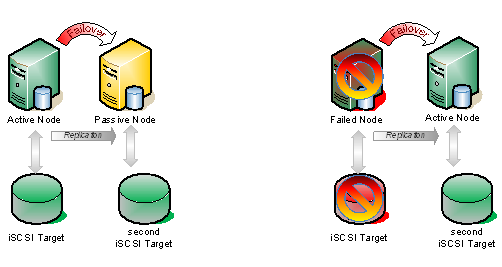
일반적인 공유 저장소 구성
그림 1 – 일반적인 공유 저장소 구성. iSCSI 대상을 사용할 수 없게되면 모든 노드가 오프라인 상태가됩니다.

위에서 설명한 것과 동일한 구성을 사용하고 복제 및 자동 장애 조치를 수행하기 위해 SteelEye DataKeeper Cluster Edition을 사용하는 핫 스탠바이 iSCSI 타겟을 추가하면 iSCSI 대상 솔루션이 완전히 새로운 차원의 가용성을 제공하게되었습니다. 그 해결책은 이것과 아주 비슷하게 보일 것입니다.

DataKeeper Cluster Edition - 고 가용성 클러스터 구성
그림 2 -이 시나리오에서 DataKeeper Cluster Edition은 활성 노드의 iSCSI 연결 볼륨을 완전히 다른 iSCSI 대상 서버에 연결된 수동 노드의 iSCSI 연결 볼륨으로 복제합니다.

SteelEye DataKeeper Cluster Edition과 복제 솔루션을 사용하는 솔루션의 주요 차이점은 일부 iSCSI 대상 공급 업체가 제공하는 WSFC와의 통합입니다. iSCSI 솔루션 공급 업체에게 묻는 질문은 다음과 같습니다.

활성 iSCSI 대상 서버에서 전원 코드를 당기면 어떻게됩니까?

복구 프로세스가 수동 절차 인 경우 실제 HA 솔루션이 아닙니다. 하지만 자동으로 WSFC와 완전히 통합되면 어떻게 될까요? 그런 다음 훨씬 높은 수준의 가용성을 확보하고 iSCSI 어레이를 단일 실패 지점으로 제거했습니다.

고 가용성 클러스터 구성을 달성하기 위해 우리와 채팅하십시오.

Clusteringformortals의 허가를 받아 복제했습니다.

Filed Under: Datakeeper, 서버 클러스터 단순화

Steeleye Datakeeper Cluster Edition, Windows It Pro에서 최고의 고 가용성 / 재해 복구 상 수상

1월 20, 2018 by Jason Aw Leave a Comment

저는 Windows IT Pro가 SteelEye DataKeeper Cluster Edition을 최고의 고 가용성 및 재해 복구 제품으로 두 범주로 선정했다고 발표하게되어 기쁩니다. 커뮤니티 초이스 금상 수상 및 편집자 최우수 실버 상.

SteelEye DataKeeper Cluster Edition - 최고의 고 가용성 재해 복구 제품SteelEye DataKeeper Cluster Edition - 최고의 고 가용성 재해 복구 제품

저는 SteelEye DataKeeper 팀의 일원이었던 것을 자랑스럽게 생각하며 Community Choice 상에 선정 된 모든 Windows IT Pro 커뮤니티에 감사드립니다!

https://clusteringformeremortals.com/2009/11/20/steeleye-datakeeper-cluster-edition-wins-windows-it-pro-best-high-availabilitydisaster-recovery-awards/에서 허락을 받아 복제했습니다.

Filed Under: Datakeeper, 서버 클러스터 단순화

  • « Previous Page
  • 1
  • …
  • 109
  • 110
  • 111
  • 112
  • Next Page »

최근 게시물

  • 고가용성(HA)이란 무엇인가요?
  • 금요일 밤의 시스템 충돌에서 살아남기: 초라한 베어메탈에서 완벽한 데이터 복제까지
  • Grounded: 암스테르담에서 열린 Percona Live에 참석하지 못한 것이 제게 HA에 대해 가르쳐준 것
  • SIOS LifeKeeper와 Red Hat 고가용성 추가 기능 비교:
  • 애플리케이션 복원력 현황: 2026 SIOS 고가용성 설문조사

가장 인기있는 게시물

우리의 메일 링리스트에 가입하세요

Copyright © 2026 · Enterprise Pro Theme on Genesis Framework · WordPress · Log in