SIOS SANless clusters

SIOS SANless clusters High-availability Machine Learning monitoring

  • Home
  • Products
    • SIOS DataKeeper for Windows
    • SIOS Protection Suite for Linux
  • การทดสอบอาหารสัตว์
  • ข่าวสารและกิจกรรม
  • ทำให้เข้าใจง่ายเซิร์ฟเวอร์คลัสเตอร์
  • เรื่องราวความสำเร็จ
  • ติดต่อเรา
  • English
  • 中文 (中国)
  • 中文 (台灣)
  • 한국어
  • Bahasa Indonesia
  • ไทย

ขยายเมตริกความพร้อมใช้งานสูงของคุณ

กันยายน 20, 2020 by Jason Aw Leave a Comment

ขยายเมตริกความพร้อมใช้งานสูงของคุณ

ขยายเมตริกความพร้อมใช้งานสูงของคุณ

ในสาขาเทคโนโลยีเรารักข้อมูล เราชอบข้อมูลเกี่ยวกับข้อมูลและเมตริกและมาตรการทั้งหมดที่เครื่องมือของเราสามารถนำมาใช้ได้ เราได้สร้างอุตสาหกรรมเกี่ยวกับการวิเคราะห์ผลิตภัณฑ์ที่รวบรวมทุกรายละเอียดจากอุปกรณ์ที่เชื่อมต่อหลายพันเครื่อง เราชอบตัวชี้วัดและมาตรการต่างๆ ในหลาย ๆ กรณีภายในพื้นที่ว่างที่สูงขึ้นเราชอบเมตริกความพร้อมใช้งานสูงที่บอกให้เราทราบว่าระบบฟื้นตัวจากความล้มเหลวได้เร็วเพียงใด เราคำนวณและติดตามเวลาระหว่างการตรวจจับและการแก้ไขและเราหมกมุ่นอยู่กับการรู้และวัดว่าข้อมูลธุรกรรมจะสูญหายไปจากภัยพิบัติระบบล้มเหลวหรือดิสก์ล่มมากเพียงใด

แดกดันในระบบความพร้อมใช้งานสูงและการกู้คืนความเสียหาย (HA / DR) มีเมตริกบางอย่างที่ไม่ได้รับความสนใจเพียงพอ

นี่คือเมตริกความพร้อมใช้งานสูงอื่น ๆ อีกแปดรายการที่คุณควรดูเพื่อจัดการสภาพแวดล้อมของคุณ:

1.  การแจ้งเตือนความปลอดภัย

ความพร้อมใช้งานไม่ใช่แค่การตรวจสอบและการกู้คืนแอปพลิเคชันเท่านั้น  ระบบที่เปิดเผยต่อสาธารณะมักถูกโจมตีอยู่เสมอ  หากคุณไม่ได้ตรวจสอบการแจ้งเตือนและคำเตือนด้านความปลอดภัยแอปพลิเคชันของคุณอาจทำงานได้อย่างไม่มีที่ติในขณะที่ทรัพย์สินทางปัญญาของคุณกำลังถูกขนย้ายออกไปอย่างไร้ที่ติ

2. การเชื่อมต่อที่ไม่ได้ใช้งาน

การเชื่อมต่อที่ไม่ได้ใช้งานฟังดูไม่เป็นอันตราย แต่มันก็ไม่เป็นอันตรายเช่นเดียวกับคุดสุใบเขียวบนสนามหญ้าทางใต้  การเชื่อมต่อที่ไม่ได้ใช้งานจะใช้ทรัพยากรและคุกคามเพื่อเติมเต็มพูลฐานข้อมูลเครือข่ายที่แออัดและยับยั้งประสิทธิภาพ  นอกจากนี้การเชื่อมต่อที่ไม่ได้ใช้งานอาจบ่งบอกถึงปัญหาในเลเยอร์แอปพลิเคชันหรือการกำหนดค่าฐานข้อมูล

3. แบบสอบถามคำสั่งหรืองานที่ใช้งานมานาน

สิ่งนี้ใช้ไม่เพียงกับการสืบค้นฐานข้อมูลหรืองานเท่านั้น แต่ยังรวมถึงคำสั่งและการสำรองข้อมูลด้วย  คิวรีคำสั่งและงานที่รันเป็นเวลานานอาจเป็นตัวบ่งชี้ความสมบูรณ์ของระบบที่ไม่ดีความเร็วของดิสก์ที่ช้า CPU หรือการแย่งชิงทรัพยากรอื่น ๆ หรือปัญหาระบบความเข้ากันได้ของแอปพลิเคชันหรือระบบปฏิบัติการที่ลึกกว่า

4. ดิสก์ IO

โดยทั่วไป Disk IO หมายถึงการดำเนินการอินพุต / เอาต์พุตของระบบที่เกี่ยวข้องกับกิจกรรมของดิสก์ การวัดดิสก์ I / O สามารถช่วยระบุปัญหาคอขวดการกำหนดค่าฮาร์ดแวร์ที่ไม่ดีดิสก์ที่มีขนาดไม่เหมาะสมหรือเค้าโครงดิสก์ที่ได้รับการปรับแต่งไม่ดีสำหรับปริมาณงานที่กำหนด  การตรวจสอบดิสก์ I / O สามารถช่วยบอกคุณได้ว่าคิวรีที่รันเป็นเวลานานเป็นฟังก์ชันของไวยากรณ์ sql ที่ไม่ดีแอปพลิเคชันที่เข้ารหัสไม่ดีหรือปัญหาเวลาแฝงและการเข้าถึงหรือไม่

5. หน่วยความจำ

เราทุกคนคิดเกี่ยวกับจำนวนหน่วยความจำที่ใช้ แต่การตรวจสอบหน่วยความจำนั้นเป็นมากกว่าการวัดและดูที่ฟรีเมื่อเทียบกับที่ใช้  การตรวจสอบหน่วยความจำช่วยให้คุณตรวจสอบคอขวดการรั่วไหลระบุระบบที่มีขนาดไม่เหมาะสมเข้าใจโหลดค่าเฉลี่ยโหลดและการเพิ่มขึ้นอย่างรวดเร็ว  นอกจากนี้การเรียนรู้เกี่ยวกับรูปแบบที่ใช้หน่วยความจำมากสามารถช่วยคุณปรับแต่งชุดความพร้อมใช้งานเพื่อหลีกเลี่ยงความผิดพลาดที่ผิดพลาดได้

6. พื้นที่ดิสก์

ในฐานะรองประธานฝ่ายประสบการณ์ลูกค้าครั้งหนึ่งฉันเคยมีประสบการณ์ที่โชคร้ายในการตื่น แต่เช้าเพื่อโทรฉุกเฉิน  ลูกค้าประสบปัญหาระบบการผลิตล่มหลังจากไฟฟ้าดับ  เมื่อพยายามรีสตาร์ทระบบแอปพลิเคชันที่ได้รับการป้องกันไม่สามารถเริ่มทำงานได้  หลังจากตรวจสอบบันทึกข้อผิดพลาดอย่างรวดเร็วเป็นที่ชัดเจนว่ารูทไดรฟ์เต็ม 100%  แอปพลิเคชันไม่สามารถเขียนลงในระบบไฟล์ใด ๆ  การตรวจสอบพื้นที่ดิสก์มีให้ใช้งานในหลายรูปแบบและหลายวิธีและการมีเป็นเมตริกสามารถป้องกันปัญหาที่ไม่จำเป็นและการแย่งชิงในนาทีสุดท้ายที่มีราคาแพงเพื่อเพิ่ม .

7. ข้อผิดพลาดและการแจ้งเตือน

ข้อผิดพลาดการแจ้งเตือนและข้อความการกู้คืนในบันทึกเป็นอีกหนึ่งเมตริกที่ควรพิจารณา  โซลูชันความพร้อมใช้งานของคุณอาจทำให้ลูกค้าของคุณออนไลน์และมีความสุข แต่ก็อาจปกปิดปัญหาที่คุณจะต้องดำเนินการในไม่ช้า  การเพิ่มการตรวจสอบบันทึกสำหรับข้อความ FATAL, PANIC และคีย์ ERROR สามารถช่วยคุณระบุปัญหาที่โซลูชันความพร้อมใช้งานของคุณมักจะกู้คืนเช่นฐานข้อมูลล่มแอปพลิเคชันตื่นตระหนกหรือการทิ้งข้อมูลหลักหรือข้อผิดพลาดร้ายแรงที่ต้องรีสตาร์ทเย็น

8. หมายเลขการกู้คืน

เช่นเดียวกับการตรวจสอบข้อผิดพลาดและการแจ้งเตือนหมายเลขการกู้คืนสามารถบอกคุณได้มากมายเกี่ยวกับความพร้อมใช้งานของระบบของคุณ  หากคุณเฉลี่ยการกู้คืนแอปพลิเคชันมากกว่าหนึ่งครั้งต่อสัปดาห์คุณอาจประสบปัญหาบางอย่างที่มากกว่าการป้องกันความพร้อมใช้งานปกติ  และในขณะที่การกู้คืนประสบความสำเร็จในการรีสตาร์ทแอปพลิเคชันหรือระบบของคุณการกู้คืนที่ผิดพลาดหรือแม้แต่การกู้คืนจริงจำนวนมากเกินไปก็ไม่ดี

รายการเมตริก HA / DR ที่เราตรวจสอบได้และเครื่องมือในการตรวจสอบนั้นกำลังเติบโตอย่างก้าวกระโดด  ตรวจสอบให้แน่ใจว่าคุณและทีมของคุณพิจารณาขยายการบันทึกและวิเคราะห์ข้อมูลในปัจจุบันเพื่อรวมสิ่งที่ทำให้ระบบความพร้อมใช้งานสูงขึ้นที่ดีที่สุดเท่าที่จะเป็นไปได้

– Cassius Rhue รองประธานฝ่ายประสบการณ์ลูกค้า


ทำซ้ำโดยได้รับอนุญาตจาก SIOS
Filed Under: ทำให้เข้าใจง่ายเซิร์ฟเวอร์คลัสเตอร์

การกู้คืนอัตโนมัติสำหรับแอปพลิเคชัน Microsoft IIS ที่ทำงานบน Amazon EC2

กันยายน 14, 2020 by Jason Aw Leave a Comment

การกู้คืนอัตโนมัติสำหรับแอปพลิเคชัน Microsoft IIS ที่ทำงานบน Amazon EC2

ทางเลือกที่ดีกว่าสำหรับการลดเวลาหยุดทำงานของ IIS

Microsoft’s IIS (Internet Information Services) เป็นเว็บเซิร์ฟเวอร์ที่ได้รับความนิยมมากที่สุดเป็นอันดับ 4 ในปัจจุบันโดยมีส่วนแบ่งการตลาด 7.8% ตามหลัง Apache, Nginx และ Cloudflare (ที่มา W3Techs.com, 8/12/20) และลูกค้า IIS จำนวนมากกำลังเรียกใช้แอปพลิเคชัน IIS บน Amazon EC2

IIS เป็นเว็บเซิร์ฟเวอร์ที่หลากหลายขยายได้และกำหนดค่าได้สูง IIS มีฟังก์ชันการทำงานที่สำคัญบางอย่างเพื่อให้แน่ใจว่าแอปพลิเคชันทำงานอย่างถูกต้องเช่น Application Pools และความสามารถในการจัดการระยะไกลเพื่อให้ผู้ดูแลระบบสามารถจัดการ IIS จากระยะไกลโดยใช้ PowerShell

การตัดสินใจว่าจะตรวจสอบและจัดการแอปพลิเคชัน IIS อย่างไร

เมื่อพูดถึงการจัดการและตรวจสอบแอปพลิเคชัน IIS ลูกค้ามีตัวเลือกมากมาย พวกเขามุ่งเน้นไปที่การปรับปรุงประสิทธิภาพของแอปพลิเคชันที่ทำงานบน IIS หรือการตรวจสอบและแก้ไขความล้มเหลว

Microsoft มีฟังก์ชันดั้งเดิมบางอย่างเพื่อช่วยคุณเพิ่มประสิทธิภาพและจัดการแอปพลิเคชันของคุณที่ทำงานบน IIS หากคุณและทีมของคุณมีความเชี่ยวชาญในด้านเทคนิคคุณอาจจะสะดวกในการใช้ PowerShell หรือภาษาสคริปต์อื่นเพื่อจัดการ IIS Application Pools การทำเช่นนี้ช่วยให้คุณสามารถรีไซเคิลพูลและหน่วยความจำเสมือนของคุณโดยอัตโนมัติเมื่อถึงเวลาที่กำหนดหรือเกณฑ์การร้องขอ

แต่สิ่งนี้ไม่ได้ช่วยคุณหากแอปพลิเคชัน IIS ของคุณประสบความล้มเหลว  ในการตรวจสอบเซิร์ฟเวอร์ IIS ของคุณคุณต้องมองหาเครื่องมือการมอนิเตอร์ (“ APM”) ที่สามารถแจ้งเตือนคุณถึงความล้มเหลวและให้รายละเอียดเกี่ยวกับสิ่งที่ล้มเหลว  ซึ่งรวมถึงโซลูชันเชิงพาณิชย์เช่นจาก SolarWinds, AppDynamics, Dynatrace, Datadog และ New Relic  วิธีการตัดสินใจของคุณขึ้นอยู่กับความต้องการขอบเขตและความซับซ้อนของคุณสมบัติและส่วนต่อประสานผู้ใช้และความเรียบง่ายของกระบวนการตั้งค่า โซลูชัน APM นั้นยอดเยี่ยมในการแจ้งเตือนคุณเมื่อมีสิ่งผิดปกติเกิดขึ้นและเหตุใด แต่ก็ไม่ได้ช่วยให้คุณสามารถสำรองและทำงานได้เสมอไปหากเซิร์ฟเวอร์ IIS ของคุณไม่ทำงาน

ทางเลือกที่ดีกว่าสำหรับการลดเวลาหยุดทำงานของ IIS

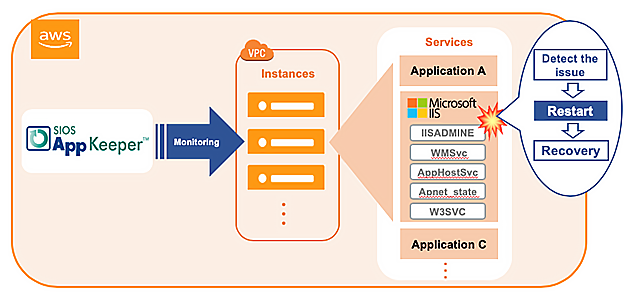
หากคุณกำลังมองหาโซลูชันที่ไม่เพียงตรวจสอบเซิร์ฟเวอร์ IIS ของคุณที่ทำงานบน Amazon EC2 แต่ยังช่วยลดเวลาหยุดทำงานเราขอแนะนำให้คุณตรวจสอบโซลูชันการตรวจสอบ SIOS AppKeeper AppKeeper จะตรวจสอบและกู้คืนแอปพลิเคชันโดยอัตโนมัติเช่นแอปพลิเคชันที่ทำงานบน IIS หากพบปัญหาการหยุดชะงักของบริการและการหยุดทำงาน

มาดูกันว่าโซลูชันการตรวจสอบ AppKeeper EC2 ช่วยลดเวลาหยุดทำงานของ IIS ได้อย่างไร:

  • AppKeeper ตรวจสอบบริการ EC2 และอินสแตนซ์ของคุณ เมื่อคุณติดตั้งและกำหนดค่า AppKeeper (ซึ่งใช้เวลาประมาณ 10 นาทีเท่านั้น) คุณจะต้องระบุอินสแตนซ์และบริการของ Amazon EC2 ที่ควรตรวจสอบและควรดำเนินการอย่างไรหากพบความบกพร่องของระบบ
  • AppKeeper แจ้งเตือนคุณหากตรวจพบความล้มเหลวของระบบกับเว็บเซิร์ฟเวอร์ IIS ของคุณ  คุณได้รับการแจ้งเตือนทางอีเมลหรือ SMS และสามารถดูรายละเอียดของเหตุการณ์ความล้มเหลวและสิ่งที่ดำเนินการ

  • AppKeeper จะเปิดบริการรีสตาร์ทอัตโนมัติและรีบูตอินสแตนซ์หากจำเป็นเมื่อตรวจพบความล้มเหลวของระบบ คุณไม่ต้องตอบสนองต่อการแจ้งเตือนและแก้ไขปัญหาก่อนรีสตาร์ทอีกต่อไป AppKeeper ทำสิ่งนั้นให้คุณโดยอัตโนมัติ

นอกเหนือจากการจัดการประสิทธิภาพของเซิร์ฟเวอร์ IIS หรือการตรวจสอบไปจนถึงการแก้ไขอัตโนมัติแล้ว AppKeeper จะกำจัดเวลาหยุดทำงานและให้ความอุ่นใจที่คุณสมควรได้รับ

ปัจจุบัน บริษัท หลายร้อยแห่งพึ่งพา AppKeeper เพื่อให้สภาพแวดล้อมระบบคลาวด์ทำงานอยู่เสมอ เราขอเชิญคุณดูวิดีโอด้านล่างเพื่อดูว่าการติดตั้งและใช้ AppKeeper นั้นง่ายเพียงใด

วิดีโอ: การติดตั้ง AppKeeper และการกู้คืนจาก AWS EC2 ล้มเหลวการสาธิต

และหากคุณชอบสิ่งที่คุณเห็นโปรดลงทะเบียนเพื่อทดลองใช้ AppKeeper ฟรี 14 วัน

ทำซ้ำโดยได้รับอนุญาตจาก SIOS

Filed Under: ทำให้เข้าใจง่ายเซิร์ฟเวอร์คลัสเตอร์

วิธีการส่งมอบความพร้อมใช้งานสูงสำหรับ SQL Server ในสภาพแวดล้อม Linux

กันยายน 10, 2020 by Jason Aw Leave a Comment

วิธีการส่งมอบความพร้อมใช้งานสูงสำหรับ SQL Server ในสภาพแวดล้อม Linux

วิธีส่งมอบความพร้อมใช้งานสูงสำหรับ SQL Server ในสภาพแวดล้อม Linux

หากองค์กรของคุณใช้ Microsoft SQL Server ที่มีความสำคัญทางธุรกิจบน Linux ทีมไอทีของคุณจะรู้ดีว่าการรักษาความพร้อมใช้งานประสิทธิภาพและความปลอดภัยอย่างต่อเนื่องนั้นยากเพียงใด สิ่งที่ยากอย่างยิ่งคือการทำให้มั่นใจว่ามีความพร้อมใช้งานสูงด้วยการจำลองแบบที่มีประสิทธิภาพและการเฟลโอเวอร์อัตโนมัติ การใช้ซอฟต์แวร์โอเพนซอร์สและโซลูชันคลัสเตอร์ HA SANless ที่กำหนดค่าได้ง่ายสามารถนำเสนอแนวทางการบำรุงรักษาที่ง่ายขึ้นโดยไม่ต้องเสียสละความปลอดภัยและประสิทธิภาพที่องค์กรของคุณต้องการ

ตัวเลือกความพร้อมใช้งานสูงที่ จำกัด สำหรับ Linux

การกระจาย Linux ส่วนใหญ่ทำให้แผนกไอทีมีทางเลือกที่ด้อยกว่าสองทางสำหรับความพร้อมใช้งานที่สูง: จ่ายเพิ่มสำหรับ SQL Server Enterprise Edition เพื่อใช้งาน Always On Availability Groups หรือพยายามทำให้การกำหนดค่า HA Linux ที่ซับซ้อนต้องทำด้วยตัวเองทำงานได้ดีซึ่งเป็นสิ่งที่สามารถพิเศษได้ ยากที่จะทำ

ปัญหาในการใช้ Enterprise Edition คือมันทำลายกลยุทธ์การประหยัดต้นทุนสำหรับการใช้ระบบปฏิบัติการโอเพนซอร์สบนฮาร์ดแวร์สินค้าโภคภัณฑ์ สำหรับแอ็พพลิเคชัน SQL Server ขนาดเล็กจำนวน จำกัด อาจเป็นไปได้ที่จะปรับค่าใช้จ่ายเพิ่มเติม แต่ราคาแพงเกินไปสำหรับแอปพลิเคชันฐานข้อมูลจำนวนมากและจะไม่ทำอะไรเลยเพื่อจัดหา HA สำหรับ Linux สำหรับวัตถุประสงค์ทั่วไป

การจัดเตรียม HA ในแอปพลิเคชันทั้งหมดที่ทำงานในสภาพแวดล้อม Linux สามารถทำได้โดยใช้ซอฟต์แวร์โอเพนซอร์สเช่น Pacemaker และ Corosync หรือ SUSE Linux Enterprise High Availability Extension แต่การทำให้ซอฟต์แวร์สแต็กเต็มรูปแบบทำงานได้ตามที่ต้องการจำเป็นต้องสร้าง (และทดสอบ) สคริปต์ที่กำหนดเองสำหรับแต่ละแอปพลิเคชันและสคริปต์เหล่านี้มักจะต้องได้รับการทดสอบและอัปเดตใหม่หลังจากที่มีการเปลี่ยนแปลงเล็กน้อยกับซอฟต์แวร์หรือฮาร์ดแวร์ที่ใช้ ความสามารถที่เกี่ยวข้องกับความพร้อมใช้งานที่ไม่ได้รับการสนับสนุนทั้งใน SQL Server Standard Edition และ Linux สามารถทำให้ความพยายามนี้ท้าทายมากขึ้น

การค้นหาโซลูชันความพร้อมใช้งานสูงทางเลือกสำหรับ SQL Server ใน Linux

เพื่อให้ HA ทั้งประหยัดต้นทุนและใช้งานง่ายคุณอาจต้องการพิจารณาสองวิธีที่แตกต่างกันสำหรับวัตถุประสงค์ทั่วไป

ระบบหนึ่งกำลังใช้ระบบที่ใช้หน่วยเก็บข้อมูลซึ่งปกป้องข้อมูลโดยการจำลองแบบภายในเครือข่ายพื้นที่จัดเก็บข้อมูล (SAN) ที่ซ้ำซ้อนและยืดหยุ่น วิธีนี้ไม่เชื่อเรื่องพระเจ้าเกี่ยวกับระบบปฏิบัติการโฮสต์ แต่ต้องการให้โครงสร้างพื้นฐาน SAN ทั้งหมดต้องได้รับจากผู้จำหน่ายรายเดียวและต้องอาศัยข้อกำหนดเกี่ยวกับความล้มเหลวแยกต่างหากเพื่อให้มีความพร้อมใช้งานสูง

อีกวิธีหนึ่งคือการใช้โฮสต์และเกี่ยวข้องกับการสร้างคลัสเตอร์ SANless ที่ไม่เชื่อเรื่องพระเจ้าบนอินสแตนซ์เซิร์ฟเวอร์ Linux ในฐานะโอเวอร์เลย์ HA คลัสเตอร์เหล่านี้สามารถดำเนินการได้ทั้ง LAN และ WAN ในคลาวด์ส่วนตัวสาธารณะและไฮบริด การซ้อนทับยังไม่เชื่อเรื่องพระเจ้าโดยใช้แอปพลิเคชันทำให้องค์กรต่างๆมีโซลูชัน HA แบบสากลเดียวสำหรับทุกแอปพลิเคชัน แม้ว่าวิธีนี้จะใช้ทรัพยากรโฮสต์ แต่ก็มีราคาไม่แพงนักและปรับขนาดได้ง่ายในสภาพแวดล้อม Linux

ตัวเลือกคลัสเตอร์ HA SANless ส่วนใหญ่มีการรวมกันของการจำลองข้อมูลระดับบล็อกแบบเรียลไทม์การตรวจสอบแอปพลิเคชันอย่างต่อเนื่องและนโยบายการกู้คืนสำหรับความล้มเหลว / ความล้มเหลวที่กำหนดค่าได้เพื่อปกป้องแอปพลิเคชันที่มีความสำคัญทางธุรกิจทั้งหมดรวมถึงแอปพลิเคชันที่ใช้อินสแตนซ์คลัสเตอร์แบบปิดตลอดเวลาที่มีอยู่ใน Standard Edition ของ SQL Server

SIOS Technology Corp. นำเสนอโซลูชันคลัสเตอร์ HA SANless ที่มีประสิทธิภาพมากขึ้นสำหรับ Linux พร้อมความสามารถขั้นสูงที่ออกแบบมาเพื่อปลดปล่อยไอทีจากความซับซ้อนและความท้าทายในชีวิตประจำวันในการสนับสนุนและเพิ่มประสิทธิภาพโครงสร้างพื้นฐานคอมพิวเตอร์ โซลูชัน SIOS Protection Suite พร้อม LifeKeeper ให้:

  • การตรวจสอบอย่างต่อเนื่องของสแต็กแอพพลิเคชัน Linux ทั้งหมด
  • Application-Aware Protection ที่สมบูรณ์ด้วยชุดการกู้คืนแอปพลิเคชัน (ARK) เพื่อการกู้คืนที่รวดเร็วปลอดภัยหรือการล้มเหลวของแอปพลิเคชันและฐานข้อมูลที่ซับซ้อน
  • การตั้งค่าที่ใช้วิซาร์ดสำหรับการทำคลัสเตอร์ Linux
  • ความยืดหยุ่นในการกำหนดค่าเช่นการใช้คลัสเตอร์หน่วยเก็บข้อมูลที่ใช้ร่วมกันแบบดั้งเดิมหรือซอฟต์แวร์เพื่อซิงโครไนซ์ที่เก็บข้อมูลภายในในการกำหนดค่าคลัสเตอร์ SANless

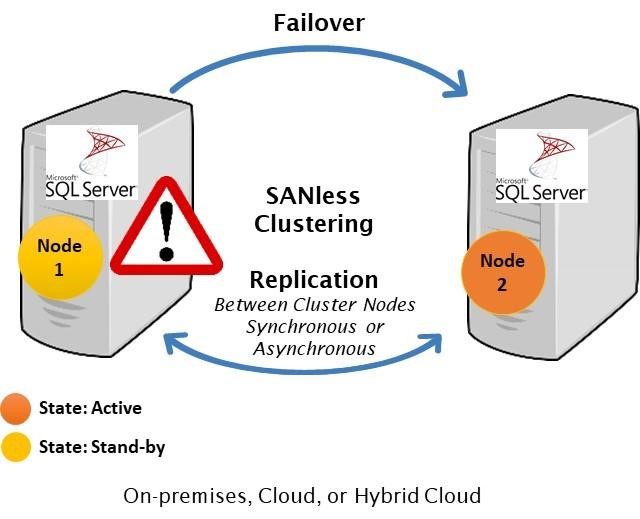
ตัวอย่างเช่นคลัสเตอร์ SANless สามารถจัดการกับความล้มเหลวพร้อมกันสองครั้ง การทำงานพื้นฐานจะเหมือนกันใน LAN และ WAN รวมถึงคลาวด์ส่วนตัวสาธารณะและไฮบริด

ในเซิร์ฟเวอร์คลัสเตอร์สองโหนดทั่วไป # 1 เริ่มแรกเป็นเซิร์ฟเวอร์หลักที่จำลองข้อมูลไปยังเซิร์ฟเวอร์ # ประสบปัญหาโดยอัตโนมัติทริกเกอร์ล้มเหลวไปยังเซิร์ฟเวอร์ # 2 ซึ่งตอนนี้กลายเป็นหลัก

ในสถานการณ์เช่นนี้แผนกไอทีน่าจะเริ่มวินิจฉัยและซ่อมแซมปัญหาใดก็ตามที่ทำให้เซิร์ฟเวอร์ # 1 ล้มเหลว เมื่อแก้ไขแล้วอาจรับช่วงต่อเนื่องจากเซิร์ฟเวอร์หลักหรือเซิร์ฟเวอร์ # 2 สามารถดำเนินการต่อในความสามารถนั้นในการจำลองข้อมูลไปยังเซิร์ฟเวอร์ # 1

ด้วยการกำหนดค่าการทำคลัสเตอร์แบบ HA SANless ส่วนใหญ่การเฟลโอเวอร์จะเป็นไปโดยอัตโนมัติและทั้งเฟลโอเวอร์และเฟลแบ็คสามารถควบคุมได้โดยคอนโซลที่ใช้เบราว์เซอร์

สำหรับข้อมูลเพิ่มเติมเกี่ยวกับโซลูชัน SIOS LifeKeeper และ Protection Suite โปรดไปที่ SIOS SAN และ SANless High Availability Clusters สำหรับสภาพแวดล้อมของเซิร์ฟเวอร์คลัสเตอร์

ทำซ้ำโดยได้รับอนุญาตจาก SIOS

Filed Under: ทำให้เข้าใจง่ายเซิร์ฟเวอร์คลัสเตอร์ Tagged With: ลินุกซ์

วิธีเปิดใช้งานใบอนุญาตสำหรับซอฟต์แวร์ SIOS Clustering

กันยายน 6, 2020 by Jason Aw Leave a Comment

วิธีเปิดใช้งานใบอนุญาตสำหรับซอฟต์แวร์ SIOS Clustering

วิธีเปิดใช้งานใบอนุญาตสำหรับซอฟต์แวร์ SIOS Clustering

วิดีโอสั้น ๆ นี้เป็นครั้งแรกในชุดบทแนะนำ "วิธีการ" ที่พร้อมใช้งานของแอปพลิเคชันที่ออกแบบโดยทีมสนับสนุน SIOS โดยจะอธิบายถึงขั้นตอนง่ายๆที่จำเป็นในการเริ่มต้นใช้งาน SIOS Protection Suite หรือซอฟต์แวร์ SIOS DataKeeper  เรียนรู้วิธีการเข้าถึงทรัพยากรการสนับสนุนที่หลากหลายในไลบรารีเอกสาร SIOS

วิธีเปิดใช้งานใบอนุญาตสำหรับซอฟต์แวร์ SIOS Clustering

ทำซ้ำโดยได้รับอนุญาตจาก SIOS

Filed Under: ทำให้เข้าใจง่ายเซิร์ฟเวอร์คลัสเตอร์ Tagged With: SIatus Datakeeper

จะเกิดอะไรขึ้นถ้าเรากำจัด Apache Downtime?

สิงหาคม 30, 2020 by Jason Aw Leave a Comment


กำจัดการหยุดทำงานของเว็บเซิร์ฟเวอร์ Apache ด้วย SIOS AppKeeper Monitoring

กำจัด * การหยุดทำงานของเว็บเซิร์ฟเวอร์ Apache ด้วย SIOS AppKeeper Monitoring

ปัจจุบันเว็บเซิร์ฟเวอร์ Apache เป็นเว็บเซิร์ฟเวอร์ที่ได้รับความนิยมมากที่สุดบนอินเทอร์เน็ต  บริษัท ต่างๆกำลังปรับใช้แอปพลิเคชันที่เน้นภารกิจสำคัญสำหรับลูกค้าที่สร้างขึ้นบน Apache โดยใช้แพลตฟอร์มคลาวด์เช่น Amazon AWS, Microsoft Azure และ Google Cloud Platform  ดังนั้นคุณสามารถเดิมพันได้ว่าพวกเขาใช้เวลาและเงินจำนวนมากในการตรวจสอบแอปพลิเคชันเหล่านั้นและพยายามลดเวลาหยุดทำงาน แต่ถ้าเราบอกคุณว่าเราสามารถขจัดความจำเป็นในการแทรกแซงด้วยตนเองผ่านการตรวจสอบอัตโนมัติและการรีสตาร์ทแอปพลิเคชันเมื่อเว็บเซิร์ฟเวอร์ Apache ของคุณไม่ทำงาน

ก่อนที่เราจะไปดูว่าเราจะทำเช่นนั้นได้อย่างไรลองย้อนกลับไปสักครู่และดูตัวเลือกที่ บริษัท ต่างๆมีในการตรวจสอบและจัดการเว็บเซิร์ฟเวอร์ Apache และแอปพลิเคชันที่สำคัญเหล่านั้น

วิธีตรวจสอบและปกป้องเว็บเซิร์ฟเวอร์ Apache ของคุณจากการหยุดทำงานโดยไม่จำเป็น

ใครก็ตามที่ปรับใช้แอปพลิเคชันโดยใช้เว็บเซิร์ฟเวอร์ Apache อาจพิจารณาตรวจสอบความสมบูรณ์ของเว็บเซิร์ฟเวอร์ด้วยตนเองหรือจ้างงานนั้นให้บุคคลที่สาม

เมื่อพูดถึงการตรวจสอบแอปพลิเคชันระบบคลาวด์ที่ทำงานบน Amazon Web Services ตัวเลือกยอดนิยมคือการใช้ Amazon CloudWatch  บริษัท บางแห่งกำลังขยายการทำงานของ CloudWatch ด้วยการสร้างระบบอัตโนมัติบางระดับโดยการพัฒนาสคริปต์หรือใช้ AWS Lambda  แต่การกำหนดค่า Amazon CloudWatch อย่างเหมาะสมด้วยเมตริกที่กำหนดเองและการตั้งค่า AWS Lambda จำเป็นต้องใช้ความเชี่ยวชาญด้านเทคนิคจำนวนหนึ่งซึ่งอาจมีมากกว่า บริษัท หลายแห่ง  จากนั้นมีค่าใช้จ่ายและความพยายามในการดูแลรักษาสคริปต์ใด ๆ เมื่อแอปพลิเคชันพัฒนาขึ้น

อีกทางเลือกหนึ่งคือการลงทุนในโซลูชัน Application Performance Monitoring (“ APM”) ที่ครอบคลุมจากผู้ขายเช่น New Relics, Dynatrace, DataDog หรือ LogicMonitor สิ่งเหล่านี้เหมาะสมมากหากคุณต้องการตรวจสอบมากกว่าแค่สภาพแวดล้อม AWS ของคุณ โซลูชัน APM สามารถกำหนดค่าได้มากและจะให้ข้อมูลจำนวนมากแก่คุณในแง่ของข้อมูลเกี่ยวกับสิ่งที่เกิดขึ้น

แต่คุณลดเวลาหยุดทำงานลงหรือยัง? อาจจะไม่.  สิ่งที่คุณทำคือการลงทุนในระบบที่จะแจ้งเตือนคุณทันทีหากและเมื่อใดที่เว็บเซิร์ฟเวอร์ Apache ของคุณหยุดทำงานและจะทำให้คุณมีข้อมูลมากเกินไป (หรือ "แจ้งเตือนพายุ") เมื่อคุณพยายามทำให้สิ่งต่างๆกลับมาทำงานอีกครั้ง

บริษัท บางแห่งตัดสินใจที่จะจ้างบุคคลภายนอกรับผิดชอบในการตรวจสอบและจัดการแอปพลิเคชันของตนให้กับบุคคลภายนอกที่เชื่อถือได้ (มักจะเป็น“ ผู้ให้บริการที่มีการจัดการ” หรือ MSP) เพื่อตอบแทนค่าบริการรายเดือนพื้นฐาน MSP จะตรวจสอบแอปพลิเคชันและเสนอชุดบริการหลักซึ่งมักจะผูกพันตามข้อตกลงระดับการให้บริการ เมื่อได้รับการแจ้งเตือนพวกเขาจะตรวจสอบ ในบางกรณีการตรวจสอบเหล่านี้อาจต้องมีการส่งต่อ (มีค่าใช้จ่ายสูง) หากและเมื่อแอปพลิเคชันหยุดทำงาน MSP จะเข้าควบคุมและรีสตาร์ทบริการหรือรีบูตอินสแตนซ์ที่สามารถทำได้  แต่การดำเนินการแก้ไขเหล่านี้มักเป็นค่าใช้จ่ายเพิ่มเติม

จะต้องมีวิธีที่ดีกว่านี้

การตรวจสอบอัตโนมัติและรีสตาร์ทด้วย SIOS AppKeeper ช่วยลดเวลาหยุดทำงานของ Apache Webserver ได้อย่างไร

จากประสบการณ์ของลูกค้าของเรา บริษัท โดยเฉลี่ยที่มีอินสแตนซ์ EC2 เพียงสามแห่งประสบปัญหาการหยุดทำงานอย่างน้อยเดือนละครั้ง  “ เว็บไซต์ล่ม! ปล่อยวางทุกอย่าง ค้นหาสิ่งที่ต้องทำ!” สิ่งที่คุณต้องทำคือลดความจำเป็นในการฝึกซ้อมดับเพลิงที่ไม่จำเป็นเหล่านี้

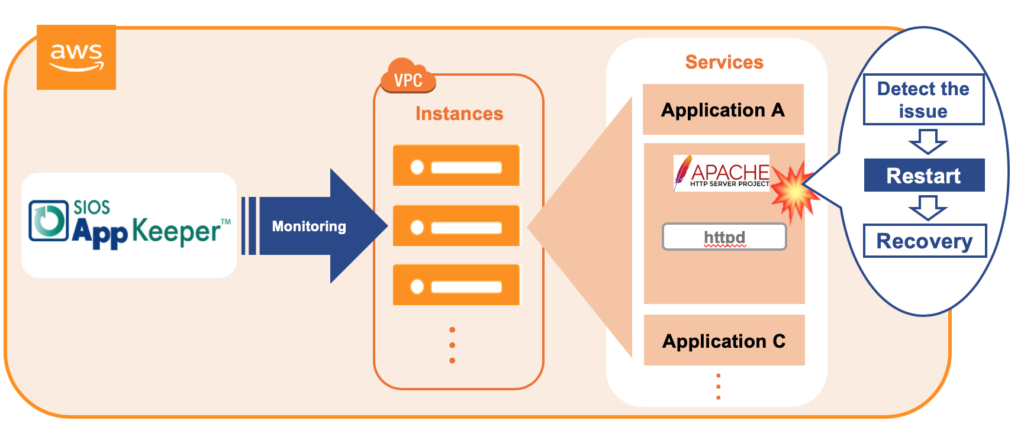
SIOS AppKeeper เป็นบริการ SaaS ที่ง่ายต่อการติดตั้งและกำหนดค่าและตรวจสอบบริการและแอปพลิเคชันที่ทำงานบน Amazon EC2 เช่นบริการ Apache httpd ของคุณ  เมื่อตรวจพบความผิดปกติ AppKeeper จะรีสตาร์ทบริการโดยอัตโนมัติและหากไม่ได้ผลระบบจะรีบูตอินสแตนซ์ทั้งหมด ไม่ต้องอ่านบันทึกอีกต่อไปเพื่อระบุสาเหตุของความล้มเหลวหรือส่งต่อให้นักพัฒนาเริ่มบริการของคุณใหม่ หรือค่าจ้างแพง.  AppKeeper มีฟังก์ชัน“ set-it-and-forget-it” เพื่อให้คุณสามารถกำจัดการหยุดทำงานได้

ปัจจุบัน บริษัท หลายร้อยแห่งพึ่งพา AppKeeper เพื่อให้สภาพแวดล้อมระบบคลาวด์ทำงานอยู่เสมอ เราขอเชิญคุณดูวิดีโอด้านล่างเพื่อสาธิตวิธีที่ AppKeeper ปกป้องเว็บเซิร์ฟเวอร์ Apache  และหากคุณชอบสิ่งที่คุณเห็นโปรดลงทะเบียนเพื่อทดลองใช้ AppKeeper ฟรี 14 วัน

จะเกิดอะไรขึ้นถ้าเรากำจัด Apache Downtime

* จากข้อมูลลูกค้า AppKeeper ระบุ 85% ของความล้มเหลวของบริการแอปพลิเคชัน ดังนั้นในเกือบเก้าครั้งในสิบ AppKeeper จะส่งอีเมลแจ้งให้ลูกค้าทราบว่าระบบตรวจพบการหยุดทำงานและบริการเริ่มต้นใหม่หรือรีบูตอินสแตนซ์โดยอัตโนมัติ  ไม่ดีไปกว่าการตื่นตระหนกและขุดดูไฟล์บันทึกก่อนที่จะรีสตาร์ททุกอย่างด้วยตนเองใช่หรือไม่

ดูโพสต์ที่เกี่ยวข้อง: เหตุใดการตรวจสอบแอปพลิเคชัน AWS EC2 จึงยากมาก


ทำซ้ำโดยได้รับอนุญาตจาก SIOS

Filed Under: ทำให้เข้าใจง่ายเซิร์ฟเวอร์คลัสเตอร์

  • « Previous Page
  • 1
  • …
  • 73
  • 74
  • 75
  • 76
  • 77
  • …
  • 112
  • Next Page »

โพสต์ล่าสุด

  • ระบบความพร้อมใช้งานสูง (High Availability หรือ HA) คืออะไร?
  • เอาตัวรอดจากวิกฤตการณ์วันศุกร์: จากระบบคอมพิวเตอร์แบบดิบๆ สู่การจำลองข้อมูลที่ราบรื่น
  • ติดดิน: สิ่งที่การพลาดชม Percona Live Amsterdam สอนฉันเกี่ยวกับ HA
  • เปรียบเทียบ SIOS LifeKeeper กับ Red Hat High Availability Add-On:
  • สถานะของความยืดหยุ่นของแอปพลิเคชัน: ผลสำรวจความพร้อมใช้งานสูงของ SIOS ปี 2026

กระทู้ยอดนิยม

เข้าร่วมรายชื่อผู้รับจดหมายของเรา

Copyright © 2026 · Enterprise Pro Theme on Genesis Framework · WordPress · Log in