MS SQL Server V.Next บน Linux พร้อมการจำลองแบบและความพร้อมใช้งานสูง
Microsoft เปิดตัวพรีวิวแรกของ MS SQL Server ที่ทำงานบน Linux ฉันสงสัยว่าพวกเขาจะทำอะไรเพื่อความพร้อมสูง รู้ว่า AlwaysOn Availability Groups และ Clustering Failover Clustering มีความแน่นแฟ้นอยู่ในระบบปฏิบัติการ Windows ฉันมั่นใจว่าจะไม่สามารถเลือกได้ ฉันถูกต้อง – คลัสเตอร์ Failover ว่างสูงสำหรับ MS SQL Server v.Next บน Linux ดีคนที่ผ่าน LinuxClustering.Net ตอบคำถามของฉันเกี่ยวกับวิธีการให้ failover สูงว่าง clusters สำหรับ MS SQL Server v.Next บน Linux กับบทความทีละขั้นตอนนี้ดี http://www.linuxclustering.net/2016/11/18/step-by-step-sql-server-v-next-for-linux-public-preview-high-availability-azure/ ไม่เพียง แต่ที่พวกเขาทำ มันทั้งหมดใน Azure ที่เรารู้ว่าอาจจะยุ่งยากให้บางส่วนของข้อ จำกัด ของเครือข่าย  ฉันต้องการจะรู้ว่าคุณรู้สึกตื่นเต้นเกี่ยวกับการมีคลัสเตอร์ failover สูงว่างสำหรับ MS SQL Server v.Next บน Linux หรือถ้าคุณคิดว่าเป็นการทดลองวิทยาศาสตร์เพียงเล็กน้อย สำหรับคนตื่นเต้นสิ่งที่ไม่ SQL Server บน Linux นำมาสู่ตารางที่ฐานข้อมูลมาเปิดไม่ได้? ตั้งแต่คุณชอบ SQL Server ที่มากทำไมไม่เพียง แต่ทำงานบน Windows? ฉันไม่ได้เป็นคนที่นี่ ฉันสุจริตต้องการทราบว่าคุณตื่นเต้นอะไรเกี่ยวกับ SQL Server บน Linux ฉันกำลังรอความคิดเห็นของคุณ ทำซ้ำโดยได้รับอนุญาตจาก Clusteringformeremortals.com
 โปรดจำไว้ว่าการดำเนินการนี้จะเป็นการปิดอินสแตนซ์ หากคุณมีพื้นที่เก็บข้อมูลระดับพรีเมี่ยมที่เชื่อมต่ออยู่คุณจะยังคงจ่ายเงินสำหรับพื้นที่จัดเก็บข้อมูลต่อไปแม้ว่าอินสแตนซ์จะถูกปิดระบบ
 รูปที่ 3 – ตรวจสอบให้แน่ใจว่าได้เพิ่มโหนดคลัสเตอร์ทั้งสองและพยานในการแชร์ไฟล์ไปยังชุดข้อมูลความพร้อมกัน
 รูปที่ 4 – ตรวจสอบให้แน่ใจว่าแต่ละโหนดคลัสเตอร์ใช้ IP แบบสแตติก
 รูปที่ 5 – ตรวจสอบให้แน่ใจว่าได้เพิ่มพื้นที่เก็บข้อมูลเพิ่มเติมสำหรับแต่ละโหนดคลัสเตอร์
 รูปที่ 6 – เปิดใช้งานทั้ง. Net Framework 3.5 และ Failover Clustering และ File Server บนโหนดคลัสเตอร์ทั้งสองเมื่อบทบาทและคุณลักษณะเหล่านั้นได้รับการเปิดใช้งานคุณพร้อมที่จะสร้างคลัสเตอร์แล้ว ขั้นตอนส่วนใหญ่ที่ฉันกำลังจะแสดงให้คุณสามารถทำได้ทั้งผ่านทาง PowerShell และ GUI อย่างไรก็ตามผมจะแนะนำว่าสำหรับขั้นตอนแรกนี้คุณใช้ PowerShell เพื่อสร้างคลัสเตอร์ของคุณ ถ้าคุณเลือกที่จะใช้ Failover Cluster Manager GUI เพื่อสร้างคลัสเตอร์คุณจะพบว่าคุณได้รับการแก้ไขด้วยคลัสเตอร์ที่กำลังออกที่อยู่ IP ซ้ำ
 รูปที่ 7 – ผลลัพธ์ของการสร้างคลัสเตอร์และคำสั่งตรวจสอบคลัสเตอร์
 รูปที่ 8 – ติดตั้ง DataKeeper หลังจากคลัสเตอร์ถูกสร้างขึ้นระหว่างการติดตั้งคุณสามารถใช้ตัวเลือกเริ่มต้นทั้งหมด บัญชีบริการที่คุณใช้ต้องเป็นบัญชีโดเมนและอยู่ในกลุ่มผู้ดูแลระบบภายในของแต่ละโหนดในคลัสเตอร์
 รูปที่ 9 – บัญชีบริการต้องเป็นบัญชีโดเมนที่อยู่ในกลุ่ม Local Admins ในแต่ละโหนดเมื่อ DataKeeper ได้รับการติดตั้งและได้รับสิทธิการใช้งานบนแต่ละโหนดคุณจะต้องบูตเครื่องใหม่
 เชื่อมต่อกับ SQL
 1 เชื่อมต่อกับ SQ
 L2 เมื่อคุณเชื่อมต่อกับเซิร์ฟเวอร์แต่ละเครื่องคุณพร้อมที่จะสร้าง DataKeeper Volume แล้ว คลิกขวาที่งานและเลือก "สร้างง
 าน" ให้ชื่องานและคำอธิบาย
 เลือกเซิร์ฟเวอร์ต้นทาง IP และไดรฟ์ข้อมูล ที่อยู่ IP คือการรับส่งข้อมูลการจำลองแบบจะเดินทางหรือไม่
 เลือกเซิร์ฟเวอร์เป้าหมายของคุณ
 เลือกตัวเลือกของคุณ สำหรับจุดประสงค์ของเราที่ VM ทั้งสองอยู่ในพื้นที่ทางภูมิศาสตร์เดียวกันเราจะเลือกการจำลองแบบซิงโครนัส สำหรับการจำลองแบบระยะไกลคุณจะต้องการใช้แบบอะซิงโครนัสและเปิดใช้งานการบีบอัดบางอย่าง
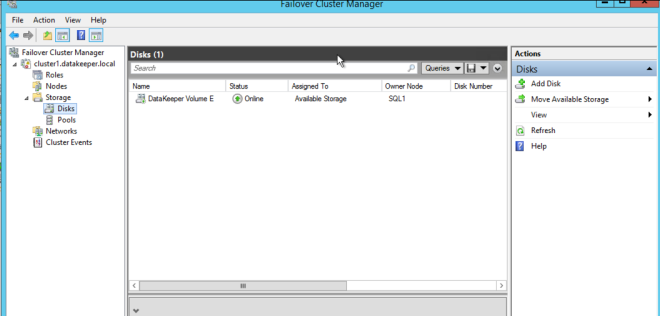
 เมื่อคลิกใช่ที่ป๊อปอัปล่าสุดคุณจะลงทะเบียนแหล่งข้อมูลไดรฟ์ DataKeeper ใหม่ในที่จัดเก็บที่พร้อมใช้งานใน Failover Clustering คุณจะเห็นแหล่งข้อมูล Volume DataKeeper ใหม่ใน Storage ที่มีอยู่
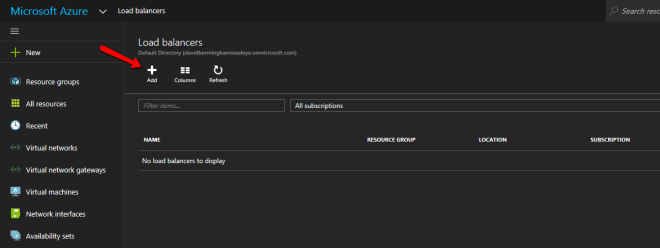 ่คุณสามารถใช้ Public Balancer โหลดถ้าไคลเอ็นต์ของคุณเชื่อมต่อผ่านทางอินเทอร์เน็ตสาธารณะ แต่สมมติว่าลูกค้าของคุณอาศัยอยู่ใน vNet เดียวกันเราจะสร้าง Internal Balancer โหลด สิ่งสำคัญที่ต้องจดบันทึกไว้ในที่นี้ก็คือ Virtual Network จะเหมือนกับเครือข่ายที่โหนดคลัสเตอร์ของคุณอาศัยอยู่ นอกจากนี้ที่อยู่ IP ส่วนตัวที่คุณระบุจะเหมือนกับที่อยู่ที่คุณใช้ในการสร้างทรัพยากรคลัสเตอร์ SQL
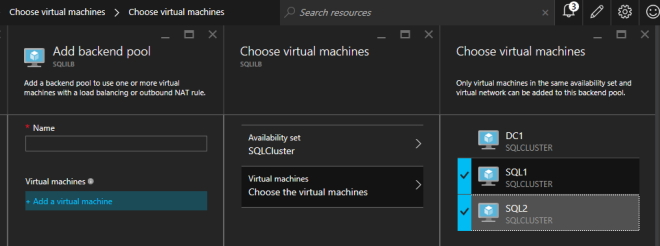
 หลังจากสร้าง Internal Load Balancer (ILB) แล้วคุณจะต้องแก้ไขไฟล์ สิ่งแรกที่เราจะทำคือการเพิ่มแบ็กเอนด์พูล ในขั้นตอนนี้คุณจะเลือกชุดความพร้อมใช้งานที่เครื่องเซิร์ฟเวอร์คลัสเตอร์ของ SQL อยู่ อย่างไรก็ตามเมื่อคุณเลือก VM ที่แท้จริงเพื่อเพิ่มลงในแบ็กเอนด์พูลให้แน่ใจว่าคุณไม่ได้เลือกพยานร่วมกันในการแชร์ไฟล์ของคุณ เราไม่ต้องการเปลี่ยนเส้นทางการรับส่งข้อมูล SQL ไปยังพยานที่แชร์ไฟล์ของคุณ
 สิ่งต่อไปที่เราจะทำคือเพิ่ม Probe การสอบสวนที่เราเพิ่มจะโพรบ Port 59999 โพรบนี้จะกำหนดโหนดที่ใช้งานอยู่ในคลัสเตอร์ของเรา
 จากนั้นเราจำเป็นต้องใช้กฎการกระจายการโหลดเพื่อเปลี่ยนเส้นทางการรับส่งข้อมูล SMB พอร์ต TCP 445 สิ่งสำคัญที่ควรสังเกตในภาพหน้าจอด้านล่างคือการเปิดใช้งานการส่งคืนเซิร์ฟเวอร์โดยตรง ตรวจสอบให้แน่ใจว่าคุณได้ทำการเปลี่ยนแปลงนั้น

 ารสนับสนุน DTC ของ SQL Server 2016 ในกลุ่มความพร้อมใช้งาน [/ caption] การสนับสนุน SQL Server 2016 สำหรับธุรกรรมแบบกระจายจะได้รับการสนับสนุนเฉพาะในกรณีที่ทำธุรกรรมเท่านั้น มีการแจกจ่ายผ่านอินสแตนซ์ต่างๆของ SQL Server ไม่ได้รับการสนับสนุนหากมีการแจกจ่ายธุรกรรมระหว่างฐานข้อมูลต่างๆภายในอินสแตนซ์เดียวกันของ SQL Server ดังนั้นในภาพด้านบนถ้าฐานข้อมูลอยู่ในอินสแตนซ์ SQL แบบแยกกันจะทำงานได้ แต่ถ้าฐานข้อมูลไม่อยู่ในอินสแตนซ์เดียวกันซึ่งมีโอกาสมากกว่า ถ้าคุณต้องการการสนับสนุนธุรกรรมแบบกระจายระหว่างฐานข้อมูลต่าง ๆ ภายในอินสแตนซ์เดียวกันของ SQL Server และคุณต้องการความพร้อมใช้งานสูงคุณยังคงต้องใช้ SQL Server Alway