SIOS SANless clusters

SIOS SANless clusters High-availability Machine Learning monitoring

  • Home
  • Products
    • SIOS DataKeeper for Windows
    • SIOS Protection Suite for Linux
  • การทดสอบอาหารสัตว์
  • ข่าวสารและกิจกรรม
  • ทำให้เข้าใจง่ายเซิร์ฟเวอร์คลัสเตอร์
  • เรื่องราวความสำเร็จ
  • ติดต่อเรา
  • English
  • 中文 (中国)
  • 中文 (台灣)
  • 한국어
  • Bahasa Indonesia
  • ไทย

แพลตฟอร์มสื่อชั้นนำปกป้อง SAP S/4 HANA ที่สำคัญใน AWS EC2 Cloud

พฤษภาคม 5, 2022 by Jason Aw Leave a Comment

แพลตฟอร์มสื่อชั้นนำปกป้อง SAP S/4 HANA ที่สำคัญใน AWS EC2 Cloud

แพลตฟอร์มสื่อชั้นนำปกป้อง SAP S/4 HANA ที่สำคัญใน AWS EC2 Cloud

เลือก SIOS ตามการรับรองและการตรวจสอบสำหรับ SAP, Amazon Web Services และ Red Hat Linux

องค์กรสื่อชั้นนำแห่งนี้เข้าถึงผู้ใหญ่แทบทุกคนในสิงคโปร์ทุกสัปดาห์ ผ่านแพลตฟอร์มสื่อที่หลากหลายที่สุดในประเทศ ทั้งสื่อดิจิทัล โทรทัศน์ วิทยุ สิ่งพิมพ์และสื่อนอกบ้าน รวมถึงผลิตภัณฑ์และแบรนด์มากกว่า 50 รายการในสี่ภาษา (อังกฤษ จีนกลาง มาเลย์ และทมิฬ)

สิ่งแวดล้อม

บริษัทใช้ an แอปพลิเคชัน SAP S/4 HANA และ ฐานข้อมูล HANA เพื่อขับเคลื่อนการดำเนินงานทั่วทั้งองค์กร การรวมการดำเนินงานในหลายแผนก พวกเขากำลังเรียกใช้แอปพลิเคชันและฐานข้อมูลที่สำคัญเหล่านี้ในสภาพแวดล้อม Red Hat Linux ในศูนย์ข้อมูลภายในองค์กร การปกป้องระบบที่จำเป็นเหล่านี้จากการหยุดทำงานและภัยพิบัติเป็นสิ่งสำคัญที่สุดสำหรับทีมไอทีขององค์กรนี้

ความท้าทาย

ทีมไอทีขององค์กรสื่อตระหนักดีว่าสามารถประหยัดต้นทุนได้อย่างมากด้วยการย้ายแอปพลิเคชัน SAP และฐานข้อมูล HANA ไปยังคลาวด์ AWS EC2 อย่างไรก็ตาม เพื่อให้การย้ายข้อมูลประสบความสำเร็จ พวกเขาต้องการโซลูชันที่มีความพร้อมใช้งานสูง (HA) และการกู้คืนความเสียหาย (DR) ที่จะ "ยกระดับและเปลี่ยน" ด้วยภูมิทัศน์ SAP ที่มีอยู่ไปยัง AWS โดยไม่หยุดชะงัก

การประเมินผล

ทีมไอทีของบริษัทต้องการโซลูชัน HA/ DR ที่พวกเขาวางใจได้เพื่อให้เป็นไปตาม SLA ความพร้อมใช้งาน 99.99% ในระบบคลาวด์ โซลูชันจำเป็นต้องได้รับการรับรองจากทั้ง SAP และ AWS และรองรับระบบปฏิบัติการ Red Hat Linux สุดท้ายนี้ เพื่อให้แน่ใจว่าพวกเขาสามารถส่งมอบการป้องกัน DR เต็มรูปแบบสำหรับปริมาณงานที่สำคัญเหล่านี้ พวกเขาต้องการโซลูชันการทำคลัสเตอร์ที่จะเฟลโอเวอร์ข้ามโซนความพร้อมใช้งานของ AWS (AZ) หลายโซน สถาปนิกโซลูชันของ AWS แนะนำให้องค์กรใช้ซอฟต์แวร์การทำคลัสเตอร์ SIOS LifeKeeper สำหรับ Linux ทีมไอทีของบริษัทมีระยะเวลาสั้นๆ ในการดำเนินการโครงการให้เสร็จสิ้น และจำเป็นต้องเลือกผู้ขาย HA ที่สามารถตอบสนองความต้องการได้โดยไม่ขัดขวางความก้าวหน้า

การแก้ไขปัญหา

พวกเขาเลือก SIOS LifeKeeper เพราะไม่เพียงตรงตามเกณฑ์ทั้งหมดของเรา แต่ยังเป็นเพราะทีม SIOS ได้รับการจัดระเบียบอย่างรวดเร็ว ทำให้พวกเขาสามารถรักษาโครงการย้ายข้อมูลบนระบบคลาวด์ได้ตามกำหนดเวลา SIOS Lifekeeper ได้รับการรับรองจากทั้ง AWS และ SAP สำหรับความพร้อมใช้งานสูงบนสภาพแวดล้อมระบบคลาวด์ของ Red Hat และ AWS EC2 โซลูชัน SIOS ยังตรงตามเกณฑ์สำคัญอีกประการหนึ่ง เนื่องจากสามารถทำซ้ำและให้ความซ้ำซ้อนในโซนความพร้อมใช้งานของ AWS ทีมไอทีขององค์กรรู้สึกประทับใจกับทีมสนับสนุนในพื้นที่เฉพาะของ SIOS ที่พร้อมตอบคำถามและให้การสนับสนุนตลอด 24 ชั่วโมง 7 วัน สัปดาห์. ปัจจุบันองค์กรมีคลัสเตอร์ล้มเหลวห้าคู่ที่ใช้ SIOS LifeKeeper สำหรับ Linux เพื่อปกป้องแอปพลิเคชัน S/4 HANA และ SAP HANA ที่ทำงานข้ามโซนความพร้อมใช้งานหลายโซนใน AWS EC2

ผลลัพธ์

ความพร้อมใช้งานมีความน่าเชื่อถือ เราไม่มีเวลาหยุดทำงานนานขึ้นตั้งแต่ใช้ซอฟต์แวร์ ด้วยการทำให้ลูกค้ารายนี้สามารถโยกย้ายปริมาณงานที่สำคัญเหล่านี้ไปยังคลาวด์โดยไม่ลดทอน HA/DR หรือประสิทธิภาพของแอปพลิเคชัน SIOS ช่วยให้เราสามารถประหยัดต้นทุนได้อย่างมาก" เขากล่าว Mediacorp ที่ใช้งานง่ายของ SIOS LifeKeeper ช่วยประหยัดยิ่งขึ้นด้วยการลดเวลาผู้ดูแลระบบไอที

ทำซ้ำโดยได้รับอนุญาตจาก SIOS
Filed Under: ทำให้เข้าใจง่ายเซิร์ฟเวอร์คลัสเตอร์

ปกป้องระบบจากการหยุดทำงาน

พฤษภาคม 1, 2022 by Jason Aw Leave a Comment

ปกป้องระบบจากการหยุดทำงาน

ในสภาพแวดล้อมทางธุรกิจในปัจจุบัน องค์กรต่างพึ่งพาแอพพลิเคชั่น ฐานข้อมูล และระบบ ERP เช่น SAP, SQL Server, Oracle และอื่นๆ แอปพลิเคชันเหล่านี้รวมกันและทำให้การดำเนินธุรกิจที่สำคัญที่สุดของคุณคล่องตัวขึ้น เมื่อพวกเขาล้มเหลว จะทำให้คุณเสียค่าใช้จ่ายมากกว่าแค่เงิน การปกป้องระบบที่ซับซ้อนเหล่านี้จากการหยุดทำงานเป็นสิ่งสำคัญ

พิสูจน์ความพร้อมใช้งานและการกู้คืนจากภัยพิบัติ

SIOS มีประสบการณ์มากกว่า 20 ปีใน ความพร้อมใช้งานสูง และ การกู้คืนระบบ .SIOS ทราบดีว่าไม่มีโซลูชันใดที่เหมาะกับโซลูชันทั้งหมด ระบบข้อมูลในปัจจุบันเป็นการผสมผสานระหว่างสภาพแวดล้อมในองค์กร คลาวด์สาธารณะ ไฮบริดคลาวด์ และมัลติคลาวด์ แอปพลิเคชันเองสามารถสร้างความซับซ้อนได้มากขึ้น แต่การกำหนดค่าซอฟต์แวร์คลัสเตอร์โอเพนซอร์สอาจต้องใช้ความอุตสาหะ ใช้เวลานาน และมีแนวโน้มที่จะเกิดข้อผิดพลาดจากมนุษย์

SIOS มีโซลูชันที่ให้ความพร้อมใช้งานสูงและการกู้คืนจากความเสียหายสำหรับแอปพลิเคชันที่สำคัญ โซลูชันเหล่านี้ได้รับการพัฒนาจากประสบการณ์จริงของเรา ในอุตสาหกรรมและกรณีการใช้งานต่างๆ สินค้าของเราได้แก่ SIOS DataKeeper Cluster Edition สำหรับ Windows และ SIOS LifeKeeper สำหรับ Linux หรือวินโดวส์ แอปพลิเคชันอันทรงพลังเหล่านี้ให้การป้องกันเมื่อเกิดข้อผิดพลาด Application Recovery Kits ที่มาพร้อมกับ LifeKeeper ช่วยเร่งเวลาการกำหนดค่าแอปพลิเคชันด้วยการกำหนดค่าอัตโนมัติและตรวจสอบอินพุต

การปกป้องระบบภายในองค์กร ในระบบคลาวด์หรือในสภาพแวดล้อมแบบไฮบริด

SIOS ให้การปกป้องที่คุณต้องการสำหรับแอปพลิเคชันที่มีความสำคัญต่อธุรกิจ และลดความซับซ้อนในการจัดการแอปพลิเคชัน ไม่ว่าจะเป็นแบบภายในองค์กร ในระบบคลาวด์ หรือในสภาพแวดล้อมแบบไฮบริดคลาวด์ เรียนรู้เพิ่มเติมเกี่ยวกับเราในวิดีโอด้านล่างหรือ ติดต่อเรา เพื่อเรียนรู้เพิ่มเติมเกี่ยวกับความพร้อมใช้งานสูงและการกู้คืนความเสียหายสำหรับแอปพลิเคชันที่สำคัญต่อธุรกิจของคุณ

ทำซ้ำโดยได้รับอนุญาตจาก SIOS

Filed Under: ทำให้เข้าใจง่ายเซิร์ฟเวอร์คลัสเตอร์

วิธีบรรลุความพร้อมใช้งานสูงในระบบคลาวด์โดยใช้ WSFC

เมษายน 29, 2022 by Jason Aw Leave a Comment

วิธีบรรลุความพร้อมใช้งานสูงในระบบคลาวด์โดยใช้ WSFC

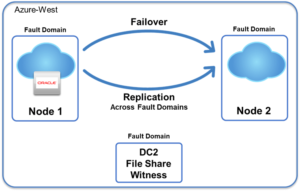
รูปที่ 1: Failover Cluster สำหรับความพร้อมใช้งานสูงใน Azure

Microsoft Windows Server มีซอฟต์แวร์ Windows Server Failover Clustering (WSFC) เพื่อให้แน่ใจว่ามีแอปพลิเคชันที่สำคัญพร้อมใช้งาน ในสภาพแวดล้อมภายในองค์กร โหนดหลักและโหนดสแตนด์บายในคลัสเตอร์จะเชื่อมต่อกับที่เก็บข้อมูลที่ใช้ร่วมกันเดียวกัน อย่างไรก็ตาม โครงสร้างพื้นฐานนี้ไม่สามารถนำไปใช้กับระบบคลาวด์ได้โดยตรง พื้นที่เก็บข้อมูลที่ใช้ร่วมกันซึ่งครอบคลุมทั้งระบบหลักและระบบสแตนด์บายเป็นสิ่งจำเป็นใน WSFC แต่ที่เก็บข้อมูลที่ใช้ร่วมกันไม่สามารถใช้กับบริการคลาวด์สาธารณะเช่น IaaS (โครงสร้างพื้นฐานเป็นบริการ) ใน AWS, Azure หรือ Google Cloud

พื้นที่เก็บข้อมูลที่ใช้ร่วมกันแยกตามพื้นที่ สำหรับ WSFC ไม่พร้อมใช้งานในระบบคลาวด์

เมื่อย้ายแอปพลิเคชันภายในองค์กรไปยังระบบคลาวด์ บริษัทต้องการย้ายโครงสร้างพื้นฐานทั้งหมดไปยังระบบคลาวด์ ซึ่งรวมถึง WSFC โดยไม่ต้องเปลี่ยนกระบวนการดำเนินการภายในองค์กร สิ่งนี้ช่วยให้พวกเขาลดการหยุดชะงักโดยการใช้ทักษะ WSFC เดียวกันและความรู้ในระบบคลาวด์

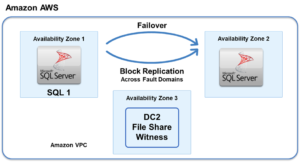
รูปที่ 2: การทำคลัสเตอร์ล้มเหลวใน AWS EC2 โหนดคลัสเตอร์อยู่ใน Availability Zone ที่แยกตามภูมิศาสตร์สำหรับการป้องกัน DR

เซิร์ฟเวอร์ที่ประกอบเป็นคลัสเตอร์จะแบ่งออกเป็นโหนดหลัก – ที่แอปพลิเคชันทำงาน – และโหนดสแตนด์บาย ซอฟต์แวร์ WSFC ตรวจสอบแอปพลิเคชันและโหนดเซิร์ฟเวอร์เพื่อให้แน่ใจว่าทำงานได้ หาก WSFC ตรวจพบสิ่งผิดปกติกับโหนดหลัก มันจะสลับการทำงานของแอปพลิเคชันเป็นโหนดสแตนด์บายในกระบวนการที่เรียกว่า "เฟลโอเวอร์"

ในสภาพแวดล้อม WSFC เซิร์ฟเวอร์หลักและเซิร์ฟเวอร์สแตนด์บายจะเชื่อมต่อกับที่เก็บข้อมูลที่ใช้ร่วมกัน – โดยทั่วไปแล้วที่เก็บข้อมูลเรียกว่า SAN (Storage Area Network) หรือที่เก็บข้อมูล iSCSI-SAN

ในการดำเนินการเฟลโอเวอร์จากเซิร์ฟเวอร์หลักไปยังเซิร์ฟเวอร์สแตนด์บาย ลิงก์เครือข่ายต้องถูกสลับเพื่อให้เซิร์ฟเวอร์สแตนด์บายสามารถอ่านและเขียนไปยัง SAN ที่ปกติแล้วจะอ่านและเขียนจากเซิร์ฟเวอร์หลัก ด้วยวิธีนี้ จะสามารถเริ่มบริการใหม่ได้ในเวลาอันสั้น ทำให้เซิร์ฟเวอร์สแตนด์บายสามารถเข้าถึงข้อมูลเดียวกันกับโหนดหลักและตรงตามวัตถุประสงค์ของจุดกู้คืน (RPO) ที่ต่ำ

ดูเนื้อหาที่เกี่ยวข้อง: พื้นฐานการกู้คืนจากภัยพิบัติ .

อย่างไรก็ตาม เมื่อย้าย WSFC ไปยังระบบคลาวด์ จะไม่มี SAN ให้ใช้งาน ตัวอย่างเช่น คุณไม่สามารถเชื่อมโยง Amazon Web Services (AWS) และ Microsoft Azure กับหลายโหนด (เซิร์ฟเวอร์) เพื่อใช้เป็นที่เก็บข้อมูลที่ใช้ร่วมกันได้ เช่นเดียวกับ IaaS สำหรับบริการคลาวด์อื่นๆ

เป็นไปได้ที่จะสร้างการกำหนดค่าคลัสเตอร์ HA ตาม WSFC โดยไม่ต้องใช้ที่เก็บข้อมูลที่ใช้ร่วมกัน แต่ต้องใช้ทักษะขั้นสูงอย่างมาก เช่น การสร้างโปรแกรมของคุณเองเพื่อกู้คืนข้อมูลบนโหนดสแตนด์บาย การดำเนินการมีความซับซ้อนและไม่ง่ายที่จะตรวจสอบเมื่อมีเหตุการณ์เกิดขึ้น

ซอฟต์แวร์การจำลองข้อมูลช่วยแก้ปัญหา

ในการแก้ไขปัญหานี้ คุณสามารถติดตั้ง การจำลองข้อมูล ซอฟต์แวร์ที่เชี่ยวชาญสำหรับคลัสเตอร์ HA เช่น SIOS DataKeeper Cluster Edition และซิงโครไนซ์ที่เก็บข้อมูลระหว่างเซิร์ฟเวอร์ภายในเครื่อง ข้อมูลบนดิสก์ในเครื่องของโหนดหลักและโหนดสแตนด์บายจะซิงโครไนซ์แบบเรียลไทม์โดยใช้การจำลองแบบระดับบล็อกตามโฮสต์ ด้วยวิธีนี้ คุณไม่จำเป็นต้องมีที่เก็บข้อมูลที่ใช้ร่วมกัน คุณสามารถสร้างการกำหนดค่าคลัสเตอร์ HA ได้โดยใช้ WSFC ที่คุ้นเคย โดยไม่กระทบต่อกระบวนการที่สร้างไว้

ด้วย DataKeeper โหนดที่ซิงโครไนซ์จะปรากฏเป็น SAN ในหน้าจอการจัดการ WSFC (การจัดการคลัสเตอร์ล้มเหลว) หากผู้จัดการฝ่ายปฏิบัติการของคุณใช้ WSFC พวกเขาจะไม่ต้องการการฝึกอบรมเพียงเล็กน้อยหรือไม่มีเลยกับแนวทางนี้

ความพร้อมใช้งานสูงในระบบคลาวด์เหนือกว่าในองค์กร HA ด้วย SIOS DataKeeper และ WSFC

DataKeeper Cluster Edition เป็นซอฟต์แวร์เสริมที่ผสานรวมกับ Windows Server Failover Clustering (WSFC) ได้อย่างราบรื่นเพื่อเพิ่มการจำลองแบบซิงโครนัสหรืออะซิงโครนัสตามโฮสต์ที่เพิ่มประสิทธิภาพ ในกรณีที่ไม่น่าเป็นไปได้ที่คลัสเตอร์ HA ทำงานผิดปกติ WSFC จะจัดการการเฟลโอเวอร์ของการดำเนินการไปยังโหนดสแตนด์บาย และเข้าถึงที่เก็บข้อมูลที่ใช้ร่วมกันเสมือนว่าเป็นที่เก็บข้อมูลที่ใช้ร่วมกัน กลไกง่ายๆ นี้ทำให้สามารถย้ายไปยัง AWS ได้โดยไม่ต้องเปลี่ยนการทำงานของระบบที่มีอยู่

โดยไม่กระทบต่อการทำงานของ WSFC ที่คุ้นเคย เป็นไปได้ที่จะรับประกันความพร้อมใช้งานสูงในระบบคลาวด์โดยใช้ DataKeeper ที่เทียบเท่าหรือดีกว่าในองค์กร ความพร้อมใช้งานสูง . ข้อดีของการกำหนดค่าคลัสเตอร์นี้คือง่ายมากและสามารถนำไปใช้กับสภาพแวดล้อมระบบคลาวด์ใดๆ ได้อย่างง่ายดาย

บูรณาการอย่างราบรื่นกับ WSFC

SIOS DataKeeper Cluster Edition ผสานรวมและขยาย Windows Server Failover Clustering (WSFC) ได้อย่างราบรื่นโดยมอบกลไกการจำลองข้อมูลตามโฮสต์ที่เพิ่มประสิทธิภาพการทำงาน ในขณะที่ WSFC จัดการคลัสเตอร์ซอฟต์แวร์ SIOS จะทำการจำลองข้อมูลเพื่อเปิดใช้งานการป้องกันจากภัยพิบัติ และทำให้แน่ใจว่าข้อมูลสูญหายเป็นศูนย์ ในกรณีที่คลัสเตอร์การจัดเก็บข้อมูลที่ใช้ร่วมกันเป็นไปไม่ได้หรือทำไม่ได้ เช่น ในสภาพแวดล้อมการจัดเก็บข้อมูลบนคลาวด์ ระบบเสมือน และประสิทธิภาพสูง

ทำซ้ำโดยได้รับอนุญาตจาก SIOS

Filed Under: ทำให้เข้าใจง่ายเซิร์ฟเวอร์คลัสเตอร์

วิธีที่ดีที่สุดวิธีเดียวในการปรับใช้องค์ประชุม/พยาน

เมษายน 26, 2022 by Jason Aw Leave a Comment

วิธีที่ดีที่สุดวิธีเดียวในการปรับใช้องค์ประชุม/พยาน

วิธีที่ดีที่สุดวิธีเดียวในการปรับใช้องค์ประชุม/พยาน

ระหว่างการประชุมครั้งล่าสุด ลูกค้าถามคำถามเกี่ยวกับความพร้อมใช้งานสูง (HA) และความจำเป็นในองค์ประชุม/ความเป็นไปได้ในการเป็นพยาน คำถามของพวกเขาคือ "วิธีที่ดีที่สุดในการปรับใช้องค์ประชุม/พยานคืออะไร" คำตอบสำหรับคำถามนั้นง่าย ไม่มีวิธีที่ดีที่สุดวิธีเดียวในการปรับใช้โควรัมเพื่อให้เข้าใจถึงสาเหตุ ให้เริ่มต้นด้วยการกำหนดสิ่งสำคัญสามประการ: ทรัพยากรพยานคืออะไร ทรัพยากรองค์ประชุม และสถานการณ์สมองแตก

สมองแตกคืออะไร?

ในสภาพแวดล้อมคลัสเตอร์ปกติ แอปพลิเคชันที่ได้รับการป้องกันกำลังทำงานบนโหนดหลักในคลัสเตอร์ในกรณีที่แอปพลิเคชันของโหนดหลักนั้นล้มเหลว ซอฟต์แวร์การทำคลัสเตอร์จะย้ายการทำงานของแอปพลิเคชันไปยังโหนดรองหรือโหนดระยะไกล ซึ่งจะถือว่ามีบทบาทหลัก ในเวลาใดก็ตาม มีโหนดหลักเพียงโหนดเดียว
Split brain เป็นภาวะที่เกิดขึ้นเมื่อสมาชิกของคลัสเตอร์ไม่สามารถสื่อสารกันได้ แต่อยู่ในสถานะทำงานและทำงานได้ และต่อมาจะเข้าเป็นเจ้าของทรัพยากรร่วมกันพร้อมกัน ผลก็คือ คุณมีคนขับรถบัสสองคนต่อสู้กันเพื่อชิงพวงมาลัยSplit-brain เนื่องจากลักษณะการทำลายล้าง อาจทำให้ข้อมูลสูญหายหรือเสียหายของข้อมูล และควรหลีกเลี่ยงผ่านการใช้ฟันดาบ องค์ประชุม พยาน หรือองค์ประชุม/ฟังก์ชั่นพยานสำหรับการอนุญาโตตุลาการคลัสเตอร์

ในตัวจัดการคลัสเตอร์ส่วนใหญ่ องค์ประชุมจะยังคงอยู่เมื่อ:

  1. เซิร์ฟเวอร์ทั้งหมดสามารถเห็นสถานะเดียวกันสำหรับคลัสเตอร์เพียร์ทั้งหมดและพยาน
  2. เซิร์ฟเวอร์ทั้งหมดสามารถเห็นสถานะเดียวกันสำหรับคลัสเตอร์เพียร์ทั้งหมด แม้ว่าจะไม่ใช่พยานก็ตาม
  3. เซิร์ฟเวอร์ทั้งหมดสามารถเห็นทรัพยากรที่เป็นพยาน แม้ว่าจะไม่เห็นกันและกัน และหลีกเลี่ยงสถานการณ์ที่สมองแตกได้

ในตัวจัดการคลัสเตอร์ส่วนใหญ่ องค์ประชุมจะหายไปเมื่อ:

  1. เซิร์ฟเวอร์ไม่สามารถดูคลัสเตอร์เพียร์ทั้งหมดและเซิร์ฟเวอร์ที่เป็นพยานได้
  2. เซิร์ฟเวอร์ไม่สามารถเห็นกลุ่มเพียร์ของคลัสเตอร์ส่วนใหญ่ แม้ว่าจะสามารถเห็นเซิร์ฟเวอร์ที่เป็นพยานได้ก็ตาม
  3. เซิร์ฟเวอร์ไม่สามารถเข้าถึงหรือรักษาการเข้าถึงทรัพยากรควอรัมเพื่อตัดสินความเป็นสมาชิกควอรัมและการเข้าถึงทรัพยากรได้สำเร็จ

ทรัพยากรพยาน (หรือเซิร์ฟเวอร์) คืออะไร?

ทรัพยากรพยานคือเซิร์ฟเวอร์ ปลายทางของเครือข่าย หรืออุปกรณ์ที่ใช้เพื่อให้บรรลุและรักษาองค์ประชุมเมื่อคลัสเตอร์มีจำนวนสมาชิกเป็นคู่คลัสเตอร์ที่มีสมาชิกเป็นจำนวนคี่ โดยใช้คลัสเตอร์ส่วนใหญ่ ไม่จำเป็นต้องใช้ทรัพยากรพยานในฐานะสมาชิกทั้งหมดของเซิร์ฟเวอร์คลัสเตอร์เพื่อตัดสินการเป็นสมาชิกส่วนใหญ่

องค์ประชุมและทรัพยากรองค์ประชุมคืออะไร?

ทรัพยากรควอรัมคือทรัพยากร (อุปกรณ์ ระบบ ที่เก็บข้อมูลบล็อก ที่จัดเก็บไฟล์ การแชร์ไฟล์ ฯลฯ) ที่ทำหน้าที่เป็นวิธีการตัดสินชี้ขาดของสถานะคลัสเตอร์และการเป็นสมาชิกในตัวจัดการคลัสเตอร์บางตัว ควอรัมเป็นทรัพยากรภายในคลัสเตอร์ที่ช่วยหรือจำเป็นสำหรับสถานะคลัสเตอร์และการตัดสินใจเป็นสมาชิกของคลัสเตอร์ในตัวจัดการคลัสเตอร์อื่นๆ ควอรัมทำหน้าที่เป็นตัวแบ่งส่วนข้อมูลเพื่อหลีกเลี่ยงการแบ่งสมอง

มากกว่าหนึ่งวิธีในการปรับใช้โควรัม

ด้วยลักษณะสำคัญขององค์ประชุม จึงจำเป็นที่สถาปัตยกรรม HA จะปรับใช้ทรัพยากรองค์ประชุม/พยานอย่างเหมาะสม และโชคดี (หรือน่าเสียดาย) ไม่มีโสด วิธีที่ดีที่สุดในการปรับใช้องค์ประชุมมีปัจจัยหลายประการที่อาจกำหนดแนวทางปฏิบัติในการเป็นพยานและแหล่งข้อมูลโควรัมของคุณปัจจัยเหล่านี้รวมถึง:

1. การปรับใช้ของคุณจะอยู่ในองค์กร คลาวด์ หรือไฮบริด

การปรับใช้ในศูนย์ข้อมูลภายในองค์กรซึ่งมีอุปกรณ์จัดเก็บข้อมูลเพิ่มเติม เช่น ที่จัดเก็บไฟเบอร์แชนเนล อุปกรณ์ควบคุมพลังงานหรือการเชื่อมต่อ หรืออุปกรณ์สโตนนิธแบบเดิม จะช่วยให้ลูกค้ามีตัวเลือกเพิ่มเติมสำหรับองค์ประชุมและฟังก์ชันการทำงานที่เป็นพยานที่อาจไม่ได้อยู่ในคลาวด์ในทำนองเดียวกัน สภาพแวดล้อมระบบคลาวด์และไฮบริดนำเสนอความแตกต่างในสิ่งที่สามารถปรับใช้ได้ และกรณีการใช้งานใดที่โควรัมกำลังถูกปรับใช้เพื่อป้องกัน นอกจากนี้ ข้อกำหนดและความแตกต่างของเวลาในการตอบสนองอาจจำกัดประเภทของอุปกรณ์และทรัพยากรที่พร้อมใช้งานสำหรับการกำหนดค่าองค์ประชุม/การยืนยัน  

2. วัตถุประสงค์ในการกู้คืนของคุณ

วัตถุประสงค์การกู้คืนก็มีความสำคัญเช่นกันเมื่อต้องพิจารณาเมื่อออกแบบและออกแบบโควรัมของคุณและเป็นพยานแหล่งข้อมูลในตัวอย่างสองโหนดคลัสเตอร์ (โหนด A และโหนด B) เมื่อโหนด A ประสบกับการสูญเสียการเชื่อมต่อกับโหนด B ลำดับความสำคัญสูงสุดสำหรับการกู้คืนคืออะไร หากทรัพยากรพยาน/องค์ประชุมอยู่ในเครือข่ายเดียวกันกับโหนด A ซึ่งอาจส่งผลให้โหนด A ยังคงออนไลน์อยู่ แต่ถูกตัดออกจากไคลเอ็นต์ ในขณะที่โหนด B ไม่สามารถประเมินองค์ประชุมและการเข้าครอบครองได้ในทำนองเดียวกัน หากอุปกรณ์โควรัมอาศัยอยู่เฉพาะในภูมิภาค ศูนย์ข้อมูล หรือเครือข่ายที่มีโหนด B การสูญเสียอาจส่งผลให้เกิดการเฟลโอเวอร์ของทรัพยากรไปยังเครือข่ายหรือศูนย์ที่หมดอายุ หรืออยู่ห่างจากโหนดหลักที่ทำงานและการทำงาน

3. ความซ้ำซ้อนของศูนย์ข้อมูลที่มีอยู่ (หรือภูมิภาค) ภายในโครงสร้างพื้นฐานของคุณ

ความซ้ำซ้อนของศูนย์ข้อมูลหรือภูมิภาคยังเป็นปัจจัยสำคัญในโทโพโลยี HA ของคุณด้วยองค์ประชุม/พยาน หากศูนย์ข้อมูลของคุณมีความซ้ำซ้อนเพียงสองระดับ คุณต้องเข้าใจการแลกเปลี่ยนระหว่างตำแหน่งขององค์ประชุม/พยานในศูนย์ข้อมูลเดียวกันกับโหนดคลัสเตอร์หลักหรือสแตนด์บาย หากศูนย์ข้อมูลมีระดับซ้ำซ้อนมากกว่าสองระดับ เช่น โซนความพร้อมใช้งานที่สามหรือการเข้าถึงภูมิภาคที่สอง ตัวเลือกนี้จะให้ความซ้ำซ้อนในระดับที่สูงขึ้นสำหรับคลัสเตอร์

4. ข้อกำหนดการกู้คืนจากภัยพิบัติ

การทำความเข้าใจข้อกำหนดการกู้คืนจากความเสียหายที่แท้จริงของคุณก็เป็นปัจจัยสำคัญในการออกแบบของคุณเช่นกัน หากซอฟต์แวร์ตัวจัดการคลัสเตอร์ของคุณต้องการการเข้าถึงองค์ประชุม/พยานเพื่อกู้คืนจากการหยุดทำงานของศูนย์ข้อมูลทั้งหมด (หรือความล้มเหลวของภูมิภาค) คุณจะต้องเข้าใจผลกระทบนี้ต่อการออกแบบของคุณแพ็คเกจซอฟต์แวร์ที่มีความพร้อมใช้งานสูงจำนวนมากมีเครื่องมือหรือวิธีการสำหรับสถานการณ์นี้ แต่ถ้าซอฟต์แวร์ของคุณไม่มี การออกแบบและการจัดวางองค์ประชุม/พยานอาจจำเป็นต้องปรับให้เข้ากับความเป็นจริงนี้

5. จำนวนสมาชิกภายในคลัสเตอร์ และที่ตั้งของพวกเขา

โดยทั่วไปไม่จำเป็นต้องใช้เซิร์ฟเวอร์องค์ประชุม/พยานเพิ่มเติมเมื่อคลัสเตอร์มีจำนวนโหนดเป็นเลขคี่อย่างไรก็ตาม หากใช้เพียงสองโหนดในคลัสเตอร์หรือปรับใช้โหนด DR ที่ไม่พร้อมใช้งานตลอดเวลา อาจเปลี่ยนสถาปัตยกรรมของคุณได้ในฐานะรองประธานฝ่ายประสบการณ์ลูกค้า ฉันได้ทำงานกับลูกค้าที่ได้ปรับใช้สถาปัตยกรรมโหนดสามตัว แต่เพื่อการประหยัดต้นทุน พวกเขาจะทำการปิดเซิร์ฟเวอร์ที่สามโดยอัตโนมัติเป็นระยะ

6. ระบบปฏิบัติการและตัวจัดการคลัสเตอร์

ปัจจัยสุดท้ายที่จะกล่าวถึงองค์ประชุม/พยานคือตัวจัดการคลัสเตอร์และระบบปฏิบัติการซอฟต์แวร์ HA และตัวจัดการคลัสเตอร์ไม่ได้ทั้งหมดเท่าเทียมกันเมื่อพูดถึงการปรับใช้องค์ประชุม/พยานหรืออนุญาโตตุลาการของสถานะองค์ประชุมซอฟต์แวร์การทำคลัสเตอร์บางตัวต้องใช้ดิสก์ที่ใช้ร่วมกันเพื่ออนุญาโตตุลาการ ส่วนซอฟต์แวร์อื่นๆ อนุญาตให้แชร์ได้ (NFS, SMB, EFS, Azure Files และ S3)การตระหนักถึงสิ่งที่ตัวจัดการคลัสเตอร์ของคุณต้องการ และโหมดที่สนับสนุนโดยคำนึงถึงองค์ประชุม (ส่วนใหญ่ธรรมดา พยาน แชร์ไฟล์ ฯลฯ) จะมีผลกระทบไม่เฉพาะกับสิ่งที่คุณปรับใช้ แต่ยังส่งผลต่อวิธีที่คุณปรับใช้ด้วย

วิธีที่ดีที่สุดวิธีเดียวในการปรับใช้เซิร์ฟเวอร์องค์ประชุม/คำพยานคือการทำความเข้าใจคำจำกัดความขององค์ประชุม/คำพยานของผู้จำหน่ายของคุณและตัวเลือกที่มีอยู่ ทราบความต้องการของคุณ ปัจจัยในข้อจำกัดหรือโอกาสที่นำเสนอโดยศูนย์ข้อมูลของคุณ (หรือสภาพแวดล้อมระบบคลาวด์) และออกแบบโซลูชัน ที่ให้ระบบที่สำคัญของคุณได้รับการปกป้องในระดับสูงสุดจากการแยกสมอง การเฟลโอเวอร์ที่ผิดพลาด และการหยุดทำงาน

-Cassius Rhue รองประธานฝ่ายประสบการณ์ลูกค้า

สืบพันธุ์จาก SIOS

Filed Under: ทำให้เข้าใจง่ายเซิร์ฟเวอร์คลัสเตอร์

การวัดและปรับปรุงประสิทธิภาพปริมาณงานเขียนบน GCP โดยใช้ SIOS DataKeeper สำหรับ Windows

เมษายน 21, 2022 by Jason Aw Leave a Comment

การวัดและปรับปรุงประสิทธิภาพปริมาณงานเขียนบน GCP โดยใช้ SIOS DataKeeper สำหรับ Windows

พื้นหลัง

โพสต์นี้ใช้เพื่อบันทึกสิ่งที่ค้นพบของฉันใน GCP เกี่ยวกับประสิทธิภาพการเขียนไปยังดิสก์ที่กำลังจำลองแบบไปยัง GCP แต่ก่อนอื่น ข้อมูลพื้นฐานบางอย่าง ลูกค้าแสดงความกังวลว่า DataKeeper เพิ่มโอเวอร์เฮดจำนวนมากให้กับประสิทธิภาพการเขียนเมื่อทำการทดสอบด้วยมิเรอร์ซิงโครนัสระหว่าง Google Zones ในภูมิภาคเดียวกัน การทดสอบดั้งเดิมที่พวกเขาทำคือกับไฟล์บิตแมปบนไดรฟ์ C ซึ่งเป็น SSD แบบถาวร ในการกำหนดค่านี้ พวกเขากดเพียง 70 MBps เท่านั้น พวกเขาพยายามย้ายบิตแมปไปยังดิสก์ GCP สุดขีด แต่ประสิทธิภาพไม่ดีขึ้น

การย้ายบิตแมปไปยัง SSD ในเครื่อง

ฉันแนะนำให้พวกเขาย้ายบิตแมปไปยัง SSD ในเครื่อง แต่พวกเขาลังเลเพราะพวกเขาเชื่อว่าดิสก์สุดขีดที่พวกเขาใช้สำหรับบิตแมปนั้นมีเวลาแฝงและปริมาณงานที่ดีหรือดีกว่า SSD ในเครื่อง ดังนั้นพวกเขาจึงสงสัยว่ามันจะทำให้ ความแตกต่าง. นอกจากนี้ การเพิ่ม SSD ภายในไม่ใช่งานเล็กน้อย เนื่องจากจะเพิ่มได้ก็ต่อเมื่อ VM ได้รับการจัดเตรียมในตอนแรกเท่านั้น

การเลือกประเภทอินสแตนซ์

ขณะที่ฉันออกเดินทางเพื่อทำงานให้เสร็จ สิ่งแรกที่ฉันค้นพบก็คืออินสแตนซ์บางประเภทไม่รองรับ SSD ในเครื่อง ตัวอย่างเช่น E2-Standard-8 ไม่รองรับ SSD ภายใน สำหรับการทดสอบครั้งแรกของฉัน ฉันเลือกใช้อินสแตนซ์ประเภท C2-Standard-8 ซึ่งถือว่าเป็น "การเพิ่มประสิทธิภาพการประมวลผล" ฉันแนบ SSD ถาวรขนาด 500 GB และเริ่มทำการทดสอบประสิทธิภาพการเขียน และค้นพบอย่างรวดเร็วว่าฉันสามารถเขียนดิสก์ได้เพียงประมาณ 140MBps แทนที่จะเป็นความเร็วสูงสุด 240MBps ลูกค้ายืนยันว่าเห็นแบบเดียวกัน เป็นเรื่องที่น่าสับสน แต่เราตัดสินใจดำเนินการต่อและลองใช้อินสแตนซ์ประเภทอื่น

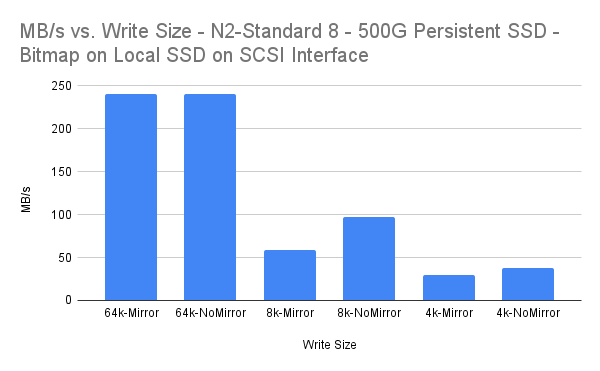
ประเภทอินสแตนซ์ที่สองที่เราเลือกคือ N2-Standard-8 ด้วยอินสแตนซ์ประเภทนี้ เราจึงสามารถพุชดิสก์ให้มีความเร็วปริมาณงานสูงสุด 240 MBps เมื่อไม่ได้จำลองดิสก์ ฉันย้ายบิตแมปไปยัง SSD ในเครื่องที่ฉันได้จัดเตรียมไว้และทำซ้ำการทดสอบเดียวกันบนมิเรอร์ซิงโครนัส (DataKeeper v8.8.2) และได้รับผลลัพธ์ที่แสดงด้านล่าง

ผลลัพธ์

พารามิเตอร์การทดสอบ Diskspd diskspd.exe -c96G -d10 -r -w100 -t8 -o3 -b64K -Sh -LD:data.dat diskspd.exe -c96G -d10 -r -w100 -t8 -o3 -b8K -Sh -LD:data .dat diskspd.exe -c96G -d10 -r -w100 -t8 -o3 -b4K -Sh -LD:data.dat

MBps

ข้อมูล

เขียนขนาด MB/วินาที ค่าใช้จ่ายร้อยละ MBps
64k-กระจก 240.01 0.00%
64k-NoMirror 240.02
8k-กระจก 58.87 39.18%
8k-NoMirror 96.8
4k-กระจกเงา 29.34 21.84%
4k-NoMirror 37.54


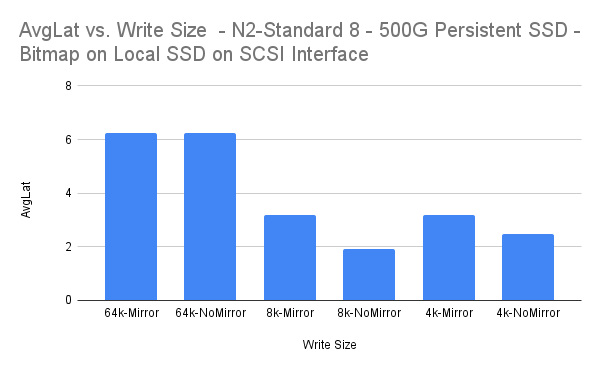
เขียนขนาด AvgLat ค่าใช้จ่ายเฉลี่ย
64k-กระจก 6.247 -0.02%
64k-NoMirror 6.248
8k-กระจก 3.183 39.21%
8k-NoMirror 1.935
4k-กระจกเงา 3.194 21.88%
4k-NoMirror 2.495

บทสรุป

ขนาดการเขียน 64k และ 4k ทั้งหมดมีค่าใช้จ่ายซึ่งอาจถือได้ว่า "ยอมรับได้" สำหรับการจำลองแบบซิงโครนัส ขนาดการเขียน 8k ดูเหมือนว่าจะมีค่าใช้จ่ายจำนวนมาก แม้ว่าเวลาแฝงเฉลี่ยที่ 3.183 มิลลิวินาทียังค่อนข้างต่ำ

-Dave Bermingham ผู้อำนวยการ Customer Success ทำซ้ำโดยได้รับอนุญาตจาก SIOS

Filed Under: ทำให้เข้าใจง่ายเซิร์ฟเวอร์คลัสเตอร์ Tagged With: Google Cloud Platform

  • « Previous Page
  • 1
  • …
  • 49
  • 50
  • 51
  • 52
  • 53
  • …
  • 112
  • Next Page »

โพสต์ล่าสุด

  • ระบบความพร้อมใช้งานสูง (High Availability หรือ HA) คืออะไร?
  • เอาตัวรอดจากวิกฤตการณ์วันศุกร์: จากระบบคอมพิวเตอร์แบบดิบๆ สู่การจำลองข้อมูลที่ราบรื่น
  • ติดดิน: สิ่งที่การพลาดชม Percona Live Amsterdam สอนฉันเกี่ยวกับ HA
  • เปรียบเทียบ SIOS LifeKeeper กับ Red Hat High Availability Add-On:
  • สถานะของความยืดหยุ่นของแอปพลิเคชัน: ผลสำรวจความพร้อมใช้งานสูงของ SIOS ปี 2026

กระทู้ยอดนิยม

เข้าร่วมรายชื่อผู้รับจดหมายของเรา

Copyright © 2026 · Enterprise Pro Theme on Genesis Framework · WordPress · Log in