SIOS SANless clusters

SIOS SANless clusters High-availability Machine Learning monitoring

  • Home
  • Products
    • SIOS DataKeeper for Windows
    • SIOS Protection Suite for Linux
  • การทดสอบอาหารสัตว์
  • ข่าวสารและกิจกรรม
  • ทำให้เข้าใจง่ายเซิร์ฟเวอร์คลัสเตอร์
  • เรื่องราวความสำเร็จ
  • ติดต่อเรา
  • English
  • 中文 (中国)
  • 中文 (台灣)
  • 한국어
  • Bahasa Indonesia
  • ไทย

ซอฟต์แวร์คลัสเตอร์สำหรับความพร้อมใช้งานสูงและการกู้คืนจากภัยพิบัติ

พฤศจิกายน 13, 2021 by Jason Aw Leave a Comment

ซอฟต์แวร์คลัสเตอร์สำหรับความพร้อมใช้งานสูงและการกู้คืนจากภัยพิบัติ

ซอฟต์แวร์คลัสเตอร์

ซอฟต์แวร์คลัสเตอร์สำหรับความพร้อมใช้งานสูงและการกู้คืนจากภัยพิบัติ

ซอฟต์แวร์คลัสเตอร์คืออะไร?

ซอฟต์แวร์คลัสเตอร์ ช่วยให้คุณกำหนดค่าเซิร์ฟเวอร์ของคุณเป็นกลุ่มหรือคลัสเตอร์เพื่อให้เซิร์ฟเวอร์หลายเครื่องสามารถทำงานร่วมกันเพื่อให้มีความพร้อมใช้งานและป้องกันการสูญหายของข้อมูล แต่ละเซิร์ฟเวอร์จะรักษาข้อมูลเดียวกัน – ระบบปฏิบัติการ แอปพลิเคชัน และข้อมูล หากเซิร์ฟเวอร์หนึ่งล้มเหลว เซิร์ฟเวอร์อื่นจะรับภาระงานทันที ผู้เชี่ยวชาญด้านไอทีพึ่งพาคลัสเตอร์เพื่อขจัดจุดล้มเหลวเพียงจุดเดียวและลดความเสี่ยงของการหยุดทำงาน อันที่จริง 86 เปอร์เซ็นต์ขององค์กรทั้งหมดกำลังใช้งานแอปพลิเคชัน HA ด้วยคลัสเตอร์บางประเภทหรือ ความพร้อมใช้งานสูง กลไกในสถานที่[1]

ประเภทของซอฟต์แวร์การจัดการคลัสเตอร์

มีโซลูชันซอฟต์แวร์การจัดการคลัสเตอร์ที่หลากหลายสำหรับการกระจาย Windows และ Linux ตัวอย่าง ได้แก่

  • Windows Server Failover Clustering (WSFC),
  • SUSE Linux Enterprise ส่วนขยายความพร้อมใช้งานสูง
  • เรดแฮทคลัสเตอร์สวีท
  • Oracle Real Application Clusters (RAC) และ
  • ซอฟต์แวร์ SIOS

ผลิตภัณฑ์เหล่านี้รองรับระบบปฏิบัติการเดียวหรือต้องใช้ฮาร์ดแวร์ SAN ราคาแพง ยกเว้น SIOS ซึ่งจำกัดความยืดหยุ่นและตัวเลือกการปรับใช้ นอกจากนี้ ส่วนขยาย HA แบบโอเพ่นซอร์สของ Linux ยังต้องการทักษะทางเทคนิคระดับสูง ซึ่งสร้างปัญหาด้านความซับซ้อนและความน่าเชื่อถือที่ท้าทายผู้ปฏิบัติงานส่วนใหญ่

ผลิตภัณฑ์ SIOS ปกป้องแอปพลิเคชันที่ใช้ Windows หรือ Linux ที่ทำงานในสภาพแวดล้อมจริง เสมือน คลาวด์หรือไฮบริด และในสถานการณ์การกู้คืนไซต์หรือการกู้คืนจากภัยพิบัติ แอปพลิเคชันต่างๆ เช่น SAP และฐานข้อมูล รวมถึง Oracle, SQL Server, DB2, SAP HANA และอื่นๆ อีกมากมาย ได้รับประโยชน์จากซอฟต์แวร์ SIOS ความเรียบง่าย "ที่พร้อมใช้งานทันที" ความยืดหยุ่นในการกำหนดค่า ความน่าเชื่อถือ ประสิทธิภาพ และความคุ้มค่าของผลิตภัณฑ์ SIOS ทำให้พวกเขาแตกต่างจากซอฟต์แวร์การทำคลัสเตอร์อื่นๆ

ซอฟต์แวร์คลัสเตอร์ SIOS ให้ความพร้อมใช้งานสูงสำหรับคลัสเตอร์ Windows และ Linux อย่างไร

หากคุณกำลังใช้งานแอปพลิเคชันที่สำคัญในสภาพแวดล้อม Windows หรือ Linux คุณอาจต้องการพิจารณาผลิตภัณฑ์คลัสเตอร์ซอฟต์แวร์ที่มีความพร้อมใช้งานสูงของ SIOS Technology Corporation

ในสภาพแวดล้อมของ Windows SIOS DataKeeper Cluster Edition ผสานรวมกับและขยาย Windows Server Failover Clustering (WSFC) ได้อย่างราบรื่นโดยให้การเพิ่มประสิทธิภาพตามโฮสต์ การจำลองข้อมูล กลไก. ในขณะที่ WSFC จัดการคลัสเตอร์ซอฟต์แวร์ SIOS จะดำเนินการจำลองแบบเพื่อเปิดใช้งานการป้องกันจากภัยพิบัติและรับรองว่าข้อมูลจะสูญหายเป็นศูนย์ในกรณีที่คลัสเตอร์การจัดเก็บข้อมูลที่ใช้ร่วมกันเป็นไปไม่ได้หรือทำไม่ได้ เช่น ในสภาพแวดล้อมการจัดเก็บข้อมูลบนคลาวด์ เสมือน และประสิทธิภาพสูง

ในสภาพแวดล้อมลินุกซ์ SIOS Protection Suite สำหรับ Linux ให้การผสมผสานอย่างแน่นหนาของคลัสเตอร์เฟลโอเวอร์ที่มีความพร้อมใช้งานสูง การตรวจสอบแอปพลิเคชันอย่างต่อเนื่อง การจำลองข้อมูล และนโยบายการกู้คืนที่กำหนดค่าได้ ปกป้องแอปพลิเคชันที่มีความสำคัญต่อธุรกิจของคุณจากการหยุดทำงานและภัยพิบัติ

ไม่ว่าคุณจะอยู่ในสภาพแวดล้อม Windows หรือ Linux ผลิตภัณฑ์ SIOS จะปลดปล่อยทีมไอทีของคุณจากความซับซ้อนและความท้าทายของโครงสร้างพื้นฐานด้านการประมวลผล พวกเขาให้ข่าวกรอง ระบบอัตโนมัติ ความยืดหยุ่น ความพร้อมใช้งานสูง และผู้จัดการไอทีที่ใช้งานง่ายจำเป็นต้องปกป้องแอปพลิเคชันที่มีความสำคัญต่อธุรกิจจากการหยุดทำงานหรือการสูญหายของข้อมูล ด้วยใบอนุญาตขายกว่า 80,000 ใบ SIOS ถูกใช้โดยบริษัทที่ใหญ่ที่สุดในโลกหลายแห่ง

นี่เป็นกรณีศึกษาหนึ่งที่กล่าวถึงวิธีที่ผู้ให้บริการระบบข้อมูลโรงพยาบาล (HIS) ชั้นนำปรับใช้ SIOS DataKeeper Cluster Edition เพื่อปรับปรุงความพร้อมใช้งานสูงและแบนด์วิดท์เครือข่ายในสภาพแวดล้อมคลัสเตอร์ Windows


ผู้ให้บริการ HIS หนึ่งรายปรับปรุง RPO และ RTO ด้วยซอฟต์แวร์คลัสเตอร์ DataKeeper ของ SIOS

ผู้ให้บริการ HIS ชั้นนำรายนี้มีองค์กรด้านการดูแลสุขภาพ (HCO) ในสหรัฐอเมริกามากกว่า 10,000 แห่ง โดยใช้แอปพลิเคชันที่หลากหลาย รวมถึงการจัดการการดูแลผู้ป่วย การบริการตนเองของผู้ป่วย และการจัดการรายได้ เพื่อสนับสนุนลูกค้าเหล่านี้ องค์กรมีคลัสเตอร์ SQL Server มากกว่า 20 คลัสเตอร์ ซึ่งตั้งอยู่ในศูนย์ข้อมูลสองแห่งที่กระจายอยู่ตามภูมิศาสตร์ เช่นเดียวกับเซิร์ฟเวอร์ขนาดเล็กสองสามตัวและการจัดส่งบันทึกของ SQL Server สำหรับ การกู้คืนระบบ (DR).

องค์กรมีฐานลูกค้าขนาดใหญ่และโครงสร้างพื้นฐานด้านไอทีที่กว้างขวาง และต้องการโซลูชันที่สามารถรองรับการรับส่งข้อมูลเครือข่ายจำนวนมาก และขจัดปัญหาแบนด์วิดท์ของเครือข่ายเมื่อจำลองข้อมูลไปยังไซต์ DR องค์กรยังต้องปรับปรุง Recovery Point Objective (RPO) และ Recovery Time Objective (RTO) เพื่อลดปริมาณข้อมูลที่มีความเสี่ยง และช่วยให้ฝ่ายไอทีกลับมาทำงานได้รวดเร็วขึ้นหลังภัยพิบัติหรือระบบล้มเหลว RPO คือจำนวนสูงสุดของการสูญเสียข้อมูลที่สามารถยอมรับได้เมื่อเซิร์ฟเวอร์ล้มเหลว หรือเกิดภัยพิบัติขึ้น RTO คือระยะเวลาสูงสุดที่ยอมรับได้ของการหยุดทำงาน

เพื่อจัดการกับความท้าทายเหล่านี้ องค์กรนี้เลือก SIOS DataKeeper Cluster Edition ซึ่งให้การผสานรวมกับ WSFC ได้อย่างราบรื่น ทำให้สามารถสร้างคลัสเตอร์ SANless ได้

เมื่อ SIOS DataKeeper Cluster Edition ผ่านการทดสอบ POC ที่เข้มงวดขององค์กรแล้ว ทีมไอทีได้ปรับใช้โซลูชันนี้ในสภาพแวดล้อมการผลิตของบริษัท ทีมงานได้ปรับใช้ SIOS ในคลัสเตอร์สามโหนดที่ประกอบด้วยโหนดบน SAN สองโหนดในศูนย์ข้อมูลหลักในองค์กรขององค์กร และโหนด SANless หนึ่งโหนดในไซต์ DR ระยะไกล

โซลูชัน SIOS จะซิงโครไนซ์การจำลองแบบข้ามสามโหนดในคลัสเตอร์และขจัดปัญหาแบนด์วิดท์ที่ไซต์ DR ปรับปรุงทั้ง RPO และ RTO และลดต้นทุนของแบนด์วิดท์ วันนี้ องค์กรใช้ SIOS DataKeeper Cluster Edition เพื่อปกป้องสภาพแวดล้อม SQL Server ของตนในโหนดคลัสเตอร์มากกว่า 18 โหนด

ดูกรณีศึกษาฉบับเต็มเพื่อเรียนรู้เพิ่มเติม .


ซอฟต์แวร์คลัสเตอร์ SIOS ทำงานอย่างไร

ซอฟต์แวร์ SIOS เป็นส่วนสำคัญของโซลูชันคลัสเตอร์ของคุณ ปกป้องตัวเลือกสภาพแวดล้อม Windows หรือ Linux ของคุณในการกำหนดค่าใดๆ (หรือรวมกัน) ของสภาพแวดล้อมทางกายภาพ เสมือน และบนคลาวด์ (สาธารณะ ส่วนตัว และไฮบริด) โดยไม่สูญเสียประสิทธิภาพหรือความพร้อมใช้งาน

หากคุณต้องการการจำลองที่รวดเร็ว มีประสิทธิภาพ เพื่อถ่ายโอนข้อมูลผ่านเครือข่ายท้องถิ่นหรือบริเวณกว้างที่มีแบนด์วิดท์ต่ำ SIOS DataKeeper จะปกป้องสภาพแวดล้อม Windows ที่มีความสำคัญทางธุรกิจ รวมถึง Microsoft SQL Server, Oracle, SharePoint, Lync, Dynamics และ Hyper-V จากการหยุดทำงานและ การสูญเสียข้อมูลในสภาพแวดล้อมทางกายภาพ เสมือน หรือระบบคลาวด์

SIOS Protection Suite สำหรับ Linux รองรับการกระจาย Linux หลักทั้งหมด รวมถึง Red Hat Enterprise Linux, SUSE Linux Enterprise Server, CentOS และ Oracle Linux และรองรับสถาปัตยกรรมการจัดเก็บข้อมูลที่หลากหลาย

หากต้องการดูว่าซอฟต์แวร์คลัสเตอร์ SIOS ทำงานอย่างไรเพื่อปกป้องสภาพแวดล้อม Windows และ Linux ขอตัวอย่าง หรือรับ ทดลองฟรี .

เรียนรู้เพิ่มเติมเกี่ยวกับ: การทำคลัสเตอร์ SAP การทำคลัสเตอร์เซิร์ฟเวอร์ SQL Oracle คลัสเตอร์ การทำคลัสเตอร์ Linux ตรวจสอบบล็อกโพสต์ล่าสุดเกี่ยวกับผลิตภัณฑ์การจัดกลุ่มของเรา

อ้างอิง

  • https://searchdomino.techtarget.com/definition/application-clustering
  • https://www.itprotoday.com/cloud-computing/clustering-software
  • https://searchwindowsserver.techtarget.com/definition/Windows-Server-failover-clustering

[1]SIOS ร่วมกับ ActualTech Research, (2018) รายงานการสำรวจความพร้อมใช้งานสูงของ State of Application ทำซ้ำจาก SIOS
Filed Under: ทำให้เข้าใจง่ายเซิร์ฟเวอร์คลัสเตอร์

พื้นฐานการกู้คืนจากภัยพิบัติ

พฤศจิกายน 8, 2021 by Jason Aw Leave a Comment

พื้นฐานการกู้คืนจากภัยพิบัติ

พื้นฐานการกู้คืนจากภัยพิบัติ

ภาพรวมการกู้คืนจากภัยพิบัติ


การกู้คืนจากภัยพิบัติหมายถึงความสามารถในการกู้คืน/ซ่อมแซมระบบอย่างรวดเร็ว และลดความเสียหายให้เหลือน้อยที่สุดในกรณีที่เกิดความล้มเหลวทั่วทั้งไซต์หรือแม้กระทั่งระดับภูมิภาค การกู้คืนข้อมูลหลังภัยพิบัติเป็นส่วนสำคัญของการจัดการความต่อเนื่องทางธุรกิจ และการมีโปรโตคอลการกู้คืนข้อมูลหลังภัยพิบัติที่มีประสิทธิภาพจะช่วยป้องกันการสูญเสียข้อมูลที่ไม่จำเป็นและค่าใช้จ่ายที่เกี่ยวข้องกับการหยุดทำงานของระบบ

อะไรคือส่วน ‘ภัยพิบัติ’ ของการกู้คืนจากภัยพิบัติ ซึ่งอาจหมายถึงภัยธรรมชาติ เช่น แผ่นดินไหว น้ำท่วม เป็นต้น แต่ยังรวมถึงเหตุการณ์ต่างๆ เช่น “ไฟไหม้” “การก่อการร้าย” “การบุกรุกโดยไม่ได้รับอนุญาต” “การแฮ็กขนาดใหญ่” และ “ขนาดใหญ่ในระยะยาว -ขนาดไฟฟ้าดับ” สิ่งใดก็ตามที่อาจก่อให้เกิดความเสียหายร้ายแรงต่อระบบไอทีหากเกิดความล้มเหลว

ผลกระทบที่แท้จริงของความล้มเหลวของระบบ

นอกเหนือจากความเสียหายทางกายภาพที่อาจเกิดขึ้นและการสูญหายของข้อมูลที่เกี่ยวข้องกับความล้มเหลวของระบบ การไม่มีแผนการกู้คืนจากความเสียหายอาจทำให้สูญเสียรายได้ที่ไม่สามารถกู้คืนได้สำหรับธุรกิจ ทุกๆ นาทีของการหยุดทำงานของระบบ นั่นหมายถึงการสูญเสียการขายและโอกาส ประสบการณ์ของลูกค้าในเชิงลบที่อาจเกิดขึ้น ชื่อเสียงทางธุรกิจที่มัวหมอง และค่าใช้จ่ายสูงในการซ่อมแซมไอทีฉุกเฉิน

ความสำคัญของการฟื้นฟูจากภัยพิบัติ

สำหรับบริษัทที่ให้บริการที่มีความสำคัญต่อภารกิจ การสร้างระบบความต่อเนื่องทางธุรกิจที่สามารถจัดการกับการหยุดทำงานของระบบที่ไม่คาดคิดได้นั้นเป็นสิ่งจำเป็น ความสามารถในการป้องกันความล้มเหลวตั้งแต่แรก และการกู้คืนอย่างรวดเร็วในกรณีที่เกิดความล้มเหลวในพื้นที่หรือแม้แต่ภัยพิบัติทั่วทั้งไซต์หรือระดับภูมิภาค จะช่วยปกป้องข้อมูล รักษาสายสัมพันธ์กับลูกค้า และประหยัดเวลาและการสูญเสียทางการเงินที่อาจร้ายแรง

สิ่งสำคัญคือต้องตระหนักว่าความล้มเหลวของระบบที่ร้ายแรงคือสิ่งที่จะเกิดขึ้น ไม่ใช่สิ่งที่จะเกิดขึ้น ดังนั้นการวางแผนการกู้คืนจากความเสียหายอย่างเหมาะสมจะช่วยปกป้องธุรกิจของคุณ

ความท้าทายในการกู้คืนจากภัยพิบัติ


แม้ว่าโปรโตคอลการกู้คืนจากความเสียหายจะมีความจำเป็น แต่ก็ใช่ว่าจะมีความท้าทายในการตั้งค่าและใช้งาน ต่อไปนี้คืออุปสรรคบางประการในการดำเนินการกู้คืนจากภัยพิบัติอย่างเหมาะสม: ความท้าทายที่ 1: การแบ่งแยกทางภูมิศาสตร์
สาระสำคัญของการป้องกันภัยพิบัติคือการรักษาระบบและข้อมูลไว้ในตำแหน่งที่แยกตามภูมิศาสตร์จากศูนย์ข้อมูลหลักหรืออินสแตนซ์ระบบคลาวด์ เพื่อที่ในกรณีที่เกิดภัยพิบัติหรือระบบคลาวด์ขัดข้อง ระบบสำรองสามารถออนไลน์และดำเนินการต่อไปได้

ความท้าทายที่ 2: ข้อกำหนดแบนด์วิดท์เครือข่าย การจำลองข้อมูลไปยังตำแหน่งภายนอกสำหรับการกู้คืนจากความเสียหายอาจหมายถึงความต้องการแบนด์วิดท์ของเครือข่ายที่เพิ่มขึ้นและปัญหาเวลาแฝง

ความท้าทายที่ 3: ปริมาณข้อมูลเพิ่มขึ้นอย่างต่อเนื่อง ข้อกำหนดด้านความจุของพื้นที่เก็บข้อมูลบนไซต์กู้คืนจากความเสียหายจะเพิ่มขึ้นเมื่อเวลาผ่านไป แผนการกู้คืนจากภัยพิบัติที่เหมาะสมจำเป็นต้องสร้าง “ลำดับความสำคัญในการป้องกัน” เพื่อชี้แจงว่าข้อมูลใดควรได้รับการปกป้องและเพิ่มประสิทธิภาพทรัพยากรการจัดเก็บข้อมูลที่มีอยู่

ความท้าทายที่ 4: ขั้นตอนการกู้คืนในขณะที่การกู้คืน หากระบบล่มเนื่องจากภัยพิบัติ จำเป็นต้องกู้คืนบริการ บ่อยครั้ง บริษัทต่างๆ พบว่าข้อมูลของพวกเขากระจัดกระจายอยู่ในหลายที่ และไม่มีขั้นตอนที่เป็นมาตรฐานสำหรับและการกู้คืน ส่งผลให้เสียเวลาและค่าใช้จ่ายมหาศาล การพัฒนาขั้นตอนการบูรณะที่ชัดเจนและได้มาตรฐานจะช่วยขจัดอาการปวดหัวนี้ และช่วยให้ดำเนินการได้อย่างรวดเร็วในยามที่สำคัญที่สุด

การสำรองข้อมูลเทียบกับการป้องกันความพร้อมใช้งาน

ตามธรรมเนียมแล้ว การสำรองข้อมูล – โดยพื้นฐานแล้วเป็นกระบวนการในการทำสำเนาข้อมูลและแอปพลิเคชันและย้ายไปยังตำแหน่งภายนอก – ได้ดำเนินการเพื่อวัตถุประสงค์ในการปกป้องข้อมูลในกรณีที่อุปกรณ์ไอทีขัดข้อง/ล้มเหลว และเพื่อการเก็บบันทึก/การเก็บถาวรตามระเบียบข้อบังคับ ข้อกำหนดเช่น HIPAA (Healthcare Information Portability Accountability Act) ในการกู้คืนการทำงาน เซิร์ฟเวอร์ พื้นที่เก็บข้อมูล และฮาร์ดแวร์อื่นๆ รวมถึงเครือข่ายที่ได้รับผลกระทบจากเหตุการณ์นั้นจำเป็นต้องเปลี่ยนหรือซ่อมแซม เซิร์ฟเวอร์ต้องได้รับการกำหนดค่าและต้องกู้คืนแอปพลิเคชัน นำกลับมาออนไลน์ และเชื่อมต่อกับข้อมูลที่กู้คืน ขั้นตอนเหล่านี้สามารถเป็นเดือน

หากไม่มีกระบวนการป้องกันความพร้อมใช้งาน การดำเนินการกู้คืนด้วยการสำรองข้อมูลเพียงอย่างเดียวอาจเป็นกระบวนการที่ใช้เวลานานและมีราคาแพง กระบวนการความพร้อมใช้งานช่วยให้ระบบปฏิบัติการเต็มรูปแบบพร้อมที่จะรับช่วงต่อในกรณีที่เกิดภัยพิบัติ ทำให้สามารถกลับมาให้บริการได้ในเวลาไม่กี่นาที

ต่อไปนี้คือสาเหตุทั่วไปบางประการที่แผนการกู้คืนข้อมูลหลังภัยพิบัติที่มีประสิทธิภาพมีความสำคัญ:

ตัวชี้วัดการกู้คืนจากภัยพิบัติ


ตัวชี้วัดหลักสำหรับการกู้คืนจากความเสียหายคือ “RPO” และ “RTO”

RPO (วัตถุประสงค์จุดกู้คืน) RPO ระบุจุดจากเวลาที่เกิดภัยพิบัติจนถึงเวลาที่ผ่านมาที่รับประกันการกู้คืนข้อมูล

ถ้า “RPO = < 5 นาที เมื่อมุ่งหมายสำหรับ “RPO = 0 (ข้อมูลสูญหายเป็นศูนย์)” จำเป็นต้องมีกลไกการป้องกันความพร้อมใช้งาน เช่น การทำคลัสเตอร์เมื่อเกิดข้อผิดพลาด

RTO (วัตถุประสงค์เวลาการกู้คืน) RTO คือดัชนีที่แสดงเวลาที่ธุรกิจของคุณอนุญาตให้ผ่านจากการหยุดทำงานครั้งแรกไปสู่การฟื้นฟูการดำเนินงาน “RTO = 1 เดือนขึ้นไป” คุณอาจสามารถจัดการการกู้คืนข้อมูลได้ด้วยการสำรองข้อมูลระยะไกลและรักษาความปลอดภัยให้กับอุปกรณ์ทดแทนเท่านั้น แต่ถ้า “RTO = ภายในไม่กี่นาที” จำเป็นต้องมีการทำคลัสเตอร์ล้มเหลว

การเลือกวิธีการกู้คืนจากภัยพิบัติ


เมื่อกำหนดวิธีการกู้คืนจากความเสียหายที่ถูกต้องสำหรับธุรกิจของคุณ ให้พิจารณาปัจจัยสำคัญเหล่านี้:

  • ความสำคัญของกระบวนการทางธุรกิจและความอดทนต่อผลกระทบ
  • ชนิดข้อมูลและความจุที่คุณต้องการปกป้อง
  • ข้อกำหนดการกู้คืน – RPO และ RTO . ของคุณ
  • งบประมาณ

มุ่งเน้นไปที่ผลกระทบทางธุรกิจ

ในขณะที่แผนกไอทีเป็นผู้นำทางเทคนิคในการพัฒนามาตรการการกู้คืนความเสียหายสำหรับระบบไอที เจ้าของธุรกิจต้องพิจารณาผลกระทบและขอบเขตของการหยุดทำงานของระบบต่อผลกระทบทางธุรกิจของแต่ละระบบที่หยุดทำงาน” เพื่อให้แน่ใจว่ามีผลกระทบน้อยที่สุดต่อธุรกิจ

ชนิดข้อมูลที่ได้รับการป้องกัน (ความสมบูรณ์ของข้อมูล)

การจัดประเภทและความสำคัญของข้อมูลที่ได้รับการคุ้มครองเป็นสิ่งสำคัญ สำหรับข้อมูลที่ไม่ต้องการความสม่ำเสมอที่แม่นยำมาก (เช่น ไฟล์เซิร์ฟเวอร์) การสำรองข้อมูลที่จัดเก็บข้อมูลหลักอย่างง่ายอาจเพียงพอ

ในทางกลับกัน ระบบ ERP และฐานข้อมูล เช่น SQL Server, Oracle และ SAP มีบริการและชิ้นส่วนที่หลากหลายซึ่งจำเป็นต้องระบุตำแหน่งบนเซิร์ฟเวอร์เฉพาะ เริ่มทำงานในคำสั่งซื้อเฉพาะ และจัดการตามแนวทางปฏิบัติที่ดีที่สุดเฉพาะแอปพลิเคชันที่หลากหลาย . โดยทั่วไปต้องมีการป้องกันความพร้อมใช้งานสูงและโซลูชันคลัสเตอร์ที่รับรู้แอปพลิเคชันเพื่อจัดการการเฟลโอเวอร์

———————————————————————————————————————

เงื่อนไขการกู้คืนจากภัยพิบัติที่สำคัญ


การสำรองข้อมูลระยะไกล – โดยพื้นฐานแล้วจะเก็บสำเนาของแอปพลิเคชันและข้อมูลไว้ในตำแหน่งระยะไกลที่แยกจากกันทางภูมิศาสตร์

มิเรอร์ที่เก็บข้อมูลแบบซิงโครนัส การรักษาสำเนาการจัดเก็บข้อมูลในเครื่องและระยะไกลให้ตรงกันสำหรับการป้องกัน DR ในวิธีนี้ ข้อมูลจะถูกเขียนไปยังที่จัดเก็บในตัวเครื่องและจำลองแบบทันทีไปยังที่เก็บข้อมูลระยะไกล ที่เก็บข้อมูลในเครื่องจะไม่ “ผูกมัด” จนกว่ากระบวนการเขียนข้อมูลไปยังตำแหน่งระยะไกลจะเสร็จสิ้น กระบวนการนี้ทำให้ทั้งสองสถานที่เหมือนกัน ขจัดความคลาดเคลื่อนที่อาจส่งผลให้หาก data-in-transit ในเวลาที่เกิดเหตุการณ์ไม่สามารถเขียนบนตำแหน่งระยะไกลได้ รับประกันความสมบูรณ์ของข้อมูลระหว่างไซต์หลักและไซต์สำรอง

มิเรอร์ที่เก็บข้อมูลแบบอะซิงโครนัส
วิธีนี้จะเขียนข้อมูลไปยังที่จัดเก็บในตัวเครื่องแล้วทำซ้ำไปยังตำแหน่งระยะไกล ช่วยให้มีประสิทธิภาพการใช้เครือข่ายมากขึ้นและลดความขัดแย้งของแบนด์วิดธ์เมื่อการแยกทางภูมิศาสตร์ทำให้เกิดเวลาแฝง

“สแตนด์บายเย็น” และ “สแตนด์บายร้อน”

สแตนด์บายเย็น กระบวนการเก็บสำเนาข้อมูลหรือระบบสำรองแบบออฟไลน์ในกรณีที่เกิดภัยพิบัติ หากระบบหลักหยุดทำงาน ระบบและซอฟต์แวร์ต้องเริ่มต้นด้วยตนเอง ในบางกรณีต้องกำหนดค่า และต้องกู้คืนข้อมูลก่อนจึงจะดำเนินการต่อได้

ร้อนสแตนด์บาย นี่เป็นกระบวนการที่ทำให้ระบบรองทำงานและเปลี่ยนไปใช้ระบบสำรองในกรณีที่ระบบหลักหยุดทำงาน

การเปรียบเทียบต้นทุนวิธีการกู้คืนจากภัยพิบัติ


RPO และ RTO ที่เล็กลง เวลาหยุดทำงานสั้นลง แต่ต้นทุนจะเพิ่มขึ้นตามไปด้วย

เมื่อพิจารณาถึงต้นทุนและมูลค่าสินทรัพย์ของข้อมูลแต่ละประเภทแล้ว จำเป็นต้องค้นหาวิธีการที่เหมาะสมที่สุดสำหรับระดับการป้องกันที่ต้องการ ความสมดุลระหว่างการใช้งานภายในองค์กรและการจ้างบริการภายนอกจะส่งผลกระทบต่อต้นทุน

หากต้องการเรียนรู้เพิ่มเติมเกี่ยวกับความพร้อมใช้งานสูงและโซลูชันการกู้คืนระบบที่ SIOS คลิก ที่นี่ .


สืบพันธุ์จาก SIOS


Filed Under: ทำให้เข้าใจง่ายเซิร์ฟเวอร์คลัสเตอร์

การกู้คืนระบบ

พฤศจิกายน 2, 2021 by Jason Aw Leave a Comment

การกู้คืนระบบ

การกู้คืนระบบ

วิธีเปิดใช้งานการกู้คืนข้อมูลหลังภัยพิบัติด้วยโซลูชันซอฟต์แวร์คลัสเตอร์เดียว

ปกป้องแอปพลิเคชัน Windows หรือ Linux ที่ทำงานด้วยการผสมผสานระหว่างโครงสร้างพื้นฐานทางกายภาพ เสมือน คลาวด์ หรือไฮบริดพร้อมการกู้คืนจากภัยพิบัติ

การกู้คืนจากภัยพิบัติคืออะไร?

การกู้คืนจากภัยพิบัติมีความสำคัญต่อการดำเนินธุรกิจอย่างต่อเนื่อง

Disaster Recovery (DR) เป็นกลยุทธ์และชุดนโยบาย ขั้นตอน และเครื่องมือที่ช่วยให้มั่นใจได้ว่าระบบ IT ฐานข้อมูล และแอปพลิเคชันที่สำคัญจะยังคงทำงานและพร้อมใช้งานสำหรับผู้ใช้เมื่อเกิดภัยพิบัติที่มนุษย์สร้างขึ้นหรือภัยธรรมชาติ แม้ว่าทีมไอทีจะเป็นเจ้าของกลยุทธ์การกู้คืนจากความเสียหาย DR ก็เป็นองค์ประกอบที่สำคัญของแผนความต่อเนื่องทางธุรกิจของทุกองค์กร ซึ่งเป็นกลยุทธ์และชุดนโยบาย ขั้นตอน และเครื่องมือที่ช่วยให้ธุรกิจทั้งหมดกลับมาทำงานได้หลังจากเกิดภัยพิบัติ

แต่เมื่อเราพูดถึงภัยพิบัติ ไม่จำเป็นต้องเป็นพายุเฮอริเคน ทอร์นาโด น้ำท่วม หรือแผ่นดินไหวเต็มรูปแบบที่ส่งผลกระทบต่อธุรกิจของคุณ ภัยพิบัติมีหลายรูปแบบ เช่น การโจมตีทางไซเบอร์ ข้อผิดพลาดของผู้ใช้ ไฟไหม้ การโจรกรรม การก่อกวน แม้แต่การโจมตีของผู้ก่อการร้าย กล่าวโดยสรุป ภัยพิบัติคือวิกฤตใดๆ ที่ส่งผลให้ระบบหยุดทำงานเป็นเวลานานและ/หรือสูญเสียข้อมูลครั้งใหญ่ในวงกว้างซึ่งส่งผลกระทบต่อโครงสร้างพื้นฐานด้านไอที ศูนย์ข้อมูล และธุรกิจของคุณ

การกู้คืนระบบ

ใน Spiceworks ล่าสุด สำรวจ ร้อยละ 59 ขององค์กรระบุว่าพวกเขาประสบปัญหาการหยุดทำงาน 1 ถึง 3 ครั้ง (นั่นคือ การหยุดชะงักของบริการที่เกี่ยวข้องกับไอทีในระดับปกติ) ตลอดระยะเวลาหนึ่งปี 11 เปอร์เซ็นต์มีประสบการณ์ 4-6 ครั้ง และ 7 เปอร์เซ็นต์ประสบปัญหา 7 หรือ มากกว่า. นอกจากนี้ การสำรวจยังระบุด้วยว่าบริษัทขนาดใหญ่ซึ่งต้องใช้บริการจำนวนมากขึ้น มีแนวโน้มที่จะประสบปัญหาการหยุดชะงักมากกว่าองค์กรขนาดเล็ก ตัวอย่างเช่น 71 เปอร์เซ็นต์ของธุรกิจขนาดเล็กประสบปัญหาการหยุดชะงักอย่างน้อยหนึ่งครั้งในช่วง 12 เดือนที่ผ่านมา เทียบกับ 79 เปอร์เซ็นต์ของธุรกิจขนาดกลาง และ 87 เปอร์เซ็นต์ของธุรกิจขนาดใหญ่ เมื่อคุณดูสถิติเหล่านั้น คุณจะรู้ว่าคุณกำลังใช้ชีวิตอยู่กับเวลาที่ยืมมา ถ้าคุณไม่มีแผนการกู้คืนจากความเสียหาย

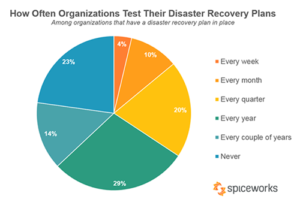
แต่มีข่าวดี เมื่อเทียบกับสถิติในปีที่แล้ว ดูเหมือนว่าองค์กรทุกขนาดและจากทุกอุตสาหกรรมจะทำงานได้ดีขึ้นเมื่อต้องมีแผนการกู้คืนความเสียหาย จากการสำรวจเดียวกันของ Spiceworks 95 เปอร์เซ็นต์ ขององค์กรมีแผน DR แต่น่าเสียดายที่ 23 เปอร์เซ็นต์ไม่เคยทดสอบหรือใช้แผนของพวกเขา การใช้แผน DR ของคุณมีความสำคัญพอๆ กับการฝึกดับเพลิงของนักเรียนหรือการฝึกชุมนุม การวางแผนเป็นเพียงขั้นตอนแรก หากผู้ที่เกี่ยวข้องในการดำเนินการตามแผนไม่ทราบว่าต้องทำอย่างไร คุณจะไม่สามารถกู้คืนจากภัยพิบัติได้

ความพร้อมใช้งานสูงเทียบกับ การกู้คืนระบบ

แต่ก่อนที่เราจะดำเนินการต่อ เรามาทำความเข้าใจความแตกต่างระหว่างแนวทางปฏิบัติที่ดีที่สุดสำหรับการจัดการความล้มเหลวของระบบกับภัยพิบัติกันก่อน ในการกู้คืนจากความล้มเหลวของระบบ ระบบสำรอง ซอฟต์แวร์ และข้อมูลควรอยู่ในเครือข่ายท้องถิ่น (LAN) ของคุณ สำหรับแอปพลิเคชันฐานข้อมูลที่สำคัญ คุณสามารถจำลองข้อมูลแบบซิงโครนัสผ่าน LAN ได้ ซึ่งจะทำให้อินสแตนซ์สแตนด์บายของคุณ “ร้อน” และซิงค์กับอินสแตนซ์ที่ใช้งานอยู่ ดังนั้นจึงพร้อมรับช่วงต่อทันทีในกรณีที่เกิดความล้มเหลว นี้เรียกว่า ความพร้อมใช้งานสูง (HA) .

อย่างไรก็ตาม ในการกู้คืนระบบ ซอฟต์แวร์ และข้อมูลในกรณีที่เกิดภัยพิบัติ หมายถึงส่วนประกอบที่ซ้ำซ้อนต้องอยู่บนเครือข่ายบริเวณกว้าง (WAN) ด้วย WAN การจำลองข้อมูลจะไม่พร้อมกันเพื่อหลีกเลี่ยงผลกระทบด้านลบต่อประสิทธิภาพของปริมาณงาน ซึ่งหมายความว่าการอัปเดตอินสแตนซ์สแตนด์บายจะทำให้การอัปเดตที่ทำกับอินสแตนซ์ที่ใช้งานอยู่ล่าช้า ส่งผลให้เกิดความล่าช้าในระหว่างกระบวนการกู้คืน เนื่องจากภัยพิบัติมีน้อยมาก ความล่าช้าบางอย่างอาจพอทนได้และขึ้นอยู่กับ (ก) ความสำคัญของธุรกิจของคุณในการบรรลุ Recovery Time Objective (RTO) และ Recovery Point Objective (RPO) ที่ต่ำที่สุดเท่าที่จะเป็นไปได้ และ (b) งบประมาณที่คุณมี สามารถจัดสรรเพื่อให้ได้ RTO และ RPO ที่ดีที่สุด

RTO คือระยะเวลาสูงสุดที่ยอมรับได้ของการหยุดทำงาน และ RPO คือจำนวนสูงสุดของการสูญเสียข้อมูลที่สามารถยอมรับได้เมื่อเกิดภัยพิบัติ สำหรับการกู้คืนจากความเสียหาย RTO ที่มีความยาวหลายนาทีหรือหลายชั่วโมงนั้นเป็นเรื่องปกติสำหรับโซลูชันบางอย่าง เนื่องจากมีค่าใช้จ่ายสูงเกินกว่าที่จะพยายามกู้คืนผ่าน WAN ในเวลาเพียงไม่กี่นาที สำหรับแอปพลิเคชันที่มีความสำคัญต่อภารกิจ องค์กรของคุณจะต้องการได้รับ RPO ที่ต่ำ แต่ยิ่ง RPO ของคุณต่ำ คุณก็ยิ่งต้องการกระบวนการมากขึ้นเท่านั้น เพื่อให้แน่ใจว่าข้อมูลทั้งหมดได้รับการจำลองแบบบนเซิร์ฟเวอร์สแตนด์บายก่อนที่จะเกิดข้อผิดพลาด ความพยายามนี้มีแนวโน้มที่จะเพิ่มเวลาในการฟื้นตัว

แต่ด้วยโซลูชันการกู้คืนความเสียหาย SIOS คุณสามารถบรรลุ RPO ที่น้อยที่สุดถึงไม่มีข้อมูลสูญหาย และ RTO ที่ใช้เวลาหนึ่งถึงสองนาที

SIOS มอบโซลูชันเดียวเพื่อตอบสนองความต้องการ HA และ DR ของคุณ

ไม่ว่าคุณจะต้องการ HA ในพื้นที่ภายในไซต์เดียวหรือ DR ที่รวดเร็วและมีประสิทธิภาพในหลายไซต์ โซลูชัน SIOS จะตอบสนองทุกความต้องการด้านความต่อเนื่องทางธุรกิจของคุณ

NS โซลูชันการกู้คืนความเสียหาย SIOS เป็นคลัสเตอร์แบบหลายไซต์ที่กระจายตัวตามภูมิศาสตร์ที่ให้ RPO วินาทีและ RTO เป็นนาที สิ่งที่ทำให้ SIOS แตกต่างจากผู้ให้บริการ DR รายอื่นๆ คือมีโซลูชันเดียวที่ตอบสนองความต้องการด้านความพร้อมใช้งานสูงและการกู้คืนจากความเสียหาย

เพื่อรองรับ DR คุณต้องกำหนดค่าคลัสเตอร์ของคุณในลักษณะเดียวกับที่คุณทำสำหรับความพร้อมใช้งานสูง แต่มีความแตกต่างที่ชัดเจนสองประการที่กล่าวถึงก่อนหน้านี้:

  • โหนดคลัสเตอร์ DR อยู่ในไซต์ทางภูมิศาสตร์ ทั้งในสถานที่ เสมือน หรือในคลาวด์ ซึ่งอยู่ไกลจากอินสแตนซ์ HA
  • ไซต์ DR อยู่บนเครือข่ายบริเวณกว้าง (WAN) ซึ่งหมายความว่า การจำลองข้อมูล จะเป็นแบบอะซิงโครนัสเพื่อหลีกเลี่ยงผลกระทบด้านลบต่อประสิทธิภาพของปริมาณงาน

โปรดจำไว้ว่า การจำลองข้อมูลแบบอะซิงโครนัสหมายความว่าการอัปเดตอินสแตนซ์ DR จะทำให้การอัปเดตที่ทำกับอินสแตนซ์ที่ใช้งานอยู่ล่าช้า แต่โดยทั่วไปแล้วจะไม่เกินไม่กี่วินาทีเท่านั้น แต่ด้วยการจำลองข้อมูลที่รวดเร็วอย่างเหลือเชื่อของ SIOS ใน WAN คุณสามารถเก็บสำเนาข้อมูลแบบเรียลไทม์ที่ซิงโครไนซ์ข้ามเซิร์ฟเวอร์และศูนย์ข้อมูลหลายแห่งเพื่อให้ได้ทั้ง HA และ DR

นอกจากโซลูชันเดียวสำหรับ HA/DR และการจำลองข้อมูลแบบเรียลไทม์แล้ว โซลูชัน SIOS HA/DR ยังให้:

  • การบีบอัดข้อมูลระดับบล็อกเพื่อลดการโหลดเครือข่าย
  • การควบคุมปริมาณแบนด์วิดท์เพื่อควบคุมและลดความแออัดของเครือข่าย
  • การเพิ่มประสิทธิภาพ WAN เพื่อปรับปรุงประสิทธิภาพของเครือข่าย
  • การผสานรวมกับการแทนที่ด้วยปุ่มกดเพื่อรองรับ DR และการเฟลโอเวอร์อัตโนมัติเพื่อรองรับ HA
  • แนวทางแพลตฟอร์มที่ไม่เชื่อเรื่องพระเจ้า ช่วยให้คุณเลือกโซลูชัน DR ในสถานที่ เสมือน คลาวด์ หรือไฮบริด

กรณีศึกษาต่อไปนี้แสดงการใช้ SIOS DataKeeper เพื่อส่ง HA และ DR ในโซลูชันเดียว

—————————————————————————————————————————

การเปิดใช้งานการป้องกัน HA และ DR ที่ศูนย์สุขภาพระดับพรีเมียร์

โรงพยาบาล ALYN ตั้งอยู่ในอิสราเอล เป็นศูนย์สุขภาพเพื่อการฟื้นฟูเด็กชั้นนำ เชี่ยวชาญในการวินิจฉัยและฟื้นฟูทารก เด็ก และวัยรุ่นที่มีความพิการทางร่างกาย ผู้ปกครองพาบุตรหลานจากอิสราเอลและต่างประเทศเพื่อรับบริการทางการแพทย์ การรักษาพยาบาล และบริการฟื้นฟูที่ล้ำสมัยเพิ่มเติม

การค้นหาโซลูชันที่เหมาะสม

โรงพยาบาล ALYN ดำเนินการแอพพลิเคชั่นที่หลากหลาย – รวมถึงเวชระเบียนอิเล็กทรอนิกส์ (EMR), การจัดการลูกค้าสัมพันธ์ (CRM), ฐานข้อมูล SQL Server, Microsoft Exchange และ Microsoft Office เพื่อสนับสนุนการดำเนินงานทางคลินิกและการบริหาร ในฐานะผู้ให้บริการด้านการรักษาพยาบาล โรงพยาบาลต้องปฏิบัติตามกฎระเบียบของรัฐบาลที่เข้มงวด และจำเป็นต้องดำเนินการตามข้อกำหนด DR ที่เข้มงวด เพื่อให้แน่ใจว่ามีการป้องกันและความพร้อมใช้งานของแอปพลิเคชันที่มีความสำคัญต่อภารกิจ โรงพยาบาลได้เลือก Hyper-V Replica เพื่อสนับสนุนกลยุทธ์ DR โดยปฏิบัติการสองห้องเซิร์ฟเวอร์ที่แยกจากกันภายในองค์กร ทำให้ Virtual Machines (VN) ที่สำคัญทั้งหมดทำงานบนเซิร์ฟเวอร์โฮสต์ Hyper-V ใดๆ สามารถจำลองไปยังอีกห้องหนึ่งในอีกห้องหนึ่งได้ ขออภัย การกำหนดค่านี้ไม่เป็นไปตามข้อกำหนด RPO และ RTO ดังนั้นทีมไอทีจึงเริ่มตรวจสอบตัวเลือกอื่นๆ

ในการค้นหาโซลูชัน DR ที่เหมาะสม ทีมไอทีได้พิจารณา Windows Server Failover Clustering (WSFC) ซึ่งใช้พื้นที่จัดเก็บข้อมูลที่ใช้ร่วมกัน น่าเสียดายที่ ALYN ไม่มี SAN และเนื่องจากข้อจำกัดด้านงบประมาณ การนำ SAN ที่เหมือนกันไปใช้ในห้องเซิร์ฟเวอร์ทั้งสองจึงเป็นเรื่องต้องห้ามด้านต้นทุน ด้วยเหตุผลนี้ ALYN จึงตรวจสอบโซลูชันของบุคคลที่สาม

ในการค้นหาเฟลโอเวอร์ของบุคคลที่สาม ซอฟต์แวร์จัดกลุ่ม , ALYN กำหนดสามเกณฑ์:

  • โซลูชันต้องทำงานร่วมกับฮาร์ดแวร์ที่มีอยู่
  • โซลูชันต้องให้การปกป้องทั้งความพร้อมใช้งานสูง (HA) และการกู้คืนความเสียหาย (DR) ในทุกแอปพลิเคชันที่สำคัญของโรงพยาบาล
  • ต้นทุนรวมในการเป็นเจ้าของ (TCO) จะต้องพอดีกับงบประมาณที่จำกัดของแผนก

SIOS DataKeeper – ทางเลือกที่ชัดเจน

หลังจากประเมินโซลูชันต่างๆ มากมาย เจ้าหน้าที่ไอทีได้เลือก SIOS DataKeeper ซึ่งทีมงานอธิบายว่าเป็นโซลูชัน “ที่มอบความสามารถระดับผู้ให้บริการด้วยต้นทุนรวมในการเป็นเจ้าของที่ต่ำอย่างน่าทึ่ง” และนำเสนอ HA และ DR ในโซลูชันเดียวที่คุ้มค่า

SIOS DataKeeper รวมการจำลองข้อมูลแบบเรียลไทม์ระดับบล็อกเข้ากับการตรวจสอบระดับแอปพลิเคชันอย่างต่อเนื่องและนโยบายเฟลโอเวอร์/เฟลแบ็คที่ยืดหยุ่นในโซลูชันทั้งหมดที่ปรับใช้และจัดการได้ง่าย DataKeeper ใช้ประโยชน์จาก WSFC และรักษาความเข้ากันได้กับสภาพแวดล้อมการทำงาน ทำให้ทีมไอทีเรียนรู้วิธีใช้โซลูชันได้อย่างรวดเร็วและกำหนดค่า HA ให้เสร็จสิ้นอย่างรวดเร็วสำหรับแอปพลิเคชันทั้งหมดอย่างรวดเร็ว

ด้วย DataKeeper ทีมไอทีสามารถสร้างสามโหนด SANless คลัสเตอร์ล้มเหลว ด้วยอินสแตนซ์ที่ทำงานอยู่ตัวเดียวและอินสแตนซ์สแตนด์บายสองอินสแตนซ์ ด้วยการกำหนดค่านี้ ALYN สามารถอัปเดตระบบและซอฟต์แวร์ได้อย่างต่อเนื่องโดยไม่กระทบต่อการดำเนินการ เนื่องจากอินสแตนซ์ที่ใช้งานอยู่สามารถย้ายไปยังเซิร์ฟเวอร์ใดๆ ในคลัสเตอร์สามโหนดและยังคงได้รับการปกป้องอย่างเต็มที่ในช่วงระยะเวลาของการบำรุงรักษาฮาร์ดแวร์และซอฟต์แวร์ที่วางแผนไว้

นอกจากนี้ SIOS ยังสามารถทำงานกับพื้นที่จัดเก็บข้อมูลประเภทใดก็ได้และการจำลองข้อมูลที่ปรับให้เหมาะสม WAN ซึ่งทำให้การใช้งานไซต์ DR ระยะไกลของ ALYN ง่ายขึ้น เพื่อรักษาประสิทธิภาพการรับส่งข้อมูลในระดับสูง การจำลองข้อมูลทั่วทั้ง WAN จะเกิดขึ้นแบบอะซิงโครนัส แต่ SIOS DataKeeper ใช้เทคนิคพิเศษเพื่อเพิ่มประสิทธิภาพการรับส่งข้อมูล ทำให้ ALYN บรรลุ RPO และ RTO ที่มีความต้องการสูง

บรรทัดล่าง

วันนี้ SIOS DataKeeper ให้การป้องกันที่มีความพร้อมใช้งานสูงสำหรับแอปพลิเคชันที่มีความสำคัญต่อภารกิจทั้งหมดของ ALYN Hospital Uri Inbar ผู้อำนวยการฝ่ายไอทีของ ALYN Hospital กล่าวว่า “ด้วย SIOS เราพบโซลูชันที่มอบความสามารถระดับผู้ให้บริการด้วยต้นทุนรวมในการเป็นเจ้าของที่ต่ำอย่างน่าทึ่ง สำหรับเรา มันเป็นทางเลือกที่ชัดเจน

โรงพยาบาล ALYN จะทดสอบการกำหนดค่าเป็นประจำ และเปลี่ยนการกำหนดสถานะที่ใช้งานอยู่และสแตนด์บายเป็นประจำ ในขณะที่เปลี่ยนเส้นทางการจำลองข้อมูลตามความจำเป็นระหว่างการอัปเดตซอฟต์แวร์ที่วางแผนไว้ แอปพลิเคชันทำงานอย่างต่อเนื่องไม่ขาดตอน

—————————————————————————————————————————

ความคิดสุดท้ายเกี่ยวกับการกู้คืนภัยพิบัติ SIOS

ในสภาพแวดล้อม Windows SIOS DataKeeper สำหรับ Windows Server มีให้เลือกทั้งแบบ Standard Edition และ Cluster Edition ที่ทนทานกว่าSIOS DataKeeper Standard Edition ให้การจำลองข้อมูลแบบเรียลไทม์สำหรับการป้องกันการกู้คืนจากความเสียหายในสภาพแวดล้อมของ Windows ServerSIOS DataKeeper Cluster Edition ผสานรวมกับ Windows Server Failover Clustering (WSFC) ได้อย่างราบรื่น ทำให้สามารถกำหนดค่าความพร้อมใช้งานสูงและการกู้คืนจากความเสียหายได้

SIOS LifeKeeper และ DataKeeper รองรับการกระจาย Linux ที่สำคัญทั้งหมด รวมถึง Red Hat Enterprise Linux, SUSE Linux Enterprise Server, CentOS และ Oracle Linux และรองรับสถาปัตยกรรมการจัดเก็บข้อมูลที่หลากหลาย

เยี่ยมชมข้อมูลอ้างอิงด้านล่างสำหรับข้อมูลเพิ่มเติมเกี่ยวกับ SIOS DataKeeper หรือ SIOS LifeKeeper: อ้างอิง

  • https://betanews.com/2019/05/28/disaster-recovery-sql-server/
  • https://community.spiceworks.com/blog/3138-data-snapshot-how-well-equipped-are-businesses-to-bounce-back-from-disaster
  • https://www.spiceworks.com/press/releases/spiceworks-study-reveals-one-in-four-companies-never-test-their-disaster-recovery-plan/

ดูเอกสารไวท์เปเปอร์ของเรา: ทำความเข้าใจกับ Disaster Recovery สำหรับตัวเลือกสำหรับ SQL Server

ทำซ้ำโดยได้รับอนุญาตจาก SIOS

Filed Under: ทำให้เข้าใจง่ายเซิร์ฟเวอร์คลัสเตอร์ Tagged With: SIOS

การกู้คืนจากภัยพิบัติแบบมัลติคลาวด์

ตุลาคม 30, 2021 by Jason Aw Leave a Comment

การกู้คืนจากภัยพิบัติแบบมัลติคลาวด์

การกู้คืนจากภัยพิบัติแบบมัลติคลาวด์


หากหัวข้อนี้ฟังดูสับสน เราเข้าใจ ด้วยคำแนะนำจากผู้เชี่ยวชาญของเรา เราหวังว่าจะบรรเทาความหวาดระแวงของคุณ – ในขณะเดียวกันก็เพิ่มข้อพิจารณาที่สำคัญบางประการสำหรับองค์กรของคุณก่อนหรือหลัง กำลังไป มัลติคลาวด์ . การวางแผนสำหรับการกู้คืนจากภัยพิบัติเป็นจุดทั่วไปของความสับสนสำหรับบริษัทต่างๆ ที่ใช้การประมวลผลแบบคลาวด์ โดยเฉพาะอย่างยิ่งเมื่อเกี่ยวข้องกับผู้ให้บริการระบบคลาวด์หลายราย

การเก็บภาษีเพียงพอในการปกป้องข้อมูลและ การกู้คืนระบบ (DR) เมื่อข้อมูลทั้งหมดอยู่ในองค์กร แต่ทุกวันนี้บริษัทหลายแห่งมีข้อมูลภายในองค์กรเช่นเดียวกับผู้ให้บริการระบบคลาวด์หลายราย ซึ่งเป็นกลยุทธ์แบบไฮบริดที่อาจเหมาะสมทางธุรกิจ แต่สามารถสร้างความท้าทายให้กับผู้ที่ได้รับมอบหมายให้ปกป้องข้อมูลได้ ก่อนที่เราจะเจาะลึกรายละเอียด มากำหนดเงื่อนไขสำคัญกันก่อน

มัลติคลาวด์คืออะไร?

Multi-cloud คือการใช้ผู้ให้บริการระบบคลาวด์ตั้งแต่สองรายขึ้นไปเพื่อให้บริการด้านไอทีและโครงสร้างพื้นฐานขององค์กร โดยทั่วไป วิธีการแบบมัลติคลาวด์ประกอบด้วยผู้ให้บริการคลาวด์สาธารณะรายใหญ่ร่วมกัน ได้แก่ Amazon Web Services (AWS), Google Cloud Platform (GCP) และ Microsoft Azure

องค์กรเลือกบริการที่ดีที่สุดจากผู้ให้บริการระบบคลาวด์แต่ละรายโดยพิจารณาจากต้นทุน ข้อกำหนดทางเทคนิค ความพร้อมใช้งานทางภูมิศาสตร์ และปัจจัยอื่นๆ ซึ่งอาจหมายความว่าบริษัทใช้ Google Cloud สำหรับการพัฒนา/ทดสอบ ในขณะที่ใช้ AWS สำหรับการกู้คืนจากความเสียหาย และใช้ Microsoft Azure เพื่อประมวลผลข้อมูลการวิเคราะห์ธุรกิจ

Multi-cloud แตกต่างจากไฮบริดคลาวด์ซึ่งหมายถึงสภาพแวดล้อมการประมวลผลที่ผสมผสานโครงสร้างพื้นฐานในสถานที่ บริการคลาวด์ส่วนตัว และระบบคลาวด์สาธารณะ

ใครใช้หลายเมฆ?

  • อุตสาหกรรมที่มีการควบคุม – หลายองค์กรดำเนินธุรกิจที่แตกต่างกันในสภาพแวดล้อมคลาวด์ที่แตกต่างกัน นี่อาจเป็นกลยุทธ์โดยเจตนาในการปรับสภาพแวดล้อมไอทีให้เหมาะสมโดยพิจารณาจากจุดแข็งของผู้ให้บริการคลาวด์แต่ละรายหรือเพียงแค่ผลิตภัณฑ์ขององค์กรไอทีที่กระจายอำนาจ
  • สื่อและความบันเทิง – วงการสื่อและความบันเทิงในปัจจุบันประกอบด้วยสตูดิโอที่ค่อนข้างเล็กและเชี่ยวชาญมากขึ้นเรื่อยๆ ซึ่งตอบสนองความต้องการด้านการผลิตเนื้อหาที่เพิ่มสูงขึ้นของผู้เล่นรายใหญ่ที่สุด เช่น Netflix และ Hulu โซลูชันมัลติคลาวด์ช่วยให้ทีมเหล่านี้ทำงานร่วมกันในโครงการเดียวกัน เข้าถึงเครื่องมือการผลิตที่ต้องการจากคลาวด์สาธารณะต่างๆ และปรับปรุงการอนุมัติโดยไม่ชักช้าที่เกี่ยวข้องกับการย้ายไฟล์สื่อขนาดใหญ่จากไซต์หนึ่งไปยังอีกไซต์หนึ่ง
  • การขนส่งและการขับขี่อัตโนมัติ – โครงการรถยนต์ที่เชื่อมต่อและขับขี่อัตโนมัติสร้างข้อมูลจำนวนมหาศาลจากเซ็นเซอร์ที่หลากหลาย ผู้ผลิตรถยนต์ หน่วยงานการขนส่งสาธารณะ และบริษัทแชร์รถร่วมโดยสารต่างมีแรงจูงใจที่จะใช้ประโยชน์จากนวัตกรรมมัลติคลาวด์ โดยผสมผสานทั้งการเข้าถึงข้อมูลบนคลาวด์หลายตัวโดยปราศจากความเสี่ยงจากค่าใช้จ่ายด้านขาออกจำนวนมากและการถ่ายโอนที่ช้า ในขณะที่ยังคงเสรีภาพในการใช้ประโยชน์จากสิ่งที่ดีที่สุด บริการคลาวด์สาธารณะสำหรับแต่ละโครงการ
  • ภาคพลังงาน – การใช้มัลติคลาวด์สามารถช่วยลดต้นทุนที่สำคัญที่เกี่ยวข้องกับการค้นหาและเจาะลึกทรัพยากรวิศวกรและนักวิทยาศาสตร์ด้านข้อมูลสามารถใช้การวิเคราะห์แมชชีนเลิร์นนิง (ML) เพื่อระบุสถานที่ที่สมควรได้รับทรัพยากรมากขึ้นในการสำรวจน้ำมัน เพื่อวัดความเสี่ยงด้านสิ่งแวดล้อมของโครงการใหม่ และเพื่อปรับปรุงความปลอดภัย

จุดปวดการกู้คืนความเสียหายแบบมัลติคลาวด์:

  • ไม่อ่านก่อนเซ็นลูกค้าอาจประสบปัญหาหากพวกเขาไม่สามารถอ่านการพิมพ์แบบละเอียดในข้อตกลงระบบคลาวด์ของตนได้ ผู้ให้บริการระบบคลาวด์มีหน้าที่รับผิดชอบโครงสร้างพื้นฐานของคอมพิวเตอร์ แต่ลูกค้ามีหน้าที่ปกป้องแอปพลิเคชันและข้อมูลของตน มีหลายสาเหตุที่ทำให้แอปพลิเคชันหยุดทำงานซึ่งไม่ครอบคลุมภายใต้ SLA ของระบบคลาวด์ ปริมาณงานที่สำคัญทางธุรกิจต้องการความพร้อมใช้งานสูงและซอฟต์แวร์ป้องกันการกู้คืนจากความเสียหายด้วย
  • การพัฒนานโยบายการป้องกันแบบรวมศูนย์ต้องสร้างนโยบายการป้องกันแบบรวมศูนย์เพื่อให้ครอบคลุมข้อมูลทั้งหมดไม่ว่าจะอยู่ที่ใด ผู้ให้บริการระบบคลาวด์แต่ละรายมีวิธีการเข้าถึง สร้าง ย้าย และจัดเก็บข้อมูลที่เป็นเอกลักษณ์ด้วยระดับการจัดเก็บข้อมูลที่แตกต่างกัน อาจเป็นเรื่องยุ่งยากในการสร้างแผนกู้คืนระบบที่ครอบคลุมข้อมูลข้ามระบบคลาวด์ต่างๆ
  • การรายงานนี่เป็นสิ่งสำคัญสำหรับการรับรองการปกป้องข้อมูลตามข้อตกลงระดับบริการที่ควบคุม เมื่อพิจารณาว่าผู้ใช้สามารถหมุนทรัพยากรบนคลาวด์ได้เร็วเพียงใด การตรวจสอบให้แน่ใจว่าคุณปกป้องทรัพยากรแต่ละอย่างอย่างเหมาะสมและระบุข้อมูลทั้งหมดที่จำเป็นต้องรวมเข้ากับแผน DR ของคุณอาจเป็นเรื่องยาก
  • ทดสอบแผน DR ของคุณลูกค้าต้องคัดกรองและทดสอบกลยุทธ์ DR ของตนอย่างเต็มที่ กลยุทธ์มัลติคลาวด์รวมความจำเป็นในการทดสอบ ผู้ให้บริการบางรายอาจเรียกเก็บเงินจากลูกค้าสำหรับการทดสอบ ซึ่งตอกย้ำความจำเป็นในการอ่านรายละเอียดสัญญา
  • ชุดทักษะทรัพยากร . การหาผู้เชี่ยวชาญในระบบคลาวด์เดียวอาจเป็นเรื่องที่ท้าทาย ด้วยมัลติคลาวด์ คุณจะต้องค้นหาความเชี่ยวชาญในแต่ละคลาวด์ หรือเฉพาะบุคคลหายากที่มีนัยสำคัญในหลายคลาวด์

เอาชนะความท้าทาย DR แบบมัลติคลาวด์

การรับมือกับความท้าทายเหล่านี้ทำให้บริษัทต่างๆ ต้องพัฒนากลยุทธ์การปกป้องข้อมูลและการกู้คืนข้อมูลที่ครอบคลุมประเด็นต่างๆ มากมาย ลองถามตัวเองด้วยคำถามเชิงกลยุทธ์ต่อไปนี้:

  • คุณได้กำหนดระดับวิกฤตสำหรับแอปพลิเคชันและข้อมูลทั้งหมดหรือไม่ การหยุดทำงานไม่กี่นาทีสำหรับแอปพลิเคชันที่สำคัญจะทำให้องค์กรของคุณสูญเสียประสิทธิภาพการทำงานของผู้ใช้ปลายทาง ความพึงพอใจของลูกค้า และแรงงานด้านไอทีเป็นจำนวนเงินเท่าใด
  • การปกป้องและกู้คืนข้อมูลจะได้รับการจัดการโดยเจ้าของและผู้สร้างแอปพลิเคชันและไอทีหรือแอปพลิเคชันในรูปแบบบริการตนเองหรือไม่
  • คุณวางแผนสำหรับการเพิ่มประสิทธิภาพข้อมูลโดยใช้ตัวเลือกต่างๆ ในระบบคลาวด์และในองค์กรหรือไม่
  • คุณวางแผนที่จะกู้คืนข้อมูลอย่างไร? การกู้คืนข้อมูลไปยังเครื่องเสมือนบนคลาวด์หรือใช้อิมเมจสำรองเป็นแหล่งที่มาของการกู้คืน?

รับโซลูชัน DR แบบมัลติคลาวด์ที่เหมาะสม

กุญแจสู่ความสำเร็จในการปกป้องและกู้คืนข้อมูลในสถานการณ์มัลติคลาวด์ที่ใหญ่ที่สุดคือทำให้แน่ใจว่าคุณสามารถมองเห็นข้อมูลทั้งหมดของคุณได้ ไม่ว่าจะจัดเก็บอย่างไร เครื่องมือจากบริษัทต่างๆ ช่วยให้คุณกำหนดได้ว่าข้อมูลและแอปพลิเคชันใดควรกู้คืนในสถานการณ์ภัยพิบัติและต้องทำอย่างไร ไม่ว่าจะเป็นจากอิมเมจสำรองหรือโดยการย้ายข้อมูลไปยัง VM ที่สร้างขึ้นใหม่ในระบบคลาวด์ เป็นต้น

เครื่องมือนี้จะช่วยคุณในการเตรียมสถานการณ์การกู้คืน และที่สำคัญคือ ทดสอบมัน หากเครื่องมือนี้รวมเข้ากับเครื่องมือสำรองข้อมูลของคุณเป็นอย่างดี เครื่องมือนี้ยังช่วยให้คุณใช้ข้อมูลสำรองเป็นแหล่งข้อมูลการกู้คืนได้ แม้ว่าข้อมูลจะถูกจัดเก็บไว้ในที่ต่างๆ เช่น คลาวด์หลายเครื่อง การสัมมนาผ่านเว็บ SIOS ล่าสุดของเรากล่าวถึงประเด็นเดียวกันนี้ นาฬิกา ที่นี่ หากคุณสนใจSIOS Datakeeper ให้คุณเรียกใช้แอปพลิเคชันที่มีความสำคัญต่อธุรกิจของคุณในสภาพแวดล้อมคลาวด์ที่ยืดหยุ่นและปรับขนาดได้ เช่น Amazon Web Services (AWS) , Azure , และ Google Cloud Platform โดยไม่สูญเสียประสิทธิภาพ ความพร้อมใช้งานสูง หรือการป้องกันภัยพิบัติ SIOS DataKeeper มีอยู่ใน AWS Marketplace และซอฟต์แวร์ความพร้อมใช้งานสูงที่ได้รับการรับรองจาก Azure เพียงตัวเดียวสำหรับ WSFC ที่นำเสนอใน ตลาด Azure


สืบพันธุ์จาก SIOS

Filed Under: ทำให้เข้าใจง่ายเซิร์ฟเวอร์คลัสเตอร์ Tagged With: Google Cloud Platform, หลายเมฆ

ความพร้อมใช้งานสูงและคลาวด์: ยิ่งคุณรู้มากขึ้น

ตุลาคม 25, 2021 by Jason Aw Leave a Comment

ความพร้อมใช้งานสูงและคลาวด์

ความพร้อมใช้งานสูงและคลาวด์: ยิ่งคุณรู้มากขึ้น

ขณะค้นหาเหตุผลในการโยกย้ายไปยังระบบคลาวด์ คุณอาจได้เรียนรู้ว่าประโยชน์ของการประมวลผลแบบคลาวด์ ได้แก่ ความสามารถในการปรับขนาด ความน่าเชื่อถือ ความพร้อมใช้งาน และอื่นๆ แต่คำเหล่านั้นหมายถึงอะไรกันแน่? ลองพิจารณาความพร้อมใช้งานสูง (HA) เนื่องจากมักจะเป็นเป้าหมายสูงสุดในการย้ายไปยังระบบคลาวด์สำหรับหลายบริษัท

แนวคิดคือการทำให้ผลิตภัณฑ์ บริการ และเครื่องมือของคุณสามารถเข้าถึงลูกค้าและพนักงานของคุณได้ตลอดเวลาจากทุกที่โดยใช้อุปกรณ์ใดก็ได้ที่มีการเชื่อมต่ออินเทอร์เน็ต นั่นหมายถึงการทำให้แน่ใจว่าแอปพลิเคชันที่สำคัญของคุณทำงานได้ – แม้ผ่านความล้มเหลวของฮาร์ดแวร์ ปัญหาซอฟต์แวร์ ข้อผิดพลาดของมนุษย์ และภัยพิบัติทั่วทั้งไซต์ – อย่างน้อย 99.99% ของเวลา (นั่นคือคำจำกัดความของความพร้อมใช้งานสูง)

แม้ว่าโดยทั่วไปแล้วผู้ให้บริการระบบคลาวด์สาธารณะจะรับประกันความพร้อมใช้งานบางระดับในข้อตกลงระดับบริการ แต่ SLA เหล่านั้นจะมีผลกับฮาร์ดแวร์ระบบคลาวด์เท่านั้น มีเหตุผลหลายประการสำหรับการหยุดทำงานของแอปพลิเคชันซึ่งไม่ครอบคลุมอยู่ใน SLA ด้วยเหตุนี้ คุณจึงต้องปกป้องแอปพลิเคชันเหล่านี้ด้วยซอฟต์แวร์การทำคลัสเตอร์ที่จะตรวจจับปัญหาและย้ายการดำเนินการไปยังเซิร์ฟเวอร์สำรองหากจำเป็น เมื่อคุณวางแผนว่าจะทำอะไรและอย่างไรที่จะทำให้โซลูชันพร้อมใช้งานในระบบคลาวด์ โปรดจำไว้ว่าผลิตภัณฑ์และบริการและโครงสร้างพื้นฐานระบบคลาวด์ของคุณต้องสามารถปรับขนาดได้ เชื่อถือได้ และพร้อมใช้งานเมื่อใดและที่ที่ต้องการ

สถิติด่วนเกี่ยวกับความพร้อมใช้งานสูงในระบบคลาวด์ในปี 2021

ตอนนี้เราได้กำหนดความพร้อมใช้งานในบริบทของระบบคลาวด์แล้ว มาดูผลกระทบต่อองค์กรและธุรกิจกัน PSA สถิติเหล่านี้อาจทำให้คุณตกใจ แต่อย่ากังวล นอกจากนี้เรายังมีวิธีแก้ปัญหาบางอย่างสำหรับปัญหาเร่งด่วนและค่าใช้จ่ายสูงเหล่านี้

  1. มากถึง 80% ของ Enterprise IT จะย้ายไปยังคลาวด์ภายในปี 2025 (Oracle)
  2. ค่าใช้จ่ายเฉลี่ยของการหยุดทำงานของไอทีอยู่ระหว่าง 5,600 ถึง 11,600 ดอลลาร์ต่อนาที (Gartner; Comparitech)
  3. อัตราส่วนพนักงานไอทีโดยเฉลี่ยต่อพนักงานคือ 1:27 (Ecityworks)
  4. 22% ของการหยุดทำงานเป็นผลมาจากความผิดพลาดของมนุษย์ (Cloudscene)
  5. ในปี 2020 แอปพลิเคชันบนคลาวด์ขององค์กร 54% ได้ย้ายจากสภาพแวดล้อมภายในองค์กรไปยังคลาวด์ ในขณะที่ 46% สร้างขึ้นตามวัตถุประสงค์สำหรับคลาวด์ (Forbes)
  6. บริษัท 1 ใน 5 แห่งไม่มีแผนกู้คืนระบบ (HBJ)
  7. 70% ของบริษัทต่างๆ ประสบกับการละเมิดข้อมูลบนคลาวด์สาธารณะในปีที่ผ่านมา (HIPAA)
  8. 48% ของธุรกิจเก็บข้อมูลลับบนคลาวด์ (Panda Security)
  9. 96% ของธุรกิจประสบปัญหาการหยุดชะงักในระยะเวลา 3 ปี (Comparitech)
  10. 45% ของบริษัทรายงานการหยุดทำงานจากความล้มเหลวของฮาร์ดแวร์ (PhoenixNAP)

สิ่งที่คุณสามารถทำได้ – รับทราบข้อมูล

หากคุณสนใจที่จะเรียนรู้พื้นฐานของความพร้อมใช้งานในระบบคลาวด์หรือฟังเกี่ยวกับการพัฒนาล่าสุดในการป้องกันแอปพลิเคชันและฐานข้อมูล เข้าร่วมกับเรา SIOS Cloud Availability Symposium กำลังจะเกิดขึ้น วันพุธที่ 22 กันยายน (EMEA) และวันพฤหัสบดีที่ 23 กันยายน (เรา) ในรูปแบบการประชุมเสมือนจริงระดับโลกสำหรับมืออาชีพด้านไอทีโดยมุ่งเน้นที่ความต้องการความพร้อมของลูกค้าไอทีระดับองค์กร เหตุการณ์นี้จะให้ข้อมูลที่คุณต้องการเกี่ยวกับการทำคลัสเตอร์ที่มีความพร้อมใช้งานสูง การกู้คืนจากภัยพิบัติ และการปกป้องแอปพลิเคชันของคุณทั้งในปัจจุบันและอนาคต

ผู้บรรยายและเซสชัน Cloud Symposium โพสต์แล้ว

เราได้เลือกวิทยากรที่นำเสนอเซสชันที่หลากหลายซึ่งสนับสนุนความพร้อมใช้งานในหลายพื้นที่ของสแต็กแอปพลิเคชันข้อมูล ตรวจสอบเซสชั่นที่โพสต์และกลับมาตรวจสอบอีกครั้งสำหรับการนำเสนอเพิ่มเติมที่จะประกาศ!เรียนรู้เพิ่มเติม

สมัครตอนนี้

ไม่ว่าคุณจะสนใจที่จะเรียนรู้พื้นฐานของความพร้อมใช้งานในระบบคลาวด์หรือได้ยินเกี่ยวกับการพัฒนาล่าสุดในการป้องกันแอปพลิเคชันและฐานข้อมูล เหตุการณ์นี้จะให้ข้อมูลที่คุณต้องการเกี่ยวกับคลัสเตอร์ที่มีความพร้อมใช้งานสูงของแอปพลิเคชัน การกู้คืนจากภัยพิบัติ และการปกป้องแอปพลิเคชันของคุณในขณะนี้และเข้าสู่ อนาคต.

สมัครตอนนี้ สำหรับ SIOS Cloud Availability Symposium

สืบพันธุ์จาก SIOS

Filed Under: ทำให้เข้าใจง่ายเซิร์ฟเวอร์คลัสเตอร์

  • « Previous Page
  • 1
  • …
  • 57
  • 58
  • 59
  • 60
  • 61
  • …
  • 112
  • Next Page »

โพสต์ล่าสุด

  • ระบบความพร้อมใช้งานสูง (High Availability หรือ HA) คืออะไร?
  • เอาตัวรอดจากวิกฤตการณ์วันศุกร์: จากระบบคอมพิวเตอร์แบบดิบๆ สู่การจำลองข้อมูลที่ราบรื่น
  • ติดดิน: สิ่งที่การพลาดชม Percona Live Amsterdam สอนฉันเกี่ยวกับ HA
  • เปรียบเทียบ SIOS LifeKeeper กับ Red Hat High Availability Add-On:
  • สถานะของความยืดหยุ่นของแอปพลิเคชัน: ผลสำรวจความพร้อมใช้งานสูงของ SIOS ปี 2026

กระทู้ยอดนิยม

เข้าร่วมรายชื่อผู้รับจดหมายของเรา

Copyright © 2026 · Enterprise Pro Theme on Genesis Framework · WordPress · Log in