SIOS SANless clusters

SIOS SANless clusters High-availability Machine Learning monitoring

  • Home
  • Products
    • SIOS DataKeeper for Windows
    • SIOS Protection Suite for Linux
  • การทดสอบอาหารสัตว์
  • ข่าวสารและกิจกรรม
  • ทำให้เข้าใจง่ายเซิร์ฟเวอร์คลัสเตอร์
  • เรื่องราวความสำเร็จ
  • ติดต่อเรา
  • English
  • 中文 (中国)
  • 中文 (台灣)
  • 한국어
  • Bahasa Indonesia
  • ไทย

หกเหตุผลที่การย้ายระบบคลาวด์ของคุณหยุดทำงาน

ธันวาคม 22, 2020 by Jason Aw Leave a Comment

หกเหตุผลที่การย้ายระบบคลาวด์ของคุณหยุดชะงัก


หกเหตุผลที่การย้ายระบบคลาวด์ของคุณหยุดทำงาน

ลูกค้าจำนวนมากขึ้นเรื่อย ๆ ที่ต้องการใช้ประโยชน์จากความยืดหยุ่นความสามารถในการปรับขนาดและประสิทธิภาพของระบบคลาวด์ เนื่องจากจำนวนแอปพลิเคชันโซลูชันลูกค้าและคู่ค้าที่มีการเปลี่ยนแปลงเพิ่มขึ้นตรวจสอบให้แน่ใจว่าการย้ายข้อมูลของคุณไม่หยุดชะงัก

หลีกเลี่ยงหกเหตุผลต่อไปนี้ Cloud Migrations Stall

1. แผนโครงการการย้ายระบบคลาวด์ไม่สมบูรณ์

การวางแผนโครงการถือเป็นปัจจัยสำคัญที่นำไปสู่ความสำเร็จของโครงการ การวางแผนมีบทบาทสำคัญในการช่วยชี้แนะผู้มีส่วนได้ส่วนเสียทีมดำเนินการที่หลากหลายและพันธมิตรผ่านขั้นตอนของโครงการ การวางแผนช่วยระบุเป้าหมายที่ต้องการจัดทรัพยากรและทีมให้สอดคล้องกับเป้าหมายเหล่านั้นลดความเสี่ยงหลีกเลี่ยงการพลาดกำหนดเวลาและส่งมอบโซลูชันที่พร้อมใช้งานสูงในระบบคลาวด์ในที่สุดแผนการที่ไม่สมบูรณ์และการวางแผนที่ไม่สมบูรณ์มักเป็นสาเหตุใหญ่ที่ทำให้โครงการหยุดชะงักในชั่วโมงที่เก้าจะมีการระบุการพึ่งพาที่สำคัญ ในระหว่างที่เซิร์ฟเวอร์รีบูตโดยไม่คาดคิดจะมีการตรวจสอบแอ็พพลิเคชันและรูโหว่ HA (ดูด้านล่าง) ตรวจสอบให้แน่ใจว่าการย้ายระบบคลาวด์ของคุณมีแผนและดำเนินการตามแผน

2. วิศวกรรมนอกสถานที่

“ นี่คือวิธีที่เราทำในโหนดในองค์กรของเรา” เป็นวลีที่เริ่มต้นการสนทนากับลูกค้าล่าสุด ลูกค้ามีส่วนร่วมกับ Edmond Melkomian ผู้จัดการโครงการของ SIOS Professional Services เมื่อความพยายามที่จะย้ายไปยังระบบคลาวด์หยุดชะงักในระหว่างเซสชันการค้นพบ Edmond สามารถค้นพบไอเท็มที่ได้รับการออกแบบมาเป็นจำนวนมากซึ่งเกี่ยวข้องกับสถาปัตยกรรมภายในองค์กรและระบบคลาวด์ สำหรับบางโครงการการทำซ้ำสิ่งที่ทำในสถานที่อาจเป็นประวัติย่อสำหรับการขยายตัวความซับซ้อนและความล่าช้า วิเคราะห์สถาปัตยกรรมและแผนการย้ายข้อมูลของคุณและกำจัดส่วนประกอบและการออกแบบที่ออกแบบมากเกินไปโดยเฉพาะอย่างยิ่งกับระบบเครือข่ายและพื้นที่จัดเก็บข้อมูล

3. อยู่ระหว่างการจัดเตรียม

การควบคุมค่าใช้จ่ายและการป้องกันการแผ่กิ่งก้านสาขาเป็นสิ่งสำคัญและมีความสำคัญอย่างยิ่งในการย้ายระบบคลาวด์อย่างไรก็ตามลูกค้าบางรายกังวลเกี่ยวกับค่าบริการต่อชั่วโมงและค่าใช้จ่ายที่เกี่ยวข้องสำหรับดิสก์และแบนด์วิดท์ตกอยู่ในกับดักของการจัดเตรียมที่ไม่เพียงพอในกับดักนี้ทรัพยากรมีขนาดที่ไม่เหมาะสมเช่นดิสก์ที่มีลักษณะความเร็วที่ไม่ถูกต้องคำนวณทรัพยากรด้วย CPU หรือหน่วยความจำที่ไม่ถูกต้องหรือคลัสเตอร์ที่มีจำนวนโหนดไม่ถูกต้องในกรณีที่อยู่ภายใต้การจัดเตรียมเช่นนี้ปัญหาจะเกิดขึ้นเมื่อการทดสอบการยอมรับของผู้ใช้ (UAT) เริ่มต้นขึ้นและปริมาณงานที่คาดหวัง / ที่คาดการณ์ไว้จะทำให้เกิดการติดขัดของบันทึกในทรัพยากรที่มีขนาดเล็กหรือการเพิ่มประสิทธิภาพต้นทุนของโหนดเป้าหมายไม่สามารถจัดการทรัพยากรได้อย่างถูกต้องในสถานการณ์ล้มเหลว แม้ว่าการปรับขนาดเครื่องเสมือนในระบบคลาวด์เป็นกระบวนการที่เรียบง่าย แต่ปัญหาการปรับขนาดเหล่านี้มักสร้างความล่าช้าในขณะที่สถาปนิกและหัวหน้าเจ้าหน้าที่การเงินพยายามทำความเข้าใจผลกระทบของการจัดเตรียมทรัพยากรซ้ำ

4. กระบวนการไอทีภายใน

บริษัท ระดับองค์กรที่ยิ่งใหญ่ทุกแห่งมีชุดกระบวนการภายในและโอกาสที่ทีมและ บริษัท ของคุณจะไม่มีข้อยกเว้นโดยทั่วไปกระบวนการไอทีเป็นสิ่งสำคัญในกระบวนการที่อาจมีผลกระทบอย่างมากต่อความสำเร็จของกลยุทธ์การย้ายระบบคลาวด์ของคุณ ในอดีตหลาย บริษัท มีการขอใบเสนอราคาและกระบวนการซื้อกิจการที่ยาวนานรวมถึงการเสนอราคาคำแนะนำการปรับขนาดการอนุมัติคำสั่งการเตรียมเซิร์ฟเวอร์และการกำหนดค่าและการปรับใช้ขั้นสุดท้ายกระบวนการระบบคลาวด์ได้เปลี่ยนแปลงวิธีการประมวลผลการจัดเก็บข้อมูลและทรัพยากรเครือข่ายอย่างมากอย่างไรก็ตามหากกระบวนการของคุณไม่ทันกับความเร็วของระบบคลาวด์การย้ายข้อมูลของคุณอาจประสบปัญหาเมื่อแผนการเปลี่ยนแปลง

5. การวางแผนความพร้อมใช้งานสูงไม่ดี

อีกเหตุผลหนึ่งที่การย้ายข้อมูลบนคลาวด์สามารถหยุดชะงักได้คือการวางแผนความพร้อมใช้งานสูง ความพร้อมใช้งานสูงต้องการมากกว่าชุดเครื่องมือหรือใบอนุญาตระดับองค์กรHA ต้องมีการออกแบบระบบที่รอบคอบละเอียดถี่ถ้วนและรอบคอบเมื่อปรับใช้โซลูชัน HA แผนของคุณจะต้องพิจารณาความจุความซ้ำซ้อนและข้อกำหนดสำหรับการกู้คืนและการแก้ไข ด้วยแผนข้อกำหนดจะได้รับการระบุอย่างเหมาะสมเสนอแนวทางแก้ไขความเสี่ยงที่พิจารณาและการอ้างอิงสำหรับการปรับใช้และการตรวจสอบความถูกจัดการ หากไม่มีแผนโครงการและการปรับใช้จะเสี่ยงต่อความเสี่ยงปัญหาความล้มเหลวจุดเดียวความพอดีที่ไม่ดีและเลเยอร์และระดับการป้องกันแอปพลิเคชันหรือกลยุทธ์การกู้คืนที่ขาดหายไปบ่อยครั้งเมื่อขาดการวางแผน HA โครงการจะหยุดชะงักในขณะที่ข้อกำหนดจะถูกแยกออก

6. การทดสอบไม่สมบูรณ์หรือไม่ถูกต้อง

รอนหุ้นส่วนที่ย้ายลูกค้าปลายทางไปยังระบบคลาวด์วางแผนที่จะเริ่มใช้งานจริงในช่วงสุดสัปดาห์สามวันที่กำลังจะมาถึง จุดตัดสินใจสุดท้ายสำหรับ "go / no-go" คือชุดการทดสอบการยอมรับของผู้ใช้บนเซิร์ฟเวอร์การจัดเตรียมการทดสอบครั้งแรกล้มเหลวเพื่อชดเชยเวลาที่เสียไปเนื่องจากอุปสรรคในการย้ายข้อมูลอื่น ๆ Ron และทีมงานได้ข้ามกรณีทดสอบหลายกรณีที่เกี่ยวข้องกับการรวมชุดสุดท้ายของความปลอดภัยและซอฟต์แวร์สำรองข้อมูลบนระบบปฏิบัติการล่าสุดพร้อมกับแพตช์ที่รองรับ การโหลดแบบจำลองซึ่งเป็นครั้งแรกในเซิร์ฟเวอร์ที่สร้างใหม่ทำให้เกิดปัญหาต่างๆภายในสถาปัตยกรรมของ Ron ซึ่งรวมถึงข้อบกพร่องของเคอร์เนลปัญหาการจัดเตรียม CPU และหน่วยความจำและปัญหารูปแบบพื้นที่จัดเก็บและความจุ โครงการล่าช้ากว่าสี่สัปดาห์เพื่อตอบสนองความเชื่อมั่นของลูกค้าการทดสอบและการตรวจสอบที่เหมาะสมการปรับขนาดและสถาปัตยกรรมและใช้ซอฟต์แวร์และการแก้ไขระบบปฏิบัติการ

คำสัญญาของระบบคลาวด์นั้นน่าดึงดูดใจและการย้ายระบบคลาวด์ที่วางแผนไว้อย่างดีจะทำให้คุณและทีมของคุณใช้ประโยชน์จากผลประโยชน์เหล่านี้ได้ ไม่ว่าคุณจะเริ่มต้นหรืออยู่ระหว่างการย้ายข้อมูลบนคลาวด์เราหวังว่าบทความนี้จะช่วยให้คุณตระหนักถึงข้อผิดพลาดที่พบบ่อยมากขึ้นเพื่อให้คุณสามารถหลีกเลี่ยงได้

– Cassius Rhue รองประธานฝ่ายประสบการณ์ลูกค้า


ผลิตซ้ำจาก SIOS
Filed Under: ทำให้เข้าใจง่ายเซิร์ฟเวอร์คลัสเตอร์

การคำนวณความพร้อมใช้งานของแอปพลิเคชันในคลาวด์

ธันวาคม 18, 2020 by Jason Aw Leave a Comment

การคำนวณความพร้อมใช้งานของแอปพลิเคชันในคลาวด์

การคำนวณความพร้อมใช้งานของแอปพลิเคชันในคลาวด์

เมื่อปรับใช้แอปพลิเคชันที่สำคัญทางธุรกิจในระบบคลาวด์คุณต้องแน่ใจว่าแอปพลิเคชันเหล่านี้พร้อมใช้งานสูง ข่าวดีก็คือหากคุณวางแผนอย่างถูกต้องคุณจะมีความพร้อมใช้งาน 99.99% (4-nines) หรือมากกว่านั้น อย่างไรก็ตามการคำนวณความพร้อมใช้งานที่แท้จริงของคุณอาจไม่ตรงไปตรงมาอย่างที่คิด

เมื่อพิจารณาถึงความพร้อมใช้งานคุณต้องพิจารณาองค์ประกอบหลักที่ทำให้การเข้าถึงแอปพลิเคชันของคุณเป็นไปได้ซึ่งฉันจะเรียกว่าโซ่ความพร้อมใช้งาน ส่วนประกอบของห่วงโซ่ความพร้อมใช้งาน ได้แก่ :

  • คำนวณ
  • เครือข่าย
  • การจัดเก็บ
  • ใบสมัคร
  • บริการตามความต้องการ

แอปพลิเคชันของคุณจะพร้อมใช้งานเป็นลิงก์ที่อ่อนแอที่สุดเท่านั้นและการหยุดทำงานของคุณจะเพิ่มขึ้นเป็นทวีคูณด้วยลิงก์เพิ่มเติมแต่ละลิงก์ที่คุณเพิ่มลงในเครือข่ายลองตรวจสอบแต่ละลิงก์

ความพร้อมในการคำนวณ

ผู้ให้บริการคลาวด์รายใหญ่สามรายแต่ละรายมีความคล้ายคลึงกันบางประการ สิ่งหนึ่งที่เหมือนกันในทั้งสามแพลตฟอร์มคือข้อตกลงระดับบริการ (SLA) ที่พวกเขาจะยอมรับในการคำนวณ

SLA สำหรับผู้ให้บริการระบบคลาวด์สาธารณะทั้งสามสำหรับ VM เมื่อคุณมี VM สองรายการขึ้นไปที่กำหนดค่าในโซนความพร้อมใช้งานที่แตกต่างกันคือ 99.99%โปรดทราบว่า SLA นี้รับประกันเฉพาะการเข้าถึงระยะไกลของหนึ่งใน VMs ในช่วงเวลาใดเวลาหนึ่งโดยไม่มีสัญญาเกี่ยวกับความพร้อมใช้งานของบริการหรือแอปพลิเคชันที่ทำงานอยู่ภายใน VMหากคุณปรับใช้ VM เดียวภายในศูนย์ข้อมูลเดียว SLA นี้จะแตกต่างกันไปตั้งแต่“ 90% ของแต่ละชั่วโมง” (AWS) ถึง 99.5% (Azure และ GCP) หรือ 99.9% (Azure single VM เมื่อใช้ Premium SSD)

ความพร้อมใช้งานสูงอย่างแท้จริงเริ่มต้นที่ 99.99% ดังนั้นขั้นตอนแรกคือการตรวจสอบให้แน่ใจว่าแอปพลิเคชันของคุณพร้อมใช้งานคือตรวจสอบให้แน่ใจว่าแอปพลิเคชันได้รับการแจกจ่ายไปยัง VM สองเครื่องหรือมากกว่าซึ่งครอบคลุมโซนความพร้อม ด้วย VM สองตัวที่กระจายอยู่ในโซนความพร้อมใช้งานสองโซนทำให้คุณมี VM อย่างน้อยหนึ่งตัวที่พร้อมใช้งาน 99.99% คุณสามารถตั้งทฤษฎีได้ว่าหากคุณมี VM สามเครื่องที่กระจายอยู่ในโซนความพร้อมใช้งาน 3 โซนความพร้อมของคุณจะมากกว่า 99.99% แม้ว่า SLA ของผู้ให้บริการระบบคลาวด์จะไม่รับประกันความพร้อมใช้งานเกิน 99.99% โดยไม่คำนึงถึงจำนวนโซนความพร้อมใช้งานที่ใช้งาน แต่หากคุณใช้สถิติที่แท้จริงคุณอาจสรุปได้ว่าความพร้อมใช้งานของคุณอาจเพิ่มขึ้นสูงถึง 99.999999% หรือ 8-nines ของ ความพร้อมใช้งานการหยุดทำงาน 26.30 มิลลิวินาทีต่อเดือน

1 – (. 0001 * .0001) = .99999999

99.999999% พร้อม 3 โซนความพร้อม?

อย่าไปอ้างตัวเลขนั้น แต่อย่าลืมว่ามันสมเหตุสมผลแล้วถ้าโซนความพร้อม 2 โซนสามารถให้คุณพร้อมใช้งานได้ 99.99% เป็นไปตามเหตุผลว่าโซนความพร้อมใช้งาน 3 แห่งจะให้ความพร้อมใช้งานมากกว่า 99.99%

Compute เป็นเพียงลิงก์เดียวในห่วงโซ่ความพร้อมใช้งาน เรายังคงต้องจัดการกับเครือข่ายพื้นที่จัดเก็บข้อมูลและบริการอื่น ๆ ที่ต้องพึ่งพาซึ่งทั้งหมดนี้แสดงถึงจุดที่เป็นไปได้ของความล้มเหลว

ความพร้อมใช้งานของเครือข่าย

เพื่อให้แอปพลิเคชันของคุณพร้อมใช้งานเครือข่ายทุกเครือข่ายระหว่างไคลเอนต์และแอปพลิเคชันและทรัพยากรทั้งหมดที่แอปพลิเคชันขึ้นอยู่จะต้องพร้อมใช้งานและทำงานในช่วงเวลาแฝงที่ยอมรับได้ คุณต้องเข้าใจการเชื่อมโยงเครือข่ายระหว่างเซิร์ฟเวอร์ฐานข้อมูลแอ็พพลิเคชันเซิร์ฟเวอร์เว็บเซิร์ฟเวอร์และไคลเอ็นต์เพื่อให้ทราบอย่างแม่นยำว่าเครือข่ายอาจล้มเหลวที่ใด โปรดจำไว้ว่ายิ่งลิงก์ในห่วงโซ่ความพร้อมใช้งานของคุณมีความพร้อมใช้งานโดยรวมลดลง

แม้ว่าความพร้อมใช้งานของเครือข่ายระหว่าง VM ใน vNet เดียวกันจะครอบคลุมภายใต้ SLA การประมวลผลมาตรฐาน แต่ก็มีบริการเครือข่ายอื่น ๆ ที่คุณอาจใช้ นี่เป็นเพียงตัวอย่างบางส่วนของบริการเครือข่ายที่คุณสามารถใช้ได้ซึ่งจะส่งผลต่อความพร้อมใช้งานของแอปพลิเคชันโดยรวม

เส้นทางด่วน – 99.95%
เกตเวย์
VPN – 99.9% ถึง 99.95%
ตัวจัดส
รรภาระงาน – 99.99%
ผู
้จัดการจราจร – 99.99%
ตัวป
รับสมดุลโหลด – 99.99%
เชื่อมต่อโดยตรง – 99.9% – 99.99%

จากสิ่งที่เราได้เรียนรู้ไปแล้วเรามาดูความพร้อมใช้งานของแอปพลิเคชันที่ใช้งานได้ในสองโซนความพร้อมใช้งาน

ความพร้อมในการประมวลผล 99.99%

ความพร้อมใช้งานของตัวจัดสรรภาระงาน 99.99%

.9999 * .9999 = .9998

ความพร้อมใช้งาน 99.98% = การหยุดทำงานประมาณ 9 นาทีต่อเดือน

ตอนนี้เราได้จัดการกับความพร้อมในการประมวลผลและเครือข่ายแล้วเรามาดูพื้นที่เก็บข้อมูลกัน

ความพร้อมในการจัดเก็บ

ตอนนี้ที่นี่เป็นที่ที่เรื่องราวมีขนเล็กน้อย ดู SLA หน่วยเก็บข้อมูลต่อไปนี้

https://azure.microsoft.com/en-us/support/legal/sla/storage/v1_5/

https://cloud.google.com/storage/sla

https://aws.amazon.com/compute/sla/

ดูเหมือนชัดเจนว่า Azure และ Google กำลังให้ SLA 99.9% สำหรับโซลูชันการจัดเก็บบล็อก AWS ไม่ได้กล่าวถึง EBS โดยเฉพาะที่นี่ พวกเขาพูดถึง VM และวัดความพร้อมใช้งาน VM ของอินสแตนซ์เดียวเป็นรายชั่วโมงแทนที่จะเป็นรายเดือนเหมือนที่ผู้ให้บริการคลาวด์รายอื่นทำ เพื่อประโยชน์ในการสนทนาให้ใช้การรับประกันความพร้อมใช้งาน 99.9% ที่ทั้ง Azure และ GCP ได้เผยแพร่

จากตัวอย่างก่อนหน้านี้เรามาเพิ่มพื้นที่เก็บข้อมูลให้กับสมการกัน

ความพร้อมในการประมวลผล 99.99%

ความพร้อมใช้งานของตัวจัดสรรภาระงาน 99.99%

ดิสก์ที่มีการจัดการ 99.9%

.9999 * .9999 * .999 = .9988

ความพร้อมใช้งาน 99.88% = ~ 53 นาทีของการหยุดทำงานต่อเดือน

การหยุดทำงาน 53 นาทีนั้นมากกว่าเวลาหยุดทำงาน 9 นาทีที่เราคำนวณไว้ในตัวอย่างก่อนหน้านี้มาก เราจะทำอย่างไรเพื่อลดผลกระทบจากความพร้อมใช้งานของพื้นที่จัดเก็บ 99.9% เราต้องสร้างความซ้ำซ้อนในการจัดเก็บมากขึ้น!

โชคดีที่เรามักจะรวมความซ้ำซ้อนของพื้นที่เก็บข้อมูลไว้ด้วยเมื่อวางแผนสำหรับความพร้อมใช้งานของแอปพลิเคชัน ตัวอย่างเช่นเมื่อเราตั้งค่าเว็บเซิร์ฟเวอร์โดยทั่วไปเว็บเซิร์ฟเวอร์แต่ละแห่งจะจัดเก็บข้อมูลไว้ในดิสก์ที่เชื่อมต่อภายในเครื่อง เมื่อปรับใช้ตัวควบคุมโดเมน Microsoft Active Directory จะดูแลการจำลองข้อมูล AD ในตัวควบคุมโดเมนทั้งหมด ในกรณีของบางอย่างเช่น SQL Server เราใช้ประโยชน์จากสิ่งต่างๆ Always On Availability Groups หรือ SIOS DataKeeper เพื่อให้ข้อมูลซิงค์กับดิสก์ที่เชื่อมต่อภายในเครื่อง

ยิ่งเราแจกจ่ายสำเนาข้อมูลในโซนความพร้อมใช้งานต่างๆมากเท่าไหร่เราก็จะมีโอกาสรอดจากความล้มเหลวได้มากขึ้นเท่านั้น

ตัวอย่างเช่นแอปพลิเคชันที่จัดเก็บข้อมูลในดิสก์สองแผ่นในโซนความพร้อมใช้งานที่แตกต่างกันจะได้รับประโยชน์จากความซ้ำซ้อนและแทนที่จะมีความพร้อมใช้งาน 99.9% มีแนวโน้มที่จะมีพื้นที่จัดเก็บถึง 99.9999%

1 – (.001 * .001) = .999999

ถ้าเราใส่มันลงในสมการก่อนหน้านี้รูปภาพจะดูสว่างขึ้นเล็กน้อย

.9999 * .9999 * .999999 = .9998

ความพร้อมใช้งาน 99.98% = ~ 9 นาทีของการหยุดทำงาน

ด้วยการทำซ้ำข้อมูลในหลาย AZ และหลายดิสก์เราจึงลดเวลาหยุดทำงานที่เกี่ยวข้องกับที่เก็บข้อมูลบนคลาวด์ได้อย่างมีประสิทธิภาพ

ความพร้อมใช้งานของแอปพลิเคชันและบริการที่ต้องพึ่งพา

คุณได้ทำทุกอย่างที่ทำได้เพื่อให้แน่ใจว่ามีการประมวลผลเครือข่ายและพื้นที่เก็บข้อมูล แต่ตัวแอปพลิเคชันล่ะ? แอปพลิเคชันบางตัวสามารถขยายขนาดและจัดเตรียมความซ้ำซ้อนได้โดยการทำโหลดบาลานซ์ระหว่างอินสแตนซ์หลายรายการของแอปพลิเคชันเดียวกัน ลองนึกถึงฟาร์มเว็บเซิร์ฟเวอร์ทั่วไปของคุณที่โดยทั่วไปคุณอาจโหลดคำขอเว็บสมดุลระหว่างเซิร์ฟเวอร์ห้าเครื่อง หากคุณสูญเสียเซิร์ฟเวอร์หนึ่งตัวตัวโหลดบาลานเซอร์จะลบเซิร์ฟเวอร์ออกจากการหมุนเวียนจนกว่าจะมีการตอบสนองอีกครั้ง

แอปพลิเคชันอื่น ๆ ต้องการการดูแลและตรวจสอบมากกว่านี้เล็กน้อย ใช้ SQL Server เป็นต้น โดยปกติ Always On Availability Groups หรือ Failover Cluster Instances จะใช้เพื่อตรวจสอบความพร้อมใช้งานของฐานข้อมูลและดำเนินการกู้คืนหากฐานข้อมูลไม่ตอบสนองเนื่องจากความล้มเหลวของแอปพลิเคชันหรือระดับระบบ แม้ว่าจะไม่มี SLA ที่เผยแพร่สำหรับโซลูชันความพร้อมใช้งานของ SQL Server แต่เป็นที่ยอมรับกันโดยทั่วไปว่าเมื่อกำหนดค่าอย่างเหมาะสมเพื่อความพร้อมใช้งานสูง SQL Server สามารถให้ความพร้อมใช้งานได้ 99.99%

คุณอาจพึ่งพาบริการบนคลาวด์อื่น ๆ เช่น Active Directory โฮสต์ DNS ที่โฮสต์ไมโครเซอร์วิสหรือแม้แต่ความพร้อมใช้งานของพอร์ทัลระบบคลาวด์เองทั้งหมดควรรวมอยู่ในสมการความพร้อมใช้งานโดยรวมของคุณ

สรุป

ความพร้อมใช้งานคือผลรวมของชิ้นส่วนที่เคลื่อนไหวทั้งหมด การข้ามไปในพื้นที่เดียวอาจส่งผลต่อความพร้อมใช้งานโดยรวมของแอปพลิเคชันของคุณอย่างทวีคูณ ใช้เวลาของคุณและตรวจสอบลิงก์ทั้งหมดในห่วงโซ่ความพร้อมใช้งานของคุณเพื่อหาจุดอ่อนรวมถึงการประมวลผลเครือข่ายพื้นที่เก็บข้อมูลแอปพลิเคชันและบริการที่ต้องพึ่งพา

โดยทั่วไปแล้วตัวเลขที่นำเสนอนี้หวังว่าจะเป็นสถานการณ์ในกรณีที่เลวร้ายที่สุดและความพร้อมใช้งานจริงของคุณควรเกิน SLA ที่เผยแพร่ ทำการบ้านและระวังบริการใด ๆ ที่ไม่สามารถรับประกันความพร้อมใช้งาน 99.99% ซึ่งเป็นเกณฑ์ทั่วไปของสิ่งที่ถือว่าพร้อมใช้งานสูง

ข้อผิดพลาดของมนุษย์และความปลอดภัยไม่ได้รับการแก้ไขในบทความนี้ คุณสามารถทำให้แอปพลิเคชันของคุณพร้อมใช้งานมากที่สุด อย่างไรก็ตามหากคุณไม่ได้ทำตามขั้นตอนเพื่อรักษาความปลอดภัยให้กับแอปพลิเคชันของคุณจากภัยคุกคามภายนอกและความผิดพลาดที่โง่เขลาของมนุษย์การเดิมพันทั้งหมดจะถูกปิดเมื่อถึงเวลาที่ว่าง

ทำซ้ำโดยได้รับอนุญาตจาก Clusteringformeremortals

Filed Under: ทำให้เข้าใจง่ายเซิร์ฟเวอร์คลัสเตอร์

ใช้ Datadog สำหรับ Amazon EC2 Monitoring หรือไม่ จับคู่กับ SIOS AppKeeper สำหรับการแก้ไขอัตโนมัติ

ธันวาคม 11, 2020 by Jason Aw Leave a Comment

Amazon EC2 Monitoring SIOS AppKeeper

ใช้ Datadog สำหรับ Amazon EC2 Monitoring หรือไม่ จับคู่กับ SIOS AppKeeper สำหรับการแก้ไขอัตโนมัติ

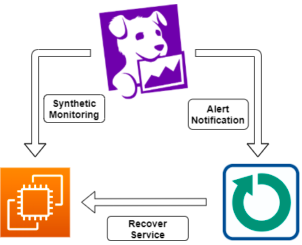
คุณเคยคิดกับตัวเองไหมว่า“ คงจะดีถ้า Datadog สามารถตรวจสอบบริการ Amazon EC2 ของเราและรีสตาร์ทโดยอัตโนมัติเมื่อตรวจพบความล้มเหลว” ฉันคิดแบบเดียวกันและตัดสินใจที่จะลองด้วยตัวเอง

SIOS AppKeeper จะตรวจสอบอินสแตนซ์ Amazon EC2 โดยอัตโนมัติสำหรับความล้มเหลวและรีสตาร์ทอินสแตนซ์โดยอัตโนมัติหรือแม้แต่รีบูตบริการเมื่อตรวจพบความล้มเหลวฉันคิดกับตัวเองว่า“ จะเป็นอย่างไรหากเรารวมความสามารถในการตรวจสอบของ Datadog เข้ากับความสามารถในการแก้ไขอัตโนมัติของ AppKeeper”

มันได้ผลและนี่คือวิธีที่ฉันทำ

หากคุณใช้ Datadog อยู่แล้วและสนใจที่จะทดลองใช้ด้วยตัวคุณเองโปรดลงทะเบียนที่ท้ายบทความนี้เพื่อเข้าถึง API ของเรา

นี่คือขั้นตอนที่ฉันใช้ในการตั้งค่า AppKeeper เพื่อรับการแจ้งเตือนจาก Datadog และรีสตาร์ทเว็บเซิร์ฟเวอร์บน Amazon EC2 เมื่อตรวจพบการหยุดทำงาน

เพื่อให้การทดสอบนี้ประสบความสำเร็จเรามีบัญชี Datadog บัญชี AppKeeper และเว็บเซิร์ฟเวอร์ NGINX ที่ทำงานบน Amazon EC2 (ใช้ Linux 2) อยู่แล้ว

วิธีรวม Datadog เข้ากับ AppKeeper เพื่อให้การแก้ไขอัตโนมัติ

ขั้นตอนที่หนึ่ง: รับโทเค็นรีสตาร์ท API จาก AppKeeper

ขอโทเค็น API สำหรับการรวม Datadog จากแบบฟอร์มนี้:

https://mk.sios.jp/BC_AppKeeper_Datadog_api_application

หากคุณขอจากแบบฟอร์มโทเค็นจะถูกส่งไปยังที่อยู่อีเมลที่คุณให้ไว้

ขั้นตอนที่สอง: สร้างผู้เช่าใน AppKeeper

ขั้นตอนต่อไปคือการลงทะเบียนบัญชี AWS ซึ่งอินสแตนซ์ที่ตรวจสอบอยู่ใน AppKeeper (AppKeeper อ้างถึงบัญชี AWS ที่ลงทะเบียนเป็น "ผู้เช่า")

https://sioscoati.zendesk.com/hc/en-us/articles/900000123406-Quick-Start-Guide#h_39404cfb-4a76-450f-99c2-e197cc63e50d

ขั้นตอนที่สาม: สร้าง IAM Role ใน AWS

จากนั้นฉันก็สร้าง IAM Role ใน AWS (คุณต้องใช้สิ่งนี้เพื่อตั้งค่าบัญชี AppKeeper ของคุณ)คำแนะนำหากคุณไม่คุ้นเคยกับกระบวนการนี้

ขั้นตอนที่สี่: เพิ่มผู้เช่าใน AppKeeper

ขั้นตอนต่อไปคือการเพิ่ม“ ผู้เช่า” ใน AppKeeper (AppKeeper ถือว่าบัญชี AWS เป็น“ ผู้เช่า”)นี่คือลิงค์ไปยังคำแนะนำโดยละเอียดเกี่ยวกับการดำเนินการนี้

ขั้นตอนที่ห้า: ตั้งค่า Synthetics Test ใน Datadog

จากนั้นฉันต้องกำหนดค่าการตรวจสอบโครงร่างของ Datadog สำหรับเซิร์ฟเวอร์ Nginx (อินสแตนซ์ EC2) ที่เราต้องการตรวจสอบวิธีดำเนินการมีดังนี้

เปิดแดชบอร์ด Datadog และเลือก UX Monitoring> Synthetic Tests จากเมนู

คลิกปุ[New Test]่มที่มุมขวาบนและเลือกเพื่อสร[New API Test]้างกรณีการตรวจสอบโครงร่าง

ป้อนข้อมูลต่อไปนี้ในแบบฟอร์มเพื่อสร้างกรณีการตรวจสอบโครงร่าง

  1. เลือกประเภทคำขอ
    เลือก“ HTTP”
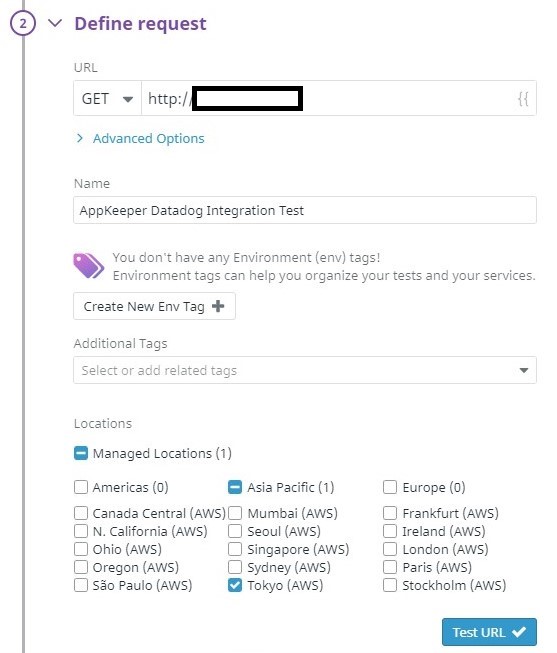
  2. กำหนดคำขอ:
    ตั้งค่าต่อไปนี้
    URL: รับ http: // {{{ที่อยู่ IP EC2}}
    ชื่อ: AppKeeper Datadog Integration Test (ชื่อใดก็ได้)
    สถานที่: โตเกียว

3. ระบุความถี่ในการทดสอบ
ไม่มีการเปลี่ยนแปลง

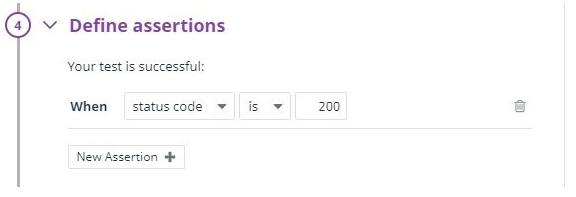
4. กำหนดการยืนยัน
คลิกที่ "การยืนยันใหม่" และตั้งค่าต่อไปนี้

เมื่อไหร่ [status code][is]:[200]

5. กำหนดเงื่อนไขการแจ้งเตือน
ไม่มีการเปลี่ยนแปลง

6.แจ้งทีมของคุณ
ไม่มีการเปลี่ยนแปลง

ขั้นตอนที่หก: เรียกใช้การทดสอบ Synthetics ใน Datadog

เมื่ออินพุตด้านบนเสร็จสมบูรณ์ให้กด "สร้างการทดสอบ" เพื่อสร้างกรณีทดสอบสำหรับการมอนิเตอร์ภายนอก

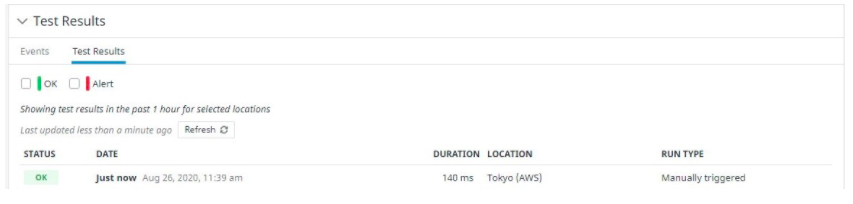
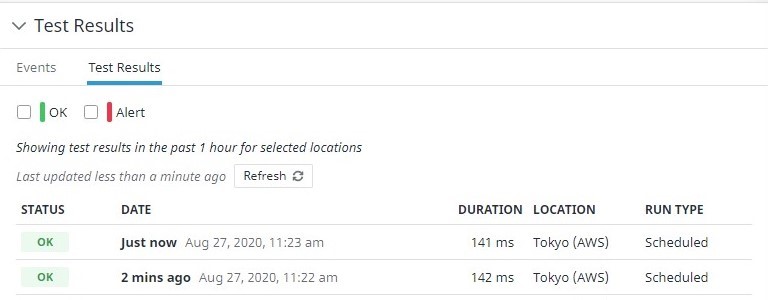
ผลลัพธ์จะปรากฏให้เห็นและเราจะเห็นว่าเว็บเซิร์ฟเวอร์ทำงานอย่างถูกต้องในส่วน“ ผลการทดสอบ”

นั่นคือทั้งหมดที่ต้องทำเพื่อกำหนดค่าการตรวจสอบ Synthetics โดยใช้ Datadog

ขั้นตอนที่เจ็ด: ตั้งค่า AppKeeper เพื่อรับการแจ้งเตือน Synthetics

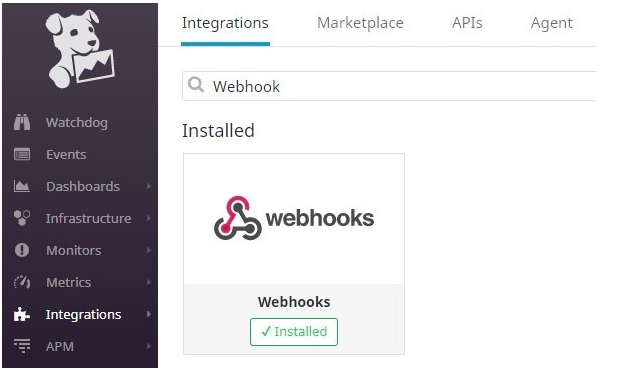
ต่อไปฉันต้องตั้ง AppKeeper เป็นปลายทางการแจ้งเตือนจากเมนู Datadog ไปที่ Integrations และเลือกแท็บ Integrations

ในช่องค้นหาป้อน“ Webhooks” เพื่อค้นหาการผสานรวม Webhooks

คลิก“ พร้อมใช้งาน” เพื่อเปิดใช้งานการรวม Webhooks ในบัญชี Datadog ของคุณ (เมื่อเปิดใช้งานแล้วจะปรากฏในคอลัมน์“ ติดตั้งแล้ว”)

คลิกที่“ กำหนดค่า” เพื่อเปิดหน้าการกำหนดค่าการรวม Webhooks

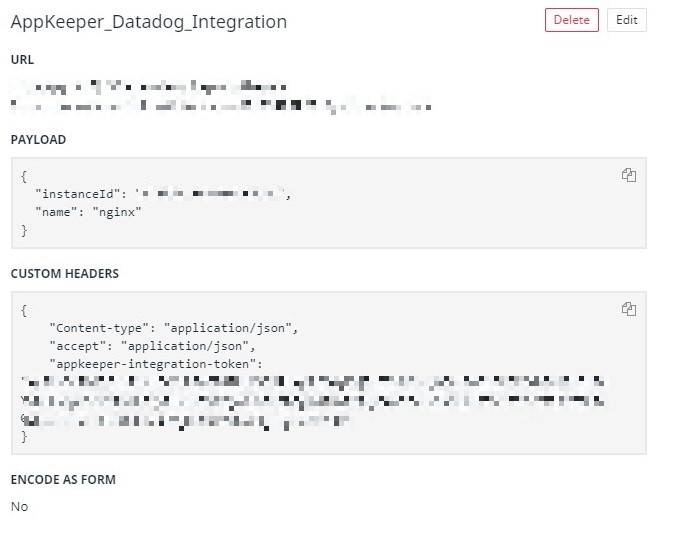
ในคอลัมน์ "Webhooks" ที่ด้านล่างของหน้าคลิก "ใหม่ +" เพื่อสร้างปลายทางการแจ้งเตือน Webhooks ใหม่ สำหรับพารามิเตอร์ให้ป้อนข้อมูลต่อไปนี้

ชื่อ: ชื่อของการรวม (ชื่อใดก็ได้)

URL: https://api.appkeeper.sios.com/v2/integration/ {{AWS account ID}} / actions / recover

น้ำหนักบรรทุก:

{

“ instanceId”:“ {{EC2 Instance ID}}”,

“ ชื่อ”:“ nginx”

}

ส่วนหัวที่กำหนดเอง: ทำเครื่องหมายในช่องและป้อนข้อมูลต่อไปนี้

{
“ ประเภทเนื้อหา”:“ application / json”,
“ ยอมรับ”:“ application / json”,
“ appkeeper-integration-token”:“ {{รับโทเค็นการรวม AppKeeper ภายนอกโทเค็นที่ได้รับใน}}”
}

เมื่อเสร็จแล้วให้กด“ บันทึก”

ขั้นตอนที่แปด: การเชื่อมต่อ AppKeeper กับการทดสอบ Synthetics

ต่อไปฉันต้องกำหนดค่า AppKeeper (การรวม Webhooks ที่ลงทะเบียนไว้) เพื่อเรียกใช้เมื่อมีการแจ้งเตือนการมอนิเตอร์ Synthetics เกิดขึ้น

เปิดกรณีทดสอบที่คุณตั้งค่าไว้ใน“ การกำหนดค่า Synthetic Monitoring ด้วย Datadog” จาก UX Monitoring> Synthetic Tests ในเมนู

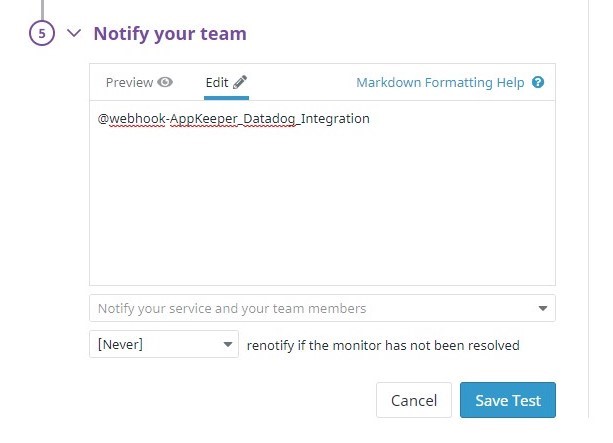
เลือก“ แก้ไขรายละเอียดการทดสอบ” จากกระปุกเกียร์ด้านขวาบนและป้อนค่าต่อไปนี้ในช่อง“ 5. แจ้งทีมของคุณ” เพื่อบันทึกการเปลี่ยนแปลง

@webhook – {{ชื่อการรวม Webhook ใน Datadog}}

※คุณสามารถตั้งค่า“ แจ้งเตือนอีกครั้งหากจอภาพไม่ได้รับการแก้ไข”คุณสามารถลองใหม่ได้หาก AppKeeper ไม่สามารถกู้คืนได้ในครั้งแรกไม่จำเป็นสำหรับวัตถุประสงค์ในการทดสอบ แต่เราขอแนะนำให้คุณตั้งค่า[10 minutes]เป็น (ช่วงต่ำสุด)

การตั้งค่าเสร็จสมบูรณ์แล้ว

ขั้นตอนที่เก้า: ยืนยันการรวมโดยเรียกใช้การทดสอบอีกครั้ง

จากนั้นฉันยืนยันว่า AppKeeper จะคืนค่าเว็บเซิร์ฟเวอร์หาก Datadog ตรวจพบว่าไม่สามารถใช้งานได้

เปิดกรณีทดสอบการตรวจสอบ Synthetics ที่คุณเพิ่งตั้งค่าจาก UX Monitoring> Synthetic Tests ใน Datadog

คลิก "ดำเนินการทดสอบต่อ" ที่มุมขวาบนและเปิดการตรวจสอบ Synthetics

ตอนนี้ Datadog จะทำการตรวจสอบ Synthetics ในช่วงเวลาปกติ

ผลการทดสอบแสดงว่าเข้าถึงเซิร์ฟเวอร์ได้สำเร็จ

ต่อไปฉันสร้างความล้มเหลวของเว็บเซิร์ฟเวอร์หลอกเพื่อทดสอบการแก้ไขอัตโนมัติของ AppKeeper

เนื่องจากเป็นเรื่องยากที่จะทำให้เกิดความล้มเหลวอย่างแท้จริงฉันจึงหยุดบริการและสร้างสถานการณ์ที่คุณไม่สามารถดูหน้าเว็บได้ในการทำเช่นนี้ฉันเชื่อมต่อกับอินสแตนซ์ EC2 ที่ติดตั้งเซิร์ฟเวอร์ Nginx โดยใช้ SSH และหยุด Nginx

sudo systemctl หยุด nginx

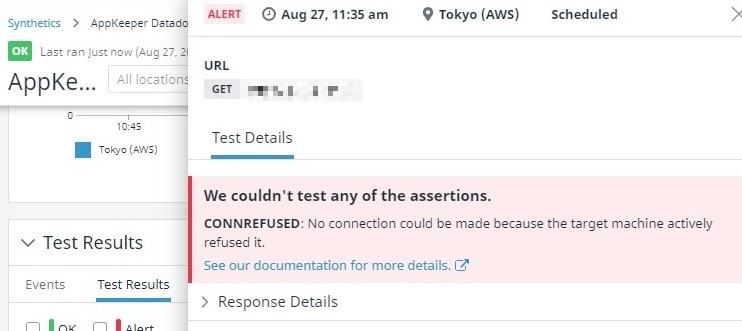
หลังจากรอไม่นาน Datadog ตรวจพบว่าเว็บเซิร์ฟเวอร์ไม่สามารถเข้าถึงได้อีกต่อไป

หน้าการทดสอบสังเคราะห์ใน Datadog ยังแสดงว่ากรณีทดสอบล้มเหลว

หากกรณีทดสอบล้มเหลว Datadog จะแจ้ง AppKeeper ว่าการมอนิเตอร์ Synthetics ล้มเหลว

เมื่อ AppKeeper ได้รับการแจ้งเตือนมันจะพยายามรีสตาร์ท Nginx โดยอัตโนมัติ

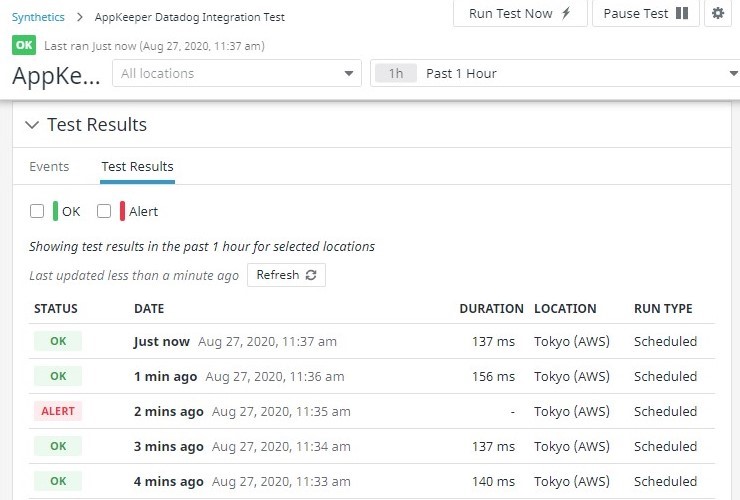
ดังนั้นหากคุณรอสักครู่คุณจะเห็นว่าการตรวจสอบ Synthetics ของ Datadog จะผ่านไปอีกครั้ง

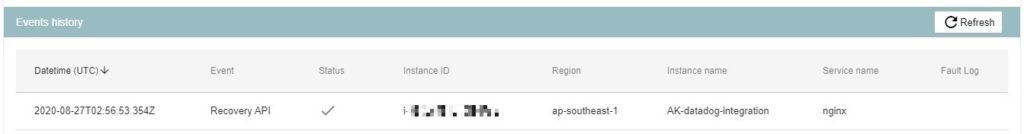
นอกจากนี้หากคุณลงชื่อเข้าใช้แดชบอร์ด AppKeeper คุณจะเห็นว่าได้ดำเนินการกู้คืนแล้ว

–

ในแบบฝึกหัดนี้ฉันใช้เว็บเซิร์ฟเวอร์ (Nginx) เป็นตัวอย่างในการตรวจจับความล้มเหลวของ Datadog โดยอัตโนมัติและเรียกคืนบริการด้วย AppKeeper

ระบบอัตโนมัติที่คล้ายกันสามารถทำได้โดยการรวม Datadog กับ EventBridge และ Lambda หรือโดยการสร้างสคริปต์ที่กำหนดเอง

อย่างไรก็ตามหากคุณเพิ่มอินสแตนซ์เป้าหมายบ่อยๆหรือรีสตาร์ทบริการที่หลากหลายต้นทุนและความซับซ้อนในการดูแล EventBridge และ Lambda หรือสคริปต์จะเพิ่มขึ้น

การผสานรวมที่พิสูจน์แล้วของ AppKeeper กับ Datadog และความสะดวกในการเพิ่มอินสแตนซ์เป้าหมายลงในแอปพลิเคชันของคุณทำให้ง่ายต่อการเพิ่มระบบอัตโนมัติให้กับสภาพแวดล้อม DevOps เพื่อลดเวลาหยุดทำงานของคุณ

หากคุณกำลังใช้ Datadog และต้องการทดลองใช้ AppKeeper's Restart API ก่อนอื่นโปรดลงชื่อสมัครทดลองใช้ฟรี 14 วันที่นี่ (คุณสามารถซื้อการสมัครใช้งานเมื่อคุณติดตั้งการทดลองใช้ฟรีแล้ว)จากนั้นคลิกที่นี่เพื่อขอทดลองใช้ฟรี เราจะแนะนำคุณตลอดขั้นตอนและมอบโทเค็นการประเมินให้คุณฟรีเพื่อช่วยคุณในการเริ่มต้น

สมัครเพื่อรับโทเค็นการประเมิน

ขอบคุณ.ฉันหวังว่าคุณจะใช้โอกาสนี้เพื่อเรียนรู้เพิ่มเติมเกี่ยวกับ SIOS AppKeeper ซึ่งให้การตรวจสอบและกู้คืนแอปพลิเคชันที่ทำงานบน EC2 โดยอัตโนมัติ

– Tatsuya Hirao จากทีมเทคนิค SIOS Technology

ทำซ้ำโดยได้รับอนุญาตจาก SIOS

Filed Under: ทำให้เข้าใจง่ายเซิร์ฟเวอร์คลัสเตอร์

5 สัญญาณบ่งบอกว่าจะต้องใช้เวลามากกว่าบล็อกโพสต์เพื่อแก้ไขความพร้อมใช้งานสูงของคุณ

ธันวาคม 8, 2020 by Jason Aw Leave a Comment

5 สัญญาณว่าต้องใช้เวลามากกว่าบล็อกโพสต์เพื่อแก้ไขความพร้อมใช้งานที่สูงของคุณ

5 สัญญาณบ่งบอกว่าจะต้องใช้เวลามากกว่าบล็อกโพสต์เพื่อแก้ไขความพร้อมใช้งานสูงของคุณ

ป้ายอยู่ที่นั่น ไฟเตือนกะพริบในลำไส้ของคุณคุณสามารถรับรู้ได้ บางทีคุณอาจจะนอนไม่หลับปัญหาของคุณเกี่ยวกับความพร้อมใช้งานสูงนั้นลึก ๆ แต่บางทีคุณอาจจะไม่แน่ใจนัก

1. หากคุณคิดว่า SLA บนคลาวด์ของคุณคือสิ่งที่คุณต้องการสำหรับความพร้อมใช้งานที่สูง

โซลูชันระบบคลาวด์มีความก้าวหน้าอย่างมากในการเพิ่มความพร้อมใช้งานของฮาร์ดแวร์และความยืดหยุ่น อย่างไรก็ตามความพร้อมใช้งานสูงของแอปพลิเคชันต้องการมากกว่าการเลือกผู้ให้บริการไฮเปอร์ไวเซอร์หรือคลาวด์ที่เหมาะสม กลยุทธ์สำหรับความพร้อมใช้งานสูงของคุณไม่สามารถหยุดได้ด้วย SLA ที่จัดเตรียมโดยระบบคลาวด์หรือผู้ให้บริการการจำลองเสมือน ตามที่อ้างโดย Wired“ การหยุดให้บริการเกือบสี่วันของ Amazon ในเดือนเมษายน 2011 ไม่ได้ละเมิด EC2 SLA ของ Amazon ซึ่งตามคำถามที่พบบ่อยอธิบายว่า“ รับประกันความพร้อมให้บริการ 99.95% ภายในภูมิภาคตลอด 365 ช่วงเวลาต่อท้าย” ในบทความ DZone นี้ David Bermingham ของเราเองได้แจกแจงความแตกต่างระหว่าง SLA บนคลาวด์และความพร้อมใช้งานของแอปพลิเคชันโดยละเอียด หากคุณต้องการโครงสร้างพื้นฐานที่พร้อมใช้งานสูงต้องมีการตรวจสอบการกู้คืนและความยืดหยุ่นที่ชั้นข้อมูลและแอปพลิเคชันด้วย

2. หากคุณเพิ่งใช้คลัสเตอร์ความพร้อมใช้งานสูงที่มาพร้อมกับระบบปฏิบัติการโอเพนซอร์สของคุณ

ถ้าเป็นเช่นนั้นแสดงว่าคุณไม่ได้เลือกฐานข้อมูลของคุณตามสิ่งที่มาพร้อมกับระบบปฏิบัติการดังนั้นทำไมคุณถึงเลือกโซลูชัน HA ตามเกณฑ์นั้นเพียงอย่างเดียว เครื่องมือที่แถมมาช่วยเพิ่มความมั่นใจความเป็นไปได้และความสามารถ อย่างไรก็ตามแม้จะเข้าถึงได้ง่าย แต่เครื่องมือที่แถมมาและซอฟต์แวร์การทำคลัสเตอร์ OS ก็ไม่สามารถตอบสนองข้อกำหนด SLA, RPO, RTO และความพร้อมใช้งานของคุณได้เสมอไป หากองค์กรของคุณมีระบบปฏิบัติการร่วมกันทีมของคุณอาจต้องการความช่วยเหลือในการนำทางเครื่องมือต่างๆและทำความเข้าใจว่าพวกเขารวมเข้าด้วยกันอย่างไร มันเหมือนกับการเลือกปัตตาเลี่ยนป้องกันความเสี่ยงและดันเครื่องตัดหญ้าแบบหมุนไปทางซ้ายบนขอบถนนเพื่อให้มีรูปร่างเป็น "Azalea" ในหลุมที่ 13 พาร์ 5 (ที่ Augusta) เครื่องตัดหญ้าทั้งสองรุ่นออกแบบมาเพื่อตัดหญ้า แต่คุณมีเวลาเท่าไหร่? คุณจะจัดการกับความซับซ้อนได้อย่างไร? คุณจะเชื่อถืออะไร กลยุทธ์สำหรับความพร้อมใช้งานสูงของคุณต้องการมากกว่าการพิจารณาความสะดวกของสิ่งที่มาพร้อมกับระบบปฏิบัติการมิฉะนั้นคุณจะต้องใช้งาน MySQL แทน SAP HANA

3. หากคุณคิดว่าการให้สิทธิ์การใช้งานแอปพลิเคชันระดับองค์กรเช่น SQL Enterprise หรือ Oracle Enterprise เป็นสิ่งเดียวกับความพร้อมใช้งานระดับสูงขององค์กร

นอกเหนือจากค่าใช้จ่ายที่เพิ่มขึ้นใบอนุญาตแอปพลิเคชันระดับองค์กรจำนวนมากยังเพิ่มความสามารถของแอปพลิเคชันในการกู้คืนในสถานการณ์ที่มีความพร้อมใช้งานสูง อย่างไรก็ตามเป็นไปได้ยากมากที่ทั้งองค์กรของคุณจะใช้แอปพลิเคชันเดียว ความพร้อมใช้งานสูงของคุณต้องการมากกว่าโซลูชันฐานข้อมูลที่พร้อมใช้งานสูง คุณจะต้องมีโซลูชันการตรวจสอบและกู้คืนแอปพลิเคชันระดับองค์กรพร้อมการสนับสนุนที่หลากหลายสำหรับแอปพลิเคชันและฐานข้อมูลทั้งหมดของคุณ นอกจากนี้คุณจะต้องมีความสามารถในการจัดการและทำซ้ำไม่เพียง แต่ข้อมูลฐานข้อมูลเท่านั้น แต่ยังรวมถึงแอปพลิเคชันและข้อมูลการกำหนดค่าที่สำคัญอีกด้วย ความพร้อมใช้งานสำหรับฐานข้อมูลเดียวหรือแอปพลิเคชันง่ายๆเป็นสิ่งหนึ่ง แต่ HA สำหรับแอปพลิเคชันที่ซับซ้อนหลายส่วนและฐานข้อมูลที่รองรับนั้นแตกต่างกันมาก บริการเพิ่มเติมส่วนอื่น ๆ ที่ต้องประสานงานกันสถาปัตยกรรมที่ซับซ้อนมากขึ้นในการจัดระเบียบแนวทางปฏิบัติที่ดีที่สุดที่เฉพาะเจาะจงมากขึ้นที่จะปฏิบัติตามก่อนระหว่างและหลังการล้มเหลว / การสลับ มากกว่าใบอนุญาตองค์กรของคุณที่จ่ายให้

4. หากช่วงเวลาหยุดทำงานของคุณเพิ่มขึ้นและเวลาการทำงานของคุณลดลง

ก้าวของชีวิตที่เพิ่มขึ้นเรื่อย ๆ ในหลาย ๆ ด้าน ครั้งสุดท้ายที่ทีมของคุณกู้คืนจากการสำรองข้อมูลรีสตาร์ทแอปพลิเคชันที่ถือว่าสำคัญด้วยตนเองหรือรีสตาร์ทชุดเครื่องเสมือนหรือโหนดที่ล้มเหลว เหตุการณ์ไฟดับของคุณไม่สามารถก้าวไปข้างหน้าอย่างยั่งยืนต่อไปหรือความสามารถของทีมของคุณจะก้าวไปไกลกว่าการดับเพลิงไปสู่การป้องกันอัคคีภัยและการพิสูจน์อัคคีภัย “ คุณสามารถวิ่งได้นานมากเท่านั้น (Carey Nieuwhof)” สำหรับบางคนคุณผจญเพลิงมานานเกินไปและการดับของคุณกลายเป็นเรื่องปกติมากกว่าเวลาที่คุณไม่ได้ทำงาน

5. หากการทดสอบล้มเหลวครั้งแรกของคุณอยู่บนเซิร์ฟเวอร์ที่ใช้งานจริง

ลูกค้ารายล่าสุดตั้งข้อสังเกตว่าเป็นไปไม่ได้ที่จะทดสอบสถานการณ์ภัยพิบัติที่อาจเกิดขึ้นได้ทุกกรณี เมื่อซอฟต์แวร์ใหม่ถูกสร้างใช้งานอัปเดตและแก้ไขความท้าทายในความพร้อมใช้งานที่สูงขึ้นกำลังเพิ่มขึ้น แต่ข้อมูลการผลิตสดของคุณไม่ใช่สถานที่ที่จะค้นหาว่าอะไรที่เข้ากันได้ไม่ดี และในขณะที่ Go-Live และ Post-Go-Live จะมีส่วนแบ่งของความประหลาดใจอยู่เสมอ แต่การที่ไม่สามารถเฟลโอเวอร์และทำงานบนโหนดสำรองได้ไม่ควรเป็นหนึ่งในนั้น

บล็อกการกำจัดสิ่งสกปรกสามารถให้คำแนะนำและข้อมูลเชิงลึกที่เป็นประโยชน์แก่คุณเพื่อกำหนดนิยามใหม่และปรับปรุงความพร้อมใช้งานที่สูงขึ้นของคุณ แต่หากสัญญาณเตือนเกิดขึ้นว่าคุณได้แลกเปลี่ยนความพร้อมใช้งานที่แท้จริงสำหรับบางลักษณะของ 'เพียงพอ' ก็จะต้องใช้เวลามากกว่าบล็อกโพสต์หรือกำจัดทุกโพสต์ในบล็อกในโลกที่พร้อมใช้งานสำหรับเรื่องนั้นเพื่อแก้ไข HA ของคุณ

– Cassius Rhue รองประธานฝ่ายประสบการณ์ลูกค้า

ทำซ้ำโดยได้รับอนุญาตจาก SIOS

Filed Under: ทำให้เข้าใจง่ายเซิร์ฟเวอร์คลัสเตอร์

9 สัญญาณคุณมีปัญหาเกี่ยวกับความพร้อมใช้งานของแอปพลิเคชัน

พฤศจิกายน 27, 2020 by Jason Aw Leave a Comment

9 สัญญาณคุณมีปัญหาเกี่ยวกับความพร้อมใช้งานของแอปพลิเคชัน

9 สัญญาณคุณมีปัญหาเกี่ยวกับความพร้อมใช้งานของแอปพลิเคชัน

คุณเคยได้ยินคำพูดที่ว่า“ การตระหนักถึงปัญหาเป็นขั้นตอนแรกในการแก้ปัญหา” แต่ที่น่าแปลกใจคือธุรกิจขนาดเล็กขนาดกลางและระดับองค์กรขนาดใหญ่ยังไม่ทราบว่าความพร้อมของแอปพลิเคชันของพวกเขาไม่ใช่สิ่งที่ควรจะเป็น

อ่านต่อไปสำหรับสัญญาณเก้าประการที่บ่งชี้ว่าคุณยังมีปัญหาความพร้อมใช้งานของแอปพลิเคชัน:

1. คุณใช้เวลาในการรีสตาร์ทแอปพลิเคชันนานกว่าการใช้งาน

การขัดข้องของแอปพลิเคชันอาจเป็นเรื่องจริงของชีวิต แต่หากแอปพลิเคชันของคุณหยุดทำงานบ่อยกว่าที่เป็นอยู่นั่นคือปัญหา

2. คุณได้เริ่มปิดเสียงเตือนชั่วคราวผ่านพายุแจ้งเตือนในกล่องจดหมายหรือศูนย์ควบคุมของคุณ

คุณได้ปรับใช้การแจ้งเตือนสำหรับการหยุดทำงานของแอปพลิเคชันหรือเซิร์ฟเวอร์แล้ว แต่พายุการแจ้งเตือนได้เข้าครอบงำกล่องจดหมายของคุณจนคุณปิดเสียงทั้งหมด

3. คุณมีศูนย์ข้อมูลเดียวสำหรับการดำเนินการที่สำคัญทั้งหมดของคุณ

ศูนย์ข้อมูลเดียวสำหรับการดำเนินงานอาจฟังดูสะดวก แต่มีทีมงานก่อสร้างที่ตั้งใจดี แต่ถูกส่งต่อไปในทางที่ผิดเพื่อเปลี่ยนศูนย์ข้อมูลเดียวให้เป็นโซนที่ไม่มีราคาแพง

4. แนวคิดในการปกป้องข้อมูลของคุณเกี่ยวข้องกับการดึงข้อมูลสำรองและที่เก็บถาวร

กลยุทธ์การปกป้องข้อมูลของคุณมีความสำคัญเทคโนโลยีการจำลองข้อมูลและการจำลองแบบไซต์ไปยังไซต์การจำลองแบบภูมิภาคไปยังภูมิภาคได้กลายเป็นแกนนำดังนั้นหากไม่มีการจำลองแบบหรือกลยุทธ์การปกป้องข้อมูลของคุณหรือเกี่ยวข้องกับการเขย่าเบา ๆ เป็นเวลานานในห้องนิรภัยอาจเป็นปัญหาใหญ่

5. ขั้นตอนการกู้คืนของคุณจำเป็นต้องมีการแทรกแซงด้วยตนเองเสมอ

การแทรกแซงด้วยตนเองไม่ใช่ปัญหา เหตุการณ์บางอย่างเป็นเรื่องยากและซับซ้อนมากจนอาจต้องใช้ความพยายามเล็กน้อยแต่หากการแทรกแซงด้วยตนเองเป็นลำดับที่หนึ่งอันดับสองและสามของธุรกิจหลังจากเซิร์ฟเวอร์หรือแอปพลิเคชันหยุดทำงานนั่นคือปัญหา

6. RTO ของคุณวัดเป็นวันไม่ใช่ชั่วโมงหรือนาที

คุณวัดวัตถุประสงค์ของเวลาในการฟื้นตัว (RTO) อย่างไร? คุณวัด RTO ของคุณเป็นวันหรือชั่วโมงแทนที่จะเป็นนาทีต่อเดือนหรือไม่?จริงอยู่ที่ทุกธุรกิจมีระดับความอดทนต่อ RTO ของตนอย่างไรก็ตาม RTO ของคุณไม่ควรเป็นหน้าที่ของการสร้างเซิร์ฟเวอร์และความไม่เสถียรขั้นต้นในสถาปัตยกรรมของคุณ

7. คุณไม่รู้จัก RPO ของคุณเนื่องจากโหมดสแตนด์บายของคุณไม่เคยซิงค์อย่างน่าเชื่อถือ

คุณได้ทำเครื่องหมายในช่องเกี่ยวกับการตรวจสอบและการกู้คืนแอปพลิเคชันของคุณที่เชื่อถือได้และดำเนินการไปอีกขั้นเพื่อจัดเตรียมระบบที่พร้อมใช้งานคลัสเตอร์สแตนด์บายเยี่ยมมากแต่ก่อนที่ฉันจะปล่อยคุณออกจากเบ็ดวัตถุประสงค์จุดกู้คืนของคุณ (RPO) คืออะไร? RPO ควรเป็นสิ่งที่แม่นยำกว่า“ ที่ไหนสักแห่งระหว่างวันที่ 0 ถึงคืนสุดท้าย”

8. จุดเดียวของความล้มเหลวไม่ได้มีอยู่เพียงจุดเดียว แต่เป็นบรรทัดฐาน

จุดเดียวของความล้มเหลวของคุณอยู่ที่ไหน?งบประมาณของคุณอาจไม่อนุญาตให้คุณกำจัดทุกจุดของความล้มเหลว แต่ถ้าคุณสามารถระบุจุดแห่งความล้มเหลวในทุกหมวดหมู่หลักและทุกองค์ประกอบที่สำคัญขององค์กรของคุณ …

9. ภัยพิบัติครั้งสุดท้ายของคุณเป็นข่าวระดับท้องถิ่นภูมิภาคหรือระดับประเทศ

หากเหตุการณ์พายุใหญ่ความล้มเหลวของกริดหรือความล้มเหลวครั้งล่าสุดส่งผลกระทบต่อธุรกิจของคุณเนื่องจากการหยุดทำงานความพร้อมใช้งานที่สูงขึ้นจะเป็นลำดับถัดไปของธุรกิจ

การหยุดทำงานทำให้ธุรกิจของคุณเสียค่าใช้จ่ายทั้งในแง่ของลูกค้าผลผลิตและความอุ่นใจความเสี่ยงที่ไม่ได้รับการแก้ไขมีผลกระทบอย่างแน่นอนต่อธุรกิจและชื่อเสียงของคุณหากมีป้ายเตือนเหล่านี้แสดงว่าคุณอาจมีปัญหาเกี่ยวกับความพร้อมใช้งานและหากคุณเพิกเฉยต่อสิ่งเหล่านี้คุณจะมีปัญหาใหญ่กว่านั้นในไม่ช้าหลังจากนั้นจึงให้ความสำคัญกับความพร้อมใช้งาน

– Cassius Rhue รองประธานฝ่ายประสบการณ์ลูกค้า

ทำซ้ำโดยได้รับอนุญาตจาก SIOS

Filed Under: ทำให้เข้าใจง่ายเซิร์ฟเวอร์คลัสเตอร์

  • « Previous Page
  • 1
  • …
  • 71
  • 72
  • 73
  • 74
  • 75
  • …
  • 112
  • Next Page »

โพสต์ล่าสุด

  • ระบบความพร้อมใช้งานสูง (High Availability หรือ HA) คืออะไร?
  • เอาตัวรอดจากวิกฤตการณ์วันศุกร์: จากระบบคอมพิวเตอร์แบบดิบๆ สู่การจำลองข้อมูลที่ราบรื่น
  • ติดดิน: สิ่งที่การพลาดชม Percona Live Amsterdam สอนฉันเกี่ยวกับ HA
  • เปรียบเทียบ SIOS LifeKeeper กับ Red Hat High Availability Add-On:
  • สถานะของความยืดหยุ่นของแอปพลิเคชัน: ผลสำรวจความพร้อมใช้งานสูงของ SIOS ปี 2026

กระทู้ยอดนิยม

เข้าร่วมรายชื่อผู้รับจดหมายของเรา

Copyright © 2026 · Enterprise Pro Theme on Genesis Framework · WordPress · Log in