SIOS SANless clusters

SIOS SANless clusters High-availability Machine Learning monitoring

  • Home
  • Products
    • SIOS DataKeeper for Windows
    • SIOS Protection Suite for Linux
  • การทดสอบอาหารสัตว์
  • ข่าวสารและกิจกรรม
  • ทำให้เข้าใจง่ายเซิร์ฟเวอร์คลัสเตอร์
  • เรื่องราวความสำเร็จ
  • ติดต่อเรา
  • English
  • 中文 (中国)
  • 中文 (台灣)
  • 한국어
  • Bahasa Indonesia
  • ไทย

วิธีการตั้งค่า SAN ต้นทุนต่ำด้วยซอฟต์แวร์ Linux iSCSI Target

ธันวาคม 12, 2018 by Jason Aw Leave a Comment

ตั้งค่า SAN ราคาถูกด้วยเป้าหมายซอฟต์แวร์ iSCSI

คู่มือขั้นตอนการตั้งค่า SAN ต้นทุนต่ำด้วยซอฟต์แวร์ iSCSI Target สำหรับ Linux

ซอฟต์แวร์ iSCSI เป้าหมายอาจเป็นวิธีที่ยอดเยี่ยมในการตั้งค่าที่จัดเก็บข้อมูลร่วมกันเมื่อคุณไม่มีแป้งพอที่จะซื้อฮาร์ดแวร์ SAN ที่มีราคาแพง เป้าหมาย iSCSI ทำหน้าที่เหมือนอาร์เรย์ iSCSI ฮาร์ดแวร์จริงยกเว้นเป็นเพียงส่วนของซอฟต์แวร์ที่ทำงานบนเซิร์ฟเวอร์แบบดั้งเดิม (หรือแม้แต่ VM!) การตั้งค่าเป้าหมาย iSCSI เป็นวิธีต้นทุนที่ง่ายและราคาไม่แพงเพื่อให้ได้พื้นที่เก็บข้อมูลที่ใช้ร่วมกันที่คุณต้องการ ไม่สำคัญว่าคุณใช้ผลิตภัณฑ์แบบกลุ่มเช่น Microsoft Windows Server Failover Clustering (WSFC) ซึ่งเป็นระบบแฟ้มคลัสเตอร์เช่น GFS หรือ OCFS หรือแม้กระทั่งในกรณีที่คุณต้องการใช้แพลตฟอร์มการจำลองเสมือน (VMware, XenServer หรือ Hyper-V) ให้มากที่สุดโดยการเปิดใช้งานการจัดเก็บข้อมูลร่วมกันและการย้ายข้อมูลแบบสด

เกี่ยวกับ Lio-Target

ล่าสุดลีนุกซ์ได้ใช้ LIO-Target เป็นเป้าหมายมาตรฐาน iSCSI มาตรฐานสำหรับ Linux LIO-Target มีวางจำหน่ายแล้วใน Linux kernel 3.1 ขึ้นไป LIO-Target สนับสนุนการจองแบบต่อเนื่องแบบ SCSI-3 ซึ่งจำเป็นต้องใช้โดย Windows Server Failover Clustering, VMware vSphere และผลิตภัณฑ์การจัดกลุ่มอื่น ๆ LUNs (ดิสก์) ที่นำเสนอโดยเป้าหมาย iSCSI สามารถเป็นไดรฟ์ทั้งพาร์ติชันหรือแม้แต่ไฟล์เก่าธรรมดาในระบบไฟล์ LIO-Target สนับสนุนตัวเลือกทั้งหมดเหล่านี้ ด้านล่างนี้เราจะทำตามขั้นตอนเพื่อกำหนดค่า LIO-Target บนเซิร์ฟเวอร์ Ubuntu 12.04 distros ล่าสุดอื่น ๆ อาจจะทำงานได้ แต่ขั้นตอนอาจแตกต่างกันเล็กน้อย

ขั้นตอนการกำหนดค่า

ขั้นแรกให้ติดตั้ง Lio-target packages:

# apt-get install -no-install-recommends targetcli python-urwid Lio-target ถูกควบคุมโดยใช้ยูทิลิตีบรรทัดคำสั่ง targetcli ขั้นตอนแรกคือการสร้างร้านสำรองสำหรับ LUN ในตัวอย่างนี้เราจะใช้ LUN ที่มีการสนับสนุนไฟล์ซึ่งเป็นเพียงไฟล์ปกติในระบบไฟล์ของเซิร์ฟเวอร์เป้าหมายของ iSCSI # targetcli /> ที่เก็บซีดี backstores / / backstores> ls o- backstores …………………………………………………… [… ] o-fileio ………………………… ……………… [0 Storage Object] o- iblock ………………………………………… [0 Storage Object] o- pscsi ………………………………………… .. [0 Storage Object] o- rd_dr ………………………………………… .. [0 Storage Object] o- rd_mcp ………………………………………… [จัดเก็บข้อมูลวัตถุ] / backstores> cd fileio / backstores / fileio> ช่วยสร้าง (สำหรับความช่วยเหลือ) / backstores / fileio> สร้าง lun0 / root / iscsi-lun0 2g (สร้าง LUN ที่สนับสนุนไฟล์ 2GB)

ขั้นตอนที่สอง

ขณะนี้ LUN ถูกสร้างขึ้นแล้ว มีวิธีตั้งค่า SAN กับซอฟต์แวร์ iSCSI Target Linux ต่ำสุด ถัดไปเราจะตั้งค่าเป้าหมายเพื่อให้ระบบไคลเอ็นต์สามารถเข้าถึงพื้นที่เก็บข้อมูลได้ / backstores / fileio / lun0> cd / iscsi / iscsi> สร้าง (สร้าง iqn และกลุ่ม port เป้าหมาย) สร้างเป้าหมาย iqn.2003-01.org.linux-iscsi.murray.x8664: sn.31fc1a672ba1 แท็ก TPG ที่เลือก 1 สร้าง TPG เรียบร้อยแล้ว 1. การเข้าสู่โหนดใหม่ /iscsi/iqn.2003-01.org.linux-iscsi.murray.x8664:sn.31fc1a672ba1/tpgt1 /iscsi/iqn.20…a672ba1/tpgt1> ตั้งค่าการตรวจสอบสิทธิ์แอตทริบิวต์ = 0 (ปิด Chap auth) / iscsi / iqn.20 … a672ba1 / tpgt1> cd luns /iscsi/iqn.20…a1/tpgt1/luns> สร้าง / backstores / fileio / lun0 (สร้าง LUN เป้าหมาย) เลือก LUN 0 สร้าง LUN เรียบร้อยแล้ว 0 กำลังเข้าสู่โหนดใหม่ /iscsi/iqn.2003-01.org.linux-iscsi.murray.x8664:sn.31fc1a672ba1/tpgt1/luns/lun0 /iscsi/iqn.20…gt1/luns/lun0> cd ../ .. / portals การรับส่งข้อมูล iSCSI สามารถใช้แบนด์วิธได้เป็นจำนวนมาก คุณอาจต้องการให้การรับส่งข้อมูล iSCSI อยู่ในเครือข่ายเฉพาะ (หรือ SAN) มากกว่าเครือข่ายสาธารณะของคุณ /iscsi/iqn.20…tpgt1/portals> สร้าง 10.10.102.164 (สร้างพอร์ทัลเพื่อฟังการเชื่อมต่อ) ใช้พอร์ต IP เริ่มต้น 3260 สร้างพอร์ทัลเครือข่ายสำเร็จ 10.10.102.164:3260 กำลังเข้าสู่โหนดใหม่ /iscsi/iqn.2003-01.org.linux-iscsi.murray.x8664:sn.31fc1a672ba1/tpgt1/portals/10.10.102.164:3260 /iscsi/iqn.20….102.164:3260> cd .. /iscsi/iqn.20…tpgt1/portals> สร้าง 10.11.102.164 ใช้พอร์ต IP เริ่มต้น 3260 สร้างพอร์ทัลเครือข่ายสำเร็จ 10.11.102.164:3260 กำลังเข้าสู่โหนดใหม่ /iscsi/iqn.2003-01.org.linux-iscsi.murray.x8664:sn.31fc1a672ba1/tpgt1/portals/10.11.102.164:3260 /iscsi/iqn.20…102.164:3260> cd ../ ../acls

ขั้นตอนสุดท้าย

ลงทะเบียน iSCSI initiators (ระบบไคลเอ็นต์) เพื่อตั้งค่า SAN ต้นทุนต่ำพร้อมด้วย iSCSI Target Software ในการทำเช่นนี้คุณจะต้องหาชื่อของผู้ริเริ่มระบบ สำหรับ Linux สิ่งนี้จะอยู่ใน /etc/iscsi/initiatorname.iscsi สำหรับ Windows ชื่อของ initiator จะพบได้ใน iSCSI Initiator Properties Panel ในแท็บ Configuration /iscsi/iqn.20…a1/tpgt1/acls> create iqn.1994-05.com.redhat: f5b312caf756 (register initiator – IQN นี้คือ IQN ของ initiator – ทำเช่นนี้สำหรับแต่ละ initiator ที่จะเข้าถึงเป้าหมาย) สำเร็จ สร้าง Node ACL สำหรับ iqn.1994-05.com.redhat: f5b312caf756 สร้างแผนที่ LUN 0 การป้อนโหนดใหม่ /iscsi/iqn.2003-01.org.linux-iscsi.murray.x8664:sn.31fc1a672ba1/tpgt1/acls/iqn.1994-05.com.redhat:f5b312caf756 /iscsi/iqn.20….102.164 : 3260> cd / ตอนนี้อย่าลืมบันทึกการตั้งค่า หากไม่มีขั้นตอนนี้การกำหนดค่าจะไม่เกิดขึ้นต่อเนื่อง /> saveconfig (SAVE configuration!) /> exit ตอนนี้คุณจำเป็นต้องเชื่อมต่อผู้ริเริ่มของคุณเข้ากับเป้าหมาย โดยทั่วไปคุณจะต้องระบุที่อยู่ IP ของเป้าหมายเพื่อเชื่อมต่อ หลังจากที่มีการเชื่อมต่อระบบไคลเอ็นต์จะเห็นดิสก์ใหม่ ดิสก์จะต้องได้รับการฟอร์แมตก่อนใช้ และนั่นแหละ! คุณพร้อมใช้ SAN ใหม่แล้ว มีความสุข! มีปัญหาในการตั้งค่า SAN ต้นทุนต่ำด้วยซอฟต์แวร์ Linux เป้าหมาย iSCSI อ่านบทความที่เป็นประโยชน์อื่น ๆ ของเราทำซ้ำได้รับอนุญาตจาก
Filed Under: ทำให้เข้าใจง่ายเซิร์ฟเวอร์คลัสเตอร์ Tagged With: iscsi, ตั้งค่า san ต้นทุนต่ำกับเป้าหมาย linux iscsi ซอฟต์แวร์

แพลตฟอร์มเพื่อทำซ้ำข้อมูล (การจำลองแบบตามโฮสต์และการจำลองแบบ SAN)

ธันวาคม 10, 2018 by Jason Aw Leave a Comment

การเลือกแพลตฟอร์มเพื่อทำซ้ำข้อมูล - ใช้โฮสต์หรือสตอเรจ?

การเลือกแพลตฟอร์มเพื่อทำซ้ำข้อมูล – ใช้โฮสต์หรือสตอเรจ?

แพลตฟอร์มทั่วไปสองแพลตฟอร์มเพื่อทำซ้ำข้อมูลมาจากโฮสต์ของเซิร์ฟเวอร์ที่ทำงานกับข้อมูลและจากอาร์เรย์ที่จัดเก็บข้อมูล เมื่อสร้างแบบจำลองระยะไกลเพื่อความต่อเนื่องทางธุรกิจการตัดสินใจว่าจะใช้โซลูชันโฮสติ้งหรือสตอเรจขึ้นอยู่กับแพลตฟอร์มที่กำลังจำลองและความต้องการทางธุรกิจสำหรับแอ็พพลิเคชันที่ใช้งานอยู่หรือไม่ หากธุรกิจต้องการผลกระทบจากศูนย์ต่อการดำเนินงานในกรณีที่เกิดภัยพิบัติจากไซต์ระบบที่ใช้โฮสต์จะเป็นทางออกที่เป็นไปได้เพียงอย่างเดียว

การจำลองแบบตามโฮสต์

หนึ่งในสองแพลตฟอร์มเพื่อทำสำเนาข้อมูลคือการจำลองแบบตามโฮสต์ ไม่ได้ล็อคผู้ใช้ลงในอาร์เรย์การเก็บข้อมูลเฉพาะจากผู้ขายรายใดรายหนึ่ง ยกตัวอย่างเช่น SIOS SteelEye DataKeeper สามารถทำซ้ำจากอาเรย์ไปยังอาเรย์ใด ๆ โดยไม่คำนึงถึงผู้ขาย ความสามารถนี้ช่วยลดต้นทุนและช่วยให้ผู้ใช้มีความยืดหยุ่นในการเลือกสิ่งที่เหมาะสมกับสภาพแวดล้อมของตน โซลูชันการจำลองแบบตามโฮสต์ส่วนใหญ่สามารถจำลองข้อมูลบนเครือข่าย IP ได้โดยผู้ใช้จึงไม่จำเป็นต้องซื้อฮาร์ดแวร์ที่มีราคาแพงเพื่อให้บรรลุฟังก์ชันนี้ โซลูชันที่ใช้โฮสต์เป็นระบบจัดเก็บข้อมูลไม่เชื่อเรื่องพระเจ้าช่วยให้ผู้จัดการฝ่ายไอทีมีอิสระในการเลือกพื้นที่เก็บข้อมูลที่ตรงกับความต้องการขององค์กร ฟังก์ชั่นซอฟต์แวร์ทำซ้ำกับฮาร์ดแวร์จัดเก็บข้อมูลใด ๆ ที่สามารถติดตั้งลงในแพลตฟอร์มแอพพลิเคชันโดยให้การสนับสนุนการจัดเก็บข้อมูลแบบไม่เหมือนกัน สามารถทำงานได้ที่ระดับบล็อกหรือระดับเสียงเหมาะสำหรับการกำหนดค่าคลัสเตอร์ ข้อเสียประการหนึ่งคือโซลูชันที่ทำงานบนโฮสต์ใช้ทรัพยากรเซิร์ฟเวอร์และอาจมีผลกับประสิทธิภาพของเซิร์ฟเวอร์โดยรวม แม้จะมีความเป็นไปได้นี้โซลูชันแบบใช้โฮสต์อาจยังคงเหมาะสมเมื่อผู้จัดการฝ่ายไอทีจำเป็นต้องมีโครงสร้างสตอเรจผู้จัดจำหน่ายหลายรายหรือมีการลงทุนแบบเดิมหรือความชำนาญเฉพาะด้านภายในแอ็พพลิเคชันเฉพาะโฮสต์

การจำลองแบบ Storage-Based

แพลตฟอร์มอื่นเพื่อทำซ้ำข้อมูลคือการจำลองแบบที่เก็บข้อมูลเป็นระบบปฏิบัติการอิสระและไม่มีค่าใช้จ่ายในการประมวลผล อย่างไรก็ตามผู้ขายมักต้องการให้ผู้ใช้ทำซ้ำจากและไปยังอาร์เรย์ที่คล้ายกัน ข้อกำหนดนี้อาจเป็นค่าใช้จ่ายโดยเฉพาะอย่างยิ่งเมื่อคุณใช้ดิสก์ประสิทธิภาพสูงในไซต์หลักของคุณและตอนนี้ต้องใช้ข้อมูลเดียวกันในไซต์รองของคุณ นอกจากนี้โซลูชันที่เก็บข้อมูลจะจำลองแบบผ่าน Fibre Channel และมักต้องการฮาร์ดแวร์พิเศษเพื่อส่งข้อมูลผ่านเครือข่าย IP ซึ่งจะช่วยเพิ่มค่าใช้จ่ายเพิ่มเติม ทางเลือกในการจัดเก็บข้อมูลจะให้ประโยชน์ในการแก้ปัญหาแบบครบวงจรจากผู้จัดจำหน่ายสตอเรจ โซลูชันเหล่านี้ใช้ประโยชน์จากคอนโทรลเลอร์ของอาร์เรย์การจัดเก็บข้อมูลเป็นแพลตฟอร์มปฏิบัติการสำหรับฟังก์ชันการจำลองแบบ การผสานรวมฮาร์ดแวร์และซอฟต์แวร์อย่างราบรื่นช่วยให้ผู้ควบคุมระบบจัดเก็บข้อมูลควบคุมค่าคอนฟิกูเรชันการจำลองแบบได้อย่างไม่เคยปรากฏมาก่อนและช่วยให้สามารถรับประกันได้ในระดับบริการซึ่งยากที่จะตรงกับวิธีการจำลองแบบอื่น ๆ ผู้จำหน่ายพื้นที่เก็บข้อมูลส่วนใหญ่ได้ปรับแต่งผลิตภัณฑ์ของตนเพื่อเสริมการทำงานแบบเสมือนเซิร์ฟเวอร์และใช้คุณลักษณะที่สำคัญเช่น failover ในการจัดเก็บเครื่องเสมือน บางรัฐวิสาหกิจอาจมีความสัมพันธ์ทางธุรกิจที่ยาวนานกับผู้จัดเก็บข้อมูลที่เฉพาะเจาะจง ในกรณีเช่นนี้โซลูชันการจัดเก็บข้อมูลอาจเหมาะสมกับความต้องการ

ทางเลือก

อย่างไรก็ตามคุณภาพของบริการมีมูลค่าสูง การจำลองแบบตามพื้นที่เก็บข้อมูลจะกำหนดเงื่อนไขเบื้องต้นของการกำหนดค่าอุปกรณ์จัดเก็บข้อมูลแบบเหมือนกัน ซึ่งหมายความว่าอาร์เรย์สตอเรจ high-end ที่กำหนดค่าไว้เหมือนกันสองชุดต้องถูกนำมาใช้เพื่อสนับสนุนฟังก์ชันการจำลองแบบเพิ่มค่าใช้จ่ายและผูกองค์กรกับโซลูชันการจัดเก็บข้อมูลของผู้ขายรายหนึ่ง การล็อกนี้ไปยังผู้จัดเก็บข้อมูลเฉพาะอาจเป็นข้อเสียเปรียบ ผู้จัดจำหน่ายระบบจัดเก็บข้อมูลบางรายมีข้อ จำกัด ด้านความเข้ากันได้ในสายผลิตภัณฑ์จัดเก็บข้อมูลซึ่งอาจทำให้การอัพเกรดเทคโนโลยีและการโยกย้ายข้อมูลมีราคาแพง เมื่อต้องการตรวจสอบทางเลือกในการจัดเก็บข้อมูลผู้จัดการด้านไอทีควรคำนึงถึงต้นทุนการเป็นเจ้าของทั้งหมด: ค่าลิขสิทธิ์สัญญาในอนาคตและสัญญาสนับสนุนจะมีผลต่อค่าใช้จ่ายในระยะยาว ค่าใช้จ่ายเป็นข้อพิจารณาที่สำคัญ แต่ได้รับผลกระทบจากปัจจัยหลายอย่างที่นอกเหนือจากค่าใบอนุญาต การแก้ปัญหาต้องใช้ฮาร์ดแวร์เฉพาะหรือสามารถใช้กับฮาร์ดแวร์ที่มีอยู่ก่อนได้หรือไม่? โซลูชันนี้ต้องการการขยายโครงสร้างพื้นฐานของเครือข่ายหรือไม่และถ้าใช่เท่าไร? หากคุณกำลังใช้การจำลองแบบเพื่อวางสำเนาข้อมูลสำรองไว้ในเซิร์ฟเวอร์เก็บข้อมูลหรือไซต์ที่แยกต่างหากโปรดทราบว่าวิธีการนี้แสดงถึงความซ้ำซ้อนของฮาร์ดแวร์บางอย่าง ผลิตภัณฑ์การจำลองแบบที่ให้ทางเลือกในการจัดโครงสร้างใหม่ที่มีอยู่เพื่อตอบสนองความต้องการของฮาร์ดแวร์ที่ซ้ำซ้อนต้องการเงินทุนที่น้อยลง

ข้อดีและข้อเสีย

ก่อนที่จะตัดสินใจเลือกโซลูชันการจำลองแบบโฮสต์หรือโซลูชันการเก็บข้อมูลให้พิจารณาข้อดีและข้อเสียของแต่ละอย่างอย่างรอบคอบตามที่แสดงในตารางต่อไปนี้

การจำลองแบบตามโฮสต์ การจำลองแบบ Storage-Based
ข้อดี
  • ไม่เชื่อเรื่องพระเจ้าการจัดเก็บ
  • ซิงค์และการซิงค์
  • ข้อมูลสามารถอยู่ในที่จัดเก็บข้อมูลใด ๆ
  • ไม่ได้รับผลกระทบจากการอัปเกรดการจัดเก็บ
  • ผู้ให้บริการรายเดียวสำหรับการจัดเก็บและจำลองข้อมูล
  • ไม่มีภาระในระบบโฮสต์
  • OS Agnostic
จุดด้อย
  • การใช้ทรัพยากรคอมพิวเตอร์ในโฮสต์


  • ผู้ขายล็อคอิน
  • ต้นทุนที่สูงขึ้น
  • ข้อมูลต้องอยู่ในอาร์เรย์
  • ข้อ จำกัด ทางไกลของ Fibre Channel
Fit ที่ดีที่สุด
  • สภาพแวดล้อมการจัดเก็บข้อมูลผู้ขายหลายราย
  • ต้องการตัวเลือกในการซิงค์หรือการซิงโครนัส
  • การใช้คลัสเตอร์ failover
  • ทำซ้ำเพื่อเป้าหมายหลายรายการ
  • ต้องการผู้ขายรายเดียว
  • จำกัด ระยะทางและสภาพแวดล้อมที่ควบคุมได้
  • ทำซ้ำไปยังเป้าหมายเดี่ยว

  เพื่อทำความเข้าใจว่า SIOS สามารถทำงานบนแพลตฟอร์มเพื่อจำลองข้อมูลได้อย่างไรอ่านเรื่องราวความสำเร็จของเราทำซ้ำโดยได้รับอนุญาตจาก Linuxclustering

Filed Under: ทำให้เข้าใจง่ายเซิร์ฟเวอร์คลัสเตอร์ Tagged With: แพลตฟอร์มเพื่อทำซ้ำข้อมูล

สมการความพร้อมใช้งาน – โซลูชั่นความพร้อมใช้งานสูง

ธันวาคม 9, 2018 by Jason Aw Leave a Comment

สมการความพร้อมใช้งาน - High Availability Solutions.jpg

สมการความพร้อมใช้งาน

คุณคุ้นเคยกับสมการความพร้อมใช้งานหรือไม่? สรุปย่อสมการนี้แสดงให้เห็นว่าเวลารวมที่จำเป็นในการเรียกคืนแอพพลิเคชันให้ใช้งานได้เท่ากับเวลาที่ต้องใช้ในการตรวจพบว่าแอปพลิเคชันกำลังประสบปัญหารวมถึงเวลาที่ต้องใช้ในการดำเนินการการกู้คืน:

TRESTORE = TDETECT + TRECOVER

แนวคิดหลักของโซลูชันด้านความพร้อมในการใช้งานสูง

สมการแนะนำแนวคิดหลักของการมีอยู่สูง (HA): การจัดกลุ่มการตรวจหาปัญหาและการกู้คืนที่ตามมา โซลูชั่น HA ตรวจสอบสุขภาพของส่วนประกอบแอพพลิเคชั่นทางธุรกิจ เมื่อมีการตรวจพบปัญหาการแก้ปัญหาเหล่านี้จะทำหน้าที่คืนค่าบริการดังกล่าว วัตถุประสงค์ของการปรับใช้โซลูชันความพร้อมใช้งานสูงคือการลดเวลาการหยุดทำงาน การลดเวลาในการตรวจจับและกู้คืนเป็นงานสำคัญสองประการของโซลูชัน HA ที่คุณเลือกใช้ แอพพลิเคชันในปัจจุบันเป็นเทคโนโลยีที่รวมกัน: เซิร์ฟเวอร์การจัดเก็บข้อมูลโครงสร้างพื้นฐานของระบบเครือข่ายและอื่น ๆ เมื่อตรวจสอบตัวเลือก HA ของคุณโปรดมั่นใจว่าคุณเข้าใจเทคโนโลยีที่แต่ละโซลูชันใช้ในการตรวจจับและกู้คืนข้อมูลจากประเภทหยุดทำงานทั้งหมด เทคโนโลยีแต่ละชิ้นมีผลกระทบโดยตรงต่อเวลาในการฟื้นฟูบริการ

การตรวจจับและการกู้คืนในเครื่อง

โซลูชันความพร้อมใช้งานสูงตรงไปตรงมา เทคโนโลยีหนึ่งที่มีความสำคัญอย่างยิ่งต่อการคืนเวลาที่เร็วที่สุดเท่าที่เป็นไปได้คือการตรวจจับและกู้คืนข้อมูลในท้องถิ่น (aka การตรวจหาและกู้คืนปัญหาระดับบริการ) ในโซลูชันการจัดกลุ่มพื้นฐานเซิร์ฟเวอร์จะเชื่อมต่ออยู่ มีการกำหนดค่าให้เซิร์ฟเวอร์หนึ่งเครื่องหรือมากกว่าสามารถใช้การดำเนินงานของอีกเครื่องหนึ่งได้ในกรณีที่เซิร์ฟเวอร์ขัดข้อง โหนดเซิร์ฟเวอร์ในคลัสเตอร์จะส่งแพ็คเก็ตข้อมูลขนาดเล็กซึ่งมักเรียกว่าสัญญาณ heartbeat ซึ่งกันและกันเพื่อระบุว่าเป็น "alive" ในสภาวะแวดล้อมแบบคลัสเตอร์แบบคลัสเตอร์เมื่อเซิร์ฟเวอร์หนึ่งเครื่องหยุดการทำงานของ heartbeats สมาชิกกลุ่มอื่น ๆ จะถือว่าเซิร์ฟเวอร์นี้ไม่ทำงาน จากนั้นจะเริ่มดำเนินการรับผิดชอบต่อโดเมนที่ใช้งานเซิร์ฟเวอร์ วิธีนี้เพียงพอสำหรับการตรวจจับความล้มเหลวในระดับเซิร์ฟเวอร์ แต่ถ้าปัญหาไม่หยุดชะงักหรือหยุดสัญญาณ heartbeat การตรวจสอบระดับเซิร์ฟเวอร์ไม่เพียงพอ มากกว่านั้นจริงสามารถขยายขอบเขตและผลกระทบของการหยุดทำงาน ตัวอย่างเช่นถ้ากระบวนการของ Apache ถูกแขวนเซิร์ฟเวอร์อาจส่ง heartbeats แม้ว่าระบบย่อยเว็บเซิร์ฟเวอร์จะหยุดทำงานหลักแล้วก็ตาม แทนที่จะรีสตาร์ทระบบย่อยของ Apache บนเซิร์ฟเวอร์เดียวกันหรือเซิร์ฟเวอร์อื่นโซลูชันการจัดกลุ่มตามระดับเซิร์ฟเวอร์ขั้นพื้นฐานจะรีสตาร์ทชุดซอฟต์แวร์ทั้งหมดของเซิร์ฟเวอร์ที่ล้มเหลวบนเซิร์ฟเวอร์สำรองซึ่งจะทำให้ผู้ใช้หยุดชะงักและยืดเวลาการกู้คืน

มันทำงานอย่างไร

การใช้การตรวจจับและกู้คืนในระดับท้องถิ่นโซลูชันการจัดกลุ่มขั้นสูงจะติดตั้งตัวแทนการตรวจสอบด้านสุขภาพภายในเซิร์ฟเวอร์คลัสเตอร์แต่ละเครื่องเพื่อตรวจสอบส่วนประกอบต่างๆของระบบต่างๆเช่นระบบไฟล์ฐานข้อมูลแอพพลิเคชันระดับผู้ใช้ที่อยู่ IP เป็นต้น ตัวแทนเหล่านี้ใช้ heuristics ที่เฉพาะเจาะจงกับส่วนประกอบที่ได้รับการตรวจสอบ ดังนั้นตัวแทนสามารถทำนายและตรวจพบปัญหาการดำเนินงานและดำเนินการแก้ไขปัญหาที่เหมาะสมที่สุด บ่อยครั้งวิธีการกู้คืนที่มีประสิทธิภาพที่สุดคือการหยุดและรีสตาร์ทระบบย่อยปัญหาบนเซิร์ฟเวอร์เดียวกัน เวลาในการกู้คืนแอปพลิเคชันต่อความพร้อมใช้งานของผู้ใช้จะลดลงอย่างมากโดยทำให้การกู้คืนภายในเซิร์ฟเวอร์ทางกายภาพเดียวกัน นอกจากนี้โดยการตรวจจับความล้มเหลวในระดับละเอียดมากขึ้นกว่าเพียงแค่การสังเกต heartbeats ระดับเซิร์ฟเวอร์ โซลูชันเช่น SteelEye Protection Suite สำหรับ Linux จาก SIOS ให้การตรวจจับและกู้คืนระดับนี้สำหรับสภาพแวดล้อมของคุณ  ตรวจสอบให้แน่ใจว่าโซลูชัน HA ใดที่คุณใช้สามารถใช้ในการตรวจจับและกู้คืนข้อมูลในท้องถิ่นได้ คุณต้องการที่จะเพลิดเพลินไปกับการแก้ปัญหาความพร้อมใช้งานสูงสำหรับโครงการของคุณ? เช็คอินกับเรา ต้องการข้อมูลเพิ่มเติมนี่คือเรื่องราวความสำเร็จของเรา ทำซ้ำโดยได้รับอนุญาตจาก Linuxclustering

Filed Under: Datakeeper, ทำให้เข้าใจง่ายเซิร์ฟเวอร์คลัสเตอร์ Tagged With: โซลูชันความพร้อมใช้งานสูง

12 รายการตรวจสอบรายการสำหรับการเลือกโซลูชันความพร้อมใช้งานสูง

ธันวาคม 6, 2018 by Jason Aw Leave a Comment

การเลือกโซลูชันความพร้อมใช้งานสูง

รายการตรวจสอบ 12 รายการสำหรับการเลือกโซลูชันความพร้อมใช้งานสูง

เมื่อเลือกโซลูชันที่มีประสิทธิภาพสูงคุณควรพิจารณาเกณฑ์ต่างๆ ค่าเหล่านี้ครอบคลุมตั้งแต่ค่าใช้จ่ายทั้งหมดของโซลูชันเพื่อความสะดวกในการกำหนดค่าและจัดการคลัสเตอร์กับข้อ จำกัด เฉพาะที่วางไว้บนฮาร์ดแวร์และซอฟต์แวร์ โพสต์นี้จะกล่าวถึงรายการตรวจสอบที่สำคัญที่สุด 12 รายการ

1 การสนับสนุนสำหรับระบบปฏิบัติการมาตรฐานและเวอร์ชันแอ็พพลิเคชัน

โซลูชันที่ต้องใช้ระบบปฏิบัติการระบบฐานข้อมูลหรือซอฟต์แวร์แอ็พพลิเคชันขั้นสูงขององค์กรจะช่วยลดประโยชน์ด้านต้นทุนของการย้ายไปยังระบบเซิร์ฟเวอร์โภคภัณฑ์ได้อย่างมาก ปรับใช้ middleware HA ที่เหมาะสม ด้วยวิธีนี้คุณจะสามารถใช้แอพพลิเคชันและ OS เวอร์ชันมาตรฐานได้ และในเวลาเดียวกันให้ตรงกับข้อกำหนดด้านสภาพแวดล้อมทางธุรกิจของ uptime

2 การสนับสนุนสำหรับการจัดเก็บข้อมูลหลากหลายรูปแบบ

เมื่อคุณปรับใช้ HA คลัสเตอร์ข้อมูลที่แอ็พพลิเคชันที่ได้รับการป้องกันต้องการจะต้องพร้อมใช้งานกับระบบทั้งหมดที่อาจต้องนำแอพพลิเคชันไปใช้บริการ คุณสามารถแชร์ข้อมูลนี้ผ่านการจำลองแบบข้อมูลโดยใช้ที่เก็บข้อมูล SCSI หรือช่องเก็บข้อมูล Fibre Channel หรือใช้อุปกรณ์ NAS คุณใช้วิธีใดในการปรับใช้ผลิตภัณฑ์ HA ที่คุณใช้จะต้องสามารถรองรับการกำหนดค่าข้อมูลทั้งหมดเพื่อให้คุณสามารถเปลี่ยนแปลงได้ตามความต้องการทางธุรกิจของคุณ

3 ความสามารถในการใช้ส่วนประกอบของโซลูชั่นที่ไม่เหมือนกัน

บางโซลูชั่น HA Clustering ต้องการให้ทุกระบบภายในคลัสเตอร์มีการกำหนดค่าเหมือนกัน ข้อกำหนดนี้เป็นเรื่องธรรมดาในหมู่โซลูชั่นฮาร์ดแวร์เฉพาะที่เทคโนโลยีการจัดกลุ่มมีจุดประสงค์เพื่อแยกเซิร์ฟเวอร์หรือที่จัดเก็บข้อมูลและในหมู่ผู้ขายระบบปฏิบัติการที่ต้องการ จำกัด การกำหนดค่าที่จำเป็นสำหรับการสนับสนุน ข้อ จำกัด นี้จำกัดความสามารถในการปรับใช้เซิร์ฟเวอร์แบบปรับขนาดลงเป็นโหนดสำรองชั่วคราวและเพื่อนำฮาร์ดแวร์ที่มีอยู่ไปใช้ซ้ำในการปรับใช้คลัสเตอร์ของคุณ การปรับใช้เซิร์ฟเวอร์ที่กำหนดค่าไว้เหมือนกันอาจเป็นทางเลือกที่ถูกต้องสำหรับความต้องการของคุณ แต่การตัดสินใจไม่ควรกำหนดโดยผู้ให้บริการโซลูชัน HA ของคุณ

4 รองรับมากกว่าสองโหนดภายในคลัสเตอร์

จำนวนโหนดที่สามารถรองรับในคลัสเตอร์เป็นตัววัดที่สำคัญของความยืดหยุ่น โซลูชัน HA ระดับเริ่มต้นจะ จำกัด ให้คุณใช้คลัสเตอร์สองโหนดโดยปกติจะอยู่ในโหมดใช้งาน / passive แม้ว่าการกำหนดค่านี้จะให้ความพร้อมใช้งานที่เพิ่มขึ้น (โดยการเพิ่มเซิร์ฟเวอร์สแตนด์บาย) แต่ก็ยังทำให้คุณไม่ต้องกังวลกับการหยุดทำงานของแอปพลิเคชัน ในการกำหนดค่าคลัสเตอร์แบบสองโหนดหากเซิร์ฟเวอร์หนึ่งเครื่องไม่ทำงานไม่ว่าด้วยเหตุผลใด ๆ เซิร์ฟเวอร์ที่เหลือจะกลายเป็นจุดล้มเหลวเพียงจุดเดียว คุณสามารถเพิ่มความสามารถในการป้องกันได้ด้วยการจัดกลุ่มโหนดสามโหนดขึ้นไป ในเวลาเดียวกันคุณยังสามารถสร้างการกำหนดค่าที่ปรับขนาดได้สูง

5 รองรับ Active / Active และ Active / Standby Configurations

การเลือกโซลูชันความพร้อมใช้งานสูงเพื่อให้เหมาะกับโครงการของคุณเป็นสิ่งสำคัญ ในการกำหนดค่าใช้งาน / สแตนด์บายหนึ่งเซิร์ฟเวอร์ไม่ได้ใช้งานรอที่จะรับภาระงานของสมาชิกคลัสเตอร์ของตน การตั้งค่านี้มีข้อเสียที่เห็นได้ชัดของการใช้ทรัพยากรของคุณในการคำนวณหามูลค่าไม่เพียงพอ เพื่อให้ได้รับประโยชน์สูงสุดจากค่าใช้จ่ายด้านไอทีของคุณให้ตรวจสอบว่าโหนดคลัสเตอร์สามารถทำงานในการกำหนดค่าใช้งาน / ใช้งานได้

6 การตรวจหาปัญหาที่โหนดและระดับการบริการส่วนบุคคล

ผลิตภัณฑ์ซอฟต์แวร์ HA ทั้งหมดสามารถตรวจพบปัญหาเกี่ยวกับฟังก์ชันการทำงานของเซิร์ฟเวอร์คลัสเตอร์ได้ งานนี้ทำโดยการส่งสัญญาณ heartbeat ระหว่างเซิร์ฟเวอร์ภายในคลัสเตอร์และเริ่มการกู้คืนหากสมาชิกกลุ่มหยุดส่งสัญญาณ แต่โซลูชัน HA ขั้นสูงยังสามารถตรวจจับปัญหาอื่นได้อีกด้วย หนึ่งที่เกิดขึ้นเมื่อแต่ละกระบวนการหรือบริการพบปัญหาที่ทำให้ไม่สามารถใช้งานได้ แต่ไม่ทำให้เซิร์ฟเวอร์หยุดการส่งหรือตอบสนองต่อสัญญาณ heartbeat เนื่องจากหน้าที่หลักของซอฟต์แวร์ HA คือการทำให้แน่ใจว่าแอพพลิเคชันจะพร้อมใช้งานสำหรับผู้ใช้ปลายทางการตรวจจับและการกู้คืนจากการขัดจังหวะระดับบริการเป็นคุณลักษณะที่สำคัญ ตรวจสอบให้แน่ใจว่าโซลูชัน HA ของคุณสามารถตรวจพบปัญหาทั้งโหนดและระดับบริการได้

7 การสนับสนุนสำหรับการกู้คืนโหนดและโหนดข้ามโหนด

ความสามารถในการดำเนินการกู้คืนทั้งในโหนดคลัสเตอร์และภายในโหนดเป็นสิ่งสำคัญ ในการกู้คืนข้ามโหนดหนึ่งโหนดจะใช้เวลามากกว่าโดเมนที่สมบูรณ์ของความรับผิดชอบสำหรับอีก เมื่อมีการพลาดจังหวะการเต้นของระบบในระดับเซิร์ฟเวอร์เซิร์ฟเวอร์ที่ควรส่งข้อมูล heartbeats จะไม่สามารถใช้งานได้และสมาชิกกลุ่มอื่นจะเริ่มต้นการกู้คืน ด้วยการกู้คืนในโหนดหรือภายในระบบบริการระบบล้มเหลวครั้งแรกจะได้รับการกู้คืนภายในเซิร์ฟเวอร์ที่ใช้งานอยู่ งานนี้โดยทั่วไปจะทำโดยการหยุดทำงานและรีสตาร์ทเซอร์วิสและทรัพยากรระบบที่ขึ้นอยู่กับระบบ วิธีการกู้คืนข้อมูลนี้ทำได้รวดเร็วและลดเวลาหยุดทำงาน

8 ความโปร่งใสในการเชื่อมต่อไคลเอ็นท์ของการกู้คืนฝั่งเซิร์ฟเวอร์

การกู้คืนฝั่งเซิร์ฟเวอร์ของแอ็พพลิเคชันหรือแม้แต่โหนดทั้งหมดควรโปร่งใสสำหรับผู้ใช้ฝั่งไคลเอ็นต์ ผ่านการใช้ที่อยู่ IP เสมือนหรือชื่อเซิร์ฟเวอร์การทำแผนที่ของทรัพยากรการคำนวณเสมือนลงในหน่วยงานคลัสเตอร์ทางกายภาพระหว่างการกู้คืนและการอัปเดตตารางเส้นทางเครือข่ายโดยอัตโนมัติไม่จำเป็นต้องเปลี่ยนแปลงระบบไคลเอ็นต์เพื่อให้ระบบเข้าถึงแอปพลิเคชันและข้อมูลที่กู้คืน โซลูชันที่ต้องการการเปลี่ยนแปลงการกำหนดค่าฝั่งไคลเอ็นต์ด้วยตนเองในการเข้าถึงแอปพลิเคชันที่กู้คืนจะช่วยเพิ่มเวลาในการกู้คืน พวกเขาแนะนำความเสี่ยงของข้อผิดพลาดเพิ่มเติมเนื่องจากการปฏิสัมพันธ์ของมนุษย์ที่จำเป็น การกู้คืนควรเป็นแบบอัตโนมัติทั้งบนเซิร์ฟเวอร์และไคลเอ็นต์

9 การป้องกันสำหรับเวลาที่วางแผนไว้และไม่ได้วางแผนไว้

นอกเหนือจากการป้องกันการขัดข้องของบริการที่ไม่ได้วางแผนแล้วโซลูชัน HA ที่คุณใช้ควรใช้งานได้เป็นเครื่องมือในการบริหารเพื่อลดการหยุดทำงานเนื่องจากกิจกรรมการบำรุงรักษา คุณสามารถย้ายแอ็พพลิเคชันและผู้ใช้ไปยังเซิร์ฟเวอร์เครื่องที่สองได้ขณะที่ทำการบำรุงรักษาในส่วนแรกเพื่อให้สามารถเคลื่อนย้ายแอ็พพลิเคชันระหว่างสมาชิกคลัสเตอร์ได้ตามต้องการ ซึ่งจะช่วยลดความจำเป็นในการบำรุงรักษาระบบวินโดว์สซึ่งทรัพยากรไอทีไม่สามารถใช้งานได้กับผู้ใช้ปลายทาง ตรวจสอบให้แน่ใจว่าโซลูชัน HA ของคุณเป็นวิธีการที่ง่ายและปลอดภัยสำหรับการดำเนินการตามความต้องการในการใช้งานและทรัพยากรที่จำเป็นระหว่างโหนดคลัสเตอร์

10 การป้องกันแบบ Off-The-Shelf สำหรับฟังก์ชั่นธุรกิจทั่วไป

โซลูชัน HA ทุกตัวที่คุณประเมินควรรวมถึงตัวแทนหรือโมดูลที่ได้รับการทดสอบและสนับสนุนซึ่งออกแบบมาเพื่อตรวจสอบสุขภาพของทรัพยากรระบบที่เฉพาะเจาะจง ได้แก่ ระบบไฟล์ที่อยู่ IP ฐานข้อมูลแอพพลิเคชันและอื่น ๆ โมดูลเหล่านี้มักเรียกว่าโมดูลการกู้คืน คุณจะได้รับประโยชน์จากทั้งเวลาทำงานที่ผู้ขายและลูกค้ารายอื่น ๆ ได้ทำไปแล้ว นอกจากนี้คุณยังมีความมั่นใจในการสนับสนุนและการบำรุงรักษาคอมโพเนนต์โซลูชันเหล่านี้อย่างต่อเนื่อง

11 ความสามารถในการผสานรวมการป้องกันสำหรับแอ็พพลิเคชันทางธุรกิจที่กำหนดเองได้อย่างง่ายดาย

อาจมีแอพพลิเคชันที่อาจกำหนดเองให้แก่ บริษัท ของคุณซึ่งคุณต้องการปกป้อง แต่ไม่มีโมดูลการกู้คืนที่ผู้ให้บริการจัดหาให้ เป็นสิ่งสำคัญดังนั้นคุณจึงมีวิธีการในการรวมแอพพลิเคชั่นทางธุรกิจของคุณเข้ากับรูปแบบการป้องกันของ HA solution ได้อย่างง่ายดาย คุณควรจะสามารถทำเช่นนี้ได้โดยไม่ต้องแก้ไขแอพพลิเคชันของคุณโดยเฉพาะอย่างยิ่งโดยไม่ต้องฝัง APIs เฉพาะของผู้ให้บริการใด ๆ ควรมีชุดเครื่องมือสำหรับนักพัฒนาซอฟต์แวร์ที่ให้ตัวอย่างและขั้นตอนการป้องกันแอปพลิเคชันของคุณทีละขั้นตอน นอกจากนี้พร้อมกับผู้ให้บริการสนับสนุนที่ให้ความช่วยเหลือตามความจำเป็น

12 ความง่ายในการใช้งานและการบริหารคลัสเตอร์

ตำนานทั่วไปเกี่ยวกับกลุ่ม HA คือการใช้และจัดการกับค่าใช้จ่ายเหล่านี้มีราคาแพงและซับซ้อน นี้ไม่จำเป็นต้องเป็นความจริง อินเทอร์เฟซการจัดการคลัสเตอร์ควรเป็นตัวช่วยสร้างเพื่อช่วยในการกำหนดค่าคลัสเตอร์เริ่มต้น ควรรวมถึงการค้นพบองค์ประกอบใหม่ ๆ โดยอัตโนมัติเมื่อมีการเพิ่มลงในคลัสเตอร์ ในทำนองเดียวกันควรอนุญาตให้มีการตรวจสอบสถานะอย่างรวดเร็วของทั้งกลุ่ม สุดท้ายต้องจัดเก็บข้อมูลเมตาของกลุ่มใด ๆ ไว้ในแบบ HA ไม่ได้อยู่ในดิสก์ครบองค์ประชุมภายในคลัสเตอร์ซึ่งการทุจริตหรือการหยุดทำงานอาจทำให้ทั้งกลุ่มกระจุยกระจายได้ เมื่อมองหาขีดความสามารถในรายการตรวจสอบนี้คุณสามารถตัดสินใจได้ดีที่สุดสำหรับความต้องการ HA เฉพาะของคุณ การเลือกโซลูชันความพร้อมใช้งานสูงไม่ใช่วิทยาศาสตร์จรวด นี่คือเรื่องราวความสำเร็จของเราทำซ้ำโดยได้รับอนุญาตจาก Linuxclustering

Filed Under: ทำให้เข้าใจง่ายเซิร์ฟเวอร์คลัสเตอร์ Tagged With: เลือกโซลูชันที่มีประสิทธิภาพสูง

คุณรู้หรือไม่ว่าแบนด์วิดธ์รองรับการจำลองแบบเรียลไทม์ได้อย่างไร?

ธันวาคม 5, 2018 by Jason Aw Leave a Comment

แบนด์วิดท์เพื่อรองรับการจำลองแบบเรียลไทม์

แบนด์วิดธ์เท่าใดเพื่อสนับสนุนการจำลองแบบเรียลไทม์?

เมื่อคุณต้องการทำซ้ำข้อมูลในการกำหนดค่าหลายไซต์หรือเครือข่ายบริเวณกว้าง (WAN) คุณต้องตอบคำถามสำคัญประการแรก: มีแบนด์วิธที่เพียงพอสำหรับการทำซ้ำพาร์ติชันและเก็บมิเรอร์ในสถานะมิเรอร์เป็นพาร์ติชันต้นฉบับหรือไม่ ปรับปรุงตลอดทั้งวัน? การรักษากระจกในสภาวะสะท้อนเป็นสิ่งสำคัญ การเปลี่ยนพาร์ติชันจะได้รับอนุญาตเฉพาะเมื่อกระจกอยู่ในสถานะการมิเรอร์

ดังนั้นขั้นตอนแรกที่สำคัญเพื่อหาจำนวนแบนด์วิดท์ที่จะสนับสนุนการจำลองแบบเรียลไทม์คือการกำหนดความต้องการแบนด์วิธของเครือข่ายของคุณ คุณจะวัดอัตราการเปลี่ยนแปลงได้อย่างไร – ค่าที่ระบุจำนวนแบนด์วิธเครือข่ายที่จำเป็นในการทำซ้ำข้อมูลของคุณหรือไม่

กำหนดอัตราการเปลี่ยนแปลงขั้นพื้นฐาน

ขั้นแรกให้ใช้คำสั่งเหล่านี้เพื่อกำหนดอัตราการเปลี่ยนแปลงขั้นพื้นฐานต่อวันสำหรับไฟล์หรือพาร์ทิชันที่คุณต้องการทำกระจก ตัวอย่างเช่นในการวัดปริมาณข้อมูลที่เขียนในวันที่ / dev / sda3 ให้เรียกใช้คำสั่งนี้ในตอนต้นของวัน: MB_START = 'awk' / sda3 / {print $ 10/2/1024} '/ proc / diskstats `รอ 24 ชั่วโมงแล้วรันคำสั่งนี้: MB_END = 'awk' / sda3 / {print $ 10/2/1024} '/ proc / diskstats` อัตราการเปลี่ยนแปลงรายวันเป็นเมกะไบต์คือ MB_END – MB_START จำนวนข้อมูลที่คุณสามารถกดผ่านการเชื่อมต่อเครือข่ายต่างๆมีดังนี้:

  • สำหรับ T1 (1.5Mbps): 14,000 MB / วัน (14 GB)
  • สำหรับ T3 (45Mbps): 410,000 MB / วัน (410 GB)
  • สำหรับ Gigabit (1Gbps): 5,000,000 MB / วัน (5 TB)

กำหนดอัตราการเปลี่ยนแปลงโดยละเอียด

มีอะไรต่อไปในการคำนวณแบนด์วิดท์เพื่อสนับสนุนการจำลองแบบเรียลไทม์? คุณจะต้องวัดอัตราการเปลี่ยนแปลงโดยละเอียด วิธีที่ดีที่สุดในการรวบรวมข้อมูลนี้คือการบันทึกกิจกรรมการเขียนดิสก์เป็นระยะเวลาหนึ่ง (เช่นหนึ่งวัน) เพื่อกำหนดช่วงเวลาในการเขียนข้อมูลสูงสุด เมื่อต้องการทำเช่นนี้ให้สร้างงาน cron ที่จะบันทึกเวลาของระบบตามด้วยการถ่ายโอนข้อมูลของ / proc / diskstats ตัวอย่างเช่นในการเก็บรวบรวมสถิติดิสก์ทุกๆ 2 นาทีให้เพิ่มลิงก์นี้ลงใน / etc / crontab: * / 2 * * * * root (วันที่ cat / proc / diskstats) >> /path_to/filename.txt รอจนกว่าระยะเวลาที่กำหนด (เช่นหนึ่งวันหนึ่งสัปดาห์) จากนั้นปิดใช้งาน cron และบันทึกไฟล์ผลลัพธ์ผลลัพธ์ / proc / diskstats ไว้ในตำแหน่งที่ปลอดภัย

วิเคราะห์และกราฟอัตรารายละเอียดของข้อมูลการเปลี่ยนแปลง

ถัดไปคุณควรวิเคราะห์อัตราการเปลี่ยนแปลงข้อมูลโดยละเอียด คุณสามารถใช้ยูทิลิตี roc-calc-diskstats สำหรับงานนี้ ยูทิลิตีนี้จะใช้ไฟล์ผลลัพธ์ / proc / diskstats และคำนวณอัตราการเปลี่ยนแปลงของดิสก์ในชุดข้อมูล ให้ใช้คำสั่งนี้: # ./roc-calc-diskstats <interval> <start_time> <diskstats-data-file> [dev-list] ตัวอย่างเช่นการ dumps ต่อไปนี้สรุป (โดยมียอดต่อดิสก์สูงสุด I / O ข้อมูล) ไปยังแฟ้มผลลัพธ์ output.txt: # ./roc-calc-diskstats 2m "Jul 22 16:04:01 "/root/diskstats.txt sdb1, sdb2, sdc1> results.txt นี่คือตัวอย่างผลลัพธ์จากไฟล์ results.txt: เวลาเริ่มต้นตัวอย่าง: อังคาร 12 ก.ค. 23:44:01 2011 เวลาสิ้นสุดตัวอย่าง: พุธ 13 ก.ค. 23:58:01 2011 ตัวอย่างช่วงเวลา: 120 วินาที # ตัวอย่าง: 727 ความยาวตัวอย่าง: 87240 วินาที (ครั้งดิบจากไฟล์: อังคาร 12 ก.ค. 23:44:01 EST 2011, พ.ค. 13 23:58:01 EST 2011) อัตราการเปลี่ยนแปลงสำหรับอุปกรณ์ dm-31, dm-32, dm-33, dm-4, dm-5, total dm-31 peak: 0.0 B / s (0.0 b / s) (@ Tue Jul 12 23:44:01 2011) เฉลี่ย: 0.0 B / s (0.0 b / s) dm-32 สูงสุด: 398.7 KB / s (3.1 Mb / s) (@ พ.ค. 13 19:28:01 2011) เฉลี่ย: 19.5 KB / s (156.2 Kb / วินาที) dm-33 peak: 814.9 KB / s (6.4 Mb / s) (@ พ.ค. 13 23:58:01 2011) เฉลี่ย: 11.6 KB / s (92.9 Kb / เดือน) dm-4 peak: 185.6 KB / s (1.4 Mb / s) (@ พ.ค. 13 15:18:01 2011) เฉลี่ย: 25.7 KB / s (205.3 Kb / s) dm-5 สูงสุด: 2.7 MB / s (21.8 Mb / s) (@ พ.ค. 13 10:18:01 2011) เฉลี่ย: 293.0 KB / s (2.3 Mb / s) ยอดรวม: 2.8 MB / s (22.5 Mb / s) (@ พ.ค. 13 10:18:01 2011) เฉลี่ย: 349.8 KB / s (2.7 Mb / s) เพื่อช่วยให้คุณเข้าใจความต้องการแบนด์วิธที่เฉพาะเจาะจงในช่วงเวลาหนึ่ง ๆ คุณสามารถกราฟอัตราข้อมูลการเปลี่ยนแปลงโดยละเอียดได้ ข้อมูลการทิ้งข้อมูลต่อไปนี้จะแสดงกราฟข้อมูลไปยัง results.csv (เช่นเดียวกับการสรุปข้อมูลสรุปเป็น results.txt): # export OUTPUT_CSV = 1 # ./roc-calc-diskstats 2m "Jul 22 16:04:01” /root/diskstats.txt sdb1, sdb2, sdc1 2> results.csv> results.txt SIOS ได้สร้างสเปรดชีตเทมเพลต diskstats-template.xlsx ซึ่งมีข้อมูลตัวอย่างที่คุณสามารถเขียนทับข้อมูลของคุณจาก roc-calc -diskstats ภาพชุดต่อไปนี้แสดงขั้นตอนการใช้สเปรดชีต

  1. เปิด results.csv และเลือกแถวทั้งหมดรวมทั้งคอลัมน์ทั้งหมด

แบนด์วิดท์เพื่อรองรับการจำลองแบบเรียลไทม์

  1. เปิด diskstats-template.xlsx เลือกแผ่นงาน diskstats.csv

2 diskstats-แผ่น

  1. ในเซลล์ 1-A ให้คลิกขวาและเลือกแทรกเซลล์ที่คัดลอก
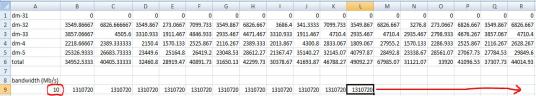
  2. ปรับค่าแบนด์วิธในเซลล์ไปทางด้านล่างซ้ายของแผ่นงาน (ตามที่แสดงในรูปต่อไปนี้) เพื่อแสดงปริมาณแบนด์วิธ (เมกะบิตต่อวินาที) ที่คุณได้จัดสรรไว้สำหรับการจำลองแบบ เซลล์ทางด้านขวาจะถูกแปลงเป็นไบต์ต่อวินาทีโดยอัตโนมัติเพื่อให้ตรงกับข้อมูลดิบที่เก็บรวบรวม

3 ขยายที่มีอยู่-bandwidth_536x96

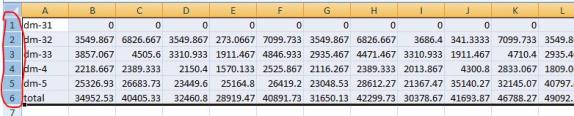
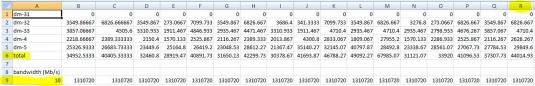
  1. จดเลขแถวและคอลัมน์ต่อไปนี้:
    • ยอดรวม (แถวที่ 6 ในรูปต่อไปนี้)
    • แบนด์วิดท์ (แถวที่ 9 ในรูปต่อไปนี้)
    • Lastapoint (คอลัมน์ R ในรูปต่อไปนี้)

4 โน้ตแถว colums_535x86

  1. เลือกแบทช์แบนด์กับโรงาน ROC

5 แบนด์วิดธ์แผ่น

  1. คลิกขวาที่กราฟและเลือกเลือกข้อมูล
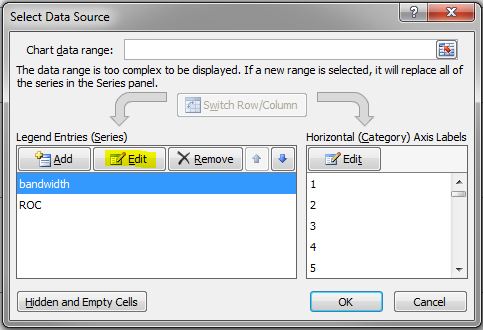
  2. ในกล่องโต้ตอบเลือกแหล่งข้อมูลให้เลือกแบนด์วิธในรายการรายการแบบหล่น (ชุด) จากนั้นคลิกแก้ไข

6 แก้ไขแบนด์วิดธ์

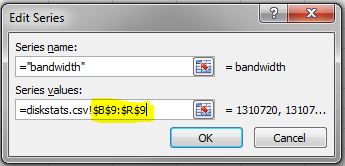
  1. ในกล่องโต้ตอบแก้ไขชุดให้ใช้ไวยากรณ์ต่อไปนี้ในฟิลด์ค่าชุด: = diskstats.csv! $ B $ <row>: $ <final_column> $ <row> รูปต่อไปนี้แสดงค่าชุดสำหรับการแพร่กระจาย B9 เป็น R9 .

7 แบนด์วิดธ์ค่า

  1. คลิกตกลงเพื่อปิดกล่อง Edit Series
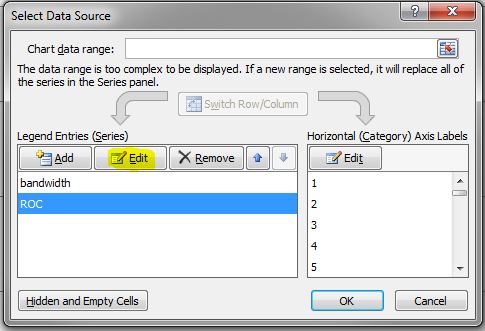
  2. ในกล่องเลือกแหล่งข้อมูลให้เลือก ROC ในรายการ (รายการ) ของรายการรหัสผลิตแล้วคลิกแก้ไข

8 แก้ไข-roc

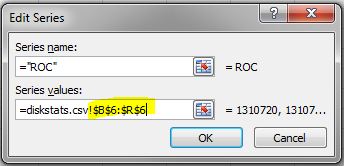
  1. ในกล่องโต้ตอบแก้ไขชุดให้ใช้ไวยากรณ์ต่อไปนี้ในฟิลด์ค่าชุด: = diskstats.csv! $ B $ <row>: $ <final_column> $ <row> รูปต่อไปนี้แสดงชุดค่าสำหรับการแพร่กระจาย B6 ไปเป็น R6 .

9 ร็อคค่า

  1. คลิก OK เพื่อปิดกล่อง Edit Series จากนั้นคลิก OK เพื่อปิดกล่อง Select Data Source

อัปเดตข้อมูล Bandwidth vs ROC วิเคราะห์ผลการค้นหาของคุณเพื่อพิจารณาว่าคุณมีแบนด์วิธเพียงพอที่จะสนับสนุนการจำลองแบบข้อมูลหรือไม่

ขั้นตอนถัดไป

หากอัตราการเปลี่ยนแปลงของคุณสูงกว่าแบนด์วิดท์ที่มีอยู่คุณจะต้องพิจารณาบางประเด็นต่อไปนี้เพื่อให้แน่ใจว่าโซลูชันการจำลองแบบของคุณทำงานได้ดีที่สุด:

  • เปิดใช้การบีบอัดในโซลูชันการจำลองแบบของคุณหรือในฮาร์ดแวร์เครือข่าย (DataKeeper for Linux ซึ่งเป็นส่วนหนึ่งของ SteelEye Protection Suite สำหรับ Linux รองรับการบีบอัดชนิดนี้)
  • สร้างพื้นที่เก็บข้อมูลที่เก็บข้อมูลแบบไม่ซ้ำกันสำหรับข้อมูลชั่วคราวและไฟล์สว็อปที่ไม่จำเป็นต้องทำซ้ำ
  • ลดจำนวนข้อมูลที่กำลังทำซ้ำ
  • เพิ่มขีดความสามารถเครือข่ายของคุณ

สำหรับวิธีการอย่างรวดเร็วเช่นการหาแบนด์วิดท์เพื่อรองรับการจำลองแบบเรียลไทม์อ่านบล็อกของเราทำซ้ำได้รับอนุญาตจาก Linuxclustering

Filed Under: ทำให้เข้าใจง่ายเซิร์ฟเวอร์คลัสเตอร์ Tagged With: เพื่อสนับสนุนการจำลองแบบเรียลไทม์

  • « Previous Page
  • 1
  • …
  • 82
  • 83
  • 84
  • 85
  • 86
  • …
  • 112
  • Next Page »

โพสต์ล่าสุด

  • ระบบความพร้อมใช้งานสูง (High Availability หรือ HA) คืออะไร?
  • เอาตัวรอดจากวิกฤตการณ์วันศุกร์: จากระบบคอมพิวเตอร์แบบดิบๆ สู่การจำลองข้อมูลที่ราบรื่น
  • ติดดิน: สิ่งที่การพลาดชม Percona Live Amsterdam สอนฉันเกี่ยวกับ HA
  • เปรียบเทียบ SIOS LifeKeeper กับ Red Hat High Availability Add-On:
  • สถานะของความยืดหยุ่นของแอปพลิเคชัน: ผลสำรวจความพร้อมใช้งานสูงของ SIOS ปี 2026

กระทู้ยอดนิยม

เข้าร่วมรายชื่อผู้รับจดหมายของเรา

Copyright © 2026 · Enterprise Pro Theme on Genesis Framework · WordPress · Log in