SIOS SANless clusters

SIOS SANless clusters High-availability Machine Learning monitoring

  • Home
  • Products
    • SIOS DataKeeper for Windows
    • SIOS Protection Suite for Linux
  • การทดสอบอาหารสัตว์
  • ข่าวสารและกิจกรรม
  • ทำให้เข้าใจง่ายเซิร์ฟเวอร์คลัสเตอร์
  • เรื่องราวความสำเร็จ
  • ติดต่อเรา
  • English
  • 中文 (中国)
  • 中文 (台灣)
  • 한국어
  • Bahasa Indonesia
  • ไทย

สี่กลยุทธ์การหลีกเลี่ยงเพื่อปรับปรุงความยืดหยุ่น ประสิทธิภาพ และผลลัพธ์ของคลัสเตอร์

มกราคม 1, 2022 by Jason Aw Leave a Comment

สี่กลยุทธ์การหลีกเลี่ยงเพื่อปรับปรุงความยืดหยุ่น ประสิทธิภาพ และผลลัพธ์ของคลัสเตอร์

สี่กลยุทธ์การหลีกเลี่ยงเพื่อปรับปรุงความยืดหยุ่น ประสิทธิภาพ และผลลัพธ์ของคลัสเตอร์

ขั้นตอนง่าย ๆ สำหรับการปรับใช้ในสภาพแวดล้อมคลัสเตอร์ SIOS Protection Suite

หลีกเลี่ยงบางสิ่งบางอย่าง – เราทุกคนเคยทำมาก่อนเปลวไฟเก่าที่เราเห็นในร้านขณะเดินไปกับคู่สมรส พนักงานขายเมื่อเรา "ไม่พร้อมที่จะซื้อ" และแม้แต่เจ้านายในขณะที่เราไปเที่ยว "วันหยุด"เมื่อฉันเป็นผู้จัดการของทีมพัฒนา ฉันได้เห็นรายงานตรงที่เรียกดูในร้านค้าขณะที่พวกเขาควรจะป่วยอยู่นอกสำนักงานพวกเขาหลบอยู่ระหว่างชั้นวางเสื้อผ้าและรีบวิ่งไปตามทางเดินถัดไปและรีบออกไปเราทุกคนเคยทำมาแล้ว และในบางกรณี สำหรับสุขภาพจิต สุขภาพกาย หรือเหตุผลที่ยังคงเป็นเรื่องส่วนตัวและเป็นส่วนตัว เราทุกคนจำเป็นต้องมีมาตรการหลีกเลี่ยงบางอย่างแม้แต่ใน HAดังนั้นคุณจะเพิ่มการหลีกเลี่ยงในสภาพแวดล้อม High Availability ของคุณได้อย่างไร และเพราะเหตุใด

สี่เหตุผลในการใช้กลยุทธ์การหลีกเลี่ยงในความพร้อมใช้งานสูง

1. ประสิทธิภาพที่ดีขึ้น (ลดการโอเวอร์โหลดของเซิร์ฟเวอร์)

เหตุผลหนึ่งที่ใช้กลยุทธ์การหลีกเลี่ยงใน HA คือการเพิ่มประสิทธิภาพแอปพลิเคชันและเซิร์ฟเวอร์พิจารณากรณีของเซิร์ฟเวอร์สามเครื่องที่ใช้งานปริมาณงานจริง ให้เรียกว่าเซิร์ฟเวอร์อัลฟ่า เซิร์ฟเวอร์เบต้า เซิร์ฟเวอร์แกมมาเซิร์ฟเวอร์อัลฟ่าและเบต้ากำลังเรียกใช้แอปพลิเคชันที่สำคัญซึ่งได้รับการสนับสนุนจากฐานข้อมูล ในขณะที่เซิร์ฟเวอร์แกมมากำลังเรียกใช้รายงานและงานการแปลงข้อมูลในกรณีของความล้มเหลวของเซิร์ฟเวอร์อัลฟ่า การเฟลโอเวอร์ไปยังเซิร์ฟเวอร์เบต้ามักจะเกิดขึ้นอย่างไรก็ตาม เนื่องจากเซิร์ฟเวอร์เบต้าใช้งานเวิร์กโหลดจำนวนมากอยู่แล้ว การโหลดแอปพลิเคชันเพิ่มเติมที่เป็นผลลัพธ์อาจส่งผลให้เซิร์ฟเวอร์โอเวอร์โหลดที่ไม่พึงประสงค์และประสิทธิภาพต่ำสำหรับทั้งสองแอปพลิเคชันดังนั้นจึงควรปรับใช้กลยุทธ์การหลีกเลี่ยงเพื่อให้แน่ใจว่า Server Gamma ถูกเลือกเป็นเป้าหมายเฟลโอเวอร์

2. การเพิ่มประสิทธิภาพการทำงาน

พิจารณาสถานการณ์สมมติของเซิร์ฟเวอร์สามตัวอีกครั้ง ได้แก่ อัลฟ่า เบต้า และแกมมาเซิร์ฟเวอร์อัลฟ่าและเบต้าได้รับการปรับขนาดเพื่อรองรับปริมาณงานสูงสุด ในขณะที่ Server Gamma เป็นเซิร์ฟเวอร์ที่ปรับต้นทุนให้เหมาะสมในกรณีที่เซิร์ฟเวอร์อัลฟ่าและเซิร์ฟเวอร์เบต้าล้มเหลว จะเกิดการเฟลโอเวอร์กับเซิร์ฟเวอร์ที่ปรับต้นทุนให้เหมาะสม Gammaอย่างไรก็ตาม เซิร์ฟเวอร์นี้ไม่ได้ปรับขนาดเพื่อรองรับปริมาณงานสูงสุด หรือปริมาณงานของทั้งเซิร์ฟเวอร์อัลฟ่าและเซิร์ฟเวอร์เบต้าในเวลาเดียวกันในกรณีนี้ สามารถใช้กลยุทธ์การหลีกเลี่ยงเพื่อเพิ่มประสิทธิภาพโดยการย้ายหนึ่งหรือทั้งสองปริมาณงานโดยอัตโนมัติจาก Server Gamma ทันทีที่โฮสต์อื่นพร้อมใช้งาน

3. การเพิ่มประสิทธิภาพความพร้อมใช้งานสูง

HA Optimization เป็นอีกสถานการณ์หนึ่งสำหรับการปรับใช้กลยุทธ์การหลีกเลี่ยง เช่นเดียวกับกลยุทธ์การเพิ่มประสิทธิภาพการทำงาน การเพิ่มประสิทธิภาพ HA ถูกใช้เพื่อให้แน่ใจว่าสภาพแวดล้อมของคุณสามารถอยู่รอดได้ในสถานการณ์ความล้มเหลวส่วนใหญ่ และแอปพลิเคชันของคุณได้รับการปรับให้เหมาะสมเพื่อให้ระดับความพร้อมใช้งานสูงสุด ณ เวลาใดเวลาหนึ่งการเพิ่มประสิทธิภาพ HA เป็นสิ่งสำคัญสำหรับแอปพลิเคชัน เช่น SAP ที่มีกระบวนการเข้าคิวที่จำลองแบบในสภาพแวดล้อม SAP ใดๆ คุณไม่ต้องการให้อินสแตนซ์ ASCS (ABAP SAP Central Service) และ ERS (enqueue replication services) อยู่บนเซิร์ฟเวอร์เดียวกันเป็นเวลานานเนื่องจากความเสี่ยงของการล็อกที่สูญหายและงานที่ถูกยกเลิก เพื่อป้องกันไม่ให้สิ่งนี้เกิดขึ้น คุณสามารถใช้กลยุทธ์การหลีกเลี่ยงที่ทำให้อินสแตนซ์ ERS และ ASCS ทำงานบนโหนดคลัสเตอร์ตรงข้ามเสมอพิจารณากรณีของเซิร์ฟเวอร์สามเครื่องที่ใช้ปริมาณงานจริง เรียกว่าเซิร์ฟเวอร์อัลฟ่า เบต้า แกมมาเซิร์ฟเวอร์อัลฟ่ากำลังเรียกใช้อินสแตนซ์ ASCS ในขณะที่เซิร์ฟเวอร์เบต้ากำลังเรียกใช้อินสแตนซ์ ERSServer Gamma ทำหน้าที่เป็นโหนดที่สามสำหรับการเฟลโอเวอร์ของทั้ง Server Beta (ERS) และ Server Alpha (ASCS)หากเบต้าขัดข้อง คุณจะไม่ต้องการให้ทรัพยากร ERS ทำงานบนโหนดเดียวกันกับอินสแตนซ์ ASCSเพื่อให้แน่ใจว่าการดำเนินการนี้ คุณสามารถปรับใช้กลยุทธ์การหลีกเลี่ยงที่จะตรวจสอบโดยอัตโนมัติก่อน และทำให้แน่ใจว่าทั้งสองแอปพลิเคชันอยู่บนเซิร์ฟเวอร์ที่แยกจากกัน และคงไว้ซึ่งแนวทางปฏิบัติที่ดีที่สุดของ SAP ASCS/ERS สำหรับการล็อกเมื่อเกิดข้อผิดพลาด

4. การหลีกเลี่ยง DR

สมมติว่าคุณมีศูนย์ข้อมูลสองแห่ง: City Alpha และ City Beta ซึ่งอยู่ห่างกันประมาณ 70 ไมล์ โดยที่ลูกค้าส่วนใหญ่ของคุณตั้งอยู่ตรงกลางระหว่างพวกเขา อย่างไรก็ตาม เนื่องจากการเปลี่ยนแปลงล่าสุดในองค์กรภายใน การควบรวม/ปิดและการเข้าซื้อกิจการ และข้อกำหนดด้านการกำกับดูแล ทีมไอทีของคุณจะต้องเพิ่มศูนย์ข้อมูลแห่งที่สามที่ตั้งอยู่ใน City Gamma ซึ่งอยู่ห่างจาก Alpha และ Beta ประมาณ 350 ไมล์ตอนนี้ทรัพยากรที่ได้รับการคุ้มครองในอัลฟ่าและเบต้าเป็นหลักก็ขยายไปยังตำแหน่งแกมมาด้วยเนื่องจากผู้ใช้และทีมส่วนใหญ่อยู่ใกล้ตำแหน่งอัลฟ่าและเบต้า และแม้แต่ผู้ใช้ที่รุนแรงที่สุดก็ตั้งอยู่ในเมืองใกล้เคียง ทีมของคุณต้องหลีกเลี่ยงการเฟลโอเวอร์ไปยังตำแหน่งแกมมา เช่นเดียวกับกลยุทธ์อื่นๆ การหลีกเลี่ยง DR พยายามเพิ่มประสิทธิภาพการทำงาน ต้นทุนข้อมูลขาเข้า/ออกในภูมิภาค เวลาแฝง และการเข้าถึงไคลเอ็นต์โดยการหลีกเลี่ยงโหนด DR หากมีเพียงหนึ่งโหนดภายในภูมิภาคใดภูมิภาคหนึ่งที่ล้มเหลวนอกจากนี้ยังช่วยให้แน่ใจว่าแม้ว่าโหนดทั้งสองจะล้มเหลวหลังจากเวลาต่างกัน แต่การเฟลโอเวอร์จะเกิดขึ้นกับโหนดอื่นในคลัสเตอร์หรือศูนย์ข้อมูลเสมอก่อนที่จะย้ายไปยัง DR คุณจะปรับใช้กลยุทธ์การหลีกเลี่ยงอย่างไรผู้ให้บริการหลายรายมีกฎความสัมพันธ์ที่สามารถกำหนดค่าได้ ในขณะที่ผู้ให้บริการรายอื่นๆ ใช้ลำดับความสำคัญของเซิร์ฟเวอร์ร่วมกันหรือขั้นตอนที่ต้องทำด้วยตัวเองในกรณีของ SIOS Protection Suite สำหรับ Linux คุณสามารถใช้วิธีการในตัวได้หลายวิธี ได้แก่:

1. การจัดลำดับความสำคัญของทรัพยากร

ในกรณีที่เกิดความล้มเหลว ทรัพยากรจะล้มเหลวไปยังเซิร์ฟเวอร์ที่มีลำดับความสำคัญที่เหลืออยู่ต่ำสุดและต่อไปยังเซิร์ฟเวอร์เพิ่มเติม (อัลฟ่า เบต้า และแกมมา)Server Alpha เป็นเซิร์ฟเวอร์หลักสำหรับ Resource.HR, Server Beta เป็นเซิร์ฟเวอร์หลักสำหรับ Resource.MFG และ Server Gamma เป็นเซิร์ฟเวอร์สำรองสำหรับทรัพยากร/เซิร์ฟเวอร์ทั้งหมดการใช้การจัดลำดับความสำคัญของทรัพยากร Resource.HR จะมีลำดับความสำคัญหนึ่ง (1) ใน Server Alpha และลำดับความสำคัญสอง (2) บน Server Gammaในขณะที่ Resource.MFG สามารถมีลำดับความสำคัญหนึ่ง (1) บนเซิร์ฟเวอร์เบต้าและลำดับความสำคัญสอง (2) บนเซิร์ฟเวอร์ Gammaหากลูกค้าต้องการปรับการใช้สภาพแวดล้อมให้เหมาะสม Resource.HR สามารถมีลำดับความสำคัญสาม (3) บนเซิร์ฟเวอร์เบต้าและทรัพยากร MFG สามารถมีลำดับความสำคัญสาม (3) บนเซิร์ฟเวอร์อัลฟ่าในกรณีที่เซิร์ฟเวอร์อัลฟ่าล้มเหลว ทรัพยากร Resource.HR จะล้มเหลวในเซิร์ฟเวอร์แกมมาก่อนที่จะพยายามเข้ามาใช้บริการ (ถูกกู้คืน) บนเซิร์ฟเวอร์อัลฟ่า

SIOS Protection Suite สำหรับ Linux (UI และ CLI) อนุญาตให้ผู้ใช้ระบุลำดับความสำคัญสำหรับแต่ละเซิร์ฟเวอร์และการรวมทรัพยากร

2. นโยบายหรือกฎความสัมพันธ์

กฎนโยบายยังสามารถใช้เพื่อป้องกันไม่ให้เกิดการกู้คืนทรัพยากรบนเซิร์ฟเวอร์ที่กำหนด และด้วยเหตุนี้จึงช่วยให้ทรัพยากรสามารถหลีกเลี่ยงเซิร์ฟเวอร์ที่ระบุซึ่งอาจใช้ปริมาณงานที่สำคัญหรือต้องใช้ทรัพยากรมากนโยบายทั่วไป ได้แก่ :

            • นโยบายข้อจำกัดที่จะบล็อกแอปพลิเคชันจากเซิร์ฟเวอร์เฉพาะตามค่าเริ่มต้น
            • นโยบายทรัพยากรที่จะบล็อกแอปพลิเคชันจากเซิร์ฟเวอร์ที่มีทรัพยากรไม่เพียงพอ
            • นโยบายชั่วคราวที่กำหนดช่วงเวลาที่ทรัพยากรได้รับอนุญาตหรือไม่อนุญาตจากระบบ
            • นโยบายที่กำหนดเองซึ่งกำหนดเซิร์ฟเวอร์ที่ต้องการหรือความสามารถในการเป็นเจ้าของแอปพลิเคชันที่เป็นไปได้ภายในคลัสเตอร์

SIOS Protection สำหรับ Linux CLI อนุญาตให้ผู้ใช้ระบุกฎของนโยบายซึ่งสามารถปิดใช้งานการเฟลโอเวอร์ไปยังทรัพยากรเฉพาะสำหรับเซิร์ฟเวอร์ที่ระบุ จัดเตรียมนโยบายชั่วคราวเพื่อป้องกันความล้มเหลว ปิดใช้งานความล้มเหลวของแอปพลิเคชันบางประเภท นโยบายข้อจำกัด และนโยบายที่กำหนดเอง

  • แหล่งข้อมูลการหลีกเลี่ยงเฉพาะ

วิธีที่ละเอียดที่สุดในการสร้างกลยุทธ์การหลีกเลี่ยงทรัพยากรคือการปรับใช้สคริปต์การหลีกเลี่ยงเฉพาะภายในแต่ละลำดับชั้นวิธีนี้จะอนุญาตให้ผู้ใช้กำหนดค่าแอปพลิเคชันเฉพาะ (เช่น app1 และ app2) เพื่อหลีกเลี่ยงกันและกันเมื่อทำได้ในขณะที่อนุญาตให้แอปพลิเคชันอื่นทำงานโดยไม่มีข้อจำกัดในกรณีของเซิร์ฟเวอร์สามตัวของเรา อัลฟ่า เบต้า และแกมมา และทรัพยากรสามอย่าง app1, app2 และ app3 วิธีการนี้จะให้ความยืดหยุ่นสูงสุดในตัวอย่างนี้ app1 และ app2 จะพยายามหลีกเลี่ยงการจัดระเบียบเมื่อเซิร์ฟเวอร์ล้มเหลว แต่ app3 จะล้มเหลวไปยังโหนดถัดไปที่พร้อมใช้งานตามลำดับความสำคัญโดยไม่มีข้อจำกัดการจัดระเบียบใดๆ

สำหรับตัวอย่างเพิ่มเติมของกลยุทธ์การหลีกเลี่ยงและทรัพยากร ให้พิจารณา SIOS Protection Suite สำหรับ Linux เอกสาร .หากลูกค้ามีสองแอปพลิเคชัน ได้แก่ app1 และ app2 ซึ่งพวกเขาต้องการให้ทำงานบนโหนดต่างๆ ทุกครั้งที่ทำได้ ลูกค้าสามารถสร้างทรัพยากรโหนดปลายสุดของเทอร์มินัลการหลีกเลี่ยงได้ 2 รายการโดยใช้ SIOS Protection Suite สำหรับทรัพยากร Linux gen/app และ '/opt/LifeKeeper /lkadm/bin/avoid_restore' สคริปต์

– Cassius Rhue รองประธานฝ่ายประสบการณ์ลูกค้า

สืบพันธุ์จาก SIOS
Filed Under: ทำให้เข้าใจง่ายเซิร์ฟเวอร์คลัสเตอร์

การทำคลัสเตอร์ Windows

ธันวาคม 28, 2021 by Jason Aw Leave a Comment

การทำคลัสเตอร์ windows - วิธีบรรลุความพร้อมใช้งานสูงใน Windows

การทำคลัสเตอร์ Windows

การทำคลัสเตอร์ Windows

วิธีการบรรลุความพร้อมใช้งานสูงใน Windows

เพื่อลดเวลาหยุดทำงานของระบบและสร้างความพร้อมใช้งานสูงสำหรับ Windows แนวทางปฏิบัติที่ดีที่สุดด้าน IT แนะนำให้คุณคลัสเตอร์เซิร์ฟเวอร์ (หรือโหนด) เพื่อที่ว่าถ้าโหนดหนึ่งล้มเหลว โหนดอื่นอย่างน้อยหนึ่งโหนดจะทำการประมวลผลเกินโดยอัตโนมัติ สิ่งนี้เรียกว่าการทำคลัสเตอร์ Windows

จำเป็นต้องมีซอฟต์แวร์คลัสเตอร์เพื่อตรวจสอบความสมบูรณ์ของโหนดหลักและเริ่มดำเนินการกู้คืนหากตรวจพบปัญหา การทำคลัสเตอร์ HA ยังต้องการวิธีการตรวจสอบให้แน่ใจว่าในกรณีที่เกิดความล้มเหลว โหนดรองกำลังเข้าถึงข้อมูลเวอร์ชันล่าสุดในการจัดเก็บในกรณีส่วนใหญ่ ทำได้โดยการเชื่อมต่อโหนดทั้งหมดของคลัสเตอร์กับที่เก็บข้อมูลที่ใช้ร่วมกันเดียวกัน โหนดคลัสเตอร์ควรแยกจากกันตามภูมิศาสตร์เพื่อป้องกันแอปพลิเคชันจากภัยพิบัติทั่วทั้งไซต์และระดับภูมิภาค

ในสภาพแวดล้อม Windows Server Microsoft รวม Windows Server Failover Clustering (WSFC) ในแพลตฟอร์ม Windows Server

Windows Server Failover Clustering คืออะไร?

ด้วย WSFC แต่ละโหนดที่ใช้งานอยู่จะมีโหนดสแตนด์บายที่มีข้อกำหนดฮาร์ดแวร์เหมือนกันและใช้ที่เก็บข้อมูลร่วมกัน โหนดที่สามมักถูกกำหนดค่าเป็นเซิร์ฟเวอร์ “พยาน” ซึ่งมีวัตถุประสงค์เพียงอย่างเดียวคือเพื่อให้แน่ใจว่าโหนดหลักทำงาน และหากตรวจพบปัญหา เพื่อส่งสัญญาณความจำเป็นในการดำเนินการเฟลโอเวอร์ไปยังโหนดสแตนด์บาย

นอกเหนือจากการตรวจสอบความสมบูรณ์ของคลัสเตอร์แล้ว โหนดใน WSFC ยังทำงานร่วมกันเพื่อให้:[1]

  • การจัดการทรัพยากร – แต่ละโหนดมีทรัพยากรทางกายภาพ เช่น SAN และอินเทอร์เฟซเครือข่าย แอปพลิเคชันที่โฮสต์ได้รับการลงทะเบียนเป็นทรัพยากรคลัสเตอร์และสามารถกำหนดค่าการพึ่งพาการเริ่มต้นและสุขภาพตามทรัพยากรอื่นๆ
  • การประสานงานล้มเหลว – ทรัพยากรแต่ละรายการโฮสต์อยู่บนโหนดหลัก และสามารถโอนโดยอัตโนมัติหรือด้วยตนเองไปยังโหนดรองอย่างน้อยหนึ่งโหนด โหนดและแอปพลิเคชันที่โฮสต์จะได้รับแจ้งเมื่อเกิดข้อผิดพลาด เพื่อให้สามารถตอบสนองได้อย่างเหมาะสม WSFC ทำงานร่วมกับ Microsoft Always On Availability Groups และ Always On Failover Clustering เพื่อประสานงานเมื่อเกิดข้อผิดพลาดในสภาพแวดล้อม Microsoft SQL Server

SIOS DataKeeper เสริม WSFC อย่างไร

WSFC ต้องการที่เก็บข้อมูลที่ใช้ร่วมกันเพื่อให้แน่ใจว่าโหนดคลัสเตอร์ทั้งหมดกำลังเข้าถึงข้อมูลล่าสุดในกรณีที่เกิดข้อผิดพลาด บ่อยครั้ง บริษัทต่างๆ ใช้ฮาร์ดแวร์ SAN ราคาแพงเพื่อรับรองความซ้ำซ้อนของข้อมูล SAN แสดงถึงความเสี่ยงจากความล้มเหลวเพียงจุดเดียว และถ้าคุณต้องการเรียกใช้แอปพลิเคชันของคุณในระบบคลาวด์ด้วยการป้องกันคลัสเตอร์ Windows Server Failover แบบเดียวกัน จะไม่มี SAN ให้ใช้งาน

SIOS DataKeeper Cluster Edition รวมและขยายคลัสเตอร์ WSFC และ SQL Server Always On Failover ได้อย่างราบรื่นโดยขจัดความจำเป็นในการจัดเก็บข้อมูลที่ใช้ร่วมกัน ให้การจำลองแบบอิงโฮสต์ที่เพิ่มประสิทธิภาพเพื่อซิงโครไนซ์ที่เก็บข้อมูลในเครื่องในโหนดคลัสเตอร์ทั้งหมด สร้างคลัสเตอร์ SANless ในขณะที่ WSFC จัดการคลัสเตอร์ SIOS DataKeeper จะทำการจำลองการจัดเก็บข้อมูลแบบซิงโครนัสหรือแบบอะซิงโครนัส ทำให้โหนดสแตนด์บายสามารถเข้าถึงข้อมูลล่าสุดได้ทันทีในกรณีที่เกิดข้อผิดพลาด SIOS DataKeeper ไม่เพียงแต่ช่วยลดต้นทุน ความซับซ้อน และความเสี่ยงจากจุดเดียวของความล้มเหลวของ SAN แต่ยังช่วยให้คุณใช้ PCIe Flash และ SSD ที่รวดเร็วล่าสุดในที่จัดเก็บข้อมูลในเครื่องของคุณเพื่อประสิทธิภาพและการป้องกันในต้นทุนเดียว โซลูชั่นที่มีประสิทธิภาพ

ด้วย SIOS DataKeeper คุณสามารถปรับสมดุลแบนด์วิดท์เครือข่ายและการใช้ CPU สำหรับแต่ละแอปพลิเคชัน

  • หากการจำลองแบบเร็วเป็นสิ่งสำคัญ SIOS DataKeeper สามารถใช้แบนด์วิดท์ได้มากกว่า 90 เปอร์เซ็นต์เพื่อเร่งการซิงโครไนซ์ข้อมูล
  • หากการลดผลกระทบของเครือข่ายเป็นสิ่งสำคัญที่สุดของคุณ SIOS DataKeeper เสนอการบีบอัดแบบบูรณาการและการควบคุมปริมาณแบนด์วิดท์

นอกจากนี้ คุณลักษณะ Target Snapshots ของ SIOS DataKeeper ยังช่วยให้คุณเรียกใช้รายงานแบบ point-in-time จากโหนดรองเพื่อลดภาระงานที่อาจส่งผลต่อประสิทธิภาพการทำงานของโหนดหลัก วิธีนี้ช่วยให้คุณสืบค้นและเรียกใช้รายงานได้รวดเร็วยิ่งขึ้น และทำการตัดสินใจได้รวดเร็วยิ่งขึ้น

การทำงานกับ WSFC ทำให้ SIOS DataKeeper Cluster Edition ปกป้องสภาพแวดล้อม Windows ที่มีความสำคัญต่อธุรกิจ รวมถึง Microsoft SQL Server, SAP, SharePoint, Lync, Dynamics และ Hyper-V โดยใช้ฮาร์ดแวร์มาตรฐานอุตสาหกรรมที่คุณเลือกและพื้นที่จัดเก็บข้อมูลในเครื่องใน ” หรือการกำหนดค่า SANless[2] SIOS DataKeeper ยังให้ความพร้อมใช้งานสูงและการป้องกันการกู้คืนจากความเสียหายสำหรับแอปพลิเคชันที่มีความสำคัญต่อธุรกิจของคุณในสภาพแวดล้อมระบบคลาวด์ เช่น Amazon Web Services (AWS), Microsoft Azure และ Google Cloud Services โดยไม่ลดทอนประสิทธิภาพลง

SIOS Protection Suite – การปกป้องสภาพแวดล้อมของ Windows โดยไม่ต้องใช้ WSFC

SIOS Protection Suite สำหรับ Windows ประกอบด้วย DataKeeper, SIOS LifeKeeper และชุดกู้คืนแอปพลิเคชันเสริมสำหรับแอปพลิเคชันชั้นนำและการดำเนินงานด้านโครงสร้างพื้นฐาน เป็นโซลูชันการจัดกลุ่มแบบบูรณาการอย่างแน่นหนาที่รวม ความพร้อมใช้งานสูง คลัสเตอร์เมื่อเกิดข้อผิดพลาด การตรวจสอบแอปพลิเคชันอย่างต่อเนื่อง การจำลองข้อมูล และนโยบายการกู้คืนที่กำหนดค่าได้ เพื่อปกป้องแอปพลิเคชันและข้อมูลที่สำคัญต่อธุรกิจของคุณจากการหยุดทำงานและภัยพิบัติ

ข้อมูลเมตาและการแจ้งเตือนแบบกระจาย

บริการ WSFC และข้อมูลเมตา/สถานะของโหนดถูกโฮสต์อยู่บนแต่ละโหนดในคลัสเตอร์ เมื่อมีการเปลี่ยนแปลงเกิดขึ้นกับโหนดใดๆ ข้อมูลที่อัปเดตจะเผยแพร่ไปยังโหนดอื่นๆ ทั้งหมดโดยอัตโนมัติ

SIOS Protection Suite ไม่ต้องการ WSFC เนื่องจาก SIOS ตรวจสอบความสมบูรณ์ของสภาพแวดล้อมแอปพลิเคชัน รวมถึงเซิร์ฟเวอร์ ระบบปฏิบัติการ และฐานข้อมูล สามารถหยุดและรีสตาร์ทแอปพลิเคชันได้ทั้งในเครื่องและบนเซิร์ฟเวอร์คลัสเตอร์อื่นที่ไซต์เดียวกันหรือในตำแหน่งที่ตั้งอื่น เมื่อตรวจพบปัญหา SIOS Protection Suite จะดำเนินการกู้คืนโดยอัตโนมัติและจัดการการเรียงซ้อนและความล้มเหลวที่จัดลำดับความสำคัญโดยอัตโนมัติ

ด้วย SIOS Protection Suite คุณสามารถใช้คลัสเตอร์ SAN หรือ SANless ที่คุณเลือกได้โดยใช้อุปกรณ์จัดเก็บข้อมูลหลากหลายประเภท รวมถึงที่จัดเก็บข้อมูลแบบต่อพ่วงโดยตรง, iSCSI, Fibre Channel และอื่นๆ

SIOS Protection Suite สำหรับ Windows สามารถตอบสนองความพร้อมใช้งานสูงและ การกู้คืนระบบ ความต้องการภายในไซต์เดียวและในหลายไซต์

โซลูชันคลัสเตอร์ SIOS Windows ยอดนิยม

โซลูชันการทำคลัสเตอร์ SIOS Windows ที่ได้รับความนิยมสูงสุดบางส่วน สำหรับ SQL Server, SAP และสภาพแวดล้อมบนคลาวด์ มีการกล่าวถึงในรายละเอียดเพิ่มเติมด้านล่าง

Windows Clustering สำหรับ SQL Server, SAP, S/4HANA และ Oracle

SIOS ให้การป้องกันที่รับรองโดย SAP อย่างครอบคลุมสำหรับทั้งแอปพลิเคชันและข้อมูล ซึ่งรวมถึงความพร้อมใช้งานสูง การจำลองข้อมูล และการกู้คืนจากความเสียหาย เพื่อป้องกัน SAP ในสภาพแวดล้อม Windows SIOS Protection Suite มี SIOS LifeKeeper ซึ่งตรวจสอบสแต็กแอปพลิเคชันทั้งหมด SIOS ปกป้องฐานข้อมูล Oracle ของคุณ ไม่ว่าคุณจะใช้งานกับ SAP หรือใช้งานแอปพลิเคชัน Oracle แบบสแตนด์อโลน คุณเพียงแค่เลือก Application Recovery Kit ที่ตรงกับการกำหนดค่าของคุณ

การทำคลัสเตอร์ Windows ในคลาวด์

ไม่ว่าคุณจะต้องการ SIOS DataKeeper เพื่อเปิดใช้งาน Windows Server Failover Clustering ในระบบคลาวด์หรือ SIOS Protection Suite สำหรับ Windows สำหรับการตรวจสอบแอปพลิเคชันและการจัดการเฟลโอเวอร์ ตลอดจนการจำลองข้อมูลระดับบล็อกที่มีประสิทธิภาพ SIOS มอบความยืดหยุ่นในการกำหนดค่าที่สมบูรณ์ SIOS ช่วยให้คุณสร้างคลัสเตอร์ในโครงสร้างพื้นฐานระบบคลาวด์จริง เสมือน คลาวด์ หรือไฮบริด ตัวอย่างเช่น การทำงานกับ WSFC SIOS DataKeeper สามารถ:

  • ปกป้องแอปพลิเคชันธุรกิจภายในองค์กรหรือแบบไฮบริดที่สำคัญต่อสภาพแวดล้อม Windows ที่มีความพร้อมใช้งานสูงใน AWS, Azure หรือ Google Cloud
  • ปกป้องแอปพลิเคชันระบบคลาวด์ เช่น SQL Server และ SAP โดยการสร้างคลัสเตอร์ Windows ใน AWS, Azure หรือ Google Cloud
  • ให้ความพร้อมใช้งานสูงและการป้องกันการกู้คืนจากความเสียหายทั่วทั้งไซต์ ในพื้นที่หรือระดับภูมิภาค โดยความล้มเหลวบนอินสแตนซ์ของแอปพลิเคชันในโซนความพร้อมใช้งานของระบบคลาวด์หรือภูมิภาค

SIOS DataKeeper Cluster Edition สามารถให้การปกป้องคลัสเตอร์ที่มีความพร้อมใช้งานสูงในคลาวด์

บทสรุป

SIOS นำเสนอข้อเสนอที่สนับสนุนแอปพลิเคชัน ระบบปฏิบัติการ และสภาพแวดล้อมโครงสร้างพื้นฐานที่หลากหลาย โดยเป็นโซลูชันเดียวที่สามารถรองรับความต้องการด้านความพร้อมใช้งานสูงทั้งหมดของคุณได้ นี่เป็นเพียงตัวอย่างเล็กๆ น้อยๆ ที่แสดงให้เห็นถึงพลังของ SIOS

  • สนามกีฬาเพิร์ทในรัฐเวสเทิร์นออสเตรเลียใช้ SIOS DataKeeper กับ WSFC เพื่อให้มีความพร้อมใช้งานสูงสำหรับเครื่องเสมือน Hyper-V
  • เพย์โก ( paygoutilities.com ) ซึ่งตั้งอยู่ในสหรัฐอเมริกา ใช้ SIOS DataKeeper กับ WSFC เพื่อให้มีความพร้อมใช้งานสูงสำหรับ SQL Server บน AWS
  • Toyo Gosei ซึ่งตั้งอยู่ในประเทศญี่ปุ่น ได้ติดตั้ง SIOS DataKeeper กับ WSFC เพื่อให้มีความพร้อมใช้งานสูงและกู้คืนระบบสำหรับแอปพลิเคชัน SAP บน Azure

สำหรับข้อมูลเพิ่มเติมเกี่ยวกับโซลูชั่นความพร้อมใช้งานสูง/การกู้คืนจากภัยพิบัติเพื่อรองรับสภาพแวดล้อม Windows ของคุณ คลิกที่นี่[TM(1] .

อ้างอิง https://www.techopedia.com/definition/24358/windows-clustering https://searchwindowsserver.techtarget.com/definition/Windows-Server-failover-clustering https://docs.microsoft.com/en-us/sql/sql-server/failover-clusters/windows/windows-server-failover-clustering-wsfc-with-sql-server?view=sql-server-ver15[1] https://docs.microsoft.com/en-us/sql/sql-server/failover-clusters/windows/windows-server-failover-clustering-wsfc-with-sql-server?view=sql-server-ver15[2] สถาปัตยกรรมที่ไม่มีการแบ่งปัน (SN) เป็นสถาปัตยกรรมคอมพิวเตอร์แบบกระจายซึ่งคำขออัปเดตแต่ละรายการได้รับการตอบสนองโดยโหนดเดียว (โปรเซสเซอร์/หน่วยความจำ/หน่วยเก็บข้อมูล) https://en.wikipedia.org/wiki/Shared-nothing_architecture สืบพันธุ์จาก SIOS

Filed Under: ทำให้เข้าใจง่ายเซิร์ฟเวอร์คลัสเตอร์ Tagged With: การทำคลัสเตอร์ Windows

การทำคลัสเตอร์ Linux

ธันวาคม 23, 2021 by Jason Aw Leave a Comment

การทำคลัสเตอร์ Linux

Linux Clustering คืออะไร?

คลัสเตอร์ Linux ที่มีความพร้อมใช้งานสูงคือกลุ่มของคอมพิวเตอร์หรือโหนด Linux อุปกรณ์จัดเก็บข้อมูลที่ทำงานร่วมกันและได้รับการจัดการเป็นระบบเดียว ในการกำหนดค่าคลัสเตอร์แบบดั้งเดิม สองโหนดเชื่อมต่อกับที่เก็บข้อมูลที่ใช้ร่วมกัน (โดยทั่วไปคือ SAN) เมื่อใช้คลัสเตอร์ลีนุกซ์ แอปพลิเคชันจะทำงานบนโหนดเดียว และซอฟต์แวร์การจัดกลุ่มจะใช้เพื่อตรวจสอบการทำงานของมัน หากซอฟต์แวร์ตรวจพบปัญหา ซอฟต์แวร์จะย้ายการทำงานของแอปพลิเคชันไปยังโหนดรองในกระบวนการที่เรียกว่าเฟลโอเวอร์ เนื่องจากโหนดรองใช้พื้นที่เก็บข้อมูลร่วมกับโหนดหลัก การดำเนินการสามารถดำเนินต่อไปได้อย่างรวดเร็ว โดยบรรลุเวลาการกู้คืนที่สั้นมาก (วินาทีถึงนาที) และวัตถุประสงค์ของจุดกู้คืน

Linux Open Source High Availability Clustering

ผู้จำหน่ายระบบปฏิบัติการ Linux บางรายเสนอซอฟต์แวร์การทำคลัสเตอร์ เช่น SUSE Linux HAE; Red Hat Enterprise Linux (RHEL); และ Oracle Real Application Clusters (RAC)

ในขณะที่อนุญาตให้คุณสร้าง คลัสเตอร์ล้มเหลว พวกเขานำเสนอความท้าทายที่หลากหลาย อันดับแรก การเลือกซอฟต์แวร์ที่จะใช้สำหรับแต่ละองค์ประกอบของการกำหนดค่า HA ซึ่งอย่างน้อยต้องมีความสามารถที่เกี่ยวข้องสามประการ: การจำลองข้อมูล , การทำคลัสเตอร์เซิร์ฟเวอร์ และตัวจัดการรีซอร์สพร้อมมอนิเตอร์ฮาร์ตบีต ด้วย SUSE และ Red Hat คุณจะถูกล็อคในระบบปฏิบัติการด้วย หากคุณต้องการใช้ระบบปฏิบัติการรุ่นอื่นที่มีราคาไม่แพงหรือฟรี เช่น CentOS หรือ Oracle Enterprise Linux (OEL) คุณจะต้องซื้อโซลูชัน HA แยกต่างหาก

ไม่ว่าคุณจะเลือกแบบใด การสร้างโซลูชันคลัสเตอร์ Linux ด้วยซอฟต์แวร์โอเพ่นซอร์สเพื่อความพร้อมใช้งานสูงคือโครงการ “ทำด้วยตัวเอง” (DIY) ซึ่งดำเนินการด้วยตนเองและมีแนวโน้มสูงที่จะเกิดข้อผิดพลาดจากมนุษย์

ส่วนขยาย HA แบบโอเพ่นซอร์สของ Linux ต้องใช้ทักษะทางเทคนิคระดับสูง ซึ่งสร้างปัญหาด้านความซับซ้อนและความน่าเชื่อถือที่ท้าทายผู้ปฏิบัติงานส่วนใหญ่

SUSE Linux Enterprise Server และ Red Hat Enterprise Linux ทั้งสองโซลูชันมีทั้งสภาพแวดล้อม SAN และ SANless แต่ต้องการให้ติดตั้งและกำหนดค่าซอฟต์แวร์การจำลองแบบที่เรียกว่า DRBD ใน OS เพื่อรองรับการจำลองข้อมูลในสภาพแวดล้อม SANless ขออภัย ต้องใช้สคริปต์แบบกำหนดเองจำนวนมาก ซึ่งอาจใช้เวลานานในการทดสอบและตรวจสอบ และต้องมีการทดสอบซ้ำเมื่อมีการอัปเดตสภาพแวดล้อม เนื่องจากบริษัทเหล่านี้เป็นบริษัทระบบปฏิบัติการก่อนและสำคัญที่สุด การสนับสนุนของพวกเขาจึงมุ่งไปที่ปัญหาระดับระบบปฏิบัติการ และบ่อยครั้งที่ผู้เชี่ยวชาญ HA แทบไม่มีหรือไม่มีเลยที่จะช่วยเหลือลูกค้าเกี่ยวกับปัญหาของพวกเขา

Oracle RAC เป็น ความพร้อมใช้งานสูง โซลูชัน แต่ได้รับการออกแบบมาเป็นหลักสำหรับระดับการจัดการฐานข้อมูล ซึ่งหมายความว่าคุณจะต้องใช้โซลูชัน HA ที่แตกต่างกันสำหรับส่วนประกอบเหล่านั้นที่ทำการตรวจสอบ จัดการ และกู้คืนระดับแอปพลิเคชันของคุณ Oracle RAC นั้นมีราคาแพงมากเช่นกัน โดยคุณต้องอัปเกรดเป็น Oracle Enterprise Edition เพิ่มเติมจากการจ่ายเงินสำหรับตัวเลือก RAC ซึ่งโดยทั่วไปจะมีมูลค่าหลายแสนดอลลาร์ เมื่อเทียบกับโซลูชันการทำคลัสเตอร์ Linux อื่นๆ เช่น SIOS Protection Suite

SIOS Protection Suite สำหรับ Linux Clustering

ดิ SIOS Protection Suite สำหรับ Linux ให้การผสมผสานอย่างแน่นหนาของคลัสเตอร์เฟลโอเวอร์ที่มีความพร้อมใช้งานสูง การตรวจสอบแอปพลิเคชันอย่างต่อเนื่อง การจำลองข้อมูล และนโยบายการกู้คืนที่กำหนดค่าได้ ปกป้องแอปพลิเคชันที่มีความสำคัญต่อธุรกิจของคุณจากการหยุดทำงานและภัยพิบัติ แม้ว่า SIOS Protection Suite จะทำงานในสภาพแวดล้อม SAN เพื่อรองรับคลัสเตอร์ที่ใช้ฮาร์ดแวร์ HA แบบดั้งเดิม แต่สถาปัตยกรรมใช้วิธีการแบบไม่มีส่วนร่วมในการจัดคลัสเตอร์เซิร์ฟเวอร์ทำให้สามารถรัน SANless ได้ นำเสนอโซลูชันที่มีประสิทธิภาพ หลากหลาย และกำหนดค่าได้ง่ายด้วยนโยบายการกู้คืนระบบเฟลโอเวอร์/เฟลแบ็คแบบอัตโนมัติและด้วยตนเองสำหรับแอปพลิเคชันที่หลากหลาย

SIOS Protection Suite สำหรับ Linux ประกอบด้วย:

  • SIOS LifeKeeper ซึ่งมีซอฟต์แวร์การทำคลัสเตอร์เฟลโอเวอร์ที่ยืดหยุ่นซึ่งตรวจสอบสแต็กแอปพลิเคชันทั้งหมด
  • SIOS DataKeeper ซึ่งให้การจำลองข้อมูลระดับบล็อกที่รวดเร็วและมีประสิทธิภาพสำหรับการมิเรอร์ที่เก็บข้อมูลในเครื่องในการกำหนดค่าคลัสเตอร์ SANless หรือการจำลองแบบไปยังตำแหน่งระยะไกลหรือระบบคลาวด์สำหรับการกู้คืนจากภัยพิบัติ
  • ชุดกู้คืนแอปพลิเคชัน (ARK) หลายชุดพร้อมการกำหนดค่าอัตโนมัติและเครื่องมือตรวจสอบความถูกต้องในผลิตภัณฑ์ เพื่อปกป้องแอปพลิเคชันและข้อมูลที่สำคัญต่อธุรกิจของคุณจากการหยุดทำงานและภัยพิบัติ

เป็นความรู้เชิงลึกของทีม SIOS ในการกู้คืนแอปพลิเคชันและการตรวจสอบและกู้คืนแอปพลิเคชันอัตโนมัติของโซลูชัน ซึ่งช่วยให้ใช้งานได้ง่ายขึ้นและเป็นทางเลือกที่ดีกว่าและราคาถูกกว่าเมื่อเปรียบเทียบกับโซลูชันคลัสเตอร์ Linux ที่มี SUSE, Red Hat และ Oracle

นอกจากนี้, SIOS LifeKeeper รองรับการกระจาย Linux หลักทั้งหมด รวมถึง Red Hat Enterprise Linux, SUSE Linux Enterprise Server, CentOS และ Oracle Linux และรองรับสถาปัตยกรรมการจัดเก็บข้อมูลที่หลากหลาย ซอฟต์แวร์ SIOS ได้รับการดัดแปลงและปรับให้เหมาะสมเพื่อให้ทำงานบนระบบปฏิบัติการเหล่านี้ และส่วนประกอบได้รับการทดสอบ ดังนั้นตรวจสอบให้แน่ใจว่าโซลูชันคลัสเตอร์ SANless จะทำงานในแต่ละระบบปฏิบัติการ

สุดท้ายนี้ ด้วย SIOS Protection Suite สำหรับ Linux คุณสามารถเรียกใช้แอปพลิเคชันที่มีความสำคัญต่อธุรกิจของคุณในสภาพแวดล้อมคลาวด์ที่ยืดหยุ่นและปรับขนาดได้ เช่น Amazon Web Services (AWS) โดยไม่สูญเสียประสิทธิภาพ ความพร้อมใช้งานสูง หรือการป้องกันภัยพิบัติ

การทำคลัสเตอร์ Linux ใน AWS

แม้ว่าผู้ให้บริการระบบคลาวด์ เช่น AWS จะมีตัวเลือกความพร้อมใช้งานสูง แต่ก็ไม่ได้ให้ระดับความพร้อมใช้งานสูงและการป้องกันที่ครอบคลุมทั่วทั้งโครงสร้างพื้นฐานของแอปพลิเคชันที่ลูกค้าต้องการและที่คุณเคยทำได้โดยใช้คลัสเตอร์ก่อนการประมวลผลบนระบบคลาวด์ นั่นคือเหตุผลที่ AWS เป็นพันธมิตรกับ SIOS SIOS Protection Suite สำหรับ Linux บรรลุความพร้อมใช้งานสูงในระดับที่ต้องการสำหรับลูกค้าร่วมกันของเราและแอปพลิเคชันที่สำคัญที่พวกเขากำลังย้ายไปยัง AWS Cloud

SIOS Protection Suite สำหรับ Linux บน AWS จัดเตรียมองค์ประกอบทั้งหมดที่คุณต้องการเพื่อสร้างคลัสเตอร์ Linux ที่มีความพร้อมใช้งานสูงในระบบคลาวด์ส่วนตัวเสมือน (VPC) ภายในเขต AWS เดียวใน Availability Zone สองแห่ง นอกจากนี้ยังสนับสนุนการป้องกันแบบสำเร็จรูปสำหรับระบบ SAP, ฐานข้อมูล Oracle และแอปพลิเคชันที่สำคัญต่อธุรกิจอื่นๆ

SIOS และ AWS เสนอ SIOS Protection Suite Quickstart บน AWS ซึ่งช่วยให้คุณสร้างคลัสเตอร์ที่มีความพร้อมใช้งานสูงของ Linux ที่กำหนดค่าอย่างสมบูรณ์และใช้งานได้ในไม่กี่ขั้นตอนสั้นๆ มันตั้งค่าสถาปัตยกรรม AWS สำหรับ SIOS Protection Suite สำหรับ Linux และปรับใช้ในบัญชี AWS ของคุณในเวลาประมาณครึ่งชั่วโมง การเริ่มต้นอย่างรวดเร็วนี้มีอยู่ใน AWS Marketplace มีไว้สำหรับผู้ใช้ระดับองค์กรที่ต้องการปรับใช้ SIOS Protection Suite สำหรับ Linux บน AWS ในสภาพแวดล้อมการทดสอบหรือการใช้งานจริง

การทำคลัสเตอร์ SIOS สำหรับ Linux

SIOS เป็นบริษัทที่มีความพร้อมใช้งานสูงซึ่งใช้เวลา 20 ปีที่ผ่านมาโดยมุ่งเน้นที่การนำเสนอ HA ที่ออกแบบมาโดยเฉพาะสำหรับ SAP, SQL, Linux, Oracle และแอปพลิเคชันอื่นๆ ประสบการณ์ของมันถูกสร้างขึ้นในผลิตภัณฑ์ การติดตั้งและการกำหนดค่าใช้เวลาและค่าใช้จ่ายเพียงเล็กน้อยเมื่อเทียบกับการเขียนสคริปต์แบบกำหนดเองกับลีนุกซ์รุ่นต่างๆนอกจากนี้ SIOS จะทดสอบและตรวจสอบระบบปฏิบัติการและแอปพลิเคชันเวอร์ชันใหม่เพื่อให้ลูกค้าไม่ต้องทำเมื่อลูกค้าโทรหา SIOS เพื่อขอรับการสนับสนุน พวกเขาจะเชื่อมต่อกับผู้เชี่ยวชาญที่มีความพร้อมใช้งานสูง ซึ่งเป็นผู้ที่มุ่งเน้นเฉพาะ HA เท่านั้นและดำเนินการดังกล่าวมาเป็นเวลานาน

สำหรับข้อมูลเพิ่มเติม โปรดดูเอกสารไวท์เปเปอร์ SIOS “การนำความพร้อมใช้งานสูงไปใช้ในสภาพแวดล้อม Linux” ข้อมูลอ้างอิงเพิ่มเติม https://whatis.techtarget.com/definition/clustered-storage สืบพันธุ์จาก SIOS

Filed Under: ทำให้เข้าใจง่ายเซิร์ฟเวอร์คลัสเตอร์

คลัสเตอร์ล้มเหลว

ธันวาคม 18, 2021 by Jason Aw Leave a Comment

คลัสเตอร์ล้มเหลว

คลัสเตอร์ล้มเหลว

โซลูชันซอฟต์แวร์คลัสเตอร์ล้มเหลว: สิ่งที่คุณต้องรู้

เฟลโอเวอร์คืออะไร?

The “Tell All” บน Failover

เฟลโอเวอร์เป็นกระบวนการที่ระบบสแตนด์บาย สำรอง ฐานข้อมูล หรือเครือข่ายถือว่าการดำเนินการเมื่อระบบหลัก ฐานข้อมูล หรือเครือข่ายล้มเหลว หรือการดำเนินการหลักถูกยกเลิกอย่างผิดปกติ Hot failover เป็นหนึ่งในหลักการออกแบบที่สำคัญที่รวมอยู่ใน ความพร้อมใช้งานสูงและระบบการกู้คืนจากภัยพิบัติ

RTO คือระยะเวลาสูงสุดของไฟดับ โดยทั่วไป แอปพลิเคชันประมวลผลธุรกรรมออนไลน์จะมี RTO ต่ำที่สุด และแอปพลิเคชันที่มีความสำคัญต่อภารกิจมักมี RTO เพียงไม่กี่วินาที

RPO คือจำนวนการสูญเสียข้อมูลสูงสุดที่สามารถยอมรับได้เมื่อเกิดความล้มเหลวขึ้น สำหรับ HA RPO มักจะเป็นศูนย์เพื่อระบุว่าควรมีข้อมูลสูญหายเป็นศูนย์ภายใต้สถานการณ์ความล้มเหลวทั้งหมด

มาทำความเข้าใจกับความล้มเหลวกันเถอะ

อันดับแรก เราต้องหารือเกี่ยวกับความแตกต่างระหว่างเซิร์ฟเวอร์สแตนด์บายแบบเย็น อุ่น และร้อน:

  • เซิร์ฟเวอร์เย็น (บางครั้งเรียกว่าโคลด์เฟลโอเวอร์) เป็นเซิร์ฟเวอร์ที่ไม่ได้เชื่อมต่อกับเซิร์ฟเวอร์หลัก แต่จะพร้อมใช้งานและเปิดเฉพาะเมื่อเซิร์ฟเวอร์หลักหยุดทำงาน เมื่อใช้เซิร์ฟเวอร์แบบเย็น อาจต้องใช้เวลามากในการเปิดเครื่องเซิร์ฟเวอร์สำรอง ซึ่งอาจต้องมีการกำหนดค่าและซอฟต์แวร์ที่อัปเดต ซึ่งหมายความว่า Recovery Time Objectives (RTO) และ Recovery Point Objectives (RPO) นั้นยาวที่สุด Cold Failover ถือว่าไม่เป็นที่ยอมรับสำหรับแอปพลิเคชันที่มีความสำคัญต่อภารกิจ
  • เซิร์ฟเวอร์ที่อบอุ่น/ล้มเหลวเป็นเซิร์ฟเวอร์ที่ได้รับการอัปเดตเป็นระยะๆ จากเซิร์ฟเวอร์หลักผ่านการจำลองข้อมูลและการมิเรอร์
  • เซิร์ฟเวอร์ฮอต/เฟลโอเวอร์คือเซิร์ฟเวอร์ที่ได้รับการอัปเดตเป็นประจำจากเซิร์ฟเวอร์หลักและพร้อมให้เข้าควบคุมทันทีในกรณีที่เกิดเฟลโอเวอร์ Hot Failover เป็นการใช้ทรัพยากรที่เข้มข้นที่สุด ส่งผลให้ข้อมูลสูญหายเป็นศูนย์ (ศูนย์ RPO) และ RPO ไม่เกินสองสามนาที และจำเป็นเพื่อรองรับความพร้อมใช้งานสูงสำหรับแอปพลิเคชันที่มีความสำคัญต่อภารกิจ

ซอฟต์แวร์ SIOS Failover Cluster รองรับการเฟลโอเวอร์แบบด่วน โดยให้ RPO เป็นศูนย์และ RTO ระดับมิลลิวินาทีสำหรับ ความพร้อมใช้งานสูง . ผลลัพธ์: ความล้มเหลวของระบบส่งผลให้ไม่มีข้อมูลสูญหาย และโปร่งใสต่อผู้ใช้

ซอฟต์แวร์คลัสเตอร์ล้มเหลว SIOS

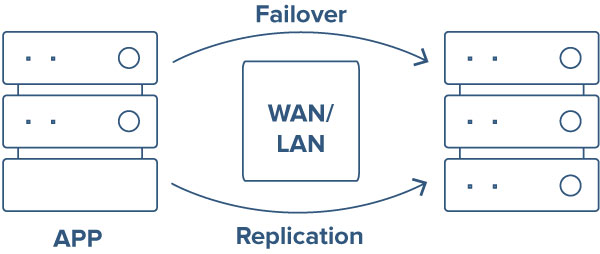
SIOS นำเสนอซอฟต์แวร์คลัสเตอร์เฟลโอเวอร์ ดังนั้นคุณสามารถสร้างคลัสเตอร์การจัดเก็บข้อมูลที่ใช้ร่วมกันแบบดั้งเดิมสำหรับความพร้อมใช้งานสูง หรือคลัสเตอร์ SIOS SANless ที่ใช้ที่เก็บข้อมูลในเครื่อง ซอฟต์แวร์ SIOS ใช้การจำลองข้อมูลแบบซิงโครนัสแบบเรียลไทม์ (สำหรับสภาพแวดล้อม LAN) หรืออะซิงโครนัส (สำหรับสภาพแวดล้อม WAN) เพื่อซิงโครไนซ์ที่เก็บข้อมูล

โซลูชัน SIOS ให้ความพร้อมใช้งานสูงและ การกู้คืนระบบ ด้วยโซลูชั่นเดียว วิธีนี้ช่วยลดต้นทุนและความซับซ้อนของการจำลองแบบที่ใช้ SAN ด้วยความสามารถในการจำลองแบบไปยังหลายเป้าหมาย คุณสามารถกำหนดค่าคลัสเตอร์เฟลโอเวอร์แบบหลายโหนดที่มีโหนดอยู่ในหลายตำแหน่งเพื่อปกป้องระบบของคุณจากภัยพิบัติ

ด้วยคลัสเตอร์ SIOS คุณสามารถทำซ้ำระหว่างการกำหนดค่าที่คุณเลือก – ระหว่างสภาพแวดล้อม SAN และ SANless และการกำหนดค่าทางกายภาพ เสมือน คลาวด์ และไฮบริด อันที่จริง โซลูชันการทำคลัสเตอร์ SIOS นั้นมีความพิเศษเฉพาะในระบบปฏิบัติการ แอปพลิเคชัน และสภาพแวดล้อมโครงสร้างพื้นฐานที่รองรับ ซึ่งรวมถึง Windows, Linux, SAP, SQL Server, Oracle, AWS, Azure และแพลตฟอร์มคลาวด์ของ Google

ความล้มเหลวของ SIOS
ซอฟต์แวร์ SIOS Failover Cluster ใช้การจำลองแบบระดับบล็อกที่มีประสิทธิภาพเพื่อให้ที่เก็บข้อมูลในเครื่องซิงโครไนซ์ ทำให้โหนดรองในคลัสเตอร์ของคุณทำงานต่อไปได้หลังจากเกิดข้อผิดพลาดด้วยการเข้าถึงข้อมูลล่าสุด

ในสภาพแวดล้อมของ Windows SIOS DataKeeper ให้ความยืดหยุ่นแก่คุณในการสร้างคลัสเตอร์ Windows ในสภาพแวดล้อมทางกายภาพ เสมือน และคลาวด์ SIOS DataKeeper Cluster Edition ผสานรวมกับและขยาย Windows Server Failover Clustering (WSFC) ได้อย่างราบรื่นโดยมอบการเพิ่มประสิทธิภาพการทำงานตามโฮสต์ การจำลองข้อมูล กลไก.

ในสภาพแวดล้อม Linux SIOS LifeKeeper และ SIOS DataKeeper ให้การรวมกันอย่างแน่นหนาของคลัสเตอร์เฟลโอเวอร์ที่มีความพร้อมใช้งานสูง การตรวจสอบแอปพลิเคชันอย่างต่อเนื่อง การจำลองข้อมูล และนโยบายการกู้คืนที่กำหนดค่าได้ ปกป้องแอปพลิเคชันที่มีความสำคัญต่อธุรกิจของคุณจากการหยุดทำงานและภัยพิบัติ


มาทบทวนกรณีศึกษาหนึ่งเรื่องที่พูดถึงประโยชน์ของหนึ่งในโซลูชันของ SIOS – SIOS DataKeeper

โซลูชันซอฟต์แวร์คลัสเตอร์ล้มเหลว SIOS ในการดำเนินการ

Van de Lande BR (VDL) ตั้งอยู่ในประเทศเนเธอร์แลนด์ ผลิตข้อต่อและวาล์วอัด PVC และ PE หลากหลายประเภท ผลิตภัณฑ์ของพวกเขาถูกใช้ทั่วโลกในการติดตั้งทางอุตสาหกรรมและทางเทคนิค การผลิตผลิตภัณฑ์ที่แตกต่างกันมากกว่า 4500 รายการ VDL มุ่งมั่นที่จะปรับปรุงและคุณภาพผลิตภัณฑ์ ทำให้แบรนด์ของพวกเขาเป็นตัวเลือกสำหรับผู้สร้างระบบและการติดตั้งมานานกว่า 50 ปี

VDL มีสภาพแวดล้อม Hyper-V ที่เก็บข้อมูลโซลิดสเตตดิสก์ (SSD) และธุรกิจต้องพึ่งพาโซลูชัน ERP เป็นอย่างมาก เมื่อมีระบบประมวลผลข้อมูลเพียงระบบเดียว VDL ก็ถูกเปิดเผยและต้องการโซลูชันการกู้คืนความเสียหาย (DR) เพื่อให้แน่ใจว่ามีการป้องกันและความพร้อมใช้งานของ ERP บริการเว็บ และระบบภารกิจสำคัญอื่นๆ ในกรณีที่เกิดภัยพิบัติ

เพื่อส่งมอบการป้องกันเฟลโอเวอร์และ DR ในทันที VDL ได้สร้างระบบ Windows Server Failover Clustering (WSFC) โดยมีโหนดหนึ่งจำลองข้อมูลไปยังโหนดอื่น หากโหนดหลักล้มเหลว WSFC จะถ่ายโอนการดำเนินการทั้งหมดไปยังโหนดสแตนด์บาย ทำให้ผู้ใช้สามารถเข้าถึงแอปพลิเคชันและข้อมูลได้อย่างต่อเนื่อง

VDL ยังเลือก SIOS DataKeeper Cluster Edition เพื่อจัดหา DR สำหรับเครื่องเสมือน Hyper-V (VM) SIOS DataKeeper เป็นซอฟต์แวร์เสริมที่ช่วยให้เข้าถึงข้อมูลได้อย่างต่อเนื่อง โดยผสานรวมกับ WSFC ได้อย่างราบรื่นเพื่อเพิ่มการจำลอง Hyper-V VMs แบบเรียลไทม์ที่ปรับให้เหมาะสมกับประสิทธิภาพการทำงานบนโฮสต์ ซิงโครนัสหรืออะซิงโครนัสแบบเรียลไทม์ระหว่างเซิร์ฟเวอร์จริงผ่านการเชื่อมต่อ LAN และ WAN การทำงานกับ WSFC นั้น SIOS DataKeeper จะตรวจสอบความสมบูรณ์ของระบบและแอปพลิเคชัน รักษาการเชื่อมต่อของไคลเอ็นต์ และทำให้สามารถสร้างคลัสเตอร์ SANless ได้ คลัสเตอร์ SANless ต่างจาก SAN ตรงที่กำจัดจุดล้มเหลวเพียงจุดเดียว และลดต้นทุนและความซับซ้อนในการปรับใช้คลัสเตอร์

SIOS DataKeeper ยังใช้ WSFC เพื่อให้ผู้ดูแลระบบมีโซลูชัน HA/DR ที่คุ้นเคยและไม่เชื่อเรื่องพระเจ้าของแอปพลิเคชัน ซึ่งจะทำให้การใช้งานและการดำเนินการง่ายขึ้นอย่างมาก

VDL ปรับใช้คลัสเตอร์ SIOS DataKeeper สองคลัสเตอร์ คลัสเตอร์สองโหนดทำงานเป็นเซิร์ฟเวอร์ไฟล์และเซิร์ฟเวอร์ iSCSI ในขณะที่อีกคลัสเตอร์หนึ่งสนับสนุนคลัสเตอร์ SQL Server (ERP) และบริการเว็บ Dynamics NAV การดำเนินการใช้เวลาน้อยกว่าหนึ่งวัน ในระหว่างการทดสอบระบบเฟลโอเวอร์ ทีมบริการเครือข่ายล้มเหลวและล้มเหลวในการสำรองระบบอย่างรวดเร็วและง่ายดาย หลังจากการประเมินการกำหนดค่าเซิร์ฟเวอร์ VDL อย่างละเอียดและการทดสอบเสร็จสิ้น ทีมติดตั้งยืนยันว่า SIOS DataKeeper และคลัสเตอร์ SANless ตรงตามเกณฑ์ทั้งหมดสำหรับการกู้คืนจากภัยพิบัติ ประสิทธิภาพ และความพร้อมใช้งานสูงของระบบ ERP บริการเว็บ และภารกิจอื่นๆ – แอปพลิเคชันที่สำคัญ องค์กรจะไม่เสี่ยงต่อการสูญหายของข้อมูลในกรณีที่เกิดความล้มเหลวอีกต่อไป

สิ่งสุดท้าย

นอกจากการทดสอบ SIOS แล้ว VDL ยังทดสอบโซลูชันอื่นๆ ด้วยผลลัพธ์ที่ยอมรับไม่ได้ ความคิดเห็น Maurits van de Lande ผู้จัดการ ICT ที่ VDL “เราได้ทดสอบเซิร์ฟเวอร์ไฟล์ของเราด้วยการจำลองแบบ DFS และเทคโนโลยี AlwaysOn แล้ว ไม่ได้ส่งมอบโซลูชันการกู้คืนความเสียหายแบบอัตโนมัติที่ตรงกับ SIOS DataKeeper ซึ่งตอบสนองข้อกำหนด DR ของเราอย่างครบถ้วน” ———————————————————————————————————————————— ไม่ว่าสภาพแวดล้อมไอทีของคุณจะเป็นอย่างไร องค์กรของคุณสามารถใช้ประโยชน์จาก SIOS DataKeeper Cluster Edition และ DataKeeper Standard Edition ซึ่งทั้งสองอย่างนี้ให้ความยืดหยุ่นในการกำหนดค่า ลดต้นทุนการถ่ายโอนข้อมูล กำจัดจุดล้มเหลวเพียงจุดเดียว ลดความซับซ้อน และเพิ่มประสิทธิภาพเครือข่าย

สำหรับข้อมูลเพิ่มเติม, ติดต่อเรา หรือขอ ทดลองฟรี .

ข้อมูลอ้างอิง:

  • https://nilebride.wordpress.com/2011/07/24/log-shipping-vs-mirroring-vs-replication/
  • https://techdifferences.com/difference-between-mirroring-and-replication.html
  • https://docs.microsoft.com/en-us/windows-server/failover-clustering/failover-clustering-overview

สืบพันธุ์จาก SIOS


Filed Under: ทำให้เข้าใจง่ายเซิร์ฟเวอร์คลัสเตอร์

การจำลองข้อมูล

ธันวาคม 13, 2021 by Jason Aw Leave a Comment

การจำลองข้อมูล


การจำลองข้อมูล

การจำลองข้อมูลตามเวลาจริงเพื่อความพร้อมใช้งานสูง

การจำลองข้อมูลคืออะไร

การจำลองข้อมูล เป็นกระบวนการที่ข้อมูลบนเซิร์ฟเวอร์จริง/เสมือนหรืออินสแตนซ์คลาวด์ (อินสแตนซ์หลัก) ถูกจำลองหรือคัดลอกอย่างต่อเนื่องไปยังเซิร์ฟเวอร์รองหรืออินสแตนซ์คลาวด์ (อินสแตนซ์สแตนด์บาย) องค์กรจำลองข้อมูลเพื่อรองรับ ความพร้อมใช้งานสูง , การสำรองข้อมูล และ/หรือการกู้คืนข้อมูลหลังภัยพิบัติ ข้อมูลจะถูกจำลองแบบซิงโครนัสหรืออะซิงโครนัสทั้งนี้ขึ้นอยู่กับตำแหน่งของอินสแตนซ์รอง วิธีที่ข้อมูลถูกจำลองแบบส่งผลกระทบต่อ Recovery Time Objectives (RTO) และ Recovery Point Objectives (RPO)

ตัวอย่างเช่น หากคุณต้องการกู้คืนจากความล้มเหลวของระบบ อินสแตนซ์สแตนด์บายของคุณควรอยู่บนเครือข่ายท้องถิ่น (LAN) สำหรับแอปพลิเคชันฐานข้อมูลที่สำคัญ คุณสามารถจำลองข้อมูลแบบซิงโครนัสจากอินสแตนซ์หลักผ่าน LAN ไปยังอินสแตนซ์รองได้ ซึ่งจะทำให้อินสแตนซ์สแตนด์บายของคุณ "ร้อน" และซิงค์กับอินสแตนซ์ที่ใช้งานอยู่ ดังนั้นจึงพร้อมรับช่วงต่อทันทีในกรณีที่เกิดความล้มเหลว สิ่งนี้เรียกว่าความพร้อมใช้งานสูง (HA)

ในกรณีที่เกิดภัยพิบัติ คุณต้องแน่ใจว่าอินสแตนซ์รองของคุณไม่ได้อยู่ร่วมกับอินสแตนซ์หลักของคุณ ซึ่งหมายความว่าคุณต้องการให้อินสแตนซ์รองในไซต์ทางภูมิศาสตร์อยู่ห่างจากอินสแตนซ์หลักหรือในอินสแตนซ์ระบบคลาวด์ที่เชื่อมต่อผ่าน WAN เพื่อหลีกเลี่ยงผลกระทบด้านลบต่อประสิทธิภาพของปริมาณงาน การจำลองข้อมูลบน WAN จะไม่พร้อมกัน ซึ่งหมายความว่าการอัปเดตอินสแตนซ์สแตนด์บายจะทำให้การอัปเดตที่ทำกับอินสแตนซ์ที่ใช้งานอยู่ล่าช้า ส่งผลให้เกิดความล่าช้าในระหว่างกระบวนการกู้คืน

ทำไมต้องทำซ้ำข้อมูลไปยังคลาวด์?

มีเหตุผลห้าประการที่คุณต้องการจำลองข้อมูลของคุณไปยังคลาวด์

  1. ดังที่เราได้กล่าวไว้ข้างต้น การจำลองแบบบนคลาวด์จะเก็บข้อมูลของคุณไว้นอกสถานที่และอยู่ห่างจากไซต์ของบริษัท แม้ว่าภัยพิบัติครั้งใหญ่ เช่น ไฟไหม้ น้ำท่วม พายุ ฯลฯ สามารถทำลายล้างอินสแตนซ์หลักของคุณ อินสแตนซ์รองของคุณนั้นปลอดภัยในระบบคลาวด์ และสามารถนำมาใช้เพื่อกู้คืนข้อมูลและแอปพลิเคชันที่ได้รับผลกระทบจากภัยพิบัติ
  2. การจำลองแบบคลาวด์มีราคาถูกกว่าการจำลองข้อมูลไปยังศูนย์ข้อมูลของคุณเอง คุณสามารถขจัดค่าใช้จ่ายที่เกี่ยวข้องกับการบำรุงรักษาศูนย์ข้อมูลสำรอง ซึ่งรวมถึงค่าใช้จ่ายด้านฮาร์ดแวร์ การบำรุงรักษา และการสนับสนุน
  3. สำหรับธุรกิจขนาดเล็ก การจำลองข้อมูลไปยังระบบคลาวด์จะมีความปลอดภัยมากขึ้น โดยเฉพาะหากคุณไม่มีความชำนาญด้านความปลอดภัยเกี่ยวกับพนักงาน ทั้งความปลอดภัยทางกายภาพและเครือข่ายที่ผู้ให้บริการระบบคลาวด์มอบให้นั้นไม่มีใครเทียบได้
  4. การจำลองข้อมูลไปยังระบบคลาวด์ทำให้สามารถปรับขนาดได้ตามต้องการ เมื่อธุรกิจของคุณเติบโตหรือหดตัว คุณไม่จำเป็นต้องลงทุนในฮาร์ดแวร์เพิ่มเติมเพื่อรองรับอินสแตนซ์รองของคุณ หรือให้ฮาร์ดแวร์นั้นไม่ได้ใช้งานหากธุรกิจชะลอตัว คุณยังไม่มีสัญญาระยะยาว
  5. เมื่อจำลองข้อมูลไปยังระบบคลาวด์ คุณมีตัวเลือกทางภูมิศาสตร์มากมาย รวมถึงการมีอินสแตนซ์ระบบคลาวด์ในเมืองถัดไป ทั่วประเทศ หรือในประเทศอื่นตามที่ธุรกิจของคุณกำหนด

เหตุใดจึงต้องทำซ้ำข้อมูลระหว่างอินสแตนซ์ระบบคลาวด์

แม้ว่าผู้ให้บริการระบบคลาวด์จะระมัดระวังทุกวิถีทางเพื่อให้แน่ใจว่าพร้อมใช้งานได้ 100 เปอร์เซ็นต์ แต่ก็เป็นไปได้ที่เซิร์ฟเวอร์คลาวด์แต่ละตัวจะล้มเหลวอันเนื่องมาจากความเสียหายทางกายภาพต่อความผิดพลาดของฮาร์ดแวร์และซอฟต์แวร์ ซึ่งเป็นสาเหตุเดียวกันทั้งหมดที่ทำให้ฮาร์ดแวร์ภายในองค์กรล้มเหลว ด้วยเหตุผลนี้ องค์กรที่รันแอปพลิเคชันที่มีความสำคัญต่อภารกิจในคลาวด์ควรทำซ้ำข้อมูลบนคลาวด์เพื่อรองรับ ความพร้อมใช้งานสูง และ การกู้คืนระบบ . คุณสามารถจำลองข้อมูลระหว่างโซนความพร้อมใช้งานในภูมิภาคเดียว ระหว่างภูมิภาคในคลาวด์ ระหว่างแพลตฟอร์มคลาวด์ต่างๆ กับระบบภายในองค์กร หรือการผสมผสานแบบไฮบริดใดๆ

การจำลองข้อมูลแบบเรียลไทม์ของ SIOS เพื่อความพร้อมใช้งานสูงและการกู้คืนจากภัยพิบัติ

SIOS Datakeeper™ ใช้การจำลองข้อมูลระดับบล็อกที่มีประสิทธิภาพเพื่อให้อินสแตนซ์หลักและรองของคุณซิงโครไนซ์ หากเกิดเฟลโอเวอร์ อินสแตนซ์รองยังคงทำงานต่อไป ทำให้ผู้ใช้สามารถเข้าถึงข้อมูลล่าสุดได้ ด้วยโซลูชัน SIOS RPO จะเป็นศูนย์เสมอ และ RTO จะขึ้นอยู่กับแอปพลิเคชัน แต่โดยทั่วไปแล้ว 30 วินาทีถึงสองสามนาที

ผลิตภัณฑ์ SIOS ปกป้องแอปพลิเคชันที่ใช้ Windows หรือ Linux ที่ทำงานในสภาพแวดล้อมจริง เสมือน คลาวด์หรือไฮบริด และในสถานการณ์การกู้คืนไซต์หรือภัยพิบัติร่วมกัน ทำให้มีความพร้อมใช้งานสูงและการกู้คืนจากความเสียหายสำหรับแอปพลิเคชัน เช่น SAP และฐานข้อมูล รวมทั้ง Oracle , ฮานา, MaxDB, SQL Server , DB2 และอื่นๆ อีกมากมาย ความเรียบง่าย "นอกกรอบ" ความยืดหยุ่นในการกำหนดค่า ความน่าเชื่อถือ ประสิทธิภาพ และความคุ้มค่าของผลิตภัณฑ์ SIOS ทำให้พวกเขาแตกต่างจากผลิตภัณฑ์อื่นๆ ซอฟต์แวร์จัดกลุ่ม .

ในสภาพแวดล้อม Windows SIOS DataKeeper Cluster Edition จะผสานรวมกับและขยาย Windows Server Failover Clustering (WSFC) ได้อย่างราบรื่นด้วยกลไกการจำลองข้อมูลตามโฮสต์ที่เพิ่มประสิทธิภาพการทำงาน ในขณะที่ WSFC จัดการคลัสเตอร์ซอฟต์แวร์ SIOS จะทำการจำลองข้อมูลเพื่อเปิดใช้งานการป้องกันจากภัยพิบัติ และทำให้แน่ใจว่าข้อมูลสูญหายเป็นศูนย์ ในกรณีที่คลัสเตอร์การจัดเก็บข้อมูลที่ใช้ร่วมกันเป็นไปไม่ได้หรือทำไม่ได้ เช่น ในสภาพแวดล้อมการจัดเก็บข้อมูลบนคลาวด์ ระบบเสมือน และประสิทธิภาพสูง

ในสภาพแวดล้อม Linux SIOS LifeKeeper และ SIOS DataKeeper ให้การรวมกันอย่างแน่นหนาของคลัสเตอร์เฟลโอเวอร์ที่มีความพร้อมใช้งานสูง การตรวจสอบแอปพลิเคชันอย่างต่อเนื่อง การจำลองข้อมูล และนโยบายการกู้คืนที่กำหนดค่าได้ ปกป้องแอปพลิเคชันที่มีความสำคัญต่อธุรกิจของคุณจากการหยุดทำงานและภัยพิบัติ

——————————————————————————————————————————— นี่คือตัวอย่างในโลกแห่งความเป็นจริง ว่าบริษัทผู้ผลิตชั้นนำรายใดรายหนึ่งใช้ SIOS เพื่อสร้างโซลูชันที่มีความพร้อมใช้งานสูงในระบบคลาวด์โดยใช้การจำลองข้อมูลแบบเรียลไทม์

วิธีบรรลุ HA ในสภาพแวดล้อมคลาวด์ด้วยการจำลองข้อมูลตามเวลาจริง

Bonfiglioli เป็นบริษัทชั้นนำด้านการออกแบบ ผลิต และจัดจำหน่ายของอิตาลี เชี่ยวชาญด้านระบบอัตโนมัติทางอุตสาหกรรม เครื่องจักรเคลื่อนที่ และผลิตภัณฑ์พลังงานลม และมีพนักงานมากกว่า 3,600 คนในสถานที่ต่างๆ ทั่วโลก ในการดำเนินธุรกิจ บริษัทต้องอาศัยแอปพลิเคชันที่สำคัญต่อภารกิจต่างๆ รวมถึงระบบ SAP ERP โครงสร้างพื้นฐานด้านไอทีของบริษัทประกอบด้วยศูนย์ข้อมูล VMware ภายในองค์กรและศูนย์ข้อมูลระยะไกลเพื่อความต่อเนื่องทางธุรกิจและการป้องกันภัยพิบัติ เนื่องจากแอปพลิเคชันส่วนใหญ่ทำงานในสภาพแวดล้อม Windows Bonfiglioli จึงใช้คลัสเตอร์ Windows Server failover ระดับแขกในสภาพแวดล้อม VMware เพื่อให้มีความพร้อมใช้งานสูงและการป้องกันภัยพิบัติ

ทีมไอทีของบริษัทใช้โปรแกรมเพื่อย้ายส่วนหนึ่งของการดำเนินงานด้านไอทีไปยังคลาวด์ของ Microsoft Azure และใช้ประโยชน์จาก Azure เป็นไซต์กู้คืนจากความเสียหาย ข้อกำหนดที่สำคัญของแผนการโยกย้ายของบริษัทคือการทำให้แน่ใจว่าสถาปัตยกรรมคลาวด์สามารถให้การป้องกันความพร้อมใช้งานสูงได้ดีกว่าเมื่อก่อน และทำให้แน่ใจว่า Bonfiglioli สามารถปฏิบัติตามข้อตกลงระดับบริการ (SLA) ที่เข้มงวดได้ต่อไป

ในสภาพแวดล้อมภายในองค์กร บริษัทใช้คลัสเตอร์ VMware ซึ่งช่วยให้ Windows Server Failover Clustering (WSFC) สามารถจัดการการเฟลโอเวอร์ไปยังเซิร์ฟเวอร์รองในกรณีที่โครงสร้างพื้นฐานล้มเหลว อย่างไรก็ตาม การให้การป้องกันประเภทนี้ในระบบคลาวด์ถือเป็นความท้าทาย เนื่องจากการใช้คลัสเตอร์เกสต์กับดิสก์บัสที่ใช้ร่วมกันไม่ใช่โซลูชันระบบคลาวด์ที่ทำงานได้ การสร้างคลัสเตอร์ใน VMware โดยใช้ Raw Device Mapping และแชร์บัสดิสก์ (RDM) นั้นท้าทายและสร้างข้อจำกัดสำหรับการสำรองข้อมูลเครื่องเสมือน

การแก้ไขปัญหา

หลังจากประเมินโซลูชันหลายรายการแล้ว Bonfiglioli เลือก SIOS DataKeeper ให้เป็นระบบคลาวด์ที่มีความพร้อมใช้งานสูงและโซลูชันการกู้คืนจากความเสียหายเมื่อเรียนรู้ว่า SIOS DataKeeper เป็นโซลูชันคลัสเตอร์ที่มีความพร้อมใช้งานสูงที่ผ่านการรับรองเพียงโซลูชันเดียวสำหรับ SAP ในระบบคลาวด์สาธารณะ นอกจากนี้ BGP ซึ่งเป็นหุ้นส่วนที่ปรึกษาด้านการจัดการของ Bonfiglioli มีประสบการณ์กับ SIOS DataKeeper และรู้ว่าติดตั้งง่าย โปร่งใสต่อระบบปฏิบัติการ และโซลูชันที่ได้รับการพิสูจน์แล้วและมีประสิทธิภาพสูง

ด้วย SIOS ทีมไอทีได้สร้างสภาพแวดล้อมแบบคลัสเตอร์โดยไม่มี RDM พวกเขาสร้างคลัสเตอร์สองโหนดใน VMware และเพิ่ม SIOS DataKeeper Cluster Edition เพื่อซิงโครไนซ์ที่เก็บข้อมูลผ่านการจำลองข้อมูลแบบเรียลไทม์ในแต่ละอินสแตนซ์ของคลัสเตอร์ ในสภาพแวดล้อมภายในองค์กร พื้นที่จัดเก็บข้อมูลแบบซิงโครไนซ์จะปรากฏต่อ WSFC เป็นดิสก์จัดเก็บข้อมูลที่ใช้ร่วมกันเพียงแผ่นเดียว

SIOS DataKeeper ยังให้การป้องกันความพร้อมใช้งานสูงสำหรับอินสแตนซ์ SAP ของบริษัท และกำจัดจุดล้มเหลวเพียงจุดเดียว ทีมไอทีใช้ SIOS DataKeeper จำลองดิสก์พาร์ติชันระดับ SSD ในศูนย์ข้อมูลภายในองค์กรของบริษัทโดยใช้การจำลองข้อมูลแบบเรียลไทม์ ซึ่งช่วยให้ Bonfiglioli สามารถกู้คืนเครื่องเสมือนไปยัง Microsoft Azure ได้ในกรณีที่เกิดภัยพิบัติ

ผลลัพธ์

Daniele Bovina สถาปนิกระบบที่ Bonfiglioli แสดงความคิดเห็นเกี่ยวกับผลลัพธ์ "SIOS DataKeeper ทำให้เรามีวิธีง่ายๆ ในการย้ายระบบ SAP ที่มีความสำคัญต่อธุรกิจของเราไปยัง Microsoft Azure cloud พร้อมปฏิบัติตาม SLA ที่เข้มงวดของเราในด้านความพร้อมใช้งาน การกู้คืนจากความเสียหาย และประสิทธิภาพ” ——————————————————————————————————————————– สำหรับข้อมูลเพิ่มเติมเกี่ยวกับ SIOS Clustering Solutions ติดต่อเรา หรือ ขอทดลองใช้ฟรี .

อ้างอิง

  • https://storageservers.wordpress.com/2018/02/12/difference-between-backup-and-replication-2/
  • http://www.bbc.co.uk/newsbeat/article/16838342/could-the-digital-cloud-used-for-storage-ever-crash

สืบพันธุ์จาก SIOS

Filed Under: ทำให้เข้าใจง่ายเซิร์ฟเวอร์คลัสเตอร์

  • « Previous Page
  • 1
  • …
  • 55
  • 56
  • 57
  • 58
  • 59
  • …
  • 112
  • Next Page »

โพสต์ล่าสุด

  • ระบบความพร้อมใช้งานสูง (High Availability หรือ HA) คืออะไร?
  • เอาตัวรอดจากวิกฤตการณ์วันศุกร์: จากระบบคอมพิวเตอร์แบบดิบๆ สู่การจำลองข้อมูลที่ราบรื่น
  • ติดดิน: สิ่งที่การพลาดชม Percona Live Amsterdam สอนฉันเกี่ยวกับ HA
  • เปรียบเทียบ SIOS LifeKeeper กับ Red Hat High Availability Add-On:
  • สถานะของความยืดหยุ่นของแอปพลิเคชัน: ผลสำรวจความพร้อมใช้งานสูงของ SIOS ปี 2026

กระทู้ยอดนิยม

เข้าร่วมรายชื่อผู้รับจดหมายของเรา

Copyright © 2026 · Enterprise Pro Theme on Genesis Framework · WordPress · Log in