SIOS SANless clusters

SIOS SANless clusters High-availability Machine Learning monitoring

  • Home
  • Products
    • SIOS DataKeeper for Windows
    • SIOS Protection Suite for Linux
  • การทดสอบอาหารสัตว์
  • ข่าวสารและกิจกรรม
  • ทำให้เข้าใจง่ายเซิร์ฟเวอร์คลัสเตอร์
  • เรื่องราวความสำเร็จ
  • ติดต่อเรา
  • English
  • 中文 (中国)
  • 中文 (台灣)
  • 한국어
  • Bahasa Indonesia
  • ไทย

บรรลุความยืดหยุ่นด้านไอทีด้วยความพร้อมใช้งานสูง

ธันวาคม 8, 2021 by Jason Aw Leave a Comment

บรรลุความยืดหยุ่นด้านไอทีด้วยความพร้อมใช้งานสูง

บรรลุความยืดหยุ่นด้านไอทีด้วยความพร้อมใช้งานสูง

ความยืดหยุ่นด้านไอทีคืออะไร?

ความยืดหยุ่นของไอทีคือความสามารถขององค์กรในการรักษาระดับการบริการที่ยอมรับได้ เมื่อเกิดการหยุดชะงักของการดำเนินธุรกิจ กระบวนการที่สำคัญ หรือระบบนิเวศไอทีของคุณ ในยุคดิจิทัลนี้ ความพร้อมใช้งานสูงมีความสำคัญต่อความสำเร็จขององค์กรของคุณ ลูกค้าของคุณจะไม่ยอมให้เว็บไซต์ล่ม และคุณไม่สามารถซื้อ ERP, CRM หรือระบบที่มีความสำคัญต่อธุรกิจอื่นๆ ได้ นี่คือที่ ความพร้อมใช้งานสูง เข้ามา.

องค์กรของคุณต้อง "ทำเครื่องหมายในช่อง" ของเทคโนโลยีและโซลูชันต่างๆ มากมายเพื่อให้แน่ใจว่าไอทีมีความยืดหยุ่น อย่างน้อยก็อย่างน้อยในนั้นก็รับประกันว่าคุณมีข้อมูลสำรอง การกู้คืนจากภัยพิบัติ ความยืดหยุ่นทางไซเบอร์ และความพร้อมใช้งานสูง สำหรับวัตถุประสงค์ของบทความนี้ เราจะพูดถึงความพร้อมใช้งานสูง (HA) เป็นหนึ่งในองค์ประกอบหลักที่จำเป็นเพื่อให้แน่ใจว่าไอทีมีความยืดหยุ่น

ความพร้อมใช้งานสูงคืออะไร?

ระบบที่มีความพร้อมใช้งานสูงช่วยให้มั่นใจได้ว่าการดำเนินธุรกิจจะดำเนินต่อไป – ด้วยความโปร่งใสทั้งหมดต่อลูกค้าและผู้ใช้ – เมื่อระบบ แอปพลิเคชัน และเครือข่ายของคุณล่ม HA เป็นส่วนประกอบของระบบเทคโนโลยีที่ขจัดจุดบกพร่องเพียงจุดเดียวเพื่อให้แน่ใจว่ามีการทำงานอย่างต่อเนื่องหรือเวลาทำงานต่อเนื่องเป็นระยะเวลานาน ระบบที่มีความพร้อมใช้งานสูงรวมเอาหลักการออกแบบห้าประการ: การเฟลโอเวอร์อัตโนมัติ การตรวจจับความล้มเหลวระดับแอปพลิเคชันโดยอัตโนมัติ ไม่มีข้อมูลสูญหาย ความล้มเหลวโดยอัตโนมัติและรวดเร็วไปยังส่วนประกอบที่ซ้ำซ้อน และความล้มเหลวของปุ่มกดและการย้อนกลับสำหรับการบำรุงรักษาตามแผน

——————————————————————————————————————————

ความยืดหยุ่นด้านไอทีและความพร้อมใช้งานสูง – ไม่ใช่ตัวอย่าง!

เมื่อเดือนสิงหาคมที่ผ่านมา ศูนย์ข้อมูลของ Nissan Group ในเดนเวอร์ ขัดข้องเนื่องจากไฟฟ้าดับ ระบบที่ได้รับผลกระทบเป็นที่รู้จักภายในว่า NNANet เป็นโซลูชันของ Nissan ที่พนักงานใช้ในการสั่งซื้อรถยนต์/ชิ้นส่วน จัดการการขายส่วนลดผลิตภัณฑ์ รับข้อมูลเกี่ยวกับการเรียกคืนรถยนต์ ยื่นคำร้องการรับประกันที่จำเป็นในการตั้งราคาและเริ่มงานบริการ และรับข้อมูลทางการเงินNNANet ถูกอธิบายว่าเป็นเส้นเลือดสำคัญของ Nissan เพราะทุกสิ่งที่ Nissan ทำจะต้องผ่าน NNANet

ระบบยังคงหยุดทำงานเป็นเวลาสี่วัน ส่งผลกระทบต่อการดำเนินงานของผู้ค้าปลีกหลายราย และระบบการผลิตในโรงงานสองแห่ง บริษัท ผู้ค้าปลีก และลูกค้าได้รับผลกระทบทั้งหมด

ผลกระทบ

เห็นได้ชัดว่านี่คือตัวอย่างที่ระบบที่มีความพร้อมใช้งานสูงที่กำหนดค่าอย่างถูกต้องและตั้งอยู่ในตำแหน่งที่เหมาะสมจะช่วยประหยัดเวลาได้หรืออย่างน้อยก็ลดผลกระทบของการขัดข้องให้เหลือน้อยที่สุด สถานการณ์ความพร้อมใช้งานสูงกลับกลายเป็นหายนะอย่างแท้จริงสำหรับนิสสันในฐานะ "การค้าระหว่างผู้บริโภค ผู้ค้าปลีก เครือข่ายการจัดจำหน่าย โรงงานผลิต และบริษัทการเงิน" ได้รับผลกระทบทั้งหมดเป็นเวลาสี่วัน[1]Nissan รีเซ็ตเป้าหมายยอดขายของตัวแทนจำหน่าย 10 เปอร์เซ็นต์สำหรับเดือนนั้นอันเป็นผลมาจากเหตุขัดข้อง ผลกระทบทางการเงินโดยรวมสำหรับนิสสันและตัวแทนจำหน่าย/ผู้ค้าปลีก/พันธมิตรยังคงต้องติดตามกันต่อไป

ความยืดหยุ่นด้านไอที– ตัวอย่างในโลกแห่งความจริง!

Cayan™ เป็นผู้ให้บริการเทคโนโลยีการชำระเงินชั้นนำและ Genius Customer Engagement Platform® ได้รวบรวมและผสานรวมเทคโนโลยีการทำธุรกรรมที่เป็นไปได้ ประเภทการชำระเงิน และโปรแกรมลูกค้าทั้งหมด ทั้งในปัจจุบันและอนาคตไว้ในแพลตฟอร์มเดียว แพลตฟอร์ม Genius รวมถึงแอปพลิเคชันที่สำคัญต่อภารกิจอื่นๆ ที่ Cayan ทำงานบน SQL Server

ลูกค้าของ Cayan รวมถึงผู้ค้าปลีกออนไลน์รายใหญ่ที่สุดของโลกบางราย บริษัทต่างๆ ที่ไม่ยอมรับการหยุดทำงาน “ความสำคัญสูงสุดของเราคือสร้างความมั่นใจว่าลูกค้าของเราสามารถทำธุรกรรมได้อย่างต่อเนื่องตลอด 24 ชั่วโมง เจ็ดวันต่อสัปดาห์” Paul Vienneau ประธานเจ้าหน้าที่ฝ่ายเทคโนโลยีของ Cayan กล่าว

Cayan ต้องการความพร้อมใช้งานสูงและ การกู้คืนระบบ ระบบสำหรับฐานข้อมูล SQL Server บริษัทพิจารณาคลัสเตอร์การจัดเก็บข้อมูลที่ใช้ร่วมกันแบบดั้งเดิม แต่โซลูชัน SAN มีราคาแพง ซับซ้อนในการจัดการ และนำเสนอความเสี่ยงที่เกี่ยวข้องกับจุดล้มเหลวเพียงจุดเดียว

ด้วยเหตุผลเหล่านี้ พนักงาน Cayan IT จึงตัดสินใจใช้คลัสเตอร์ SIOS #SANLess คลัสเตอร์ SANLess ใช้ที่จัดเก็บในตัวเครื่องจึงมีค่าใช้จ่ายด้านประสิทธิภาพน้อยที่สุดและเวลาตอบสนองของแอปพลิเคชันที่รวดเร็ว ซอฟต์แวร์ SIOS SIOS DataKeeper ถูกรวมเข้ากับ Windows Server Failover Clustering (WSFC) SIOS ใช้ประสิทธิภาพแบบเรียลไทม์ การจำลองข้อมูล เพื่อซิงโครไนซ์ที่เก็บข้อมูลในเครื่องในโหนดคลัสเตอร์หลักและระยะไกล ทำให้ปรากฏต่อ WSFC เป็น SAN เสมือน

ผลกระทบ

ตั้งแต่ปรับใช้คลัสเตอร์ SIOS SANless Cayan ไม่เคยประสบปัญหาการหยุดทำงานหรือข้อมูลสูญหาย ความคิดเห็นของ Paul Vienneau, CTO, “เรายินดีเป็นอย่างยิ่งกับซอฟต์แวร์ SIOS DataKeeper เป็นไปตามหรือเกินความคาดหมายของเรา การใช้งานและการดูแลระบบอย่างต่อเนื่องเป็นเรื่องง่าย และเราไม่มีเวลาหยุดทำงานตั้งแต่เริ่มใช้งานคลัสเตอร์ SIOS SANLess” ไม่มีปัญหาความพึงพอใจของลูกค้าที่ต้องรายงาน ไม่มีการสูญเสียรายได้ ไม่มีพนักงานที่ไม่มีประสิทธิภาพ ไม่มีการหยุดชะงักของธุรกิจ

———————————————————————————

SIOS: บรรลุความยืดหยุ่นด้านไอทีด้วยความพร้อมใช้งานสูง

SIOS DataKeeper™ ใช้การจำลองระดับบล็อกอย่างมีประสิทธิภาพเพื่อให้การจัดเก็บข้อมูลในเครื่องซิงโครไนซ์ ทำให้โหนดรองในคลัสเตอร์ของคุณทำงานต่อไปได้หลังจากเกิดข้อผิดพลาดด้วยการเข้าถึงข้อมูลล่าสุด

ผลิตภัณฑ์ SIOS ปกป้องแอปพลิเคชันที่ใช้ Windows หรือ Linux ที่ทำงานในสภาพแวดล้อมทางกายภาพ เสมือน คลาวด์หรือไฮบริด และในสถานการณ์การกู้คืนไซต์หรือเมื่อเกิดภัยพิบัติร่วมกัน ทำให้มีความพร้อมใช้งานสูงและการกู้คืนจากความเสียหายสำหรับแอปพลิเคชัน เช่น SAP S/4HANA และฐานข้อมูล รวมถึง Oracle, SQL Server, DB2 และอื่นๆ อีกมากมาย ความเรียบง่าย "ที่พร้อมใช้งานทันที" ความยืดหยุ่นในการกำหนดค่า ความน่าเชื่อถือ ประสิทธิภาพ และความคุ้มค่าของผลิตภัณฑ์ SIOS ทำให้พวกเขาแตกต่างจากซอฟต์แวร์การทำคลัสเตอร์อื่นๆ

ในสภาพแวดล้อม Windows SIOS DataKeeper Cluster Edition จะผสานรวมกับและขยาย Windows Server Failover Clustering (WSFC) ได้อย่างราบรื่นด้วยกลไกการจำลองข้อมูลตามโฮสต์ที่เพิ่มประสิทธิภาพการทำงาน ในขณะที่ WSFC จัดการคลัสเตอร์ซอฟต์แวร์ SIOS จะดำเนินการจำลองแบบเพื่อเปิดใช้งานการป้องกันจากภัยพิบัติและรับรองว่าข้อมูลจะสูญหายเป็นศูนย์ในกรณีที่คลัสเตอร์การจัดเก็บข้อมูลที่ใช้ร่วมกันเป็นไปไม่ได้หรือทำไม่ได้ เช่น ในสภาพแวดล้อมการจัดเก็บข้อมูลบนคลาวด์ เสมือน และประสิทธิภาพสูง

ในสภาพแวดล้อม Linux SIOS LifeKeeper™ และ SIOS DataKeeper สำหรับ Linux ให้การผสมผสานที่มีความพร้อมใช้งานสูง การจัดคลัสเตอร์ล้มเหลว การตรวจสอบแอปพลิเคชันอย่างต่อเนื่อง การจำลองข้อมูล และนโยบายการกู้คืนที่กำหนดค่าได้ ปกป้องแอปพลิเคชันที่มีความสำคัญต่อธุรกิจของคุณจากการหยุดทำงานและภัยพิบัติ

ไม่ว่าคุณจะอยู่ในสภาพแวดล้อม Windows หรือ Linux ผลิตภัณฑ์ SIOS จะปลดปล่อยทีมไอทีของคุณจากความซับซ้อนและความท้าทายในการสร้างและจัดการโครงสร้างพื้นฐานด้านการประมวลผลที่มีความพร้อมใช้งานสูง พวกเขาให้ข่าวกรอง ระบบอัตโนมัติ ความยืดหยุ่น ความพร้อมใช้งานสูง และความสะดวกในการใช้งานผู้จัดการฝ่ายไอทีที่จำเป็นในการปกป้องแอปพลิเคชันที่มีความสำคัญต่อธุรกิจจากการหยุดทำงานหรือการสูญเสียข้อมูล

SIOS = ความยืดหยุ่นด้านไอทีด้วย HA + DR

การสำรองข้อมูล ความพร้อมใช้งานสูง การกู้คืนจากภัยพิบัติ และความยืดหยุ่นทางไซเบอร์ล้วนเป็นองค์ประกอบสำคัญในการบรรลุความยืดหยุ่นด้านไอที ด้วยโซลูชัน SIOS คุณสามารถ "ทำเครื่องหมายในช่อง" สำหรับทั้งความพร้อมใช้งานสูงและการกู้คืนจากความเสียหาย – สองโซลูชันในหนึ่งเดียว ด้วยความสามารถในการจำลองแบบไปยังหลายเป้าหมาย คุณสามารถกำหนดค่าคลัสเตอร์เฟลโอเวอร์แบบหลายโหนดที่มีโหนดอยู่ในหลายตำแหน่งเพื่อปกป้องระบบของคุณจากความล้มเหลวและภัยพิบัติ

สำหรับข้อมูลเพิ่มเติมและเพื่อให้แน่ใจว่า ความยืดหยุ่นด้านไอที สำหรับองค์กรของคุณ รับการสาธิตฟรี ของ SIOS วันนี้

ข้อมูลอ้างอิง:

  • https://www.continuitycentral.com/index.php/news/technology/1636-improving-your-it-resilience-and-disaster-recovery-capability
  • https://canada.autonews.com/retail/lessons-learned-computer-glitch-crashed-nissan
  • [1]https://canada.autonews.com/retail/lessons-learned-computer-glitch-crashed-nissan

ทำซ้ำโดยได้รับอนุญาตจาก SIOS
 

Filed Under: ทำให้เข้าใจง่ายเซิร์ฟเวอร์คลัสเตอร์ Tagged With: ความยืดหยุ่นด้านไอที

วิธีบรรลุความพร้อมใช้งานสูงด้วยคลัสเตอร์
ธันวาคม 3, 2021 by Jason Aw Leave a Comment

วิธีบรรลุความพร้อมใช้งานสูงด้วยคลัสเตอร์วิธีบรรลุความพร้อมใช้งานสูงด้วยคลัสเตอร์
 

วิธีบรรลุความพร้อมใช้งานสูงด้วยคลัสเตอร์
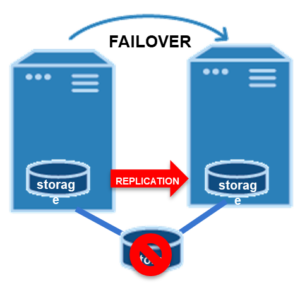
ความพร้อมใช้งานสูงคืออะไร?

ความพร้อมใช้งานสูง (HA) เป็นส่วนประกอบของระบบเทคโนโลยีที่ขจัดจุดบกพร่องเพียงจุดเดียวเพื่อให้แน่ใจว่ามีการทำงานอย่างต่อเนื่องหรือเวลาทำงานต่อเนื่องเป็นระยะเวลานาน ความพร้อมใช้งานสูง กลุ่ม คือกลุ่มของเซิร์ฟเวอร์ที่รองรับแอปพลิเคชันที่มีความสำคัญต่อธุรกิจซึ่งต้องการการหยุดทำงานน้อยที่สุดและความพร้อมใช้งานอย่างต่อเนื่อง

ทุกองค์กรใช้ฐานข้อมูลและแอปพลิเคชันที่มีความสำคัญต่อธุรกิจที่หลากหลาย เช่น คลังข้อมูล แอปพลิเคชันอีคอมเมิร์ซ ระบบการจัดการลูกค้าสัมพันธ์ (CRM) ระบบการเงิน การจัดการห่วงโซ่อุปทาน และระบบข่าวกรองธุรกิจ เมื่อระบบ ฐานข้อมูล หรือแอปพลิเคชันล้มเหลว องค์กรเหล่านี้ต้องการการป้องกันความพร้อมใช้งานสูงเพื่อให้ระบบทำงานและทำงานต่อไป และลดความเสี่ยงของการสูญเสียรายได้ พนักงานที่ไม่มีประสิทธิภาพ และลูกค้าที่ไม่พึงพอใจ

คลัสเตอร์ที่มีความพร้อมใช้งานสูงประกอบด้วยหลักการออกแบบห้าประการ:

  • พวกเขาจะล้มเหลวโดยอัตโนมัติไปยังระบบที่ซ้ำซ้อนเพื่อรับการดำเนินการเมื่อส่วนประกอบที่ใช้งานอยู่ล้มเหลว สิ่งนี้จะกำจัดจุดล้มเหลวเพียงจุดเดียว
  • พวกเขาสามารถตรวจจับความล้มเหลวระดับแอปพลิเคชันโดยอัตโนมัติเมื่อเกิดขึ้น โดยไม่คำนึงถึงสาเหตุ
  • ทำให้มั่นใจได้ว่าข้อมูลจะไม่สูญหายระหว่างที่ระบบล้มเหลว
  • โดยจะเฟลโอเวอร์ไปยังส่วนประกอบที่ซ้ำซ้อนโดยอัตโนมัติและรวดเร็วเพื่อลดเวลาหยุดทำงาน
  • พวกเขาให้ความสามารถในการเฟลโอเวอร์ด้วยตนเองและย้อนกลับเพื่อลดเวลาหยุดทำงานระหว่างการบำรุงรักษาที่วางแผนไว้

TechTarget ให้คำจำกัดความ HA ว่าเป็น "ระบบหรือส่วนประกอบที่ทำงานอย่างต่อเนื่องเป็นระยะเวลานานเป็นที่น่าพอใจ ความพร้อมใช้งานสามารถวัดได้เมื่อเทียบกับ 'ใช้งานได้ 100%' หรือ 'ไม่เคยล้มเหลว' มาตรฐานความพร้อมใช้ของระบบหรือผลิตภัณฑ์ซึ่งมีอยู่อย่างกว้างขวางแต่ทำได้ยาก เรียกว่าความพร้อมใช้งาน 'five 9s' (99.999%)” แต่ให้นิยามความพร้อมใช้งานสูงโดยง่าย:

ความพร้อมใช้งานสูงช่วยให้มั่นใจว่าระบบ ฐานข้อมูล และแอปพลิเคชันของคุณทำงานเมื่อจำเป็นและตามความจำเป็น

"เมื่อ" คำนึงถึงเปอร์เซ็นต์ของเวลาที่แอปพลิเคชันต้องเปิดใช้งาน “ตามความจำเป็น” จะพิจารณาถึงการทำงานที่เหมาะสมของระบบ ฐานข้อมูล และ/หรือแอปพลิเคชันโดยไม่สูญเสียข้อมูล

ความพร้อมใช้งานสูงจะแตกต่างกันขึ้นอยู่กับระบบและ/หรือแอปพลิเคชัน ตัวอย่างเช่น ด้วยแอปพลิเคชันที่มีความสำคัญต่อภารกิจ เช่น ระบบอีคอมเมิร์ซของคุณ ความพร้อมใช้งาน 9 วินาที (99.99%) สี่รายการถือเป็นมาตรฐานอุตสาหกรรม ด้วยความพร้อมใช้งาน 99.99% คุณสามารถคาดหวังเวลาหยุดทำงานไม่เกิน 52.60 นาทีต่อปี หรือ 8.64 วินาทีของการหยุดทำงานต่อวัน อย่างไรก็ตาม สำหรับแอปพลิเคชันและระบบที่ไม่สำคัญ เช่น ความล้มเหลวของเดสก์ท็อปเครื่องเดียว ความพร้อมใช้งานสูงอาจเป็น 9 วินาที (99%) สองรายการ ซึ่งเท่ากับเวลาหยุดทำงาน 8.77 ชั่วโมงต่อปี หรือ 1.44 นาทีของการหยุดทำงานต่อวัน เมื่อวัดเวลาหยุดทำงานที่ยอมรับได้ สิ่งสำคัญคือคุณต้องพิจารณา:

  • เวลาหยุดทำงานโดยไม่ได้วางแผนไว้ (เช่น ความล้มเหลวของฮาร์ดแวร์หรือซอฟต์แวร์)
  • เวลาหยุดทำงานที่วางแผนไว้ซึ่งจำเป็นสำหรับการบำรุงรักษาฮาร์ดแวร์และซอฟต์แวร์เป็นประจำ
  • เวลาทำงานที่ระดับฐานข้อมูลและแอปพลิเคชัน

ทางเลือกของคุณสำหรับความพร้อมใช้งานสูงนั้นขึ้นอยู่กับหลายปัจจัย รวมถึงความสำคัญของแอปพลิเคชันต่อธุรกิจ ไม่ว่าลูกค้าจะได้รับผลกระทบ ความถี่ที่แอปพลิเคชันทำงาน จำนวนผู้ใช้ที่ได้รับผลกระทบ ฐานข้อมูลหรือแอปพลิเคชันต้องเปลี่ยนระบบที่ซ้ำซ้อนได้เร็วเพียงใด และข้อมูลสูญหายได้มากน้อยเพียงใด

ตัวชี้วัดความพร้อมใช้งานสูง: RTO และ RPO

ตัววัดสองตัวที่ปกติใช้ในการประเมิน HA (และ Disaster Recovery (DR) เช่นกัน) คือ Recovery Time Objective (RTO) และ Recovery Point Objective (RPO)

  • RTO คือระยะเวลาสูงสุดที่ยอมรับได้ของการหยุดทำงานใดๆ โดยทั่วไป แอปพลิเคชันประมวลผลธุรกรรมออนไลน์จะมี RTO ต่ำที่สุด และแอปพลิเคชันที่มีความสำคัญต่อภารกิจมักมี RTO เพียงไม่กี่วินาที
  • RPO คือจำนวนสูงสุดของการสูญเสียข้อมูลที่สามารถยอมรับได้เมื่อเกิดความล้มเหลวขึ้น สำหรับ HA RPO มักจะเป็นศูนย์เพื่อระบุว่าควรมีข้อมูลสูญหายเป็นศูนย์ภายใต้สถานการณ์ความล้มเหลวทั้งหมด

อย่างไรก็ตาม มีความแตกต่างระหว่างสิ่งที่ RTO และ RPO ที่คุณสามารถทำได้เพื่อรองรับความพร้อมใช้งานสูงเมื่อเทียบกับ การกู้คืนระบบ . ด้วย HA การจำลองข้อมูล สามารถซิงโครนัสได้เนื่องจากส่วนประกอบที่ซ้ำซ้อนของคุณอยู่ในสภาพแวดล้อม LAN ของคุณ ฐานข้อมูลแบบแอ็คทีฟและสแตนด์บายสามารถอัปเดตพร้อมกันได้ ทำให้สามารถกู้คืนข้อมูลแบบเรียลไทม์เต็มรูปแบบโดยอัตโนมัติ ซึ่งสามารถตอบสนอง RTO และ RPO ที่มีความต้องการสูงสุดได้ เป็นผลให้อินสแตนซ์สแตนด์บายของคุณ "ร้อน" และซิงค์กับอินสแตนซ์ที่ใช้งานอยู่ของคุณ ดังนั้นจึงพร้อมที่จะเข้าควบคุมทันทีในกรณีที่เกิดความล้มเหลว

อย่างไรก็ตาม ในการกู้คืนระบบ ซอฟต์แวร์ และข้อมูลในกรณีที่เกิดภัยพิบัติ จำเป็นต้องมีส่วนประกอบที่ซ้ำซ้อนบนเครือข่ายบริเวณกว้าง (WAN) นี่เป็นสิ่งสำคัญเนื่องจากคุณต้องเก็บส่วนประกอบที่ซ้ำซ้อนในตำแหน่งทางภูมิศาสตร์ให้ห่างจากอินสแตนซ์ที่ใช้งานอยู่ แต่ด้วย WAN การจำลองข้อมูลจะไม่พร้อมกันเพื่อหลีกเลี่ยงการส่งผลเสียต่อประสิทธิภาพการรับส่งข้อมูล ซึ่งหมายความว่าการอัปเดตอินสแตนซ์สแตนด์บายจะทำให้การอัปเดตที่ทำกับอินสแตนซ์ที่ใช้งานอยู่ล่าช้า ส่งผลให้เกิดความล่าช้าในระหว่างกระบวนการกู้คืน เนื่องจากภัยพิบัติเกิดขึ้นได้ยาก ความล่าช้าบางอย่างจึงอาจพอทนได้และขึ้นอยู่กับ (ก) ความสำคัญของธุรกิจของคุณในการบรรลุ RTO และ RPO ที่ต่ำที่สุดเท่าที่จะเป็นไปได้ และ (b) งบประมาณที่คุณสามารถจัดสรรเพื่อให้ได้ RTO และ RPO ที่ดีที่สุด

SIOS ช่วยให้คุณบรรลุความพร้อมใช้งานสูงได้อย่างไร

SIOS นำเสนอโซลูชันเดียวที่ตอบสนองทั้งความต้องการความพร้อมใช้งานสูงและการกู้คืนจากความเสียหายในระบบปฏิบัติการ สภาพแวดล้อมโครงสร้างพื้นฐาน และแอปพลิเคชันที่หลากหลาย รวมถึง SAP, SQL Server, Oracle และสภาพแวดล้อมอื่นๆ ที่ทำงานในการกำหนดค่าพื้นที่เก็บข้อมูลที่ใช้ร่วมกันบน SAN หรือ SANless , การกำหนดค่าการจัดเก็บข้อมูลในเครื่อง

  • สภาพแวดล้อมของ Windows : เมื่อเพิ่มในสภาพแวดล้อม Windows Server Failover Cluster (WSFC) แล้ว SIOS DataKeeper จะช่วยให้คุณสร้างคลัสเตอร์ SANless โดยที่คลัสเตอร์การจัดเก็บข้อมูลที่ใช้ร่วมกันเป็นไปไม่ได้หรือทำไม่ได้ หรือเพิ่มการจำลองแบบสำหรับการป้องกันภัยพิบัติในคลัสเตอร์ Windows ที่ใช้ SAN ของคุณ การจำลองแบบอิงโฮสต์ที่รวดเร็วและมีประสิทธิภาพจะซิงโครไนซ์ที่เก็บข้อมูลในเครื่องบนโหนดคลัสเตอร์ในเครื่องและโหนดระยะไกล สร้างคลัสเตอร์ SANLess ในสภาพแวดล้อมทางกายภาพ เสมือน หรือคลาวด์
  • สภาพแวดล้อม Linux : SIOS Protection Suite สำหรับ Linux เป็นแพ็คเกจ ซอฟต์แวร์จัดกลุ่ม โซลูชันที่ใช้ SIOS LifeKeeper และ SIOS DataKeeper เพื่อให้มีการรวมคลัสเตอร์ล้มเหลวที่มีความพร้อมใช้งานสูง การตรวจสอบแอปพลิเคชันอย่างต่อเนื่อง การจำลองข้อมูล และนโยบายการกู้คืนที่กำหนดค่าได้ เพื่อปกป้องแอปพลิเคชันและข้อมูลที่สำคัญต่อธุรกิจของคุณจากการหยุดทำงานและภัยพิบัติ SIOS Protection Suite ให้คุณสร้างคลัสเตอร์ SAN หรือ SANLess โดยใช้อุปกรณ์จัดเก็บข้อมูลที่หลากหลาย รวมถึงที่เก็บข้อมูลที่ต่อโดยตรง, iSCSI และ Fibre Channel SIOS Protection Suite สำหรับ Linux รองรับลีนุกซ์รุ่นหลักๆ ทั้งหมด รวมถึง Red Hat Enterprise Linux, SUSE Linux Enterprise Server, CentOS และ Oracle Linux

ด้วยโซลูชัน SIOS RPO จะเป็นศูนย์เสมอ และ RTO จะขึ้นอยู่กับแอปพลิเคชัน แต่โดยทั่วไปแล้ว 30 วินาทีถึงไม่กี่นาทีสำหรับบางแอปพลิเคชัน มาพูดคุยกันเกี่ยวกับกรณีศึกษา “SIOS ที่ใช้งานได้จริง” ของลูกค้ารายหนึ่งโดยใช้คลัสเตอร์ HA ที่บริษัทค้าปลีกที่ใหญ่ที่สุดของสวิตเซอร์แลนด์


Migros บรรลุความต่อเนื่องทางธุรกิจที่สำคัญของระบบ POS ด้วย SIOS High Availability Solutions

Migros เป็นบริษัทค้าปลีกรายใหญ่ที่สุดของสวิตเซอร์แลนด์ มีเครือข่ายซูเปอร์มาร์เก็ตที่ใหญ่ที่สุด และเป็นนายจ้างรายใหญ่ที่สุดที่มีพนักงานมากกว่า 100,000 คน นอกจากนี้ยังเป็นหนึ่งในร้านค้าปลีกที่ใหญ่ที่สุดในโลกสี่สิบแห่ง ด้วยการร่วมมือกับ Realstuff Informatik AG ผู้ให้บริการด้านไอทีในสวิตเซอร์แลนด์และผู้ค้าปลีกโซลูชัน SIOS นั้น Migros กำลังมองหาการแทนที่ระบบ ณ จุดขาย (POS) ด้วยแพลตฟอร์มใหม่ที่มีประสิทธิภาพมากขึ้นในการดำเนินงานและสามารถลดภัยคุกคามจากการหยุดทำงาน

ระบบ POS ใหม่ให้ข้อมูลราคาและการแบ่งประเภทผลิตภัณฑ์ในร้านค้า 650 แห่งของ Migros และผู้ค้าปลีกต้องการโซลูชันที่มีความพร้อมใช้งานสูงเพื่อรองรับการขายในแต่ละวัน หากไม่มีระบบ HA พนักงานจะไม่สามารถกำหนดราคาสินค้าหรือชั่งน้ำหนักสินค้าได้หากระบบขัดข้อง ส่งผลให้การปฏิบัติงานหยุดชะงัก หลังจากประเมินตัวเลือกต่างๆ Migros ตัดสินใจว่าต้องการสภาพแวดล้อมเซิร์ฟเวอร์โอเพ่นซอร์สที่ให้ความพร้อมใช้งานสูงและการปกป้องข้อมูลอย่างต่อเนื่อง เป็นอิสระจากสภาพแวดล้อมเสมือนจริง และสามารถดำเนินการภายในโดยเจ้าหน้าที่ไอทีของบริษัท เพื่อแก้ไขข้อกำหนดเหล่านี้ ทีมงานได้เลือก SIOS Protection Suite สำหรับ Linux สำหรับการจำลองแบบเพื่อปกป้องข้อมูล POS

สำหรับการออกแบบระบบ การฝึกอบรมลูกค้า และการสนับสนุนภาษาแม่ Realstuff ได้ร่วมมือกับ SIOS Competence and Support Center สำหรับยุโรปกลางและยุโรปตะวันออก ซึ่งตั้งอยู่ในเมืองเดรสเดน ประเทศเยอรมนี และดำเนินการโดย Computer Concept เป็นสิ่งสำคัญที่ Migros จะได้รับการสนับสนุนตลอด 24x7x365 ในช่วงเวลาสำนักงานภูมิภาคจากศูนย์ความสามารถและการสนับสนุน

Realstuff ใช้โซลูชันความพร้อมใช้งานสูงของ SIOS Protection Suite เพื่อตรวจสอบเซิร์ฟเวอร์ POS และทำซ้ำข้อมูลอย่างต่อเนื่อง ที่ที่ตั้งร้านค้าแต่ละแห่ง เซิร์ฟเวอร์สองแห่งถูกใช้เพื่อให้แน่ใจว่ามีการปกป้องข้อมูลอย่างต่อเนื่อง หากเซิร์ฟเวอร์หนึ่งล้มเหลว อินสแตนซ์ที่สองจะเข้ามาแทนที่งานในทันที นอกจากนี้ เซิร์ฟเวอร์ทั้งสองมิเรอร์สินทรัพย์ข้อมูลบนระบบการมอนิเตอร์อ่านกรณีศึกษาของ Migros ฉบับเต็มได้ที่นี่

ความคิดสุดท้าย

ศูนย์ความสามารถและการสนับสนุนระดับภูมิภาคได้ปรึกษากับ Realstuff เพื่อให้ข้อมูลเชิงลึกและทิศทางในการดำเนินการและเปิดตัว และดำเนินการฝึกอบรมเชิงปฏิบัติการเป็นเวลาสามวันเพื่อฝึกอบรมทีม Migros Richard Huber ผู้จัดการและสมาชิกคณะกรรมการบริหารของ Realstuff แสดงความคิดเห็นหลังการปรับใช้งานว่าประโยชน์ของโซลูชันความพร้อมใช้งานสูงของ SIOS คือความยืดหยุ่น ความน่าเชื่อถือ ความสะดวกในการใช้งาน และการรับประกันว่าข้อมูลจะได้รับการซิงค์ตลอดเวลา

วันนี้ Migros ได้ปฏิบัติตามข้อกำหนดสำหรับ HA ด้วยโซลูชันที่ใช้งานง่าย SIOS ซึ่งให้การตรวจสอบเซิร์ฟเวอร์ ที่เก็บข้อมูล แอปพลิเคชัน ฐานข้อมูล และการเชื่อมต่อเครือข่ายอย่างต่อเนื่อง เพื่อตรวจหาจุดล้มเหลว ลดการหยุดทำงาน รักษาการเชื่อมต่อไคลเอ็นต์ และให้บริการอย่างต่อเนื่อง การเข้าถึงข้อมูล


สำหรับข้อมูลเพิ่มเติมเกี่ยวกับโซลูชัน SIOS และวิธีที่ SIOS สามารถช่วยให้คุณบรรลุ HA ในสภาพแวดล้อม SQL Server คุณสามารถอ่าน “ทำไมต้องทำคลัสเตอร์สำหรับความพร้อมใช้งานสูงของเซิร์ฟเวอร์ SQL” ที่นี่


สืบพันธุ์จาก SIOS

Filed Under: ทำให้เข้าใจง่ายเซิร์ฟเวอร์คลัสเตอร์

สี่เหตุผลในการใช้กลยุทธ์การหลีกเลี่ยงในความพร้อมใช้งานสูง

พฤศจิกายน 28, 2021 by Jason Aw Leave a Comment

สี่เหตุผลในการใช้กลยุทธ์การหลีกเลี่ยงในความพร้อมใช้งานสูง

สี่กลยุทธ์การหลีกเลี่ยงเพื่อปรับปรุงความยืดหยุ่น ประสิทธิภาพ และผลลัพธ์ของคลัสเตอร์

ขั้นตอนง่าย ๆ สำหรับการปรับใช้ในสภาพแวดล้อมคลัสเตอร์ SIOS Protection Suite


หลีกเลี่ยงบางสิ่งบางอย่าง – เราทุกคนเคยทำมาก่อนเปลวไฟเก่าที่เราเห็นในร้านขณะเดินไปกับคู่สมรส พนักงานขายเมื่อเรา “ไม่พร้อมที่จะซื้อ” และแม้แต่เจ้านายในขณะที่เราไปเที่ยว “วันหยุด”ตอนที่ฉันเป็นผู้จัดการทีมพัฒนา ฉันได้เห็นรายงานตรงที่เรียกดูในร้านค้าขณะที่พวกเขาควรจะป่วยอยู่นอกสำนักงานพวกเขาหลบอยู่ระหว่างชั้นวางเสื้อผ้าและรีบวิ่งไปตามทางเดินถัดไปและรีบออกไปเราทุกคนเคยทำมาแล้ว และในบางกรณี สำหรับสุขภาพจิต สุขภาพกาย หรือเหตุผลที่ยังคงเป็นเรื่องส่วนตัวและเป็นส่วนตัว เราทุกคนจำเป็นต้องมีมาตรการหลีกเลี่ยงบางอย่างแม้แต่ใน HAดังนั้นคุณจะเพิ่มการหลีกเลี่ยงให้กับ .ได้อย่างไร ความพร้อมใช้งานสูง สิ่งแวดล้อม และทำไม?

สี่เหตุผลในการใช้กลยุทธ์การหลีกเลี่ยงในความพร้อมใช้งานสูง

  • ประสิทธิภาพที่ดีขึ้น (ลดการโอเวอร์โหลดของเซิร์ฟเวอร์)

เหตุผลหนึ่งที่ใช้กลยุทธ์การหลีกเลี่ยงใน HA คือการเพิ่มประสิทธิภาพแอปพลิเคชันและเซิร์ฟเวอร์พิจารณากรณีของเซิร์ฟเวอร์สามเครื่องที่ใช้งานปริมาณงานจริง ให้เรียกว่าเซิร์ฟเวอร์อัลฟ่า เซิร์ฟเวอร์เบต้า เซิร์ฟเวอร์แกมมาเซิร์ฟเวอร์อัลฟ่าและเบต้ากำลังเรียกใช้แอปพลิเคชันที่สำคัญซึ่งได้รับการสนับสนุนจากฐานข้อมูล ในขณะที่เซิร์ฟเวอร์แกมมากำลังเรียกใช้รายงานและงานการแปลงข้อมูลในกรณีที่เซิร์ฟเวอร์อัลฟ่าล้มเหลว การเฟลโอเวอร์ไปยังเซิร์ฟเวอร์เบต้าจะเกิดขึ้นตามปกติอย่างไรก็ตาม เนื่องจากเซิร์ฟเวอร์เบต้าใช้งานเวิร์กโหลดจำนวนมากอยู่แล้ว การโหลดแอปพลิเคชันเพิ่มเติมที่เป็นผลลัพธ์อาจส่งผลให้เซิร์ฟเวอร์โอเวอร์โหลดที่ไม่พึงประสงค์และประสิทธิภาพต่ำสำหรับทั้งสองแอปพลิเคชันดังนั้นจึงควรปรับใช้กลยุทธ์การหลีกเลี่ยงเพื่อให้แน่ใจว่า Server Gamma ถูกเลือกเป็นเป้าหมายเฟลโอเวอร์

  • การเพิ่มประสิทธิภาพการทำงาน

พิจารณาสถานการณ์สมมติของเซิร์ฟเวอร์สามตัวอีกครั้ง ได้แก่ อัลฟ่า เบต้า และแกมมาเซิร์ฟเวอร์อัลฟ่าและเบต้าได้รับการปรับขนาดเพื่อรองรับปริมาณงานสูงสุด ในขณะที่ Server Gamma เป็นเซิร์ฟเวอร์ที่ปรับต้นทุนให้เหมาะสมในกรณีที่เซิร์ฟเวอร์อัลฟ่าและเซิร์ฟเวอร์เบต้าล้มเหลว จะเกิดการเฟลโอเวอร์กับเซิร์ฟเวอร์ที่ปรับต้นทุนให้เหมาะสม Gammaอย่างไรก็ตาม เซิร์ฟเวอร์นี้ไม่ได้ปรับขนาดเพื่อรองรับปริมาณงานสูงสุด หรือปริมาณงานของทั้งเซิร์ฟเวอร์อัลฟ่าและเซิร์ฟเวอร์เบต้าในเวลาเดียวกันในกรณีนี้ สามารถใช้กลยุทธ์การหลีกเลี่ยงเพื่อเพิ่มประสิทธิภาพโดยการย้ายหนึ่งหรือทั้งสองปริมาณงานโดยอัตโนมัติจาก Server Gamma ทันทีที่โฮสต์อื่นพร้อมใช้งาน

  • การเพิ่มประสิทธิภาพ HA

HA Optimization เป็นอีกสถานการณ์หนึ่งสำหรับการปรับใช้กลยุทธ์การหลีกเลี่ยง เช่นเดียวกับกลยุทธ์การเพิ่มประสิทธิภาพการทำงาน การเพิ่มประสิทธิภาพ HA ถูกใช้เพื่อให้แน่ใจว่าสภาพแวดล้อมของคุณสามารถอยู่รอดได้ในสถานการณ์ความล้มเหลวส่วนใหญ่ และแอปพลิเคชันของคุณได้รับการปรับให้เหมาะสมเพื่อให้ระดับความพร้อมใช้งานสูงสุด ณ เวลาใดเวลาหนึ่งการเพิ่มประสิทธิภาพ HA เป็นสิ่งสำคัญสำหรับแอปพลิเคชัน เช่น SAP ที่มีกระบวนการเข้าคิวที่จำลองแบบในสภาพแวดล้อม SAP ใดๆ คุณไม่ต้องการให้อินสแตนซ์ ASCS (ABAP SAP Central Service) และ ERS (enqueue replication services) อยู่บนเซิร์ฟเวอร์เดียวกันเป็นเวลานานเนื่องจากความเสี่ยงของการล็อกที่สูญหายและงานที่ถูกยกเลิก เพื่อป้องกันไม่ให้สิ่งนี้เกิดขึ้น คุณสามารถใช้กลยุทธ์การหลีกเลี่ยงที่ทำให้อินสแตนซ์ ERS และ ASCS ทำงานบนโหนดคลัสเตอร์ตรงข้ามเสมอพิจารณากรณีของเซิร์ฟเวอร์สามเครื่องที่ใช้ปริมาณงานจริง เรียกว่าเซิร์ฟเวอร์อัลฟ่า เบต้า แกมมาเซิร์ฟเวอร์อัลฟ่ากำลังเรียกใช้อินสแตนซ์ ASCS ในขณะที่เซิร์ฟเวอร์เบต้ากำลังเรียกใช้อินสแตนซ์ ERSServer Gamma ทำหน้าที่เป็นโหนดที่สามสำหรับการเฟลโอเวอร์ของทั้ง Server Beta (ERS) และ Server Alpha (ASCS)หากเบต้าขัดข้อง คุณจะไม่ต้องการให้ทรัพยากร ERS ทำงานบนโหนดเดียวกันกับอินสแตนซ์ ASCSเพื่อให้แน่ใจว่าการดำเนินการนี้ คุณสามารถปรับใช้กลยุทธ์การหลีกเลี่ยงที่จะตรวจสอบโดยอัตโนมัติก่อน และทำให้แน่ใจว่าทั้งสองแอปพลิเคชันอยู่บนเซิร์ฟเวอร์ที่แยกจากกัน และคงไว้ซึ่งแนวทางปฏิบัติที่ดีที่สุดของ SAP ASCS/ERS สำหรับการล็อกเมื่อเกิดข้อผิดพลาด

  • DR หลีกเลี่ยง

สมมติว่าคุณมีศูนย์ข้อมูลสองแห่ง: City Alpha และ City Beta ซึ่งอยู่ห่างกันประมาณ 70 ไมล์ โดยที่ลูกค้าส่วนใหญ่ของคุณตั้งอยู่ตรงกลางระหว่างพวกเขา อย่างไรก็ตาม เนื่องจากการเปลี่ยนแปลงล่าสุดในองค์กรภายใน การควบรวม/ปิดและการเข้าซื้อกิจการ และข้อกำหนดด้านการกำกับดูแล ทีมไอทีของคุณจะต้องเพิ่มศูนย์ข้อมูลแห่งที่สามที่ตั้งอยู่ใน City Gamma ซึ่งอยู่ห่างจาก Alpha และ Beta ประมาณ 350 ไมล์ตอนนี้ทรัพยากรที่ได้รับการคุ้มครองในอัลฟ่าและเบต้าเป็นหลักก็ขยายไปยังตำแหน่งแกมมาด้วยเนื่องจากผู้ใช้และทีมส่วนใหญ่อยู่ใกล้ตำแหน่งอัลฟ่าและเบต้า และแม้แต่ผู้ใช้ที่รุนแรงที่สุดก็ตั้งอยู่ในเมืองใกล้เคียง ทีมของคุณต้องหลีกเลี่ยงการเฟลโอเวอร์ไปยังตำแหน่งแกมมา เช่นเดียวกับกลยุทธ์อื่นๆ การหลีกเลี่ยง DR พยายามเพิ่มประสิทธิภาพการทำงาน ต้นทุนข้อมูลขาเข้า/ออกในภูมิภาค เวลาแฝง และการเข้าถึงไคลเอ็นต์โดยการหลีกเลี่ยงโหนด DR หากมีเพียงหนึ่งโหนดภายในภูมิภาคใดภูมิภาคหนึ่งที่ล้มเหลวนอกจากนี้ยังช่วยให้แน่ใจว่าแม้ว่าโหนดทั้งสองจะล้มเหลวหลังจากเวลาต่างกัน แต่การเฟลโอเวอร์จะเกิดขึ้นกับโหนดอื่นในคลัสเตอร์หรือศูนย์ข้อมูลเสมอก่อนที่จะย้ายไปยัง DR

คุณจะปรับใช้กลยุทธ์การหลีกเลี่ยงอย่างไร

ผู้ให้บริการหลายรายมีกฎความสัมพันธ์ที่สามารถกำหนดค่าได้ ในขณะที่ผู้ให้บริการรายอื่นๆ ใช้ลำดับความสำคัญของเซิร์ฟเวอร์ร่วมกันหรือขั้นตอนที่ต้องทำด้วยตัวเองในกรณีของ SIOS Protection Suite สำหรับ Linux คุณสามารถใช้วิธีการในตัวได้หลายวิธี ได้แก่:

  • การจัดลำดับความสำคัญของทรัพยากร

ในกรณีที่เกิดความล้มเหลว ทรัพยากรจะล้มเหลวไปยังเซิร์ฟเวอร์ที่มีลำดับความสำคัญที่เหลืออยู่ต่ำสุดและต่อไปยังเซิร์ฟเวอร์เพิ่มเติม (อัลฟ่า เบต้า และแกมมา)Server Alpha เป็นเซิร์ฟเวอร์หลักสำหรับ Resource.HR, Server Beta เป็นเซิร์ฟเวอร์หลักสำหรับ Resource.MFG และ Server Gamma เป็นเซิร์ฟเวอร์สำรองสำหรับทรัพยากร/เซิร์ฟเวอร์ทั้งหมดการใช้การจัดลำดับความสำคัญของทรัพยากร Resource.HR จะมีลำดับความสำคัญหนึ่ง (1) ใน Server Alpha และลำดับความสำคัญสอง (2) บน Server Gammaในขณะที่ Resource.MFG สามารถมีลำดับความสำคัญหนึ่ง (1) บนเซิร์ฟเวอร์เบต้าและลำดับความสำคัญสอง (2) บนเซิร์ฟเวอร์ Gammaหากลูกค้าต้องการปรับการใช้สภาพแวดล้อมให้เหมาะสม Resource.HR สามารถมีลำดับความสำคัญสาม (3) บนเซิร์ฟเวอร์เบต้าและทรัพยากร MFG สามารถมีลำดับความสำคัญสาม (3) บนเซิร์ฟเวอร์อัลฟ่าในกรณีที่เซิร์ฟเวอร์อัลฟ่าล้มเหลว ทรัพยากร Resource.HR จะล้มเหลวในเซิร์ฟเวอร์แกมมาก่อนที่จะพยายามเข้ามาใช้บริการ (ถูกกู้คืน) บนเซิร์ฟเวอร์อัลฟ่า

SIOS Protection Suite สำหรับ Linux (UI และ CLI) อนุญาตให้ผู้ใช้ระบุลำดับความสำคัญสำหรับแต่ละเซิร์ฟเวอร์และการรวมทรัพยากร

  • นโยบายหรือกฎความสัมพันธ์

กฎนโยบายยังสามารถใช้เพื่อป้องกันไม่ให้เกิดการกู้คืนทรัพยากรบนเซิร์ฟเวอร์ที่กำหนด และด้วยเหตุนี้จึงช่วยให้ทรัพยากรสามารถหลีกเลี่ยงเซิร์ฟเวอร์ที่ระบุซึ่งอาจใช้ปริมาณงานที่สำคัญหรือต้องใช้ทรัพยากรมากนโยบายทั่วไป ได้แก่ :

            • นโยบายข้อจำกัดที่จะบล็อกแอปพลิเคชันจากเซิร์ฟเวอร์เฉพาะตามค่าเริ่มต้น
            • นโยบายทรัพยากรที่จะบล็อกแอปพลิเคชันจากเซิร์ฟเวอร์ที่มีทรัพยากรไม่เพียงพอ
            • นโยบายชั่วคราวที่กำหนดช่วงเวลาที่ทรัพยากรได้รับอนุญาตหรือไม่อนุญาตจากระบบ
            • นโยบายที่กำหนดเองซึ่งกำหนดเซิร์ฟเวอร์ที่ต้องการหรือความสามารถในการเป็นเจ้าของแอปพลิเคชันที่เป็นไปได้ภายในคลัสเตอร์

SIOS Protection สำหรับ Linux CLI อนุญาตให้ผู้ใช้ระบุกฎของนโยบายซึ่งสามารถปิดใช้งานการเฟลโอเวอร์ไปยังทรัพยากรเฉพาะสำหรับเซิร์ฟเวอร์ที่ระบุ จัดเตรียมนโยบายชั่วคราวเพื่อป้องกันความล้มเหลว ปิดใช้งานความล้มเหลวของแอปพลิเคชันบางประเภท นโยบายข้อจำกัด และนโยบายที่กำหนดเอง

  • แหล่งข้อมูลการหลีกเลี่ยงเฉพาะ

วิธีที่ละเอียดที่สุดในการสร้างกลยุทธ์การหลีกเลี่ยงทรัพยากรคือการปรับใช้สคริปต์การหลีกเลี่ยงเฉพาะภายในแต่ละลำดับชั้นวิธีนี้จะอนุญาตให้ผู้ใช้กำหนดค่าแอปพลิเคชันเฉพาะ (เช่น app1 และ app2) เพื่อหลีกเลี่ยงกันและกันเมื่อทำได้ในขณะที่อนุญาตให้แอปพลิเคชันอื่นทำงานโดยไม่มีข้อจำกัดในกรณีของเซิร์ฟเวอร์สามตัวของเรา อัลฟ่า เบต้า และแกมมา และทรัพยากรสามอย่าง app1, app2 และ app3 วิธีการนี้จะให้ความยืดหยุ่นสูงสุดในตัวอย่างนี้ app1 และ app2 จะพยายามหลีกเลี่ยงการจัดระเบียบเมื่อเซิร์ฟเวอร์ล้มเหลว แต่ app3 จะล้มเหลวไปยังโหนดถัดไปที่พร้อมใช้งานตามลำดับความสำคัญโดยไม่มีข้อจำกัดการจัดระเบียบใดๆ

สำหรับตัวอย่างเพิ่มเติมของกลยุทธ์การหลีกเลี่ยงและทรัพยากร ให้พิจารณา SIOS Protection Suite สำหรับ Linux เอกสาร .หากลูกค้ามีสองแอปพลิเคชัน ได้แก่ app1 และ app2 ซึ่งพวกเขาต้องการให้ทำงานบนโหนดต่างๆ ทุกครั้งที่ทำได้ ลูกค้าสามารถสร้างทรัพยากรโหนดปลายสุดของเทอร์มินัลการหลีกเลี่ยงได้ 2 รายการโดยใช้ SIOS Protection Suite สำหรับทรัพยากร Linux gen/app และ ‘/opt/LifeKeeper /lkadm/bin/avoid_restore’ สคริปต์

สืบพันธุ์จาก SIOS


Filed Under: ทำให้เข้าใจง่ายเซิร์ฟเวอร์คลัสเตอร์

ข้อมูลเบื้องต้นเกี่ยวกับคลัสเตอร์ – ตอนที่ 2

พฤศจิกายน 23, 2021 by Jason Aw Leave a Comment

ข้อมูลเบื้องต้นเกี่ยวกับคลัสเตอร์ - ตอนที่ 2

ข้อมูลเบื้องต้นเกี่ยวกับคลัสเตอร์ – ตอนที่ 2

มีคลัสเตอร์ประเภทใดบ้างและทำงานอย่างไร

ภาพรวมของ HA Clusters และ Load Balancing Clusters

การทำคลัสเตอร์ช่วยปรับปรุงความน่าเชื่อถือและประสิทธิภาพของระบบซอฟต์แวร์และฮาร์ดแวร์โดยสร้างความซ้ำซ้อนเพื่อชดเชยความล้มเหลวของระบบที่คาดไม่ถึง หากระบบถูกขัดจังหวะเนื่องจากความล้มเหลวของฮาร์ดแวร์หรือซอฟต์แวร์ หรือภัยธรรมชาติ อาจส่งผลกระทบสำคัญต่อธุรกิจและรายได้ ทำให้เสียเวลาและค่าใช้จ่ายที่สำคัญเพื่อสำรองข้อมูลและดำเนินการ

นี่คือที่ การจัดกลุ่ม เข้ามา. โซลูชันการทำคลัสเตอร์มีสามประเภทหลัก – คลัสเตอร์ HA, คลัสเตอร์โหลดบาลานซ์ และคลัสเตอร์ HPC ประเภทใดจะเพิ่มความพร้อมใช้งานและประสิทธิภาพของระบบให้กับธุรกิจของคุณได้ดีที่สุด มาดูโซลูชันการทำคลัสเตอร์สามประเภทในรายละเอียดเพิ่มเติมด้านล่าง

HA Clustering คืออะไร?

การทำคลัสเตอร์ High Availability หรือที่เรียกว่าการทำคลัสเตอร์ HA มีประสิทธิภาพสำหรับแอปพลิเคชันทางธุรกิจที่สำคัญต่อภารกิจ ระบบ ERP และฐานข้อมูล เช่น SQL Server SAP และ Oracle ที่ต้องการความพร้อมใช้งานเกือบต่อเนื่อง

การจัดกลุ่ม HA สามารถแบ่งออกเป็นสองประเภท ได้แก่ การกำหนดค่า "Active-Active" และการกำหนดค่า Active-Passive

มาดูความแตกต่างระหว่างการทำคลัสเตอร์ HA ทั้งสองประเภทนี้

HA Clustering Type 1: Active-Active Configuration

ในการกำหนดค่าแอ็คทีฟแอ็คทีฟ การประมวลผลจะดำเนินการกับโหนดทั้งหมดในคลัสเตอร์ ตัวอย่างเช่น ในกรณีของการทำคลัสเตอร์แบบสองโหนด ทั้งสองโหนดจะทำงานอยู่ หากโหนดหนึ่งหยุดลง การประมวลผลจะถูกแทนที่ด้วยอีกโหนดหนึ่ง

อย่างไรก็ตาม หากแต่ละโหนดทำงานที่เกือบ 100% และโหนดหนึ่งหยุดทำงาน โหนดอื่นจะรับภาระการประมวลผลเพิ่มเติมได้ยาก ดังนั้น การวางแผนกำลังการผลิตที่มีมาร์จิ้นจึงมีความสำคัญสำหรับการทำคลัสเตอร์ HA

HA Clustering Type 2: Active-Standby Configuration

ลองใช้ตัวอย่างสองโหนดของเราอีกครั้ง ในการกำหนดค่าแอ็คทีฟสแตนด์บาย โหนดหนึ่งได้รับการกำหนดค่าเป็นโหนดที่ใช้งานอยู่และอีกโหนดหนึ่งได้รับการกำหนดค่าเป็นโหนดสแตนด์บาย โหนดที่ทำงานอยู่และสัญญาณแลกเปลี่ยนโหนดสแตนด์บายที่เรียกว่า "ฮาร์ตบีต" เพื่อตรวจสอบว่าทำงานเป็นปกติหรือไม่

หากโหนดสแตนด์บายไม่สามารถรับการเต้นของหัวใจของโหนดที่ทำงานอยู่ โหนดสแตนด์บายจะกำหนดว่าโหนดที่ทำงานอยู่หยุดทำงานและจะเข้าควบคุมการประมวลผลของโหนดที่ทำงานอยู่ กลไกนี้เรียกว่า "เฟลโอเวอร์" ในทางกลับกัน กลไกที่กู้คืนโหนดปฏิบัติการที่หยุดทำงานและถ่ายโอนการประมวลผลกลับไปยังโหนดที่แอ็คทีฟที่กู้คืนมาจะเรียกว่า "failback" ในการกำหนดค่าแบบแอ็คทีฟ/สแตนด์บาย เมื่อเกิดความล้มเหลว การสลับอย่างง่ายจากโหนดแอ็คทีฟเป็นโหนดสแตนด์บายทำให้การกู้คืนค่อนข้างง่าย อย่างไรก็ตาม จำเป็นต้องพิจารณาว่าทรัพยากรของโหนดสแตนด์บายเมื่อโหนดปฏิบัติการทำงานตามปกติจะสูญเปล่า

สององค์ประกอบของการจัดกลุ่ม HA: การใช้งานและการจัดเก็บ

เพื่อให้คลัสเตอร์ HA มีประสิทธิภาพ ต้องแก้ไขสองส่วน: การจัดการแอปพลิเคชันและการป้องกันการจัดเก็บ ซอฟต์แวร์คลัสเตอร์จะตรวจสอบความสมบูรณ์ของแอปพลิเคชันที่ได้รับการป้องกัน และหากตรวจพบปัญหา ให้ย้ายการทำงานของแอปพลิเคชันนั้นไปยังโหนดสแตนด์บาย โหนดสแตนด์บายจำเป็นต้องเข้าถึงข้อมูลเวอร์ชันล่าสุด โดยควรเหมือนกับข้อมูลที่โหนดหลักเข้าถึงก่อนเหตุการณ์ สามารถทำได้สองวิธี: ที่เก็บข้อมูลที่ใช้ร่วมกัน, ที่เก็บข้อมูลแบบไม่ใช้ร่วมกัน ในโมเดลพื้นที่เก็บข้อมูลที่ใช้ร่วมกัน โหนดคลัสเตอร์ทั้งสองเข้าถึงที่เก็บข้อมูลเดียวกัน – โดยทั่วไปคือ SAN ในการกำหนดค่าแบบไม่มีการแบ่งใช้ (หรือที่เรียกว่า SANless) ที่จัดเก็บในเครื่องบนโหนดทั้งหมดจะถูกมิเรอร์โดยใช้ซอฟต์แวร์การจำลองแบบ

ผลิตภัณฑ์ซอฟต์แวร์การทำคลัสเตอร์มีความแตกต่างกันอย่างมากในด้านความสามารถในการตรวจสอบและตรวจจับปัญหาที่อาจทำให้แอปพลิเคชันล้มเหลว และในความสามารถในการจัดการการเฟลโอเวอร์ได้อย่างน่าเชื่อถือ ผลิตภัณฑ์การทำคลัสเตอร์จำนวนมากตรวจพบเฉพาะว่าแอปพลิเคชันเซิร์ฟเวอร์ทำงานหรือไม่ แต่ไม่ตรวจพบซอฟต์แวร์ บริการ เครือข่าย และปัญหาอื่นๆ ที่อาจทำให้แอปพลิเคชันล้มเหลว

การรับรู้แอปพลิเคชันเป็นสิ่งสำคัญ

ในทำนองเดียวกัน ERP และแอปพลิเคชันฐานข้อมูลที่ซับซ้อนมีส่วนประกอบหลายส่วนที่ต้องจัดเก็บไว้ในเซิร์ฟเวอร์หรืออินสแตนซ์ที่ถูกต้อง เริ่มทำงานในลำดับที่ถูกต้อง และดำเนินการตามแนวทางปฏิบัติที่ดีที่สุดที่ซับซ้อน เลือกซอฟต์แวร์คลัสเตอร์ที่มีซอฟต์แวร์เฉพาะที่เรียกว่า Application Recovery Kit ที่ออกแบบมาโดยเฉพาะเพื่อรักษาแนวปฏิบัติที่ดีที่สุดสำหรับข้อกำหนดเฉพาะของแอปพลิเคชัน/ฐานข้อมูล

มีหลายวิธีในการกำหนดค่าคลัสเตอร์ HA:

คลัสเตอร์สองโหนดแบบดั้งเดิมพร้อมพื้นที่เก็บข้อมูลที่ใช้ร่วมกัน


สองเซิร์ฟเวอร์ถูกคลัสเตอร์ด้วยที่เก็บข้อมูลแบบแบ่งใช้

คลัสเตอร์ไร้ SAN สองโหนด

คลัสเตอร์สามารถกำหนดค่าได้โดยใช้ LAN ในพื้นที่และการจำลองแบบระดับบล็อกแบบซิงโครนัสความเร็วสูง

การจำลองแบบเรียลไทม์สามารถใช้เพื่อซิงโครไนซ์ที่เก็บข้อมูลบนเซิร์ฟเวอร์หลักกับที่เก็บข้อมูลบนเซิร์ฟเวอร์สำรองที่อยู่ในศูนย์ข้อมูลเดียวกัน ในไซต์การกู้คืนจากความเสียหาย หรือทั้งสองอย่าง สิ่งนี้ช่วยให้คุณสร้างการกำหนดค่าความพร้อมใช้งานสูงและการกู้คืนจากความเสียหายได้อย่างยืดหยุ่น การจำลองระดับบล็อก SIOS สองโหนดหรือหลายโหนดได้รับการปรับให้เหมาะสมอย่างมากสำหรับประสิทธิภาพ คุณยังสามารถใช้ที่เก็บข้อมูลภายในที่เชื่อมต่อด้วยความเร็วสูงและความเร็วสูง เช่น อุปกรณ์จัดเก็บข้อมูลประเภทแฟลช PCIe บนเซิร์ฟเวอร์จริงของคุณ เพื่อให้ได้การกำหนดค่าที่ต่ำมาก ประสิทธิภาพสูง และมีความพร้อมใช้งานสูงข้อมูลของคุณได้รับการปกป้องบนอุปกรณ์แฟลชและแอปพลิเคชันของคุณด้วย

คลัสเตอร์บน SAN ที่มีโหนดที่สาม

โหนดที่สามสำหรับการป้องกันภัยพิบัติ

การกำหนดค่านี้ใช้คลัสเตอร์แบบ SAN และเพิ่มโหนด SANless ที่สามลงในศูนย์ข้อมูลระยะไกลหรือระบบคลาวด์ และได้รับการป้องกันการกู้คืนจากความเสียหายอย่างเต็มรูปแบบในกรณีที่เกิดภัยพิบัติ เซิร์ฟเวอร์กายภาพระยะไกลแบบสแตนด์บายจะให้บริการโดยอัตโนมัติโดยไม่มีข้อมูลสูญหาย ทำให้ไม่ต้องเสียเวลาในการกู้คืนจากสื่อสำรองข้อมูล

คลัสเตอร์โหลดบาลานซ์คืออะไร?

การทำคลัสเตอร์โหลดบาลานซ์เป็นกลไกที่สามารถใช้เป็นระบบเดียวได้โดยการกระจายการประมวลผลไปยังหลายโหนดโดยใช้ตัวโหลดบาลานซ์เพื่อปรับปรุงประสิทธิภาพโดยการกระจายการประมวลผล แม้ว่าจะสามารถแยกโหนดที่ล้มเหลวเพื่อป้องกันไม่ให้โหนดล้มเหลวส่งผลกระทบต่อทั้งระบบ แต่ตัวโหลดบาลานซ์ก็เป็นจุดเสี่ยงจุดเดียวที่สำคัญของความล้มเหลวและ ไม่ใช่ตัวเลือกความพร้อมใช้งานสูง . มีผลเฉพาะกับแอปพลิเคชันเช่นการโหลดบาลานซ์ของเว็บเซิร์ฟเวอร์ หากตัวโหลดบาลานซ์เองล้มเหลว ระบบทั้งหมดหยุดทำงาน

การทำคลัสเตอร์ HPC คืออะไร?

คุณยังสามารถใช้คลัสเตอร์เพื่อประสิทธิภาพได้อีกด้วย แทนความพร้อมใช้งานสูง . คลัสเตอร์คอมพิวเตอร์ประสิทธิภาพสูงหรือคลัสเตอร์ HPC รวมพลังการประมวลผลของหลาย ๆ (บางครั้งหลายพันโหนด) เพื่อให้ได้ประสิทธิภาพของ CPU ที่จำเป็นในสภาพแวดล้อมที่เน้น CPU เช่นสภาพแวดล้อมทางวิทยาศาสตร์และเทคโนโลยีที่ต้องการการจำลองขนาดใหญ่ การวิเคราะห์ CAE และการประมวลผลแบบขนาน .

คุณพร้อมที่จะค้นหาโซลูชันการทำคลัสเตอร์ HA ที่เหมาะสมสำหรับธุรกิจของคุณแล้วหรือยัง?

เรียนรู้เพิ่มเติมเกี่ยวกับการทำคลัสเตอร์ SIOS High Availability ที่นี่ .


ทำซ้ำโดยได้รับอนุญาตจาก SIOS

Filed Under: ทำให้เข้าใจง่ายเซิร์ฟเวอร์คลัสเตอร์

ข้อมูลเบื้องต้นเกี่ยวกับคลัสเตอร์ – ตอนที่ 1

พฤศจิกายน 18, 2021 by Jason Aw Leave a Comment

ข้อมูลเบื้องต้นเกี่ยวกับคลัสเตอร์ – ตอนที่ 1

ข้อมูลเบื้องต้นเกี่ยวกับคลัสเตอร์ – ตอนที่ 1

การจัดกลุ่มในตอนแรกคืออะไร?

เทคโนโลยีการจัดกลุ่มเป็นเทคโนโลยีที่ช่วยให้คุณสามารถเชื่อมต่อเซิร์ฟเวอร์หลายเครื่องเพื่อทำหน้าที่เป็นหน่วยการทำงานเดียว

ประเภทของการจัดกลุ่ม

คุณสามารถ กลุ่ม เซิร์ฟเวอร์เพื่อวัตถุประสงค์หลายประการ ตัวอย่างเช่น คุณสามารถรวมพลังการประมวลผลของเซิร์ฟเวอร์ขนาดเล็กหลายเครื่องเข้าด้วยกันเพื่อประสิทธิภาพสูง คุณยังสามารถกระจายงานการประมวลผลไปยังหลาย ๆ โหนดได้โดยใช้ตัวโหลดบาลานซ์เพื่อเพิ่มประสิทธิภาพ

การทำคลัสเตอร์ความพร้อมใช้งานสูง (HA) เป็นกระบวนการของการรวมโหนดเซิร์ฟเวอร์เพื่อปกป้องแอปพลิเคชันที่สำคัญจากการหยุดทำงานและการสูญหายของข้อมูล

ข้อมูลเบื้องต้นเกี่ยวกับคลัสเตอร์
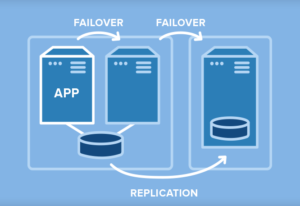
ในคลัสเตอร์เฟลโอเวอร์หน่วยเก็บข้อมูลที่ใช้ร่วมกันแบบดั้งเดิม โหนดหลักและโหนดรองหรือโหนดระยะไกลจะใช้ที่เก็บข้อมูลเดียวกัน

HA คลัสเตอร์

การจัดกลุ่มความพร้อมใช้งานสูง (HA) เป็นกลไกที่ช่วยลดเวลาหยุดทำงานโดยกำจัดจุดความล้มเหลวเพียงจุดเดียว (SPOF) ในคลัสเตอร์ HA แอปพลิเคชันที่สำคัญจะรันบนโหนดหลักที่เชื่อมต่อกับโหนดรองหรือโหนดระยะไกลอย่างน้อยหนึ่งโหนดในคลัสเตอร์ ซอฟต์แวร์คลัสเตอร์จะตรวจสอบความสมบูรณ์ของแอปพลิเคชัน เซิร์ฟเวอร์ และเครือข่าย ในกรณีที่เกิดความล้มเหลวบนโหนดหลัก โหนดหลักจะย้ายการดำเนินการของแอปพลิเคชันไปยังโหนดรองในกระบวนการที่เรียกว่าเฟลโอเวอร์ โดยที่การดำเนินการจะดำเนินต่อไป

ความพร้อมใช้งานสูง

ความพร้อมใช้งานสูงของแอปพลิเคชันคือการวัดระยะเวลาที่แอปพลิเคชันพร้อมใช้งานและใช้งานได้ในปีที่กำหนด โดยทั่วไปแล้ว HA คลัสเตอร์ ให้ความพร้อมใช้งาน 99.99% (สี่เก้า) หรือเวลาหยุดทำงานมากกว่า 52 นาทีเล็กน้อยตลอดทั้งปีที่กำหนด

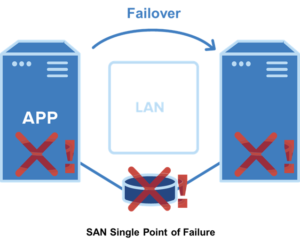
เป็นสิ่งสำคัญที่จะต้องทราบว่าในคลัสเตอร์ HA แบบดั้งเดิม โหนดคลัสเตอร์ทั้งหมดจะเชื่อมต่อกับที่เก็บข้อมูลที่ใช้ร่วมกันเดียวกัน ซึ่งโดยทั่วไปคือ SAN ด้วยวิธีนี้ หลังจากเกิดข้อผิดพลาด โหนดรองจะเข้าถึงข้อมูลเดียวกันกับโหนดหลักและการดำเนินการสามารถดำเนินต่อไปได้

ข้อมูลเบื้องต้นเกี่ยวกับคลัสเตอร์
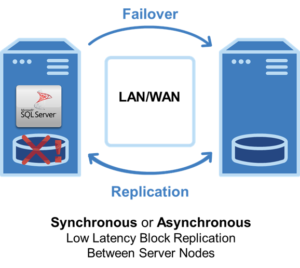
คลัสเตอร์ SANless ซิงโครไนซ์ที่เก็บข้อมูลในเครื่องโดยใช้การจำลองระดับบล็อกตามโฮสต์

SANless Clusters

อย่างไรก็ตาม หลายบริษัทต้องการใช้คลัสเตอร์ SANless ด้วยเหตุผลหลายประการ ประการแรก พื้นที่เก็บข้อมูลที่ใช้ร่วมกันแสดงถึงจุดล้มเหลวจุดเดียวที่สำคัญ ประการที่สอง พื้นที่จัดเก็บข้อมูลที่ใช้ร่วมกันมักไม่ใช่ตัวเลือกในสภาพแวดล้อมคลาวด์สาธารณะ ประการที่สาม SAN อาจขัดขวางประสิทธิภาพของแอปพลิเคชันฐานข้อมูล เช่น SQL Server, Oracle และ SAP

แทนที่จะใช้พื้นที่เก็บข้อมูลที่ใช้ร่วมกัน บริษัทเหล่านี้ใช้การจำลองแบบระดับบล็อกที่มีประสิทธิภาพ อิงโฮสต์ เพื่อซิงโครไนซ์ที่เก็บข้อมูลในเครื่องบนโหนดคลัสเตอร์ทั้งหมด ในกรณีเกิดเฟลโอเวอร์ โหนดรองจะเชื่อมต่อกับที่จัดเก็บในตัวเครื่องโดยมีสำเนาที่เหมือนกันของที่เก็บข้อมูลหลัก ซึ่งไม่เพียงแต่ช่วยขจัดความเสี่ยง SAN SPOF เท่านั้น แต่ยังช่วยให้เพิ่มดิสก์ด่วน (SSD) ลงในที่จัดเก็บข้อมูลภายในองค์กรเพื่อประสิทธิภาพสูงที่คุ้มค่า การทำคลัสเตอร์ SANless ยังช่วยให้บริษัทต่างๆ สามารถโยกย้ายสภาพแวดล้อม HA ในสถานที่ไปยังคลาวด์ได้โดยใช้ความพยายามเพียงเล็กน้อยหรือการหยุดชะงักของกระบวนการทางธุรกิจที่กำลังดำเนินอยู่

สืบพันธุ์จาก SIOS

Filed Under: ทำให้เข้าใจง่ายเซิร์ฟเวอร์คลัสเตอร์ Tagged With: SIOS

  • « Previous Page
  • 1
  • …
  • 56
  • 57
  • 58
  • 59
  • 60
  • …
  • 112
  • Next Page »

โพสต์ล่าสุด

  • ระบบความพร้อมใช้งานสูง (High Availability หรือ HA) คืออะไร?
  • เอาตัวรอดจากวิกฤตการณ์วันศุกร์: จากระบบคอมพิวเตอร์แบบดิบๆ สู่การจำลองข้อมูลที่ราบรื่น
  • ติดดิน: สิ่งที่การพลาดชม Percona Live Amsterdam สอนฉันเกี่ยวกับ HA
  • เปรียบเทียบ SIOS LifeKeeper กับ Red Hat High Availability Add-On:
  • สถานะของความยืดหยุ่นของแอปพลิเคชัน: ผลสำรวจความพร้อมใช้งานสูงของ SIOS ปี 2026

กระทู้ยอดนิยม

เข้าร่วมรายชื่อผู้รับจดหมายของเรา

Copyright © 2026 · Enterprise Pro Theme on Genesis Framework · WordPress · Log in