SIOS SANless clusters

SIOS SANless clusters High-availability Machine Learning monitoring

  • Home
  • Products
    • SIOS DataKeeper for Windows
    • SIOS Protection Suite for Linux
  • การทดสอบอาหารสัตว์
  • ข่าวสารและกิจกรรม
  • ทำให้เข้าใจง่ายเซิร์ฟเวอร์คลัสเตอร์
  • เรื่องราวความสำเร็จ
  • ติดต่อเรา
  • English
  • 中文 (中国)
  • 中文 (台灣)
  • 한국어
  • Bahasa Indonesia
  • ไทย

วิธีปกป้องแอปพลิเคชันในแพลตฟอร์มคลาวด์ – คลัสเตอร์ความพร้อมใช้งานสูงของ AWS EC2

กุมภาพันธ์ 11, 2022 by Jason Aw Leave a Comment

วิธีปกป้องแอปพลิเคชันในแพลตฟอร์มคลาวด์ - คลัสเตอร์ความพร้อมใช้งานสูงของ AWS EC2

วิธีปกป้องแอปพลิเคชันในแพลตฟอร์มคลาวด์ – คลัสเตอร์ความพร้อมใช้งานสูงของ AWS EC2

คลัสเตอร์สำหรับความพร้อมใช้งานสูงของ AWS

โซลูชันความพร้อมใช้งานและคลัสเตอร์ระดับสูงสำหรับแอปพลิเคชันใน AWS

การทำคลัสเตอร์ AWS คืออะไร

คลัสเตอร์ AWS คือชุดของเทคโนโลยีที่ได้รับการกำหนดค่าเพื่อให้แน่ใจว่ามีการป้องกันความพร้อมใช้งานสูงสำหรับแอปพลิเคชันที่ใช้สภาพแวดล้อม AWS EC2 และตรวจสอบด้วยซอฟต์แวร์การทำคลัสเตอร์ ในสภาพแวดล้อมคลัสเตอร์ AWS โหนดสองโหนดขึ้นไปใน AWS ได้รับการกำหนดค่าในคลัสเตอร์เฟลโอเวอร์ แอปพลิเคชันทำงานบนโหนดหลักในคลัสเตอร์ หากซอฟต์แวร์การทำคลัสเตอร์ตรวจพบความล้มเหลวในการทำงานของแอปพลิเคชัน ซอฟต์แวร์จะจัดการการเฟลโอเวอร์ของการทำงานของแอปพลิเคชันไปยังโหนดรองในคลัสเตอร์ เพื่อลดความซับซ้อนและเร่งการปรับใช้คลัสเตอร์ที่มีความพร้อมใช้งานสูงใน AWS ซอฟต์แวร์คลัสเตอร์ที่มีความพร้อมใช้งานสูงของ SIOS จะพร้อมใช้งานบน AWS Marketplace . สามารถใช้งานได้โดยอัตโนมัติโดยใช้ an AWS QuickStart หรือผ่านรูปแบบการให้สิทธิ์ใช้งานแบบถาวรของคุณเอง คลัสเตอร์ SIOS เปิดใช้งานการเฟลโอเวอร์ของคลัสเตอร์โดยเฉพาะในภูมิภาค AWS และโซนความพร้อมใช้งานสำหรับเวลาทำงานจริง 99.99% และการป้องกันการกู้คืนจากความเสียหาย

SIOS มอบความพร้อมใช้งานสูงใน AWS

เพื่อลดความซับซ้อนและเร่งการปรับใช้คลัสเตอร์ที่มีความพร้อมใช้งานสูงในระบบคลาวด์ SIOS High Availability Clustering Software พร้อมใช้งานบน ตลาด AWS สามารถใช้งานได้โดยอัตโนมัติโดยใช้ an AWS QuickStart . การปรับใช้ AWS Quick Start เหมาะอย่างยิ่งสำหรับองค์กรที่ลงทุนในคลัสเตอร์ที่มีความพร้อมใช้งานสูงในคลาวด์เป็นครั้งแรกคู่ค้าคลัสเตอร์ AWS
ความพร้อมใช้งานสูงของ AWS พร้อม SIOS DataKeeper

SIOS DataKeeper Cluster Edition เป็นความพร้อมใช้งานสูงครั้งแรกและ การกู้คืนระบบ โซลูชันเพื่อรวมการทำคลัสเตอร์แบบอัตโนมัติเต็มรูปแบบที่เน้นแอปพลิเคชันและการจำลองข้อมูลอย่างมีประสิทธิภาพ การรวมเข้ากับสภาพแวดล้อม Windows Server Failover Clustering ได้อย่างราบรื่น ช่วยให้คลัสเตอร์ที่มีความพร้อมใช้งานสูงทำงานในระบบคลาวด์ซึ่งไม่สามารถจัดเก็บข้อมูลที่ใช้ร่วมกันได้ SIOS DataKeeper ซิงโครไนซ์ที่เก็บข้อมูลในเครื่องแบบเรียลไทม์โดยใช้การจำลองระดับบล็อกที่มีประสิทธิภาพสูงเพื่อสร้างคลัสเตอร์ SANless ผู้ดูแลระบบและผู้จัดการมีโอกาสลองใช้โปรแกรม AWS Quick Start พวกเขาสามารถใช้ SIOS Amazon Machine Image (AMI) บน AWS Marketplace เพื่อดูว่าการปรับใช้สองโหนดนั้นง่ายเพียงใด คลัสเตอร์เซิร์ฟเวอร์ SQL ในระบบคลาวด์ ด้วย SIOS DataKeeper SIOS AMI บน AWS Marketplace มอบวิธีที่ง่ายและสะดวกสำหรับลูกค้าในการซื้อซอฟต์แวร์ SIOS DataKeeper เพื่อปกป้องแอปพลิเคชันที่มีความสำคัญต่อธุรกิจใน AWS

เทคโนโลยี SIOS ได้รับสถานะ AWS Microsoft Workloads Competency การกำหนดนี้ตระหนักว่า SIOS มอบเทคโนโลยีที่ได้รับการพิสูจน์แล้วและความเชี่ยวชาญอย่างลึกซึ้งในการช่วยเหลือลูกค้าในการโยกย้าย การปรับใช้ และการจัดการแอปพลิเคชันบน Microsoft บน AWS โดยเฉพาะกับปริมาณงานที่ใช้ Microsoft SQL Server

SIOS Protection Suite สำหรับ Linux ให้ความพร้อมใช้งานสูงอย่างแท้จริงสำหรับ AWS

ผู้ให้บริการระบบคลาวด์ เช่น AWS มีตัวเลือกความพร้อมใช้งาน แต่พวกเขาไม่ได้ให้ระดับของ ความพร้อมใช้งานสูง และการป้องกันที่ครอบคลุมทั่วทั้งโครงสร้างพื้นฐานของแอปพลิเคชันทั้งหมดที่ลูกค้าต้องการและที่คุณได้รับจากการใช้คลัสเตอร์ก่อนที่จะมีคลาวด์ ลูกค้า AWS ทราบเรื่องนี้ พวกเขารู้ว่าพวกเขาต้องการความพร้อมใช้งานจริงและเครื่องมือซอฟต์แวร์การจัดกลุ่มที่ให้ความพร้อมใช้งานสูงในระดับที่แท้จริง (เวลาทำงานอย่างน้อย 99.99%) ด้วยเหตุนี้ AWS จึงเป็นพันธมิตรกับ SIOS ของเรา SIOS Protection Suite สำหรับ Linux เพื่อให้ได้ระดับความพร้อมใช้งานสูงที่ต้องการเหล่านี้ด้วย การทำคลัสเตอร์ Linux สำหรับลูกค้าที่มีร่วมกันของเราและแอปพลิเคชันที่สำคัญที่พวกเขากำลังย้ายไปยัง AWS Cloud

SIOS Protection Suite สำหรับ Linux ให้การผสมผสานอย่างแน่นหนาของคลัสเตอร์เฟลโอเวอร์ที่มีความพร้อมใช้งานสูง การตรวจสอบแอปพลิเคชันอย่างต่อเนื่อง การจำลองข้อมูล และนโยบายการกู้คืนที่กำหนดค่าได้ SIOS Protection Suite สำหรับ Linux ประกอบด้วย SIOS LifeKeeper, SIOS DataKeeper และ Application Recovery Kits (ARK) หลายชุดเพื่อปกป้องแอปพลิเคชันและข้อมูลที่สำคัญต่อธุรกิจของคุณจากการหยุดทำงานและภัยพิบัติ
การปรับใช้ SIOS Quick Start สำหรับ AWS

SIOS มอบความสามารถความพร้อมใช้งานสูงแบบเดียวกับที่มีให้ผ่าน Windows Server Failover Cluster ในระบบคลาวด์และกำหนดค่าได้บน AWS อย่างรวดเร็วและง่ายดาย ช่วยประหยัดเวลาหลายเดือน ปรับปรุงความยืดหยุ่นในการปฏิบัติงาน และลดต้นทุนในการติดตั้งและบำรุงรักษาลงอย่างมาก มาดูกันว่าลูกค้าของเรา กัลลิเวอร์ และ มหากาพย์ ใช้ซอฟต์แวร์คลัสเตอร์ความพร้อมใช้งานสูง SIOS ใน AWS

ข้อเสนอของ AWS Marketplace และการปรับใช้ SIOS DataKeeper และ SIOS Protection Suite Quick Start สำหรับ AWS เป็นโซลูชันที่ครอบคลุมซึ่งช่วยลดความยุ่งยากในการเปลี่ยนไปใช้ปฏิบัติการที่มีความพร้อมใช้งานสูงในระบบคลาวด์ ในที่สุดก็นำไปสู่การปลดพนักงานไอทีเพื่อสนับสนุนความคิดริเริ่มในการขับเคลื่อนธุรกิจเพิ่มเติม

AWS Quick Starts คือการปรับใช้อ้างอิงอัตโนมัติสำหรับปริมาณงานหลักบน AWS QuickStart แต่ละรายการจะเปิดใช้ กำหนดค่า และเรียกใช้บริการของ AWS ที่จำเป็นในการปรับใช้ปริมาณงานเฉพาะบน AWS ซึ่งทำได้โดยใช้แนวทางปฏิบัติที่ดีที่สุดของ AWS เพื่อความปลอดภัยและความพร้อมใช้งาน QuickStarts ขจัดขั้นตอนที่ต้องทำด้วยตนเองด้วยการคลิกเพียงครั้งเดียว รวดเร็ว ต้นทุนต่ำ และปรับแต่งได้ SIOS DataKeeper AMI หลายรายการพร้อมจำหน่ายบน AWS Marketplace ดังนั้นจึงช่วยให้ลูกค้าเพิ่มความพร้อมใช้งานสูงในการปรับใช้ที่มีอยู่หรือปรับใช้คลัสเตอร์ SQL Server แบบสองโหนดใน AWS อ่านเอกสารไวท์เปเปอร์

  • ซื้อ SIOS DataKeeper ผ่าน AWS Marketplace
  • ดูการเริ่มต้นอย่างรวดเร็วสำหรับ SIOS Protection Suite สำหรับ Linux บน AWS
  • ดูข้อมูลเพิ่มเติมเกี่ยวกับ ความพร้อมใช้งานสูงสำหรับ SQL บน AWS
  • ขอ ทดลองใช้ซอฟต์แวร์การทำคลัสเตอร์ความพร้อมใช้งานสูงของ SIOS ฟรี

ดูบล็อกโพสต์ล่าสุดเกี่ยวกับความพร้อมใช้งานสูงของระบบคลาวด์ที่นี่

ทำซ้ำโดยได้รับอนุญาตจาก SIOS
Filed Under: ทำให้เข้าใจง่ายเซิร์ฟเวอร์คลัสเตอร์

วิธีป้องกันแอปพลิเคชันในแพลตฟอร์มคลาวด์ – คลัสเตอร์ SANless สำหรับสภาพแวดล้อมคลาวด์

กุมภาพันธ์ 7, 2022 by Jason Aw Leave a Comment

วิธีป้องกันแอปพลิเคชันในแพลตฟอร์มคลาวด์ – คลัสเตอร์ SANless สำหรับสภาพแวดล้อมคลาวด์

ทำซ้ำโดยได้รับอนุญาตจาก SIOS

Filed Under: ทำให้เข้าใจง่ายเซิร์ฟเวอร์คลัสเตอร์

สิ่งสำคัญเจ็ดประการในการเปลี่ยนทีมความพร้อมใช้งานสูง

กุมภาพันธ์ 3, 2022 by Jason Aw Leave a Comment

สิ่งสำคัญเจ็ดประการในการเปลี่ยนทีมความพร้อมใช้งานสูง

สิ่งสำคัญเจ็ดประการในการเปลี่ยนทีมที่มีความพร้อมใช้งานสูง (การนำทางการลาออกครั้งใหญ่)

เว้นแต่คุณจะอยู่ใต้ก้อนหินหรือถูกแช่แข็งในเวลาที่คุณน่าจะเคยได้ยินจากแหล่งใดแหล่งหนึ่งว่านายจ้างและพนักงานอยู่ท่ามกลางกระแสที่เรียกว่า "การลาออกครั้งใหญ่"ตามที่รายงานใน US News and World Report “ตามรายงานของสำนักงานสถิติแรงงานสหรัฐ ชาวอเมริกัน 4 ล้านคนลาออกจากงานในเดือนกรกฎาคม พ.ศ. 2564 และแนวโน้มก็ไม่ชะลอตัวลง” ไม่ว่าขนาดบริษัทของคุณหรือกระแสรายได้ในปัจจุบัน หากยังไม่มี แนวโน้มนี้จะส่งผลกระทบต่อทีมไอทีของคุณในอนาคตอันใกล้ใช่ ปล่อยให้มันจมลงไปทีมเดียวกันที่รับผิดชอบในการตรวจสอบความพร้อมของแอปพลิเคชันที่สำคัญต่อภารกิจของคุณมีความเสี่ยงไม่ทางใดก็ทางหนึ่งต่อผลกระทบของ "The Great Resignation" แล้วคุณจำสัญญาณเตือนได้อย่างไร มาตกลงกับความเป็นจริงและนำทางด้วยความเอาใจใส่และชัดเจนผ่าน “การลาออกครั้งใหญ่” เพื่อไม่ให้เกิด “ภัยพิบัติครั้งใหญ่” สำหรับการใช้งานที่สำคัญของคุณ?

นี่คือคำแนะนำทางเทคนิคและไม่ใช่ทางเทคนิคสำหรับเสียง ความพร้อมใช้งานสูง (HA) แนวปฏิบัติที่ดีที่สุดท่ามกลางการเปลี่ยนแปลง:

1. Don't Quit

อย่าเลิก.อย่างจริงจัง!ในขณะที่เพื่อนร่วมงานและคนดี ๆ กำลังเลือกที่จะเปลี่ยนงาน อาชีพ หรือเลิกจ้างงาน การเลิกจ้างอาจเป็นสิ่งที่น่าดึงดูดใจโดยเฉพาะอย่างยิ่งเมื่อคุณเริ่มพิจารณาถึงโอกาสในการแบกภาระงานที่หนักอยู่แล้วด้วยม้านั่งที่สั้นลงแต่อย่าเลิก

2. ระบุความเสี่ยงที่สำคัญต่อความพร้อมใช้งานสูง

แน่นอนว่ากระบวนการระบุความเสี่ยงนี้เป็นแบบสองง่าม หลังจากการลาออก ทีมของคุณมีความเสี่ยงจากการเปลี่ยนแปลงบุคลากรเพิ่มเติมแต่ความพร้อมใช้งานสูงของคุณก็มีความเสี่ยงเช่นกันเนื่องจากสูญเสียความสามารถ ความรู้ด้านเทคนิค หรือความเชี่ยวชาญเพื่อป้องกันไม่ให้องค์กรของคุณประสบปัญหาการหยุดทำงานโดยไม่ได้วางแผนหลังจากการลาออกของทีมใหม่ คุณจะต้องระบุความเสี่ยงที่สำคัญความเสี่ยงทางเทคนิคบางประการ ได้แก่:

  1. ความเชี่ยวชาญและความรู้เกี่ยวกับคลาวด์
  2. การบริหารฐานข้อมูล
  3. การดูแลระบบการจัดเก็บและการกำหนดค่า
  4. ความรู้เกี่ยวกับผลิตภัณฑ์ Tacit High Availability
  5. ความคุ้มครองฉุกเฉิน (บุคลากร)
  6. ความเป็นผู้นำทางเทคนิค
  7. เอกสาร

3. ผู้จัดการ: ประเมินบริษัทของคุณ

หลายครั้งที่ผู้คนเริ่มออกจากบริษัท มันง่ายมากที่จะพูดว่า "พวกเขา ไม่ใช่เรา!" เราต้องการเน้นที่เหตุผลทั้งหมดว่าทำไมปัญหาจึงทำให้พวกเขาลาออก ลาออก หรือเลือกอาชีพหรืองานอื่นค่อนข้างเป็นไปได้ที่เหตุผลในการจากไปเป็นเรื่องส่วนตัว แต่บางครั้ง ปัญหาก็อยู่ที่กระจกเงาและไม่ใช่พวกเขา แต่เป็นเราเหตุใดการค้นหาว่าเป็นปัญหากับพวกเขาหรือคุณมีความสำคัญต่อ HA หรือไม่ถ้าปัญหาอยู่ที่บริษัทของคุณ เช่น พันธกิจ วิสัยทัศน์ วัฒนธรรมเกี่ยวกับ HA และ IT หรือปัญหาการว่าจ้างและการจัดพนักงานสำหรับการจัดการระบบ IT และ HA เพียงแค่เพิ่มจำนวนพนักงานก็จะเป็นการแก้ไขชั่วคราวนอกจากนี้ ความเสี่ยงต่อขวัญกำลังใจของทีม ความมุ่งมั่น และการถ่ายทอดความรู้อาจถูกลดทอนลงไปอีก เนื่องจากยังคงให้ความสำคัญกับการเปลี่ยนโทษและการแก้ปัญหา

4. หัวหน้าทีม: ประเมินทีมของคุณ

เกือบทุกบริษัทมีคนลาออกจากทีมในช่วงสองปีที่ผ่านมาไม่ว่าพวกเขาจะแสวงหาค่าจ้างที่สูงขึ้น อยู่บ้านเพื่อดูแลสมาชิกในครอบครัว เกษียณอายุ หรือแสวงหาทางเลือกอื่น ๆ พวกเขาก็ต้องจากไปหากคุณสูญเสียสมาชิกในทีม การประเมินทีมที่เหลืออยู่เป็นสิ่งสำคัญการประเมินนี้จะมีลักษณะทางเทคนิคและไม่ใช่ทางเทคนิคในทางเทคนิค คุณจะต้อง: ก. ระบุทักษะ ความสามารถ และช่องว่างความรู้ในปัจจุบัน ทักษะใดที่เหลืออยู่ในทีม และความเชี่ยวชาญทางเทคนิคและความสามารถระดับใด ช่องว่างความรู้ระหว่าง โดยเฉพาะระหว่างทฤษฎีกับการปฏิบัติอยู่ที่ไหน

ข. ทำความเข้าใจทั้งบทบาทที่มีอยู่และที่ขาดหายไปสมาชิกในทีมของคุณหลายคนอาจมีหน้าที่และความรับผิดชอบหลายอย่างการสูญเสียสมาชิกในทีมคนเดียวอาจหมายถึงการสูญเสียความคุ้มครองในหลายบทบาทและความรับผิดชอบ

ค. ประเมินความต้องการการฝึกอบรมหรือเสริมทันที คุณได้รับการคุ้มครองที่ใด แต่ต้องการการฝึกอบรมเพิ่มเติมเพื่อให้ทีมมีเสถียรภาพและมั่นคง? พื้นที่ใดที่คุณขาดความคุ้มครองที่สามารถบรรเทาได้ด้วยการฝึกอบรมบุคลากรที่มีอยู่หรือรูปแบบบริการมืออาชีพด้านสัญญาบางรูปแบบ?ในฐานะ VP of Customer Experience ดูสิ่งนี้โดยตรง เมื่อเร็วๆ นี้ ทีมงานของเราทำงานร่วมกับบริษัทที่ต้องการบริการอย่างมืออาชีพหลังจากสูญเสียสมาชิกในทีมหลักที่รับผิดชอบต่อสภาพแวดล้อม HA ของพวกเขาไป

ที่ไม่ใช่ทางเทคนิค คุณจะต้อง: ก. เข้าใจว่าสมาชิกในทีมที่เหลือรู้สึกอย่างไร แม้กระทั่งก่อนเกิดการระบาดของโควิด-19 และช่วง “การลาออกครั้งใหญ่” หลายทีมต่างก็วิ่งหนีควัน โลกแห่ง HA ที่เปิดตลอด 24 ชั่วโมงทุกวันทิ้งงานมากมายที่ต้องทำให้เสร็จด้วยหมายเลขทีม บรรทัดฐาน และงานตามปกติหากทีมของคุณได้รับผลกระทบ การเช็คอินและฟังเรื่องราวของสมาชิกในทีมที่เหลืออยู่นั้นมีความสำคัญพอๆ กับเซิร์ฟเวอร์ที่ใช้งานจริงค้นหาว่าใครกำลังหมดแรง หมดไฟ สับสน ใกล้จะพังหรือในทางกลับกัน เต็มไปด้วยชีวิตชีวาและพร้อมสำหรับความท้าทายครั้งใหม่ อย่าลืมฟังสัญญาณด้วยวาจาและอวัจนภาษา เห็นอกเห็นใจ (ไม่ใช่แค่กับการสูญเสียเพื่อนร่วมงาน แต่ด้วยอารมณ์ ความกังวล และความกลัวของพวกเขา)

ข. ทำความเข้าใจเหตุผลที่สมาชิกในทีมที่เหลืออยู่ยังคงอยู่บนเรือ การรู้ว่าสมาชิกในทีมรู้สึกอย่างไรเป็นทั้งความจำเป็นทางเทคนิคและไม่ใช่ทางเทคนิค แต่เกือบเท่ากับงานนี้คือการหาเหตุผลที่ทำให้พวกเขาอยู่ต่อแน่นอน เหตุผลบางอย่างอาจทำให้คุณประหลาดใจผู้เขียนและวิทยากร Carey Nieuwhof กล่าวว่าสมาชิกในทีมบางคนอยู่เพียงเพราะพวกเขา “รู้สึกติดอยู่กับทีมเพราะพวกเขาไม่ได้ออกไปก่อน” เหตุผลอื่นๆ ที่สมาชิกในทีมอยู่ต่ออาจไม่ทำให้คุณประหลาดใจ แต่ไม่ว่าจะด้วยเหตุผลใดก็ตาม ความสะดวกสบาย โอกาส เงินเดือน สถานที่ ทางเลือกหุ้น ความหลงใหล การทำงานเป็นทีม วัฒนธรรม เหตุผลทั้งหมดที่สมาชิกในทีมของคุณอยู่นั้นมีความสำคัญ

ค. ประเมินผลกระทบของการเป็นคนมือสั้น เห็นได้ชัดว่ามีองค์ประกอบทางเทคนิคของการถูกกล่าวถึงก่อนหน้านี้ การประเมินช่องว่างทักษะ ฯลฯ แต่มีข้อบ่งชี้ในการประเมินทางเทคนิคของการเป็นคนถนัดมือสั้น และนั่นไม่ใช่เทคนิคให้แน่ใจว่าได้ประเมินและประเมินผลกระทบที่จะมีผลกระทบต่อจิตใจ อารมณ์ และสุขภาพส่วนบุคคลของสมาชิกในทีมที่เหลืออยู่แม้เพียงชั่วครู่เท่านั้นในช่วงเริ่มต้นอาชีพการเป็นผู้จัดการ ทีมงานของเราจัดการกับเหตุการณ์ที่ลดขนาดลงซึ่งทำให้พนักงานหลายคนอ่อนแอทางอารมณ์และเหนื่อยล้าทางจิตใจสิ่งนี้นำไปสู่ความเหนื่อยล้าที่สูงขึ้น มีหมอกในจิตใจมากขึ้น และเพิ่มอัตราข้อบกพร่องและข้อผิดพลาดของสมาชิกในทีมเหล่านั้นหากทีมของคุณได้รับผลกระทบอย่างรุนแรงทั้งทางร่างกายและจิตใจจากการมีสมาธิสั้น ความเสี่ยงต่อ HA ของคุณอาจเพิ่มขึ้นทีมของคุณอาจแย่งชิงเพื่อเอาตัวหย่อน และพวกเขาอาจชุมนุมอย่างรวดเร็วเพื่อครอบคลุมสำหรับหัวหน้าหรือสมาชิกในทีมที่ลาออก แต่สิ่งสำคัญคือคุณต้องเข้าใจว่าผู้ที่ยังคงอยู่นั้นหมดแรง รู้สึกติดกับดัก หรือมีความเสี่ยงที่จะ ออกจาก.

5. ระบุงานด้านเทคนิคที่สำคัญ ลำดับความสำคัญ และมอบหมายความรับผิดชอบ

หลายปีก่อน ผู้บริหารระดับสูงลาออกจากบริษัทแม้จะเปลี่ยนบทบาทและงานตลอดเกือบหนึ่งปีของการเปลี่ยนแปลง แต่ก็ยังมีบทบาทและงานที่สร้างความประหลาดใจให้กับพนักงานที่เหลืออยู่ในการลาออกในปัจจุบันนี้ คุณไม่มีช่วงเปลี่ยนผ่านทั้งปีนอกจากนี้ หากทีมของคุณมีประสบการณ์การลาออกมากกว่าหนึ่งครั้ง คุณอาจยังวิเคราะห์และเปลี่ยนบุคคลแรกไม่เสร็จ ดังนั้นจึงเป็นสิ่งสำคัญมากในการระบุและจัดลำดับความสำคัญของงานที่สำคัญที่สุด และมอบหมายความรับผิดชอบ อย่าลืมแสดงรายการงานต่างๆ เช่น การสแกนความปลอดภัย การอัปเดต การบำรุงรักษา การสำรองข้อมูล การทดสอบ การปรับใช้แอปพลิเคชันใหม่ การวิเคราะห์ต้นทุน การโคลนและการปรับใช้อิมเมจใหม่ แอปพลิเคชันแพตช์ และการแก้ไขช่องโหว่งานเหล่านี้ทั้งหมดยังคงมีความจำเป็นแม้ว่าจะสูญเสียไปและอาจส่งผลร้ายแรงได้หากปล่อยทิ้งไว้

6. จัดทำแผนระยะสั้นสำหรับการบำรุงรักษาและการดำเนินงาน

งาน บทบาท และความรับผิดชอบยังคงต้องได้รับการคุ้มครองปัญหาวิกฤตจะต้องได้รับการแก้ไขการหยุดทำงานโดยไม่ได้วางแผนจะไม่รอที่จะเกิดขึ้นหลังจากที่คุณสร้างพนักงานของคุณขึ้นใหม่ ฝึกอบรมบุคลากรที่มีอยู่ และติดตั้งบริษัทของคุณให้มีความยืดหยุ่นมากขึ้นต่อการเปลี่ยนแปลงและการเปลี่ยนแปลงของการลาออกครั้งใหญ่เพื่อนำทางในระยะสั้น คุณจะต้องพัฒนาแผนระยะสั้นที่ชาญฉลาดและบรรลุผลได้จริงแผนนี้ควรจัดทำแผนผังขั้นตอน งาน และกระบวนการที่ระบุเพื่อให้การบำรุงรักษาและการดำเนินการสามารถดำเนินต่อไปได้นอกจากนี้ ควรกำหนดวิธีการจัดการนโยบายโครงสร้างพื้นฐานที่สำคัญที่มีอยู่อย่างรอบคอบตลอดฤดูกาลที่วุ่นวายที่จะมาถึง

7. มุ่งสู่อนาคต

ขั้นตอนก่อนหน้านี้นำไปสู่สิ่งนี้ด้วยการประเมินทีมปัจจุบัน และการระบุความเสี่ยงที่สำคัญของคุณ และแผนการเปลี่ยนแปลงในขั้นตอนต่อไปคือการมุ่งเน้นไปที่อนาคต คุณยังคงมีภารกิจคุณยังมีแอปพลิเคชันที่สำคัญซึ่งจำเป็นต้องมีความพร้อมใช้งานสูงคุณยังมีข้อมูลที่จำเป็นต้องได้รับการปกป้อง ขุด จำลอง และพร้อมใช้งานสำหรับธุรกิจของคุณเริ่มวางแผนสำหรับทีมในอนาคต

  1. สร้างบทบาทและความรับผิดชอบ
  2. อัปเดตสถาปัตยกรรมและเอกสารประกอบ
  3. ประเมินโอกาสในการเติบโตและการจัดตำแหน่ง
  4. วางแผนการว่าจ้างใหม่ รวมทั้งเวลาในการเริ่มต้นใช้งาน
  5. จัดสรรเวลาและทรัพยากรเพื่อสร้างและอัปเดตสื่อการสอนงาน
  6. เน้นสุขภาพทีม
  7. ใช้กลยุทธ์การลดความเสี่ยงในระยะใกล้และวางแผนระยะยาว

ไม่ใช่ข่าวทั้งหมดที่เกี่ยวกับ “การลาออกครั้งใหญ่” จะเป็นข่าวร้ายสำหรับทีมและ HA ของคุณหลังจากที่สมาชิกในทีมออกจากตำแหน่งและโอกาสใหม่หรือแตกต่างกัน คุณมีโอกาสที่แท้จริงและหายากที่จะนำข้อมูลทั้งหมดของการประเมินของคุณมาเปลี่ยนเป็นเครื่องมือสำหรับการเติบโตและการจัดตำแหน่งและอนาคต HA ที่ดีขึ้นการสร้างอนาคตที่สดใสนี้รวมถึงการกำหนดหน้าที่ บทบาท และทักษะที่จำเป็น การปรับปรุงสถาปัตยกรรมและการออกแบบ การวางแผนสำหรับการว่าจ้างใหม่และการบริการ และการมุ่งเน้นที่การสร้างทีมที่มีสุขภาพดีขึ้น

ฉันได้พูดถึงเรื่องนี้โดยละเอียดมากขึ้นในครั้งล่าสุดนี้ สัมภาษณ์ ทีเอฟ.-Cassius Rhue, VP, ประสบการณ์ลูกค้าทำซ้ำจาก SIOS

Filed Under: ทำให้เข้าใจง่ายเซิร์ฟเวอร์คลัสเตอร์

ลดการหยุดทำงานด้วยความพร้อมใช้งานสูง

มกราคม 29, 2022 by Jason Aw Leave a Comment

ลดการหยุดทำงานด้วยความพร้อมใช้งานสูง

ลดการหยุดทำงานด้วยความพร้อมใช้งานสูง

เวลาหยุดทำงานมีราคาแพงกว่าที่เคยเป็นมาสำหรับธุรกิจสมัยใหม่ การสำรวจค่าใช้จ่ายรายชั่วโมงของการหยุดทำงานของ ITIC 2021 พบว่า 91% ขององค์กร การหยุดทำงานหนึ่งชั่วโมงในระบบ ฐานข้อมูล หรือแอปพลิเคชันที่สำคัญต่อธุรกิจมีค่าใช้จ่ายเฉลี่ยมากกว่า 300,000 ดอลลาร์ และสำหรับองค์กรขนาดใหญ่ 18% ต้นทุนของ เวลาหยุดทำงานหนึ่งชั่วโมงเกิน 5 ล้านเหรียญ

ความพร้อมใช้งานสูง (HA) เป็นคุณลักษณะของระบบ ฐานข้อมูล หรือแอปพลิเคชันที่ออกแบบมาให้ทำงานอย่างต่อเนื่องและเชื่อถือได้เป็นระยะเวลานาน เป้าหมายของ HA คือการลดหรือขจัดการหยุดทำงานโดยไม่ได้วางแผนไว้สำหรับแอปพลิเคชันที่สำคัญ ซึ่งทำได้โดยการกำจัดจุดล้มเหลวเพียงจุดเดียวด้วยการผสมผสานส่วนประกอบที่ซ้ำซ้อนและเทคโนโลยีอื่นๆ เข้ากับการออกแบบระบบ ฐานข้อมูล หรือแอปพลิเคชันที่มีความสำคัญต่อธุรกิจ

ตัวชี้วัด SLA และ HA

ข้อตกลงระดับบริการ (SLA) ถูกใช้โดยผู้ให้บริการเพื่อรับประกันว่าระบบ ฐานข้อมูล หรือแอปพลิเคชันที่มีความสำคัญต่อธุรกิจของลูกค้าจะพร้อมใช้งานเมื่อธุรกิจต้องการ

IDC ได้สร้างแบบจำลอง SLA ที่กำหนดความต้องการเวลาทำงานที่ห้าระดับดังนี้:

  • AL4 (ความพร้อมใช้งานอย่างต่อเนื่อง – ความคลาดเคลื่อนของระบบ): ไม่เกิน 5 นาที 15 วินาทีของการหยุดทำงานตามแผนและโดยไม่ได้วางแผนต่อปี (ความพร้อมใช้งาน 99.999% หรือ "ห้าเก้า")
  • AL3 (ความพร้อมใช้งานสูง – การทำคลัสเตอร์แบบดั้งเดิม): ไม่เกิน 52 นาที 35 วินาทีของการหยุดทำงานตามแผนและโดยไม่ได้วางแผนต่อปี (ความพร้อมใช้งาน 99.99% หรือ "สี่เก้า")
  • AL2 (การกู้คืน – การจำลองและสำรองข้อมูล): ไม่เกิน 8 ชั่วโมง 45 นาทีและ 56 วินาทีของการหยุดทำงานตามแผนและไม่ได้วางแผนต่อปี (ความพร้อมใช้งาน 99.9% หรือ "สามเก้า")
  • AL1 (ความน่าเชื่อถือ – ส่วนประกอบแบบถอดเปลี่ยนได้): ไม่เกิน 87 ชั่วโมง 39 นาทีและ 29 วินาทีของการหยุดทำงานตามแผนและไม่ได้วางแผนต่อปี (ความพร้อมใช้งาน 99% หรือ "สองเก้า")
  • AL0 (เซิร์ฟเวอร์ที่ไม่มีการป้องกัน): ไม่มีการรับประกันความพร้อมใช้งานหรือเวลาทำงาน

จากข้อมูลของ ITIC 89% ขององค์กรที่ทำการสำรวจต้องการความพร้อมใช้งาน "สี่เก้า" สำหรับระบบ ฐานข้อมูล และแอปพลิเคชันที่มีความสำคัญต่อธุรกิจของพวกเขา และ 35% ขององค์กรเหล่านั้นพยายามที่จะบรรลุความพร้อมใช้งาน "ห้าเก้า"

นอกจากเวลาทำงานและความพร้อมใช้งานแล้ว ตัวชี้วัด HA ที่สำคัญอีกสองรายการคือ วัตถุประสงค์เวลาพักฟื้น (RTO) และ วัตถุประสงค์ของจุดพักฟื้น (RPO) RTO คือระยะเวลาสูงสุดที่ยอมรับได้ของการหยุดทำงาน และ RPO คือจำนวนการสูญเสียข้อมูลสูงสุดที่สามารถยอมรับได้เมื่อเกิดความล้มเหลวขึ้น ไม่เหมือนกับตัววัด RTO และ RPO สำหรับการกู้คืนจากความเสียหายซึ่งโดยทั่วไปกำหนดไว้เป็นชั่วโมงและวัน ตัววัด RTO และ RPO สำหรับระบบ ฐานข้อมูล และแอปพลิเคชันที่มีความสำคัญต่อธุรกิจมักใช้เวลาเพียงไม่กี่วินาที (RTO) และศูนย์ (RPO)

HA คลัสเตอร์

การทำคลัสเตอร์ HA โดยทั่วไปประกอบด้วยโหนดเซิร์ฟเวอร์ ที่เก็บข้อมูล และซอฟต์แวร์การทำคลัสเตอร์

การจัดกลุ่มแบบดั้งเดิม

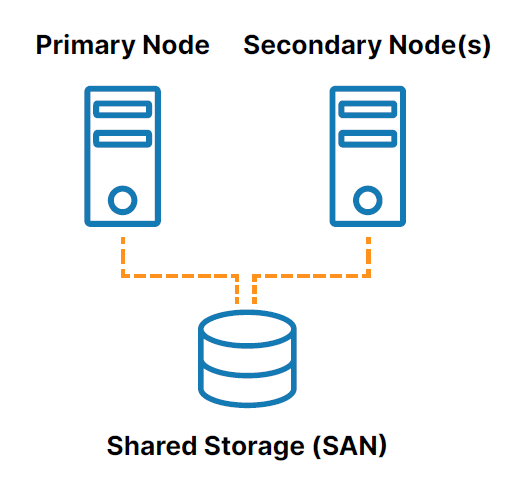
คลัสเตอร์ HA ภายในองค์กรแบบดั้งเดิมคือกลุ่มของโหนดเซิร์ฟเวอร์ตั้งแต่สองโหนดขึ้นไปที่เชื่อมต่อกับที่เก็บข้อมูลที่ใช้ร่วมกัน (โดยทั่วไปคือ เครือข่ายพื้นที่จัดเก็บ หรือ SAN) ที่ได้รับการกำหนดค่าด้วยระบบปฏิบัติการ ฐานข้อมูล และแอปพลิเคชันเดียวกัน (ดู รูปที่ 1 ).

การทำคลัสเตอร์เซิร์ฟเวอร์แบบดั้งเดิมพร้อมที่เก็บข้อมูลที่ใช้ร่วมกัน
รูปที่ 1: การทำคลัสเตอร์เซิร์ฟเวอร์แบบดั้งเดิมพร้อมที่เก็บข้อมูลที่ใช้ร่วมกัน

โหนดหนึ่งถูกกำหนดให้เป็นโหนดหลัก (หรือแอ็คทีฟ) และโหนดอื่น ๆ ถูกกำหนดให้เป็นโหนดรอง (หรือสแตนด์บาย) หากโหนดหลักล้มเหลว การทำคลัสเตอร์จะช่วยให้ระบบ ฐานข้อมูล หรือแอปพลิเคชันสามารถข้ามไปยังโหนดรองอย่างน้อยหนึ่งโหนดได้โดยอัตโนมัติ และทำงานต่อไปโดยมีการหยุดชะงักน้อยที่สุด เนื่องจากโหนดรองเชื่อมต่อกับที่เก็บข้อมูลเดียวกัน การดำเนินการจึงดำเนินต่อไปโดยที่ข้อมูลสูญหายเป็นศูนย์

อย่างไรก็ตาม การใช้พื้นที่จัดเก็บแบบแบ่งใช้ในรูปแบบการทำคลัสเตอร์แบบเดิมสร้างความท้าทายหลายประการ ได้แก่:

  • ที่เก็บข้อมูลแบบแบ่งใช้เป็นจุดความล้มเหลวเพียงจุดเดียวที่อาจทำให้โหนดที่เชื่อมต่อทั้งหมดในคลัสเตอร์ออฟไลน์ได้
  • พื้นที่จัดเก็บ SAN อาจมีราคาแพงและซับซ้อนในการเป็นเจ้าของและจัดการ
  • การจัดเก็บข้อมูลที่ใช้ร่วมกันในระบบคลาวด์สามารถเพิ่มค่าใช้จ่ายและความซับซ้อนที่ไม่จำเป็นได้อย่างมาก และผู้ให้บริการระบบคลาวด์บางรายไม่ได้เสนอตัวเลือกพื้นที่จัดเก็บข้อมูลที่ใช้ร่วมกัน

การทำคลัสเตอร์แบบไม่ใช้ SAN

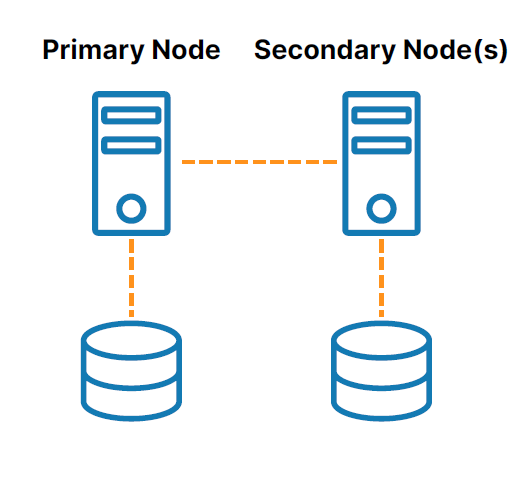
SANless หรือคลัสเตอร์ "ไม่แชร์อะไร" (ดู รูปที่ 2 ) จัดการกับความท้าทายที่เกี่ยวข้องกับการจัดเก็บข้อมูลที่ใช้ร่วมกัน ในการกำหนดค่าเหล่านี้ ทุกโหนดคลัสเตอร์มีที่เก็บข้อมูลในเครื่องของตัวเอง การจำลองแบบระดับบล็อกตามโฮสต์ที่มีประสิทธิภาพใช้เพื่อซิงโครไนซ์หน่วยเก็บข้อมูลบนโหนดคลัสเตอร์ โดยคงไว้ซึ่งความเหมือนกัน ในกรณีเกิดเฟลโอเวอร์ โหนดรองจะเข้าถึงสำเนาที่เหมือนกันของหน่วยเก็บข้อมูลที่ใช้โดยโหนดหลัก

การทำคลัสเตอร์ HA กับที่เก็บข้อมูล SANless หรือ "shared-nothing"
รูปที่ 2: การทำคลัสเตอร์ HA กับที่เก็บข้อมูล SANless หรือ "shared-nothing"

ซอฟต์แวร์คลัสเตอร์

ซอฟต์แวร์การทำคลัสเตอร์ช่วยให้คุณกำหนดค่าเซิร์ฟเวอร์ของคุณเป็นคลัสเตอร์เพื่อให้เซิร์ฟเวอร์หลายเครื่องสามารถทำงานร่วมกันเพื่อจัดหา HA และป้องกันการสูญหายของข้อมูล โซลูชันซอฟต์แวร์การทำคลัสเตอร์ที่หลากหลายพร้อมใช้งานสำหรับ Windows, Linux distribution และ virtual machine hypervisors ต่างๆ อย่างไรก็ตาม โซลูชันแต่ละอย่างจำกัดความยืดหยุ่นและตัวเลือกการปรับใช้ของคุณ และนำเสนอความท้าทายต่างๆ เช่น ความซับซ้อนทางเทคนิคและการให้สิทธิ์ใช้งานที่มีราคาแพง

อย่ารอให้เกิดภัยพิบัติ

HA มีความสำคัญต่อระบบ ฐานข้อมูล และแอปพลิเคชันที่มีความสำคัญต่อธุรกิจ แต่ด้วยแพลตฟอร์มที่มีอยู่มากมาย ความซับซ้อนก็เพิ่มขึ้นอย่างมาก นั่นเป็นเหตุผลที่โซลูชันที่รับรู้แอปพลิเคชันนั้นสมเหตุสมผลมาก สิ่งที่คุณต้องการคือพันธมิตรที่เชื่อถือได้ซึ่งมีความเชี่ยวชาญอย่างกว้างขวางในด้านความพร้อมใช้งานสูง—พันธมิตรเช่น SIOS ซึ่งมีความรู้ทางเทคโนโลยีเพื่อให้แน่ใจว่าธุรกิจของคุณจะดำเนินต่อไป

อย่ารอให้ไฟดับหรือภัยพิบัติเพื่อดูว่าคุณมีความยืดหยุ่นที่ธุรกิจของคุณต้องการหรือไม่ กำหนดเวลาการสาธิตส่วนบุคคลวันนี้ที่ https://us.sios.com เพื่อดูว่า SIOS สามารถทำอะไรกับธุรกิจของคุณได้บ้าง

สืบพันธุ์จาก SIOS


Filed Under: ทำให้เข้าใจง่ายเซิร์ฟเวอร์คลัสเตอร์

วิธีป้องกันแอปพลิเคชันและฐานข้อมูล – Oracle Clustering

มกราคม 25, 2022 by Jason Aw Leave a Comment

วิธีป้องกันแอปพลิเคชันและฐานข้อมูล - Oracle Clustering

วิธีป้องกันแอปพลิเคชันและฐานข้อมูล – Oracle Clustering

Oracle Clustering โดยไม่มี RAC: สิ่งที่คุณต้องรู้

Oracle Cluster คืออะไร

คลัสเตอร์ล้มเหลวเป็นวิธีหนึ่งในการมอบการป้องกันความพร้อมใช้งานสูงสำหรับแอปพลิเคชันโดยกำจัดจุดล้มเหลวเพียงจุดเดียวด้วยการเรียกใช้ระบบปฏิบัติการและฐานข้อมูลและแอปพลิเคชันเดียวกันบนเซิร์ฟเวอร์หลายเครื่องซึ่งทั้งหมดใช้ที่เก็บข้อมูลเดียวกันหรือเชื่อมต่อกับที่เก็บข้อมูลที่มีการซิงโครไนซ์อย่างต่อเนื่อง Oracle ทำงานบนหนึ่งในเซิร์ฟเวอร์เหล่านี้ ซึ่งเรียกว่าเซิร์ฟเวอร์หลัก หากล้มเหลว ซอฟต์แวร์การจัดการแอปพลิเคชัน (ซอฟต์แวร์การจัดกลุ่ม) จะย้ายการดำเนินการไปยังเซิร์ฟเวอร์สำรองอย่างน้อยหนึ่งเครื่องในกระบวนการที่เรียกว่าเฟลโอเวอร์ เนื่องจากเซิร์ฟเวอร์หลักและเซิร์ฟเวอร์ระยะไกลเข้าถึงที่เก็บข้อมูลเดียวกันหรือเหมือนกัน การทำงานของ Oracle จึงสามารถดำเนินการต่อได้โดยใช้เวลากู้คืนน้อยที่สุดหรือข้อมูลสูญหาย หลายองค์กรถือว่า Oracle เป็นแกนหลักของการดำเนินงาน โดยเฉพาะอย่างยิ่งหากพวกเขาใช้ระบบ SAP ที่ใช้ Oracle หรือ Oracle ERP System

Oracle RAC คืออะไร

ซอฟต์แวร์การทำคลัสเตอร์ของ Oracle เรียกว่า Oracle Real Application Clusters (RAC) RAC "ช่วยให้คุณสามารถรวมเซิร์ฟเวอร์สินค้าโภคภัณฑ์ที่มีขนาดเล็กลงในคลัสเตอร์เพื่อสร้างสภาพแวดล้อมที่ปรับขนาดได้ซึ่งสนับสนุนแอปพลิเคชันทางธุรกิจที่สำคัญต่อภารกิจ"[1] ด้วย Oracle RAC คุณสามารถจัดคลัสเตอร์ฐานข้อมูล Oracle และใช้ Oracle Clusterware เพื่อเชื่อมต่อหลายเซิร์ฟเวอร์ เพื่อให้ทำงานเป็นระบบเดียว

ในขณะที่ RAC ถูกรวมเข้ากับ Oracle Database Standard Edition ก่อนหน้านี้ (โดยไม่มีค่าใช้จ่ายเพิ่มเติม) ตอนนี้ Oracle ได้นำคุณลักษณะ RAC ออกจาก Standard Edition จากเวอร์ชัน 19c เป็นต้นไป คุณสามารถซื้อ Oracle RAC ได้โดยมีค่าใช้จ่ายเพิ่มเติมด้วย Oracle Database Enterprise Edition น่าเสียดาย นี่หมายความว่าลูกค้าที่ต้องการใช้ RAC จะต้องอัปเกรดเป็น Oracle Database Enterprise หรือย้ายไปยัง Oracle Cloud ซึ่งทั้งสองวิธีนี้เป็นโซลูชันที่มีราคาแพงกว่า Standard Edition อย่างมาก

SIOS มอบโซลูชันการทำคลัสเตอร์ Oracle ที่มีความพร้อมใช้งานสูงโดยไม่ต้องอัปเกรดเป็น Enterprise Edition ซึ่งช่วยประหยัดค่าใช้จ่ายในการออกใบอนุญาตได้มากถึง 70 เปอร์เซ็นต์

SIOS Protection Suite สำหรับ Linux (Oracle Linux, Red Hat, SUSE)

ดิ SIOS Protection Suite สำหรับ Linux ให้การผสานรวมอย่างแน่นหนาของคลัสเตอร์เฟลโอเวอร์ที่มีความพร้อมใช้งานสูง การตรวจสอบแอปพลิเคชันอย่างต่อเนื่อง การจำลองข้อมูล และนโยบายการกู้คืนที่กำหนดค่าได้ ปกป้องฐานข้อมูล Oracle และแอปพลิเคชันของคุณจากการหยุดทำงานและภัยพิบัติ ไม่เหมือนกับโซลูชันการทำคลัสเตอร์อื่นๆ ที่ตรวจสอบเฉพาะการทำงานของเซิร์ฟเวอร์ SIOS LifeKeeper จะตรวจสอบความสมบูรณ์ของเซิร์ฟเวอร์ การเชื่อมต่อเครือข่าย ที่เก็บข้อมูล กระบวนการของ Oracle ทั้งหมด และแอปพลิเคชันที่เกี่ยวข้อง ปัญหาจะได้รับการแก้ไขทันทีด้วยชุดการดำเนินการที่กำหนดนโยบายเพื่อให้มั่นใจว่าจะกู้คืนได้อย่างรวดเร็วโดยไม่รบกวนผู้ใช้ปลายทาง

SIOS Protection Suite สามารถทำงานในสภาพแวดล้อมที่จัดเก็บข้อมูลที่ใช้ร่วมกัน (SAN) เพื่อรองรับคลัสเตอร์ HA แบบเดิม หรือในการกำหนดค่าพื้นที่จัดเก็บข้อมูลที่ไม่มีการแชร์ (SANless) ในระบบคลาวด์ ไฮบริด และสภาพแวดล้อมอื่นๆ ที่พื้นที่จัดเก็บข้อมูลที่ใช้ร่วมกันทำไม่ได้หรือเป็นไปไม่ได้ นำเสนอคลัสเตอร์ที่แข็งแกร่ง หลากหลาย และกำหนดค่าได้ง่าย พร้อมนโยบายการกู้คืนระบบเฟลโอเวอร์/เฟลแบ็คแบบอัตโนมัติและด้วยตนเองสำหรับฐานข้อมูลและแอปพลิเคชัน Oracle ของคุณ

SIOS Protection Suite สำหรับ Linux ประกอบด้วย:

  • SIOS LifeKeeper ซึ่งมีซอฟต์แวร์การจัดกลุ่มเฟลโอเวอร์ที่ยืดหยุ่นซึ่งตรวจสอบสแต็กแอปพลิเคชันทั้งหมด
  • SIOS DataKeeper ซึ่งให้การจำลองข้อมูลระดับบล็อกที่รวดเร็วและมีประสิทธิภาพสำหรับการมิเรอร์ที่เก็บข้อมูลในเครื่องในการกำหนดค่าคลัสเตอร์ SANless หรือการจำลองแบบไปยังตำแหน่งระยะไกลหรือระบบคลาวด์สำหรับการกู้คืนจากภัยพิบัติ
  • ชุดกู้คืนแอปพลิเคชัน (ARK) หลายชุดพร้อมการกำหนดค่าอัตโนมัติและเครื่องมือตรวจสอบความถูกต้องในผลิตภัณฑ์ เพื่อปกป้องแอปพลิเคชันและข้อมูลที่สำคัญต่อธุรกิจของคุณจากการหยุดทำงานและภัยพิบัติ

SIOS LifeKeeper รองรับการกระจาย Linux ที่สำคัญทั้งหมด รวมถึง Red Hat Enterprise Linux, SUSE Linux Enterprise Server, CentOS และ Oracle Linux และรองรับสถาปัตยกรรมการจัดเก็บข้อมูลที่หลากหลาย ซอฟต์แวร์ SIOS ได้รับการปรับและปรับให้เหมาะสมเพื่อให้ทำงานบนระบบปฏิบัติการเหล่านี้ และส่วนประกอบได้รับการทดสอบเพื่อให้แน่ใจว่าโซลูชันคลัสเตอร์ SANless จะทำงานในแต่ละระบบปฏิบัติการ

SIOS รองรับ Oracle Clustering ใน Cloud

ด้วย SIOS Protection Suite สำหรับ Linux คุณสามารถเรียกใช้แอปพลิเคชัน Oracle ของคุณในสภาพแวดล้อมคลาวด์สาธารณะที่ยืดหยุ่นและปรับขนาดได้ เช่น Amazon Web Services (AWS) หรือ Microsoft Azure โดยไม่ต้องล็อกอินจากผู้ขายหรือลดประสิทธิภาพการทำงาน ความพร้อมใช้งานสูง หรือการป้องกันภัยพิบัติ .

SIOS Protection Suite สำหรับ Linux บน AWS หรือ Azure มีองค์ประกอบที่คุณต้องการเพื่อสร้างคลัสเตอร์ Linux ที่มีความพร้อมใช้งานสูงทั่วทั้ง Fault Domains บนระบบคลาวด์และ Availability Zone ที่ให้คุณแยกพื้นที่ทางภูมิศาสตร์สำหรับการป้องกันจากภัยพิบัติและการหยุดทำงานทั่วทั้งไซต์และระดับภูมิภาค

ในสภาพแวดล้อม Windows Server Failover Clustering (WSFC) คุณสามารถใช้ SIOS DataKeeper Cluster Edition เพื่อซิงโครไนซ์ที่เก็บข้อมูลในเครื่องโดยใช้การจำลองแบบโฮสต์ที่มีประสิทธิภาพสำหรับการทำคลัสเตอร์ SANlessSIOS DataKeeper Cluster Edition ซอฟต์แวร์ปกป้องสภาพแวดล้อม Windows ที่มีความสำคัญต่อธุรกิจของคุณ รวมถึง Oracle จากการหยุดทำงานและการสูญหายของข้อมูล

SIOS รองรับ Oracle Clustering ในสภาพแวดล้อมเสมือน

ซอฟต์แวร์คลัสเตอร์ SIOS SANless ให้ความพร้อมใช้งาน ความน่าเชื่อถือ และความยืดหยุ่นสูงระดับองค์กรที่จำเป็นสำหรับฐานข้อมูลและแอปพลิเคชัน Oracle เมื่อทำงานในสภาพแวดล้อม VMware, Hyper-V, KVM และ XenServer

SIOS Protection Suite สำหรับ Linux ปกป้องฐานข้อมูล Oracle และแอปพลิเคชันที่ทำงานบน Linux ในสภาพแวดล้อมเสมือน หากคุณใช้งาน Oracle บน Windows ในสภาพแวดล้อมเสมือน SIOS DataKeeper Cluster Edition จะปกป้องสภาพแวดล้อม Windows ที่มีความสำคัญต่อธุรกิจของคุณ รวมถึงฐานข้อมูลและแอปพลิเคชัน Oracle ของคุณ

SIOS เสนอการจำลองข้อมูลแบบบูรณาการ ความพร้อมใช้งานสูง การจัดกลุ่มและ การกู้คืนระบบ โซลูชันที่สนับสนุน Oracle บนทั้ง Linux และ Windows เพื่อให้การป้องกันแบบยืดหยุ่นต่อข้อผิดพลาดสำหรับองค์กรขนาดเล็กและขนาดใหญ่ โดยมีค่าใช้จ่ายเพียงเล็กน้อยเมื่อเทียบกับโซลูชันการทำคลัสเตอร์ของ Oracle อื่นๆ ด้วยคลัสเตอร์ SIOS SANless คุณไม่จำเป็นต้องมีที่จัดเก็บข้อมูลที่ใช้ร่วมกันที่มีราคาแพง เพื่อให้ได้แอปพลิเคชันที่มีความพร้อมใช้งานสูงและการปกป้องฐานข้อมูลอย่างเต็มรูปแบบ แต่คุณสามารถเรียกใช้ฐานข้อมูลและแอปพลิเคชัน Oracle ในระบบคลาวด์ที่ไม่มี SAN ได้และ SIOS สามารถปกป้องฐานข้อมูล Oracle และแอปพลิเคชันของคุณภายในองค์กรและในสภาพแวดล้อมเสมือนและไฮบริดได้เช่นกัน

สำหรับข้อมูลเพิ่มเติมเกี่ยวกับวิธีที่ SIOS สามารถปกป้องฐานข้อมูลและแอปพลิเคชัน Oracle ของคุณ คลิกที่นี่หรือเดโมส่วนตัว .

[1]https://docs.oracle.com/cd/B28359_01/rac.111/b28254/admcon.htm#RACAD7148 ทำซ้ำโดยได้รับอนุญาตจาก SIOS

Filed Under: ทำให้เข้าใจง่ายเซิร์ฟเวอร์คลัสเตอร์

  • « Previous Page
  • 1
  • …
  • 53
  • 54
  • 55
  • 56
  • 57
  • …
  • 112
  • Next Page »

โพสต์ล่าสุด

  • ระบบความพร้อมใช้งานสูง (High Availability หรือ HA) คืออะไร?
  • เอาตัวรอดจากวิกฤตการณ์วันศุกร์: จากระบบคอมพิวเตอร์แบบดิบๆ สู่การจำลองข้อมูลที่ราบรื่น
  • ติดดิน: สิ่งที่การพลาดชม Percona Live Amsterdam สอนฉันเกี่ยวกับ HA
  • เปรียบเทียบ SIOS LifeKeeper กับ Red Hat High Availability Add-On:
  • สถานะของความยืดหยุ่นของแอปพลิเคชัน: ผลสำรวจความพร้อมใช้งานสูงของ SIOS ปี 2026

กระทู้ยอดนิยม

เข้าร่วมรายชื่อผู้รับจดหมายของเรา

Copyright © 2026 · Enterprise Pro Theme on Genesis Framework · WordPress · Log in