SIOS SANless clusters

SIOS SANless clusters High-availability Machine Learning monitoring

  • Home
  • 제작품
    • SIOS DataKeeper for Windows
    • SIOS Protection Suite for Linux
  • 뉴스 및 이벤트
  • 서버 클러스터 단순화
  • 성공 사례
  • 저희에 게 연락
  • English
  • 中文 (中国)
  • 中文 (台灣)
  • 한국어
  • Bahasa Indonesia
  • ไทย

오픈 소스 고 가용성을 사용하는 경우 팀에 필요한 7 가지 기술

3월 31, 2021 by Jason Aw Leave a Comment

오픈 소스 고 가용성을 사용하는 경우 팀에 필요한 7 가지 기술

오픈 소스 고 가용성을 사용하는 경우 팀에 필요한 7 가지 기술

고 가용성 (HA) 영역에는 오픈 소스 경로로 이동하기로 결정한 경우 팀에 필요한 특정 중요한 기술이 있습니다. 정의에 의한 오픈 소스는 자유롭게 사용할 수있는 소프트웨어를 의미합니다.

오늘날 Microsoft 및 SIOS Technology Corp와 같은 공급 업체에서 제공하는 많은 운영 체제에 대한 고 가용성 클러스터의 상용 구현이 많이 있습니다. 이러한 상용 솔루션은 리소스 모니터링, 종속성 관리, 장애 조치 및 클러스터 정책, 그리고 사전 패키지 및 가격이 책정 된 관리 형태를 제공합니다.상업적 구현에 대한 대안은 기업에 고 가용성을 제공 할 수있는 기회를 기업에 제공하는 몇 가지 오픈 소스 옵션입니다.

기업들이 계속해서 최적화, 비용 절감 및 더 엄격한 통제를 추구함에 따라 점점 더 많은 기업과 고객이 오픈 소스 가용성 솔루션으로의 전환을 고려하고 있습니다.

다음은 팀이 오픈 소스 HA로 전환하는 데 필요할 수있는 7 가지 기술입니다.

1. 코딩 기술

대부분의 경우 엔터프라이즈 애플리케이션에 대한 사전 패키지 및 번들 지원이 없다는 것은 팀이 구성 요소를 보호하고 번들 구성 요소로 문제를 해결하거나 애플리케이션 인식이 제대로 처리되도록 애플리케이션 커넥터를 작성하는 솔루션을 개발할 수 있어야한다는 것을 의미합니다.많은 사람들이 스크립트를 작성할 수 있지만 팀은 건전한 개발 관행과 표준을 만들고 준수하는 방법을 알아야합니다.이것의 기본은 다음과 같습니다.

  • 설계 및 아키텍처 요구 사항
  • 디자인 리뷰
  • 코드 / 코드 검토 및 단위 테스트 (가급적 자동화)

2. 기술 환경에 대한 지식

많은 엔터프라이즈 응용 프로그램은 SLA (서비스 수준 계약) 및 SLO (서비스 수준 목표)를 충족하는 고 가용성을 제공하기 위해 여러 시스템과의 통합이 필요합니다.팀은 여러 엔터프라이즈 시스템과의 통합을위한 보호 및 솔루션을 구축하기 위해 기술 환경에 대한 심층적 인 애플리케이션 인식과 지식이 필요합니다.중요한 응용 프로그램, 해당 응용 프로그램의 기술 환경, 네트워킹, 하드웨어, 하이퍼 바이저, 환경 및 응용 프로그램 종속성을 이해하는 사람이 필요합니다.또한 오픈 소스 커뮤니티에서 사용하려는 HA 기술 집합의 아키텍처, 기능 및 제한 사항을 이해하는 팀 구성원이 필요합니다. 팀이 다음 영역을 얼마나 알고 이해하는지 고려하십시오.

  • 데이터 전달 및 노드 통신
  • 노드 실패
  • 응용 관리
  • 시스템 복구 및 다시 시작
  • 로깅 및 메시지
  • 데이터 복원력 및 보호

3. 비즈니스 프로세스 지식

비즈니스 요구 사항과 비즈니스 프로세스를 이해할 수있는 사람이 필요합니다.팀에는 기업의 비즈니스와이를 추진하는 프로세스를 이해하는 전문가가 필요합니다.팀은 솔루션 개발에 사용할 수있는 예산의 양, 비즈니스가 감수 할 수있는 위험의 정도, 말하지 않거나 지정되지 않은 추가 요구 사항을 수집하는 방법을 알고 이해해야합니다.

또한 팀은 이러한 비즈니스 요구 사항을 소프트웨어 요구 사항으로 변환하는 방법과 비즈니스 요구 사항을 충족하는 최소 실행 가능한 고 가용성 솔루션을 실현하는 프로세스를 관리하는 방법을 알고 있거나이를 고용해야합니다. 비즈니스 프로세스에 적합합니다.

4. OS, 애플리케이션 및 인프라 경험

모든 것을 개방하려는 경우 팀은 운영 체제, 애플리케이션 및 인프라를 이해 한 경험이 필요합니다.Linux 용 커널 버전, Windows 용 업데이트 및 핫픽스를 포함하여 다양한 OS 출시주기를 이해해야합니다.지원해야하는 애플리케이션이 사내에 있지만 애플리케이션 업데이트주기, 종속성, 애플리케이션과 OS 지원 매트릭스의 교차점을 이해하기 위해 부지런히 노력해야합니다.환경이 균질하다면 훌륭합니다.그렇지 않으면 팀이 RHEL, RHEL 파생 제품 및 SUSE의 차이점을 알아야합니다.Linux와 Windows 모두라면 이것도 알아야합니다.또한 인프라가 애플리케이션과 OS 조합에 미치는 차이를 이해해야합니다.AWS 및 Azure는 GCP, 온 프레미스 및 기타 하이퍼 바이저와 다른 고 가용성의 차이점을 나타냅니다.

5. 변경 관리 기능

OS, 인프라 및 애플리케이션에 대한 확고한 이해와 함께 기술 및 비즈니스 지식을 갖춘 솔루션을 개발할 개발 팀이 있다고 상상해보십시오.그러나 스크립트를 모으는 것은 시작에 불과합니다.팀에도 변경 관리 기능이 필요합니다.팀은 코드 변경 및 버전, 패키지 및 패키지 위치를 어떻게 추적합니까?팀은 업데이트 및 변경 릴리스를 어떻게 관리합니까?팀은 git과 같은 소스 리포지토리, Jira와 같은 프로젝트 관리 도구 및 릴리스 교육 숙련도에 정통해야합니다.원치 않는 영향을 피하면서 코드를 업데이트하고 패치 및 수정을 제공하는 방법을 이해하는 팀이 필요합니다.

6. 데이터 분석 및 문제 해결 경험

자체 HA 솔루션을 제공하는 공간에 들어가면 팀은 분석 및 문제 해결 경험이 필요합니다.애플리케이션 코드, 시스템 메시지, 애플리케이션 오류 로그 및 추적 파일의 교차점을 이해하는 리소스가 필요합니다.시스템 충돌이 발생하면 로그를 더 자세히 조사하여 문제를 해결하고 근본 원인을 찾고 데이터를 분석하여 권장 사항을 만들고 변경 사항을 배포 할 준비를해야합니다 (위의 # 5 참조).또한 팀은 오류, 실패 또는 시스템 충돌이없는 경우에도 이러한 로그 및 추적 파일의 데이터가 환경 상태에 대해 알려줄 수있는 데이터를 알고 이해해야합니다.

7. 연결 (개발자, QA, 파트너, 커뮤니티)

솔직히 말해서 여러분의 비즈니스는 고 가용성을 제공하는 것이 아니라 오픈 소스 HA 영역에 뛰어 들기로 결정한 경우 팀의 뛰어난 능력보다 더 많은 도움이 필요할 것입니다.추가 도움을 얻는 열쇠는 어디서부터 시작해야하는지 이해 한 다음 커뮤니티 개발자, 테스트 전문가, HA 및 애플리케이션 파트너, 오픈 소스 커뮤니티와 올바른 연결을 만드는 것입니다.공개 포럼은 정말 도움이되었지만 응답 시간이 SLA 및 SLO를 준수하는지 다시 확인해야합니다.

오픈 소스 솔루션을 사용하는 것은 많은 기업이 비용 문제와 유연성, 비용 절감 및 위험 감소에 대한 인식을 추구하기 위해 선택하는 옵션입니다.그러나 구매자는 새로운 기술 및 관리의 형태로 숨겨진 비용이있을 수 있으며 사용하는 오픈 소스 프로그램의 관점에서 "자신의 HA 솔루션 롤"에 필요한 숨겨진 위험이있을 수 있습니다.

– Cassius Rhue, VP, 고객 경험

SIOS에서 재현
Filed Under: 서버 클러스터 단순화 Tagged With: 리눅스

Linux 환경에서 SQL Server에 대한 고 가용성을 제공하는 방법

9월 10, 2020 by Jason Aw Leave a Comment

Linux 환경에서 SQL Server에 대한 고 가용성을 제공하는 방법

Linux 환경에서 SQL Server에 대한 고 가용성을 제공하는 방법

조직이 Linux에서 업무상 중요한 Microsoft SQL Server를 실행하는 경우 IT 팀은 의심 할 여지없이 고 가용성, 성능 및 보안을 지속적으로 유지 관리하는 것이 얼마나 어려운지 알고 있습니다. 특히 어려운 것은 강력한 복제 및 자동 장애 조치로 고 가용성을 보장하는 방법입니다. 오픈 소스 소프트웨어와 쉽게 구성 할 수있는 HA SANless 클러스터 솔루션을 사용하면 조직에 필요한 안전과 성능을 희생하지 않고도보다 간단한 유지 관리 방식을 제공 할 수 있습니다.

Linux에 대한 제한된 고 가용성 옵션

대부분의 Linux 배포판은 IT 부서에 고 가용성을위한 두 가지 열등한 선택을 제공합니다. SQL Server Enterprise Edition에 Always On 가용성 그룹을 구현하는 데 더 많은 비용을 지불하거나 복잡한 DIY HA Linux 구성이 제대로 작동하도록하는 데 어려움을 겪는 것입니다. 하기 어렵다.

Enterprise Edition 사용의 문제점은 상용 하드웨어에서 오픈 소스 운영 체제를 사용하기위한 비용 절감 전략을 약화 시킨다는 것입니다. 제한된 수의 소규모 SQL Server 응용 프로그램의 경우 추가 비용을 정당화 할 수 있습니다. 그러나 많은 데이터베이스 애플리케이션에 비해 너무 비싸고 Linux 용 범용 HA를 제공하는 데 아무 일도하지 않습니다.

Pacemaker 및 Corosync 또는 SUSE Linux Enterprise High Availability Extension과 같은 오픈 소스 소프트웨어를 사용하여 Linux 환경에서 실행되는 모든 애플리케이션에 HA를 제공 할 수 있습니다. 그러나 전체 소프트웨어 스택이 원하는대로 작동하려면 각 응용 프로그램에 대한 사용자 지정 스크립트를 만들고 테스트해야하며 이러한 스크립트는 사용중인 소프트웨어 나 하드웨어를 약간 변경 한 후에도 종종 다시 테스트하고 업데이트해야합니다. SQL Server Standard Edition과 Linux 모두에서 지원되지 않는 가용성 관련 기능은 이러한 노력을 더욱 어렵게 만들 수 있습니다.

Linux에서 SQL Server를위한 대체 고 가용성 솔루션 찾기

HA를 비용 효율적이고 쉽게 구현하기 위해 두 가지 다른 범용 접근 방식을 고려할 수 있습니다.

하나는 중복되고 탄력적 인 SAN (Storage Area Network) 내에서 데이터를 복제하여 데이터를 보호하는 스토리지 기반 시스템을 사용하는 것입니다. 이 접근 방식은 호스트 운영 체제와 관련이 없지만 전체 SAN 인프라를 단일 공급 업체로부터 확보해야하며 고 가용성을 제공하기 위해 별도의 장애 조치 프로비저닝에 의존해야합니다.

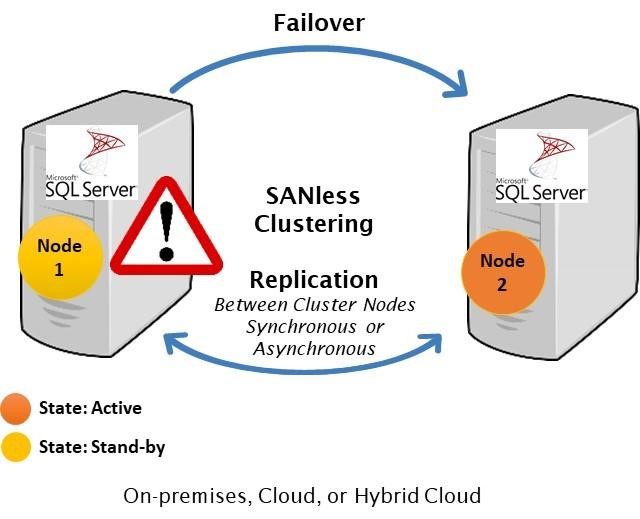
다른 접근 방식은 호스트 기반이며 Linux 서버 인스턴스에서 스토리지에 구애받지 않는 SANless 클러스터를 만드는 것입니다. HA 오버레이로서 이러한 클러스터는 사설, 공용 및 하이브리드 클라우드의 LAN과 WAN 모두에서 작동 할 수 있습니다. 또한 오버레이는 애플리케이션에 구애받지 않으므로 조직이 모든 애플리케이션에서 단일 범용 HA 솔루션을 가질 수 있습니다. 이 접근 방식은 호스트 리소스를 소비하지만 비교적 저렴하고 Linux 환경에서 쉽게 확장 할 수 있습니다.

대부분의 HA SANless 클러스터 옵션은 실시간 블록 수준 데이터 복제, 지속적인 애플리케이션 모니터링, 구성 가능한 장애 조치 / 장애 복구 정책의 조합을 제공하여 Standard Edition에서 사용할 수있는 Always On 장애 조치 클러스터 인스턴스를 사용하는 애플리케이션을 포함하여 모든 비즈니스 크리티컬 애플리케이션을 보호합니다. SQL Server의.

SIOS Technology Corp.는 컴퓨팅 인프라를 지원하고 최적화하는 복잡성과 일상적인 문제에서 IT를 해방하도록 설계된 고급 기능을 갖춘 Linux 용보다 강력한 HA SANless 클러스터 솔루션을 제공합니다. LifeKeeper가 포함 된 SIOS Protection Suite 솔루션은 다음을 제공합니다.

  • 전체 Linux 애플리케이션 스택에 대한 지속적인 모니터링
  • 복잡한 애플리케이션 및 데이터베이스의 빠르고 안전한 복구 또는 페일 오버를위한 애플리케이션 복구 키트 (ARK)로 완벽한 애플리케이션 인식 보호
  • Linux 클러스터링을위한 마법사 기반 설정
  • 기존 공유 스토리지 클러스터 또는 소프트웨어를 사용하여 SANless 클러스터 구성에서 로컬 스토리지를 동기화하는 것과 같은 구성 유연성

예를 들어 SANless 클러스터는 두 개의 동시 오류를 처리 할 수 있습니다. 기본 작동은 LAN 및 WAN뿐만 아니라 사설, 공용 및 하이브리드 클라우드에서 동일합니다.

일반적인 2 노드 클러스터에서 서버 # 1은 처음에 데이터를 서버 #에 복제하는 기본 서버입니다. 문제가 발생하여 이제 기본 서버가되는 서버 # 2에 대한 장애 조치가 자동으로 트리거됩니다.

이 상황에서 IT 부서는 서버 # 1의 장애를 유발 한 모든 문제를 진단하고 수리하기 시작할 것입니다. 일단 수정되면 주 서버 또는 서버 # 2가 해당 용량에서 계속해서 데이터를 서버 # 1에 복제 할 수 있으므로 인계 될 수 있습니다.

대부분의 HA SANless 클러스터링 구성에서 장애 조치는 자동이며 브라우저 기반 콘솔에서 장애 조치와 장애 복구를 모두 제어 할 수 있습니다.

SIOS LifeKeeper 및 Protection Suite 솔루션에 대한 자세한 내용은 클러스터 서버 환경 용 SIOS SAN 및 SANless 고 가용성 클러스터를 참조하세요.

SIOS의 허가를 받아 복제

Filed Under: 서버 클러스터 단순화 Tagged With: 리눅스

단계별 : Amazon EC2에서 SANless MySQL Linux 장애 조치 클러스터를 구성하는 방법

8월 18, 2020 by Jason Aw Leave a Comment

단계별 : Amazon EC2에서 SANless MySQL Linux 장애 조치 클러스터를 구성하는 방법

단계별 : Amazon EC2에서 SANless MySQL Linux 장애 조치 클러스터를 구성하는 방법

이 단계별 가이드에서는 Amazon의 Elastic Compute Cloud (Amazon EC2)에서 고 가용성 2 노드 MySQL 클러스터 (감시 서버 포함)를 구성하는 데 필요한 모든 단계를 안내합니다. 가이드에는 스크린 샷, 셸 명령 및 코드 조각이 모두 포함되어 있습니다. Amazon EC2에 어느 정도 익숙하고 이미 계정이 있다고 가정합니다. 그렇지 않은 경우 오늘 가입 할 수 있습니다. 또한 Linux 시스템 관리 및 가상 IP 등과 같은 장애 조치 클러스터링 개념에 대한 기본적인 지식이 있다고 가정하겠습니다.

장애 조치 클러스터링은 수년 동안 사용되어 왔습니다. 일반적인 구성에서는 두 개 이상의 노드가 공유 스토리지로 구성되어 기본 노드에서 장애 조치가 발생할 경우 보조 또는 대상 노드가 최신 데이터에 액세스 할 수 있습니다. 공유 스토리지를 사용하면 거의 0에 가까운 복구 지점 목표가 가능할뿐만 아니라 대부분의 클러스터링 소프트웨어에 대한 필수 요구 사항입니다. 그러나 공유 스토리지에는 몇 가지 문제가 있습니다. 첫째, 단일 장애 지점 위험입니다. 공유 스토리지 (일반적으로 SAN)가 실패하면 클러스터의 모든 노드가 실패합니다. 둘째, SAN은 비용이 많이 들고 구매, 설정 및 관리가 복잡 할 수 있습니다. 셋째, Amazon EC2를 포함한 퍼블릭 클라우드의 공유 스토리지는 고 가용성 (99.99 % 가동 시간), 거의 제로에 가까운 복구 시간 및 복구 지점 목표, 재해 복구 보호를 유지하려는 회사에게는 불가능하거나 실용적이지 않습니다.

다음은 엄격한 HA / DR SLA를 충족하면서 이러한 문제를 제거하기 위해 클라우드에서 SANless 클러스터를 생성하는 것이 얼마나 쉬운 지 보여줍니다. 아래 단계에서는 Amazon EC2와 함께 MySQL 데이터베이스를 사용하지만 SQL, SAP, Oracle 또는 기타 애플리케이션을 보호하기 위해 AWS에서 2 노드 클러스터를 생성하는 데 동일한 단계를 적용 할 수 있습니다.

참고 : 기능, 화면 및 버튼보기는 아래에 제시된 스크린 샷과 약간 다를 수 있습니다.

1. Virtual Private Cloud (VPC) 생성
2. 인터넷 게이트웨이 생성
삼. 서브넷 생성 (가용 영역)
4. 라우팅 테이블 구성
5. 보안 그룹 구성
6. 인스턴스 시작
7. 탄력적 IP 생성
8. 가상 IP에 대한 경로 항목 생성
9. ENI에 대한 소스 / 대상 확인 비활성화
10. 액세스 키 ID 및 보안 액세스 키 얻기
11. Linux OS 구성
12. EC2 API 도구 설치
13. MySQL 설치 및 구성
14. 클러스터 설치 및 구성
15. 클러스터 연결 테스트

개요

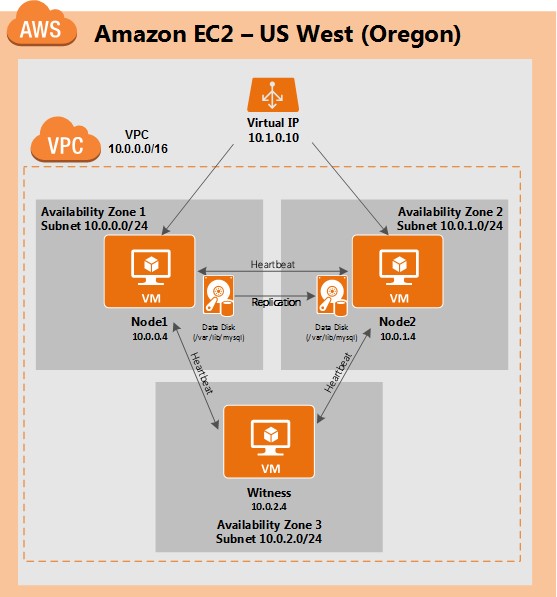
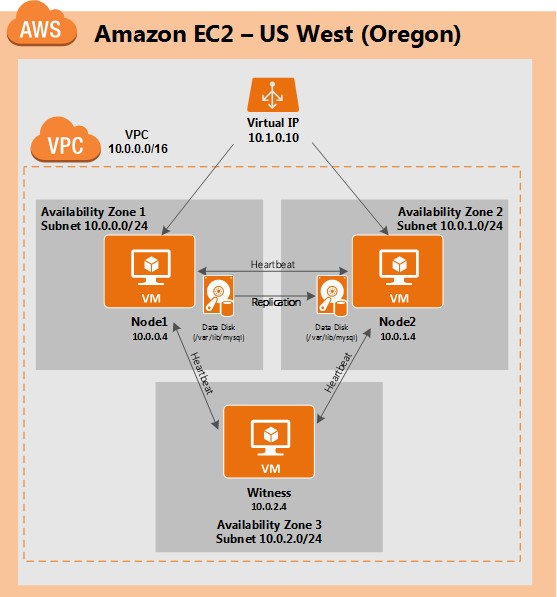
이 문서에서는 단일 Amazon EC2 리전 내에서 클러스터를 생성하는 방법을 설명합니다. 클러스터 노드 (node1, node2 및 감시 서버)는 최대 가용성을 위해 서로 다른 가용성 영역에 상주합니다. 이는 또한 노드가 다른 서브넷에 있음을 의미합니다.

다음 IP 주소가 사용됩니다.

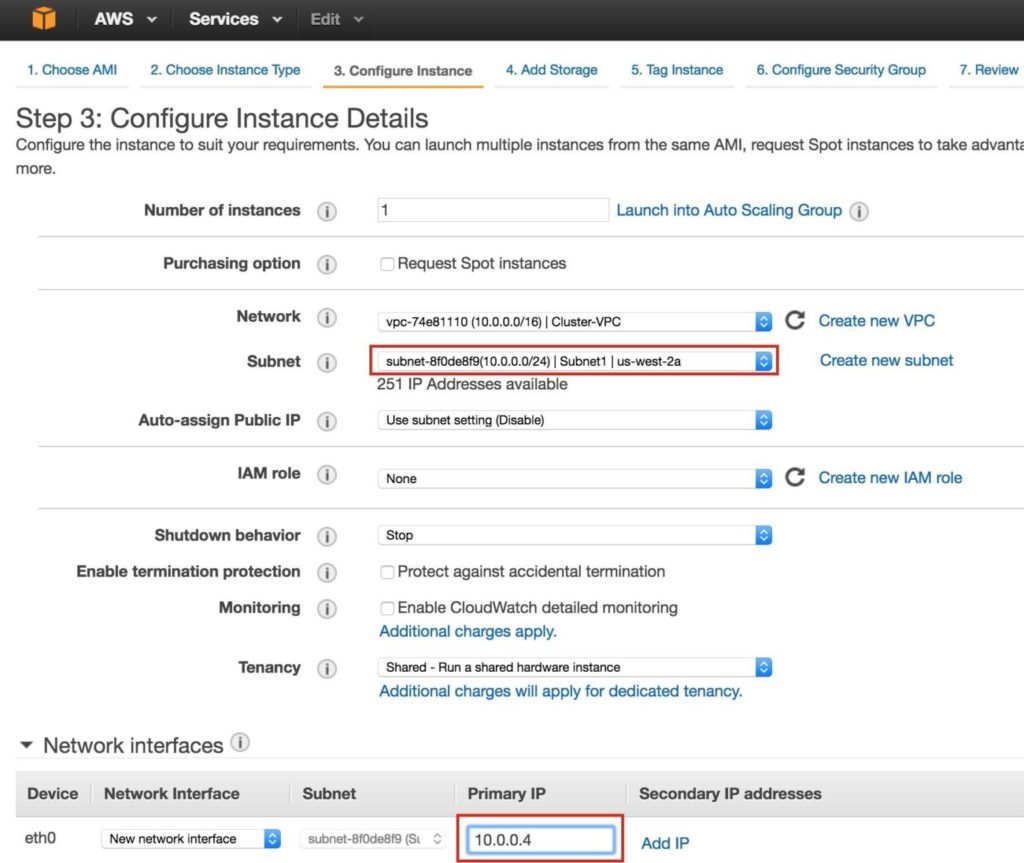
  • node1 : 10.0.0.4
  • node2 : 10.0.1.4
  • 증인 : 10.0.2.4
  • 가상 / "부동"IP : 10.1.0.10

1 단계 : Virtual Private Cloud (VPC) 생성

먼저 Virtual Private Cloud (VPC라고도 함)를 만듭니다. VPC는 전용 Amazon 클라우드 내의 격리 된 네트워크입니다. IP 주소 블록 및 서브넷, 라우팅 테이블, 보안 그룹 (예 : 방화벽) 등을 완벽하게 제어 할 수 있습니다. 가상 네트워크에 Azure Iaas VM (가상 머신)을 시작합니다.

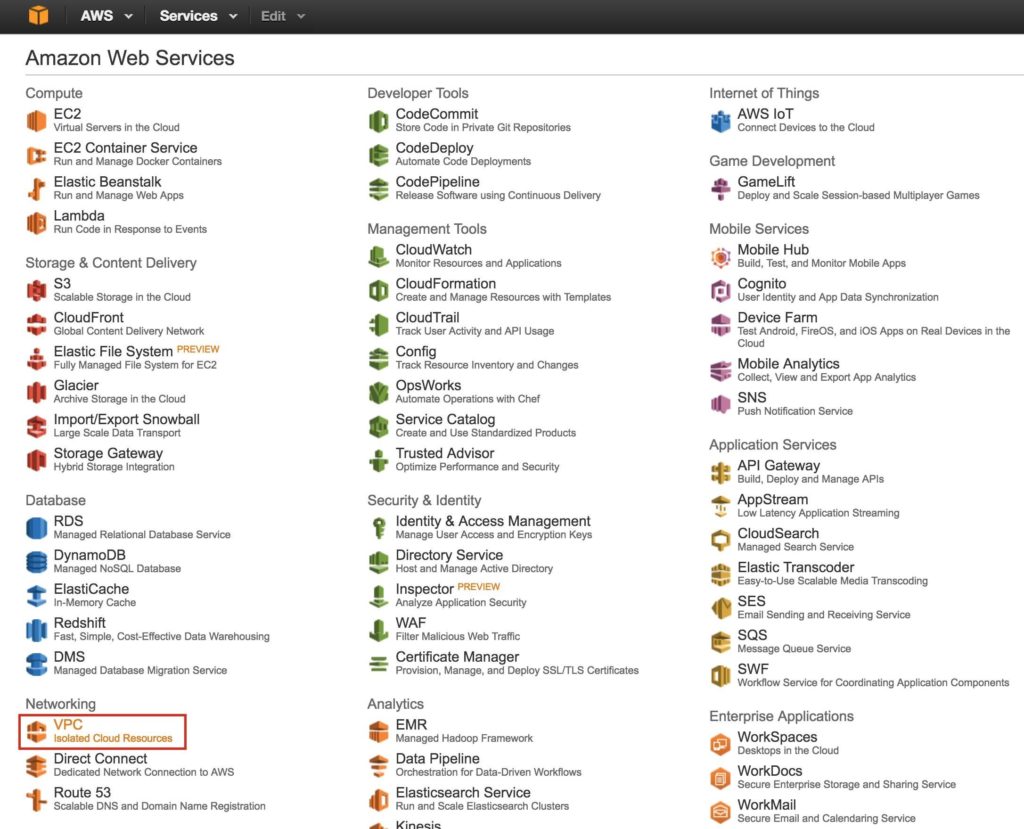
기본 AWS 대시 보드에서 "VPC"를 선택합니다.

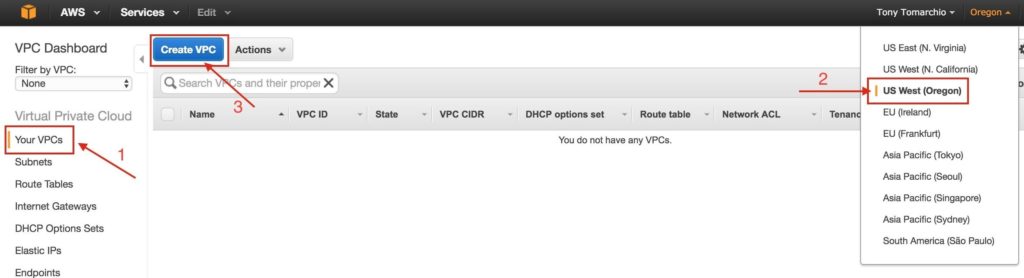
"Your VPCs"아래에서 화면 오른쪽 상단에서 적절한 지역을 선택했는지 확인합니다. 이 가이드에서는 3 개의 가용 영역이있는 리전이므로 "미국 서부 (오레곤)"리전이 사용됩니다. 지역 및 가용 영역에 대한 자세한 내용을 보려면 여기를 클릭하세요.

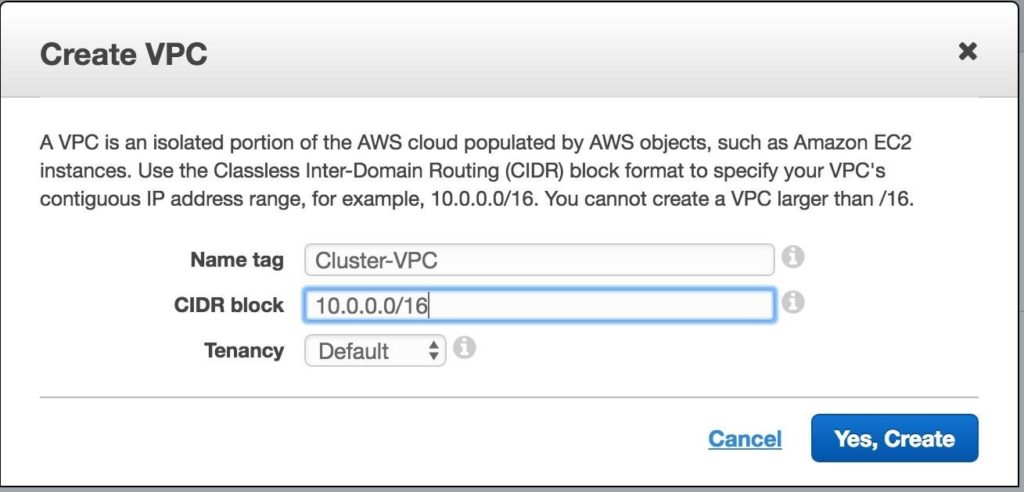
VPC에 이름을 지정하고 사용할 IP 블록을 지정합니다. 이 가이드에서는 10.0.0.0/16이 사용됩니다.

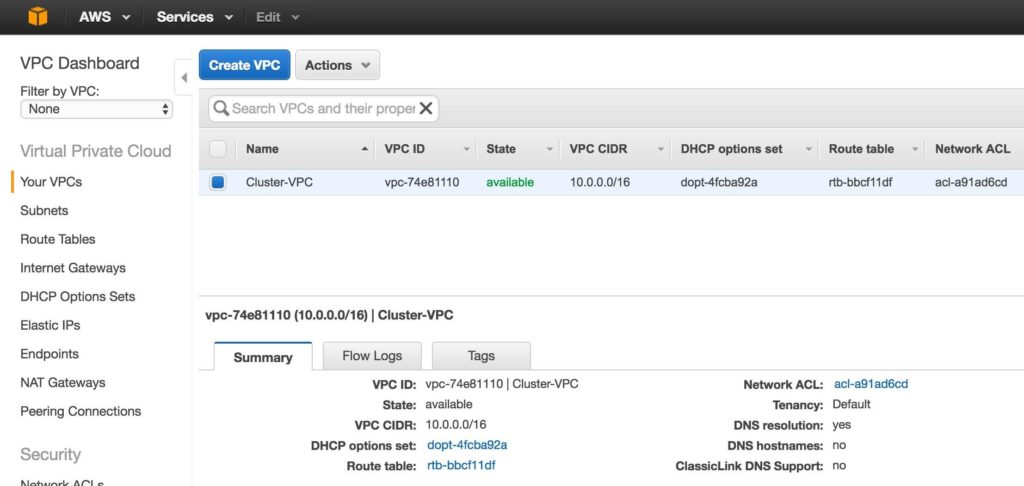
이제“Your VPCs”화면에 새로 생성 된 VPC가 표시됩니다.

2 단계 : 인터넷 게이트웨이 생성

다음으로 인터넷 게이트웨이를 만듭니다. 인스턴스 (VM)가 인터넷과 통신 할 수 있도록하려는 경우 필요합니다.

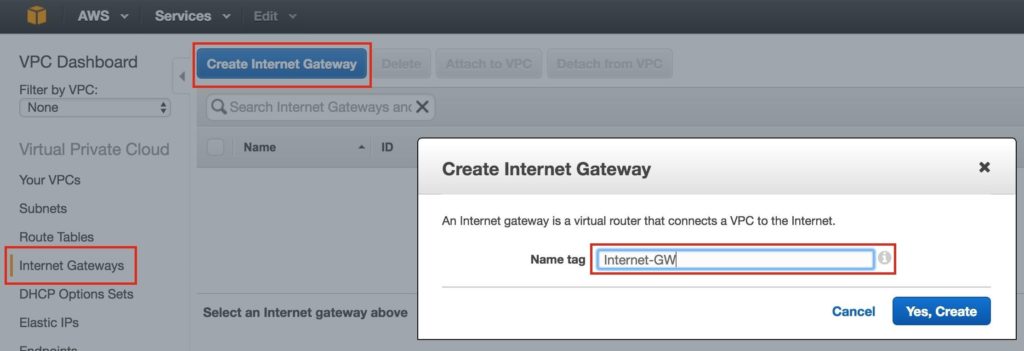
왼쪽 메뉴에서 인터넷 게이트웨이를 선택하고 인터넷 게이트웨이 만들기 버튼을 클릭합니다. 이름을 지정하고 다음을 만듭니다.

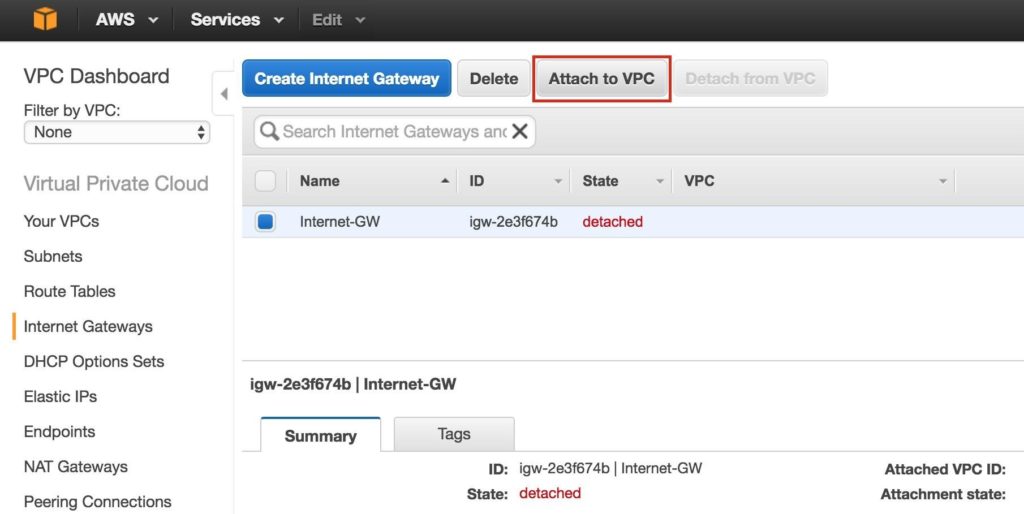
다음으로 인터넷 게이트웨이를 VPC에 연결합니다.

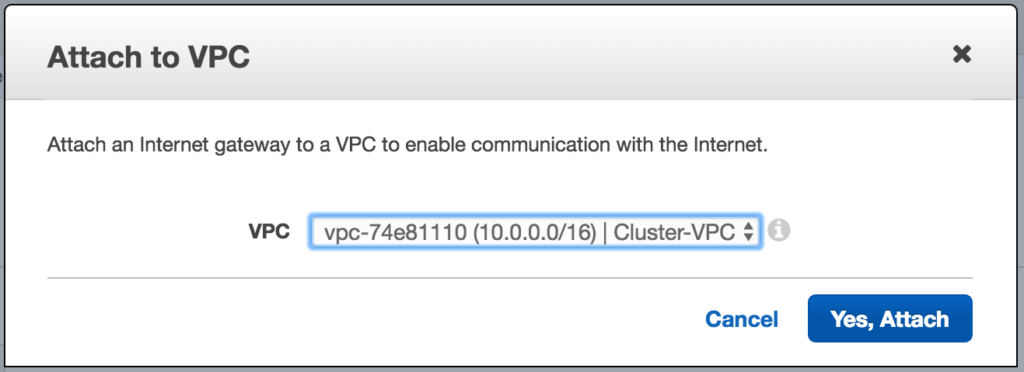
VPC를 선택하고 연결을 클릭합니다.


3 단계 : 서브넷 생성 (가용 영역)

다음으로 서브넷 3 개를 만듭니다. 각 서브넷은 자체 가용 영역에 상주합니다. 3 개의 인스턴스 (VM : node1, node2, 감시)는 별도의 서브넷 (따라서 가용 영역)으로 시작되므로 가용 영역의 장애로 인해 클러스터의 여러 노드가 제거되지 않습니다.

미국 서부 (오레곤) 리전 인 us-west-2에는 3 개의 가용성 영역 (us-west-2a, us-west-2b, us-west-2c)이 있습니다. 3 개의 가용성 영역 각각에 하나씩 3 개의 서브넷을 만듭니다.

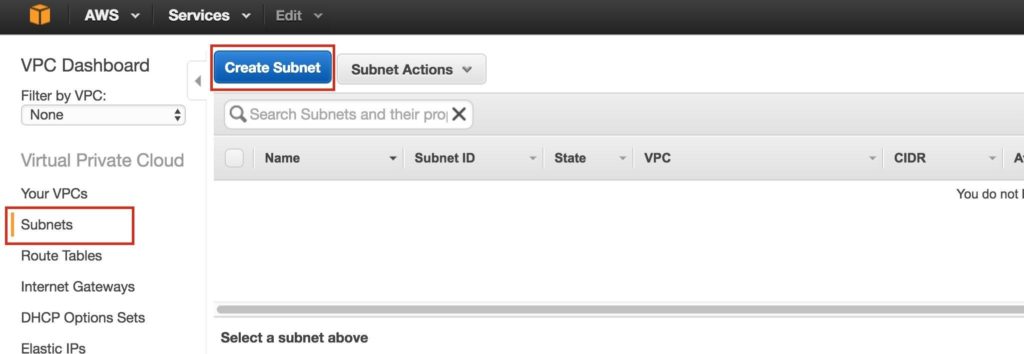
VPC 대시 보드에서 서브넷으로 이동 한 다음 서브넷 생성 :

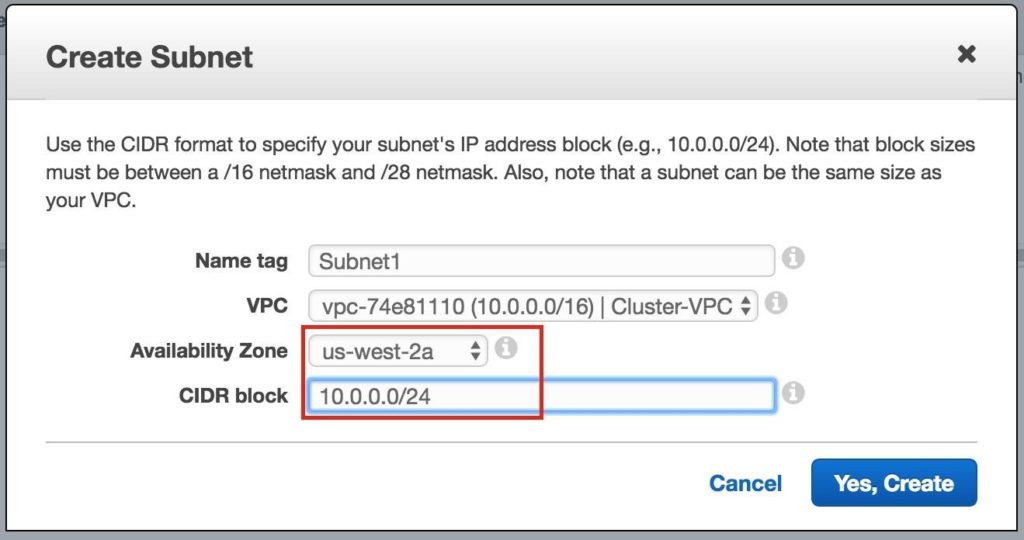
첫 번째 서브넷에 이름 (“Subnet1)”을 지정하고 가용성 영역 us-west-2a를 선택한 다음 네트워크 블록 (10.0.0.0/24)을 정의합니다.

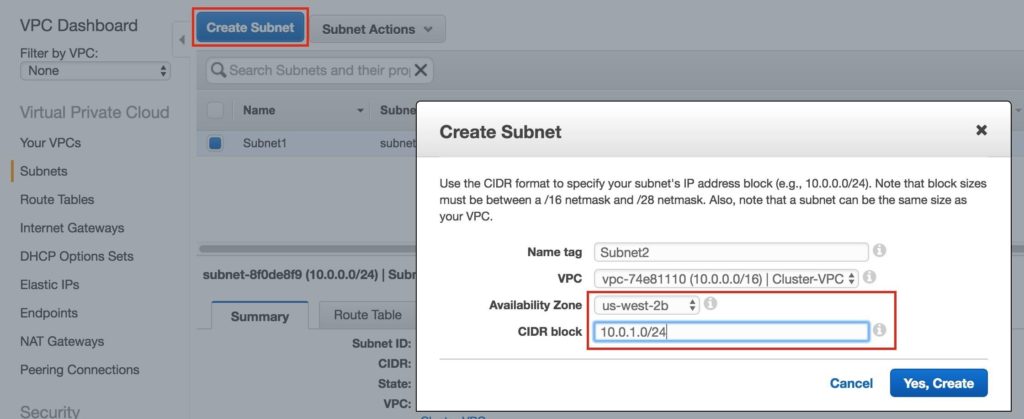
두 번째 서브넷 가용성 영역 us-west-2b를 생성하려면 반복합니다.

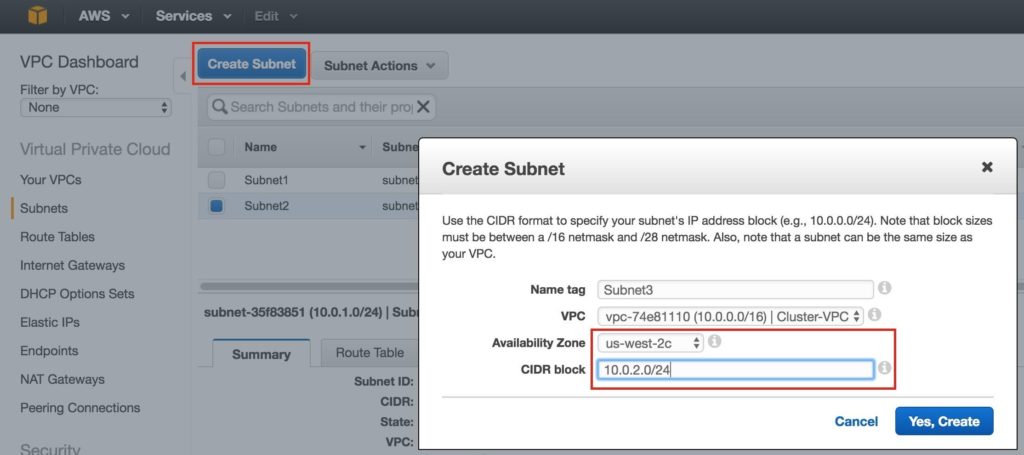
us-west-2c 가용성 영역에 세 번째 서브넷을 생성하려면 반복합니다.

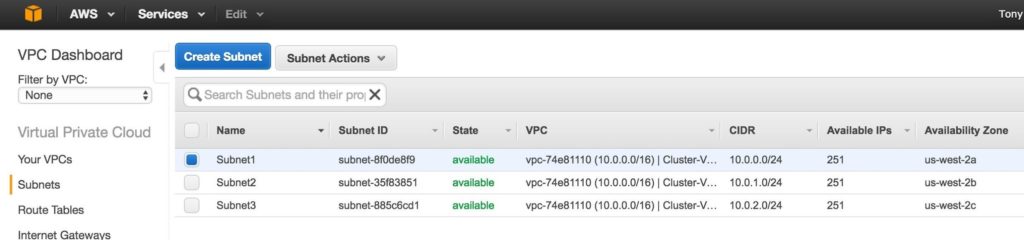
완료되면 아래에 표시된대로 각각 다른 CIDR 블록과 별도의 가용 영역에 3 개의 서브넷이 생성되었는지 확인합니다.

4 단계 : 라우팅 테이블 구성

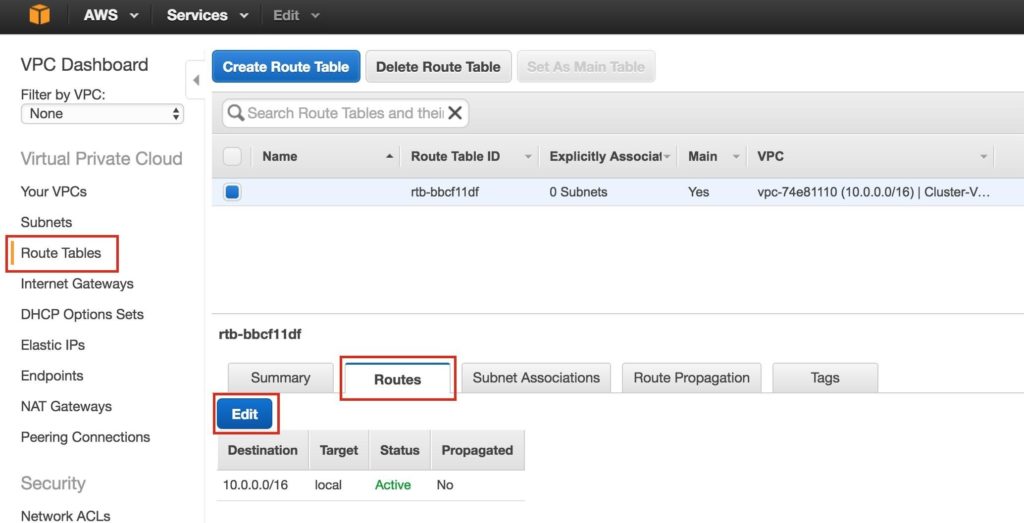
외부로의 트래픽이 이전 단계에서 만든 인터넷 게이트웨이로 전송되도록 VPC의 라우팅 테이블을 업데이트합니다. VPC 대시 보드에서 라우팅 테이블을 선택합니다. Routes 탭으로 이동하면 기본적으로 VPC 내에서만 트래픽을 허용하는 하나의 경로 만 존재합니다.

편집을 클릭하십시오.

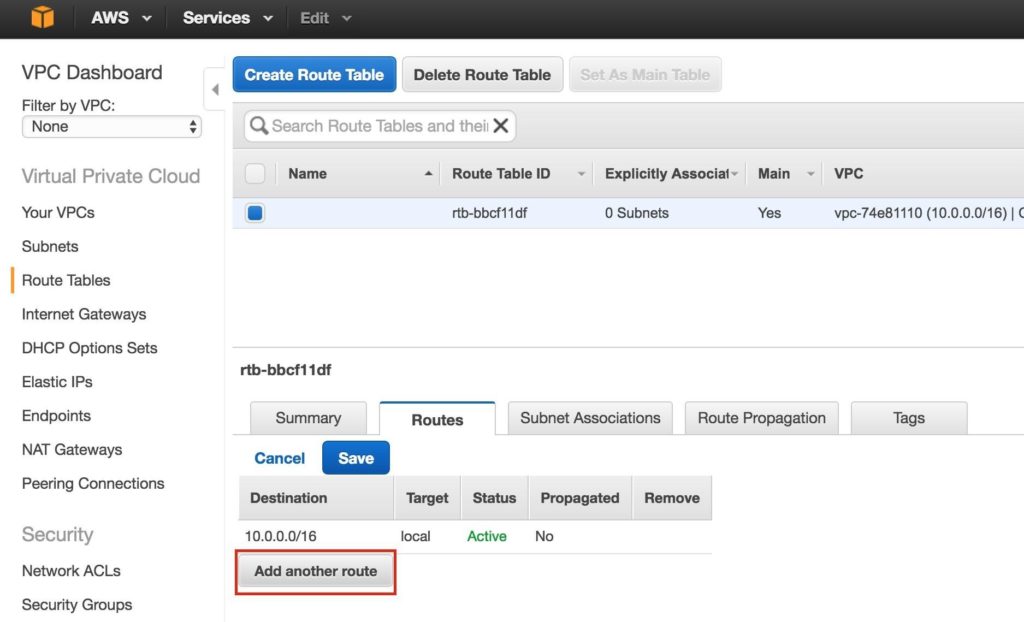
다른 경로 추가 :

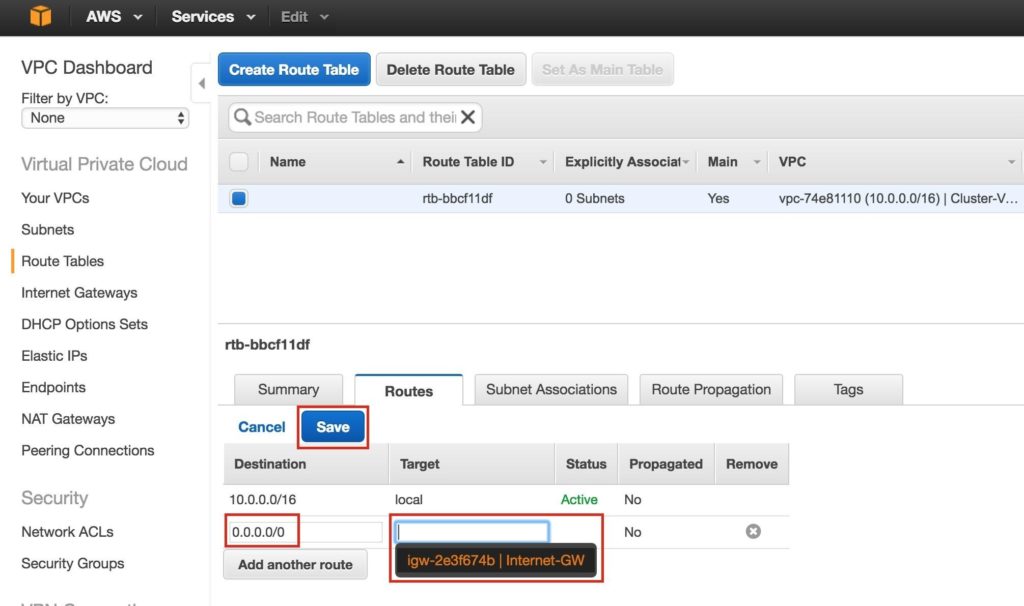
새 경로의 대상은 "0.0.0.0/0"(인터넷)이고 대상에 대해 인터넷 게이트웨이를 선택합니다. 그런 다음 저장을 클릭합니다.

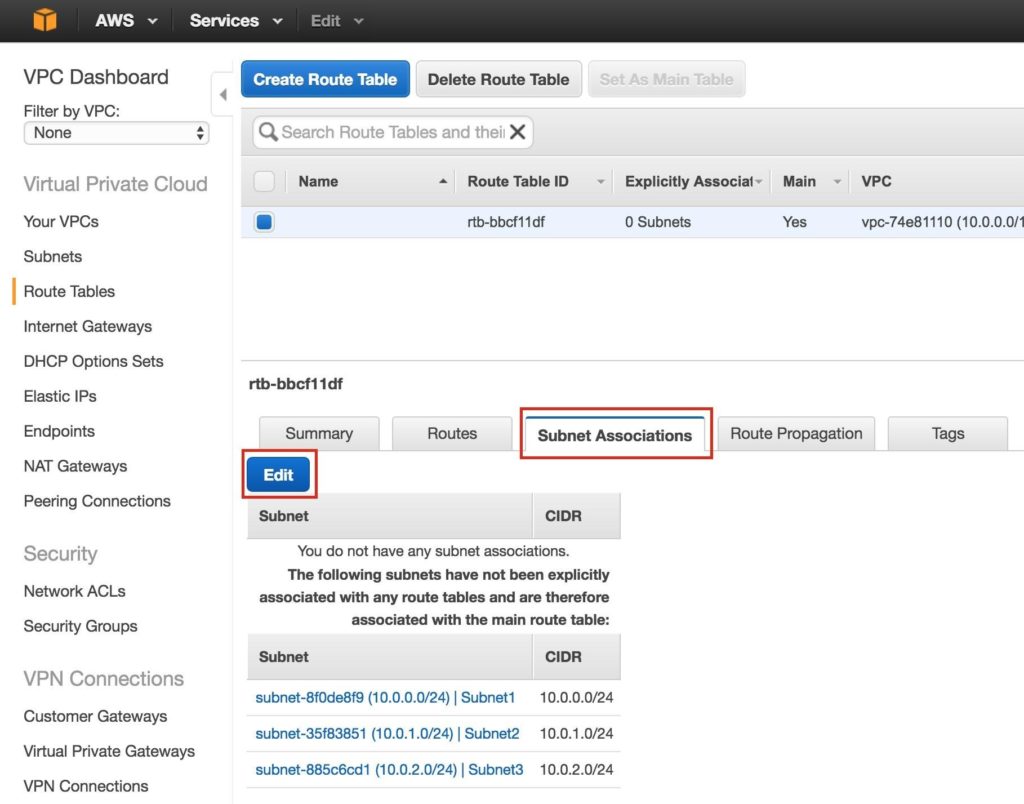
다음으로 3 개의 서브넷을 라우팅 테이블과 연결합니다. "서브넷 연결"탭을 클릭하고 편집 :

3 개의 서브넷 모두 옆에있는 확인란을 선택하고 저장합니다.

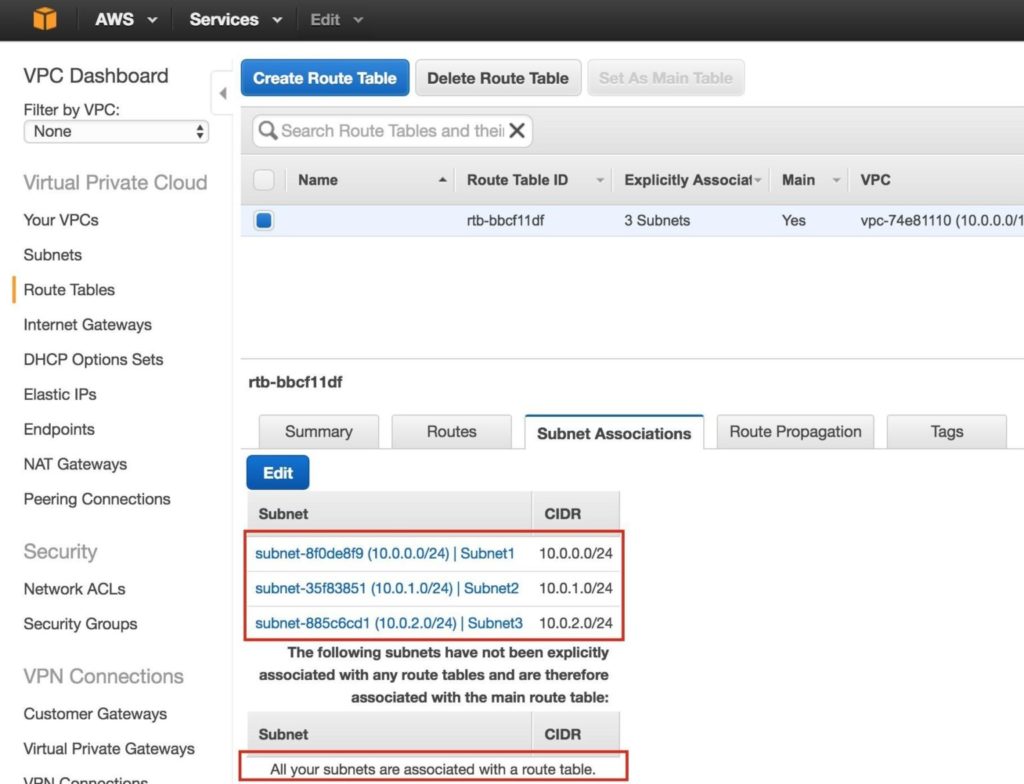
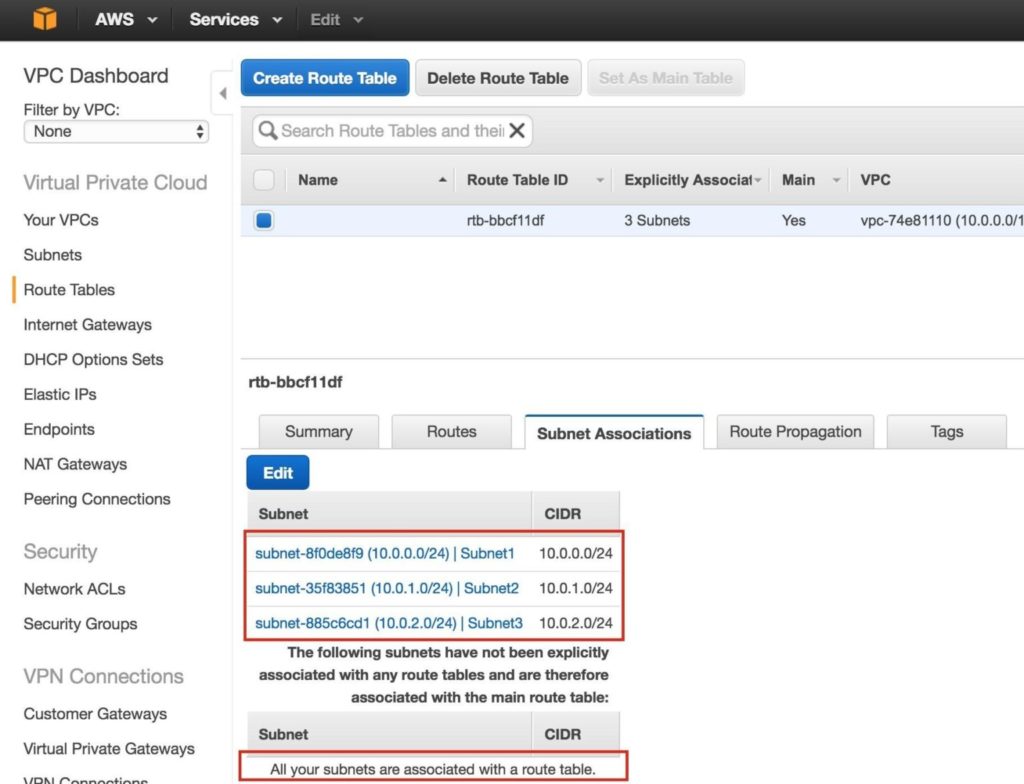
3 개의 서브넷이 기본 라우팅 테이블과 연결되어 있는지 확인합니다.

나중에 돌아와서 라우팅 테이블을 다시 한 번 업데이트하여 트래픽이 클러스터의 가상 IP와 통신 할 수 있도록 라우트를 정의 할 것입니다.하지만 이는 Linux 인스턴스 (VM)가 생성 된 후에 수행되어야합니다.

5 단계 : 보안 그룹 구성

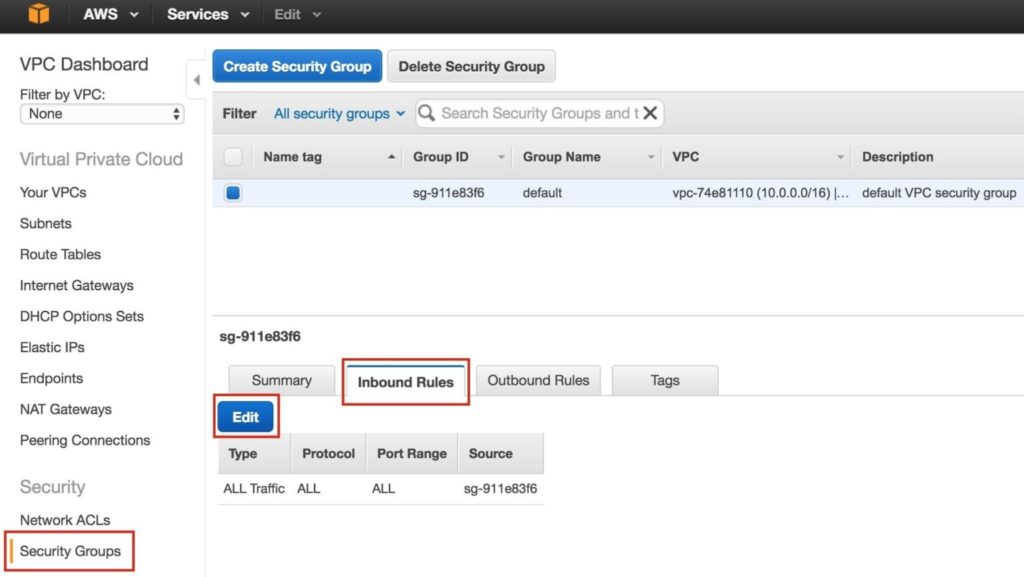
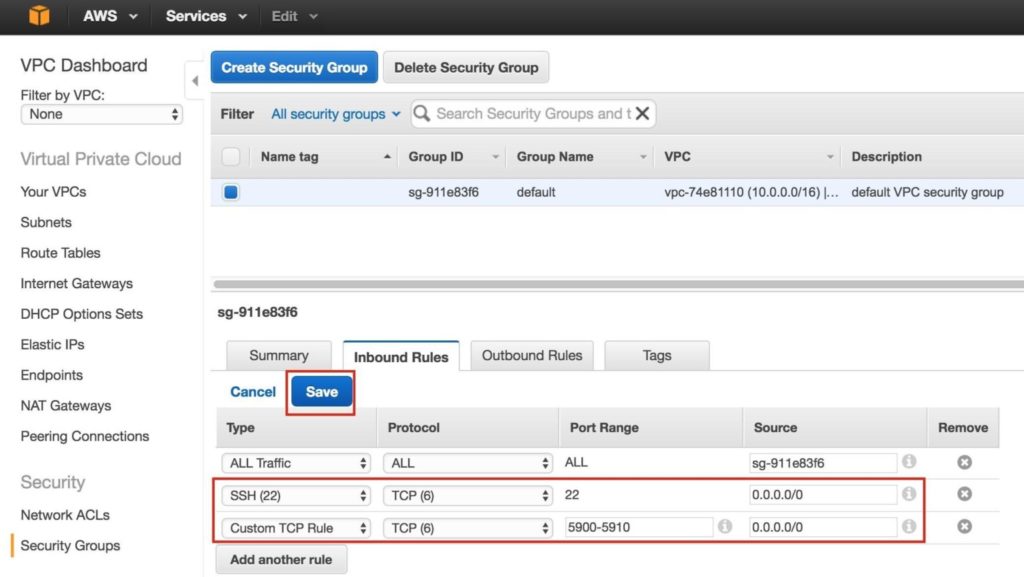
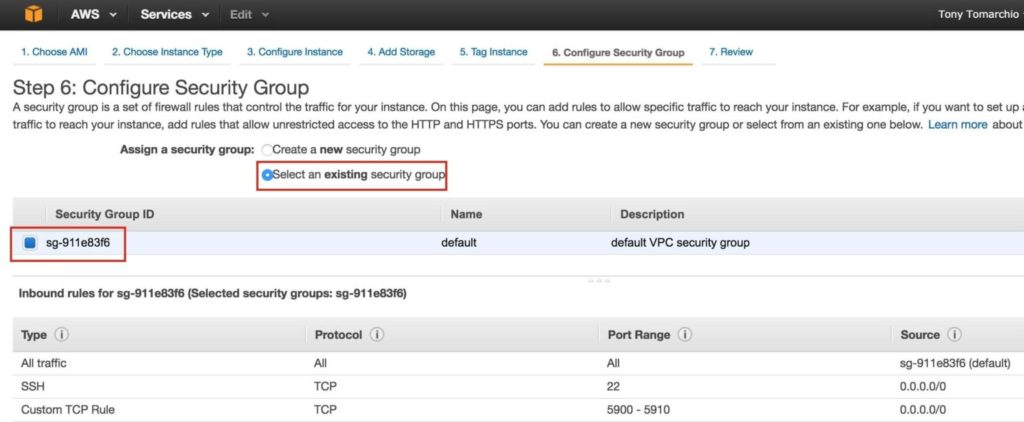
들어오는 SSH 및 VNC 트래픽을 허용하도록 보안 그룹 (가상 방화벽)을 수정합니다. 둘 다 나중에 Linux 인스턴스를 구성하고 클러스터 소프트웨어의 설치 / 구성을 구성하는 데 사용됩니다.

왼쪽 메뉴에서 "보안 그룹"을 선택한 다음 "인바운드 규칙"탭을 클릭합니다. 편집을 클릭하십시오.

SSH (포트 22) 및 VNC 모두에 대한 규칙을 추가합니다. VNC는 일반적으로 구성 방법에 따라 5900의 포트를 사용하므로이 가이드의 목적에 따라 5900-5910 포트 범위를 엽니 다. VNC 설정에 따라 구성하십시오.

6 단계 : 인스턴스 시작

이 가이드에서는 3 개의 인스턴스 (가상 머신)를 프로비저닝합니다. 처음 두 개의 VM ( "node1"및 "node2"라고 함)은 MySQL 데이터베이스 및 관련 리소스를 온라인 상태로 만드는 기능을 가진 클러스터 노드로 작동합니다. 세 번째 VM은 분할 브레인에 대한 추가 보호를 위해 클러스터의 증인 서버 역할을합니다.

최대한의 가용성을 보장하기 위해 VM 3 개 모두 단일 지역 내의 서로 다른 가용성 영역에 배포됩니다. 이는 각 인스턴스가 다른 서브넷에 있음을 의미합니다.

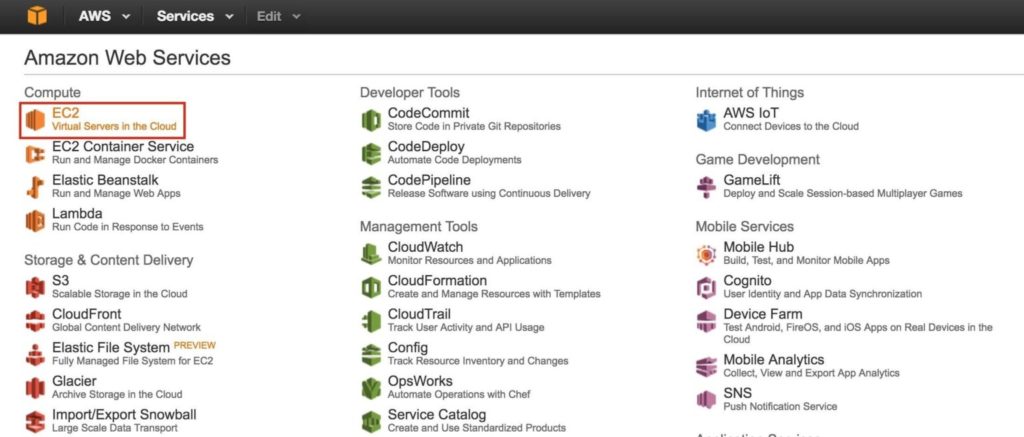
기본 AWS 대시 보드로 이동하여 EC2를 선택합니다.


"node1"만들기

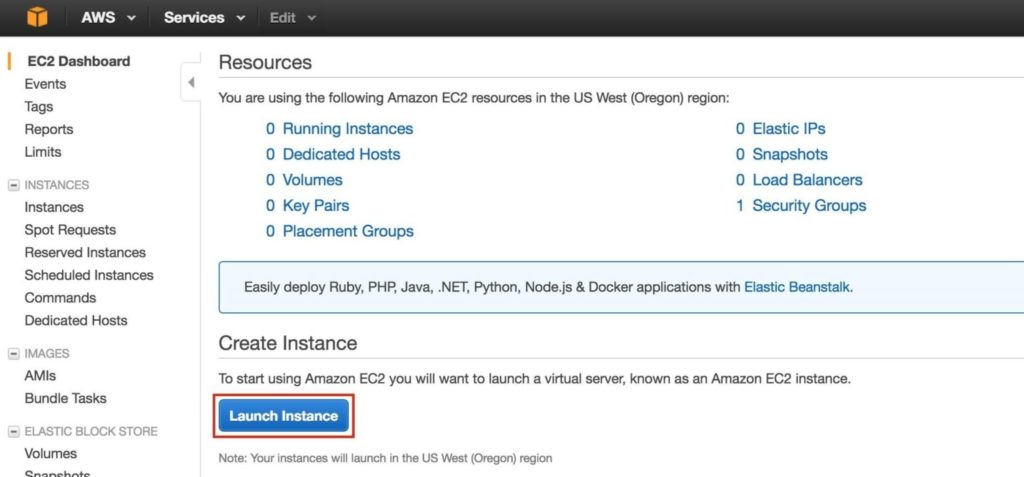
첫 번째 인스턴스 ( "node1")를 만듭니다. 인스턴스 시작을 클릭합니다.

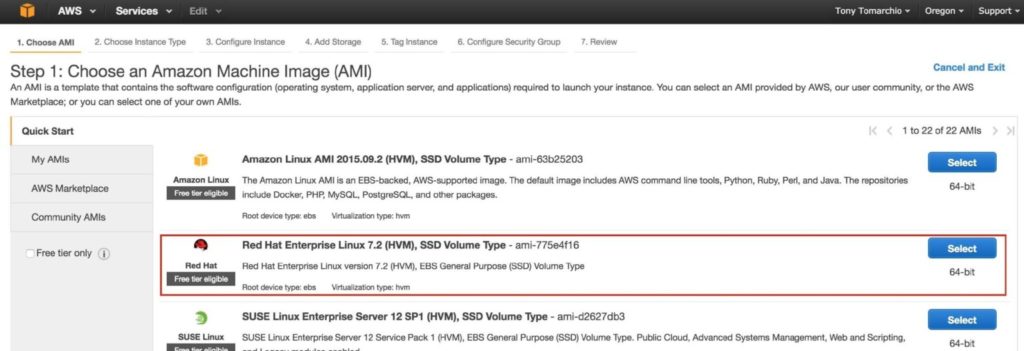
Linux 배포를 선택하십시오. 나중에 사용되는 클러스터 소프트웨어는 RHEL, SLES, CentOS, Oracle Linux를 지원합니다. 이 가이드에서는 RHEL 7.X를 사용합니다.

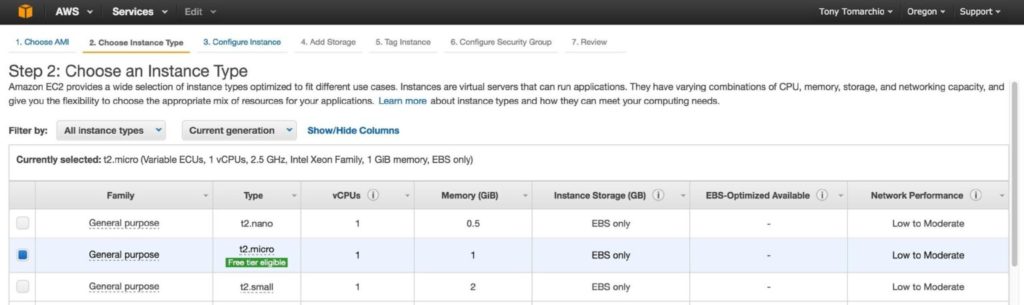
그에 따라 인스턴스 크기를 조정하십시오. 이 가이드의 목적과 비용을 최소화하기 위해 t2.micro 크기가 사용되었습니다. 무료 등급이 적용되기 때문입니다. 인스턴스 크기 및 가격에 대한 자세한 내용은 여기를 참조하세요.

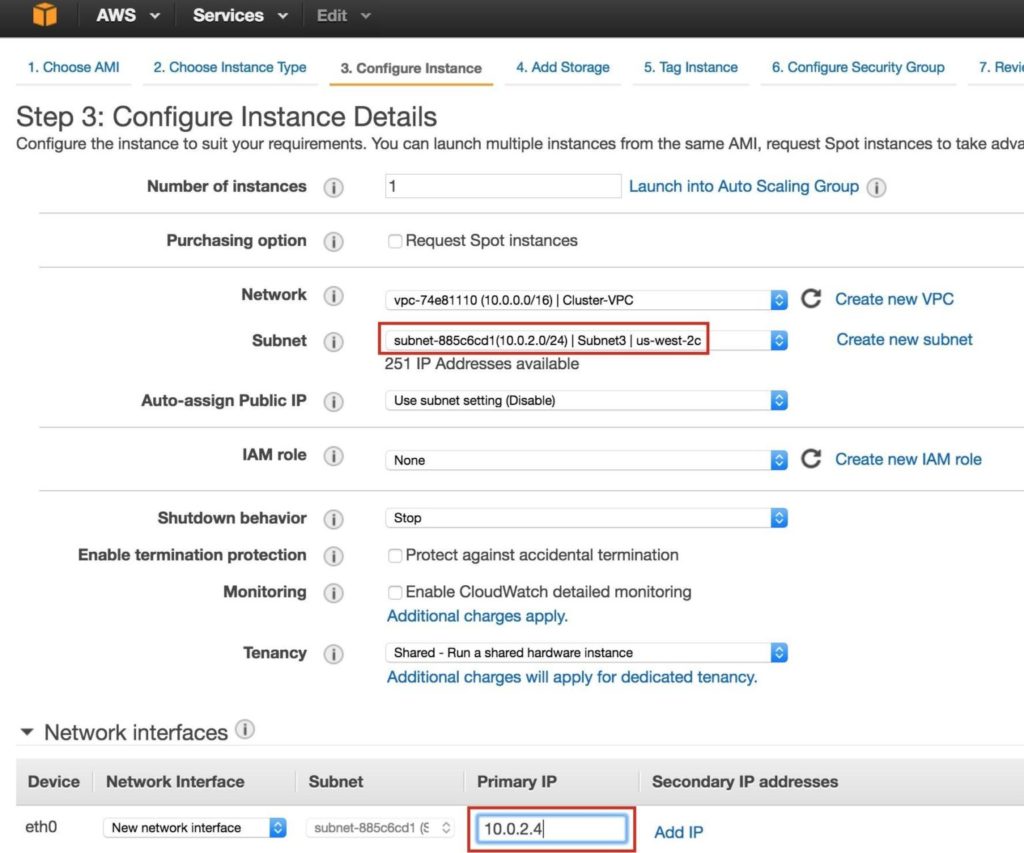
다음으로 인스턴스 세부 정보를 구성합니다. 중요 :이 첫 번째 인스턴스 (VM)를 "Subnet1"로 시작하고 서브넷 (10.0.0.0/24)에 유효한 IP 주소를 정의해야합니다. 서브넷의 첫 번째 사용 가능한 IP이므로 10.0.0.4 미만이 선택되었습니다.
참고 : AWS의 특정 서브넷에있는 .1 / .2 / .3은 예약되어 사용할 수 없습니다.

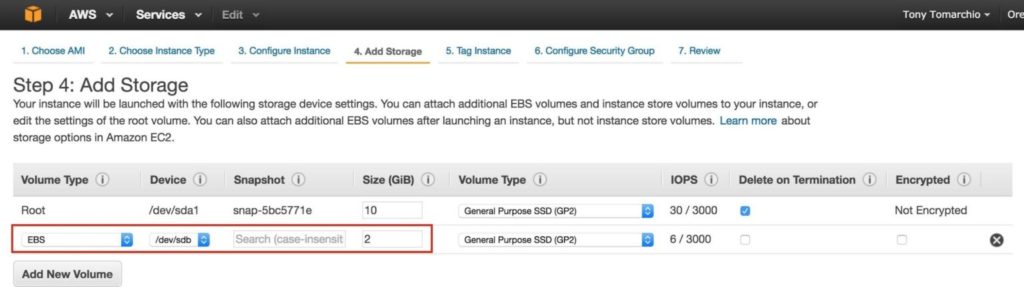
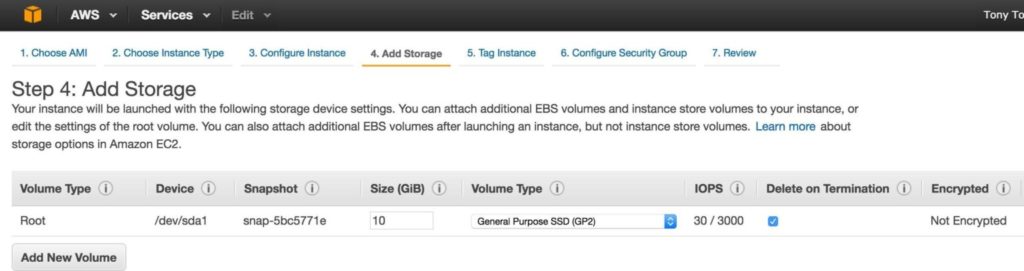
다음으로 클러스터 노드에 추가 디스크를 추가합니다 ( "node1"및 "node2"모두에서 수행됨). 이 디스크는 MySQL 데이터베이스를 저장하고 나중에 노드간에 복제됩니다.

참고 : '증인'노드에 디스크를 추가 할 필요가 없습니다. "node1"및 "node2"만. 새 볼륨을 추가하고 원하는 크기를 입력합니다.

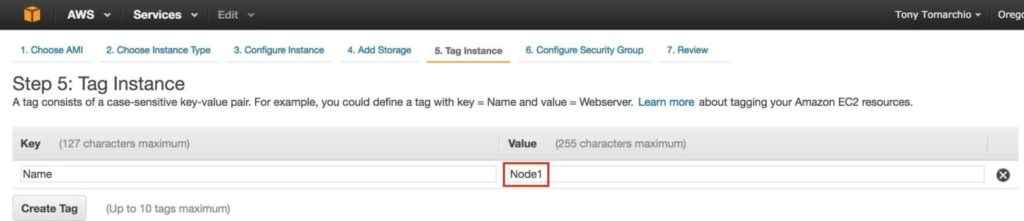
인스턴스 Node1에 대한 태그를 정의하십시오.

인스턴스를 기존 보안 그룹과 연결하여 이전에 생성 한 방화벽 규칙이 활성화되도록합니다.

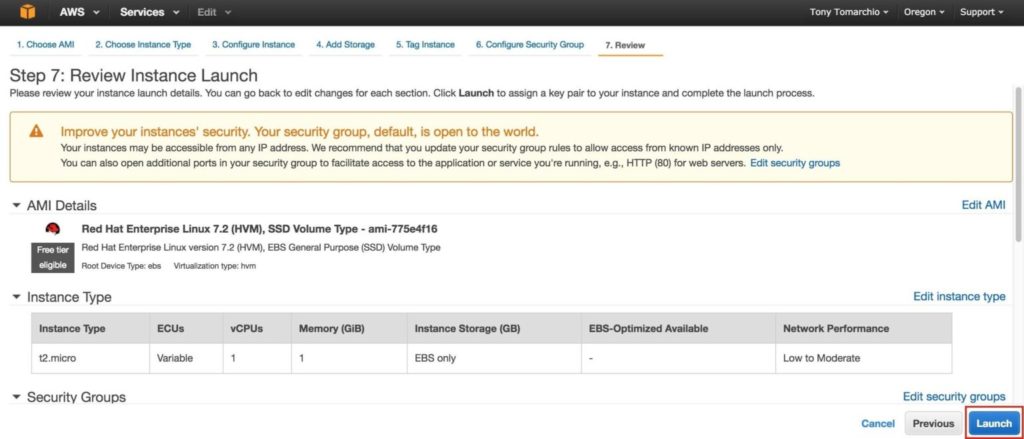
시작을 클릭합니다.

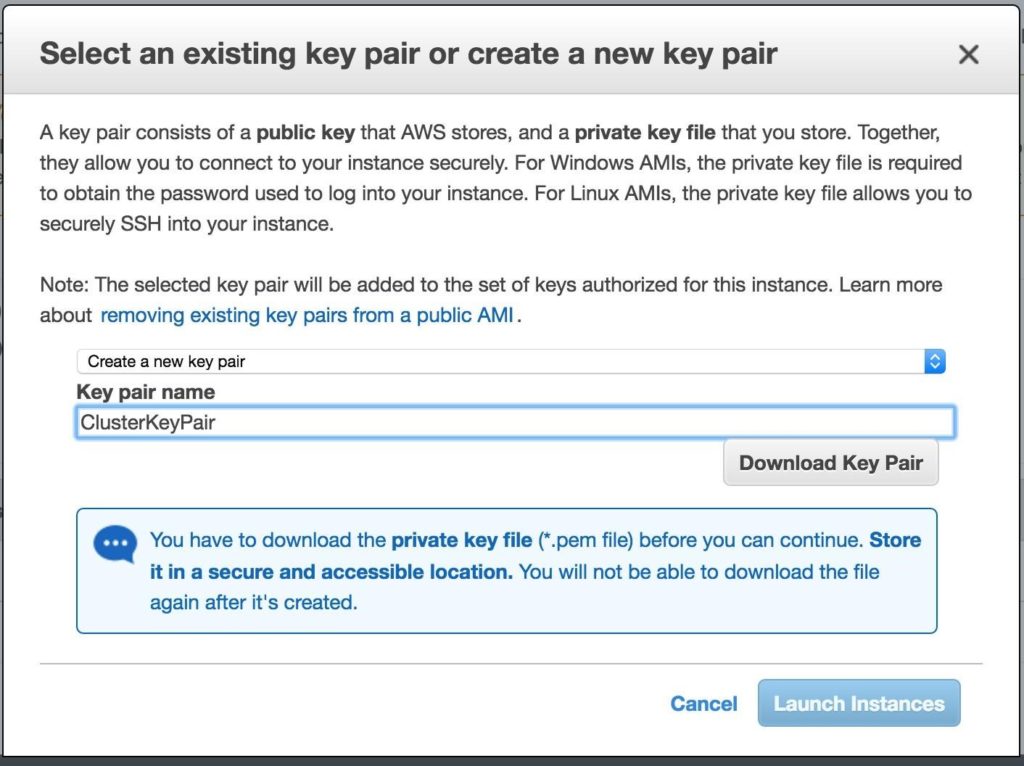
중요 : AWS 환경의 첫 번째 인스턴스 인 경우 새 키 쌍을 만들어야합니다. 비공개 키 파일은 Linux 인스턴스에 SSH로 연결할 때 필요하므로 안전한 위치에 저장해야합니다.

"node2"만들기

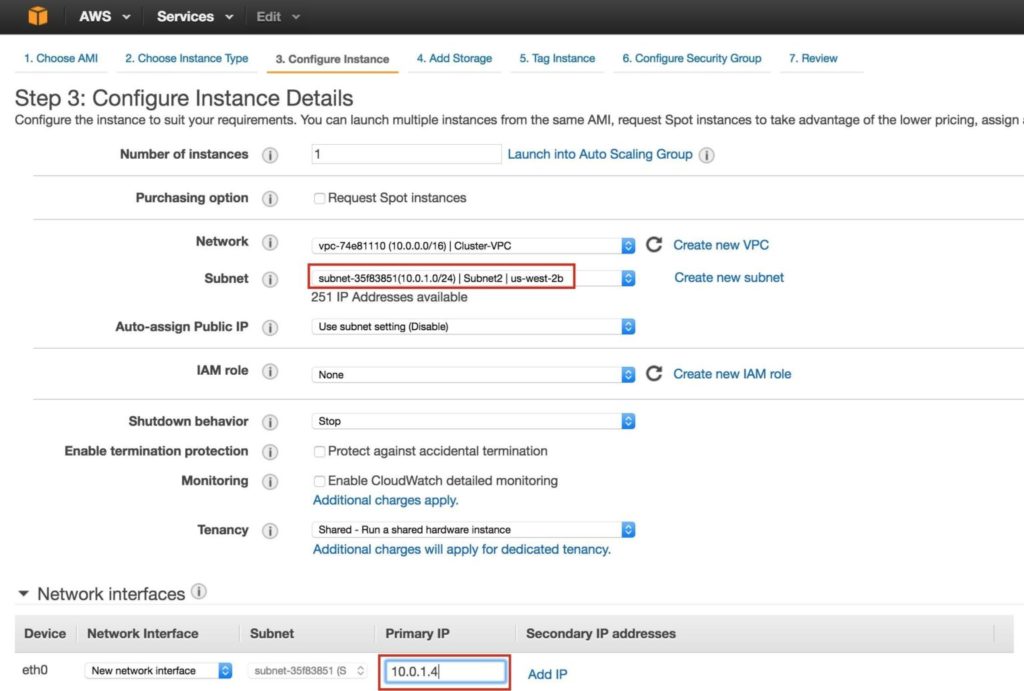
위의 단계를 반복하여 두 번째 Linux 인스턴스 (node2)를 만듭니다. Node1과 똑같이 구성하십시오. 하지만 'Subnet2'(us-west-2b 가용성 영역)에 배포해야합니다. Subnet2의 IP 범위는 10.0.1.0/24이므로 여기에서는 IP 10.0.1.4가 사용됩니다.

두 번째 디스크도 Node2에 추가해야합니다. Node1에 추가 한 디스크와 정확히 같은 크기 여야합니다.

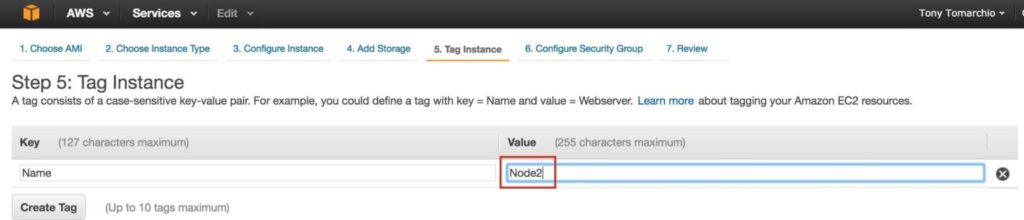
두 번째 인스턴스에 태그 지정…. “Node2”:

"증인"만들기

위의 단계를 반복하여 세 번째 Linux 인스턴스 (증인)를 만듭니다. 두 번째 디스크를 추가 할 필요가 없다는 점을 제외하면 Node1 & Node2와 똑같이 구성합니다.이 인스턴스는 클러스터에 대한 감시 역할 만하며 MySQL을 온라인 상태로 만들지 않기 때문입니다.

'Subnet3'(us-west-2c 가용성 영역)에 배포해야합니다. Subnet2의 IP 범위는 10.0.2.0/24이므로 여기에서는 IP 10.0.2.4가 사용됩니다.

참고 : 감시 노드에는 기본 디스크 구성이 좋습니다. 두 번째 디스크는 필요하지 않습니다.

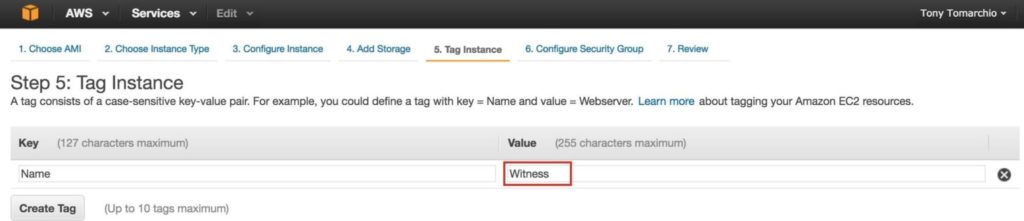
감시 노드에 태그를 지정합니다.

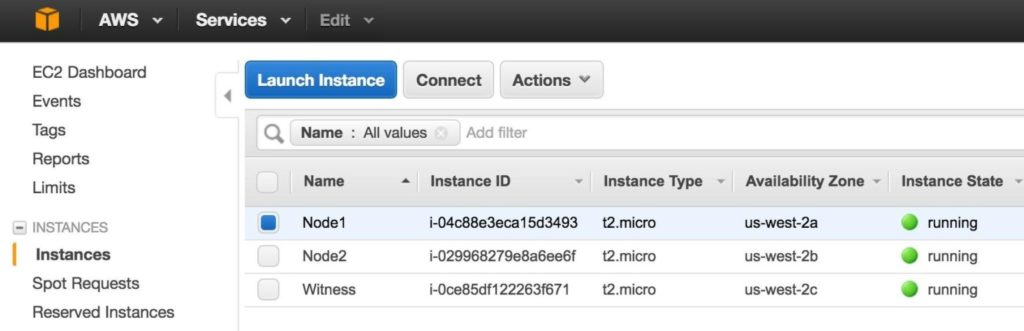
3 개의 인스턴스를 프로비저닝하는 데 약간의 시간이 걸릴 수 있습니다. 완료되면 EC2 콘솔에서 실행중인 것으로 표시됩니다.

7 단계 : 탄력적 IP 생성

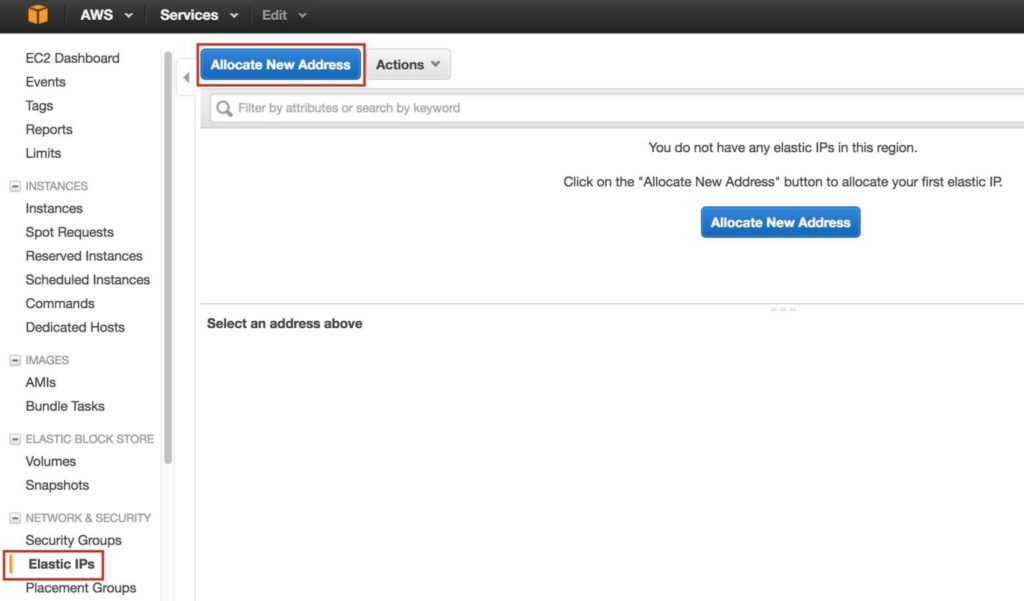
그런 다음 외부에서 인스턴스에 연결하는 데 사용할 공개 IP 주소 인 탄력적 IP를 만듭니다. 왼쪽 메뉴에서 탄력적 IP를 선택한 다음 "새 주소 할당"을 클릭합니다.


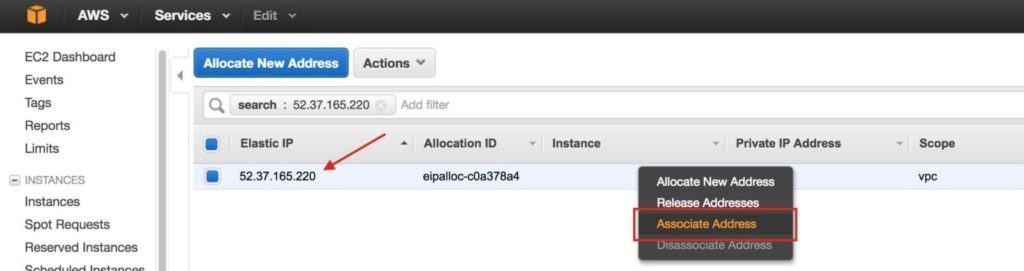
새로 생성 된 탄력적 IP를 선택하고 마우스 오른쪽 버튼을 클릭 한 다음 "Associate Address"를 선택합니다.

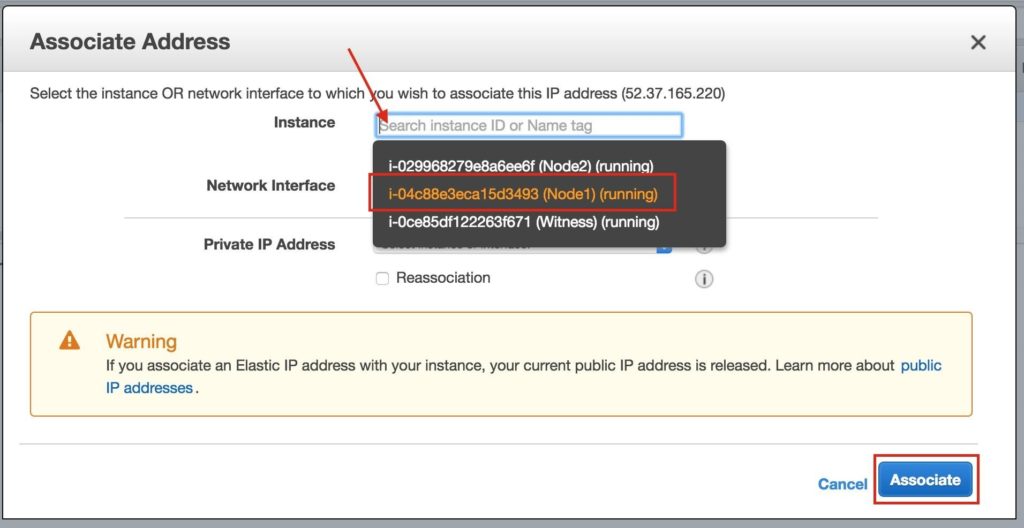
이 탄력적 IP를 Node1과 연결합니다.

인터넷 액세스를 원하거나 직접 SSH / VNC 할 수 있도록하려면 다른 두 인스턴스에 대해이 작업을 반복합니다.

8 단계 : 가상 IP에 대한 경로 항목 생성

이 시점에서 3 개의 인스턴스가 모두 생성되었으며 클러스터의 가상 IP가 작동하려면 라우팅 테이블을 한 번 더 업데이트해야합니다. 이 다중 서브넷 클러스터 구성에서 가상 IP는 VPC에 할당 된 CIDR 범위 밖에 있어야합니다.

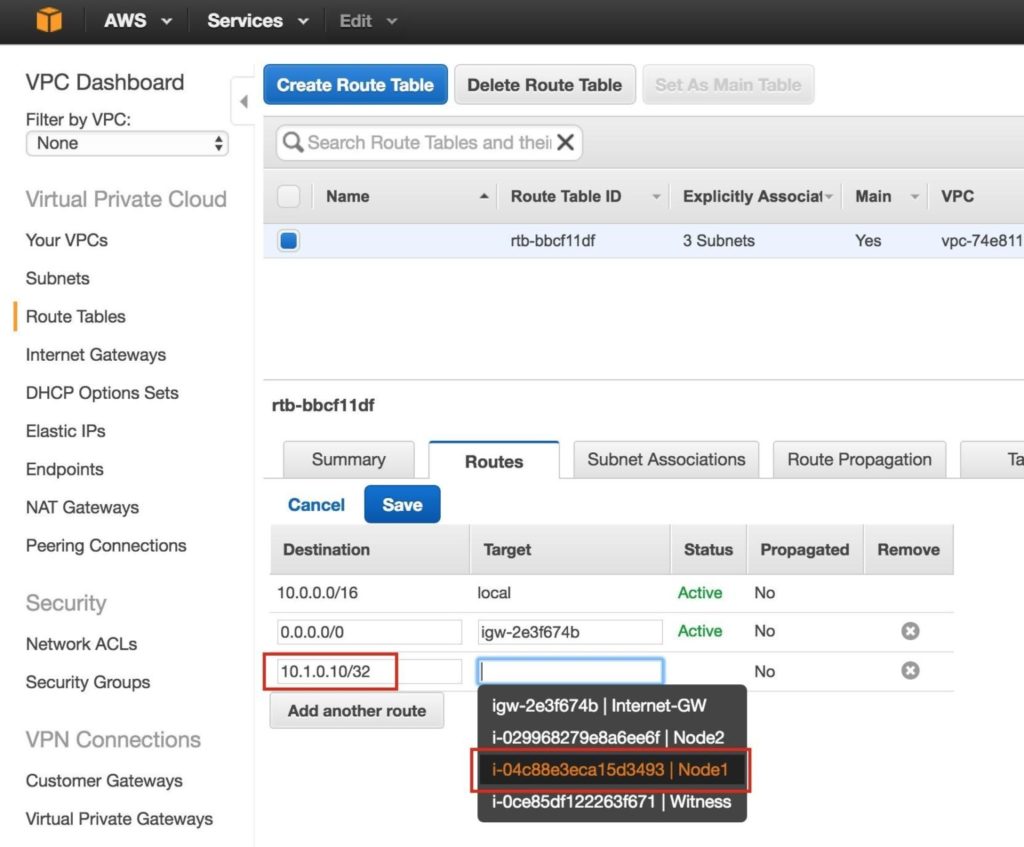
트래픽을 클러스터의 가상 IP (10.1.0.10), 기본 클러스터 노드 (Node1)로 보내는 새 경로를 정의합니다.

VPC 대시 보드에서 라우팅 테이블을 선택하고 편집을 클릭합니다. 대상이 Node1 인 "10.1.0.10/32"에 대한 경로를 추가합니다.

9 단계 : ENI에 대한 소스 / 대상 확인 비활성화

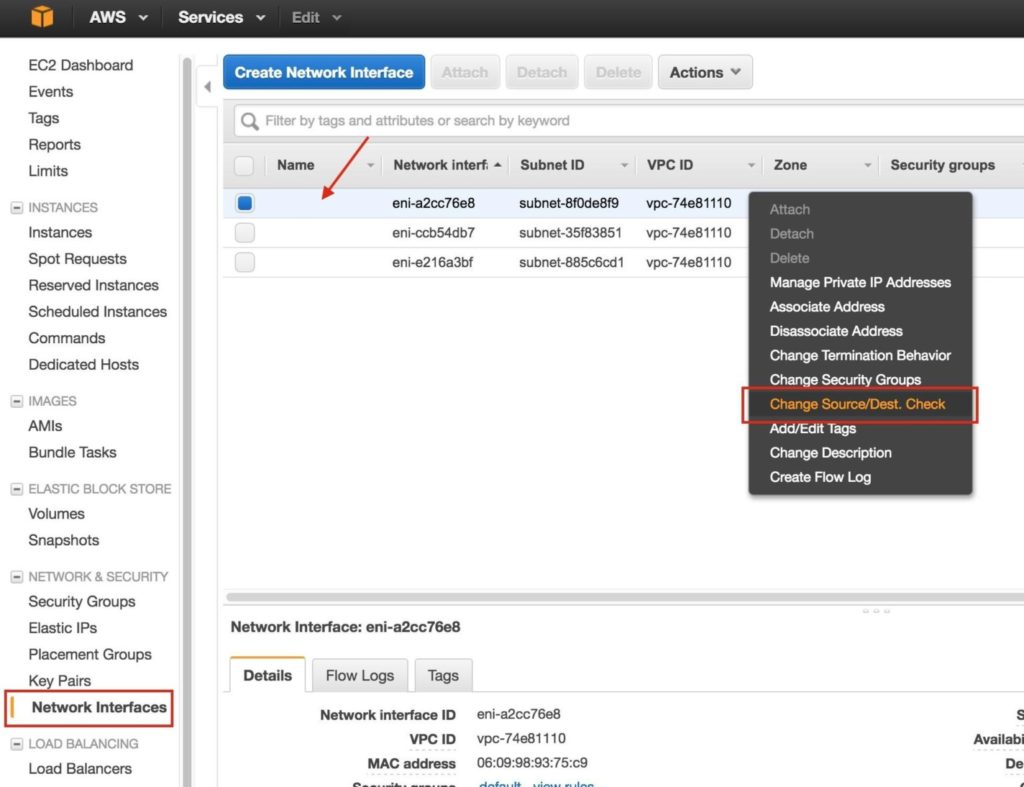
다음으로 클러스터 노드의 ENI (Elastic Network Interface)에 대한 소스 / 대상 확인을 사용 중지합니다. 이는 인스턴스가 클러스터의 가상 IP 주소에 대한 네트워크 패킷을 수락하기 위해 필요합니다.

모든 ENI에 대해이 작업을 수행하십시오.

“Network Interfaces”를 선택하고 ENI를 마우스 오른쪽 버튼으로 클릭 한 다음“Change Source / Dest Check”를 선택합니다.

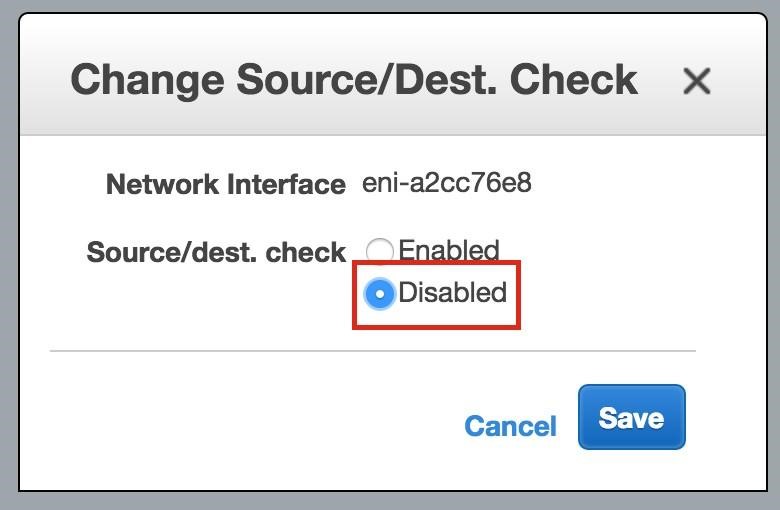
"Disabled"선택 :

10 단계 : 액세스 키 ID 및 보안 액세스 키 얻기

가이드의 뒷부분에서 클러스터 소프트웨어는 AWS 명령 줄 인터페이스 (CLI)를 사용하여 클러스터의 가상 IP에 대한 라우팅 테이블 항목을 조작하여 트래픽을 활성 클러스터 노드로 리디렉션합니다. 이 기능이 작동하려면 AWS CLI가 올바르게 인증 할 수 있도록 액세스 키 ID와 보안 액세스 키를 얻어야합니다.

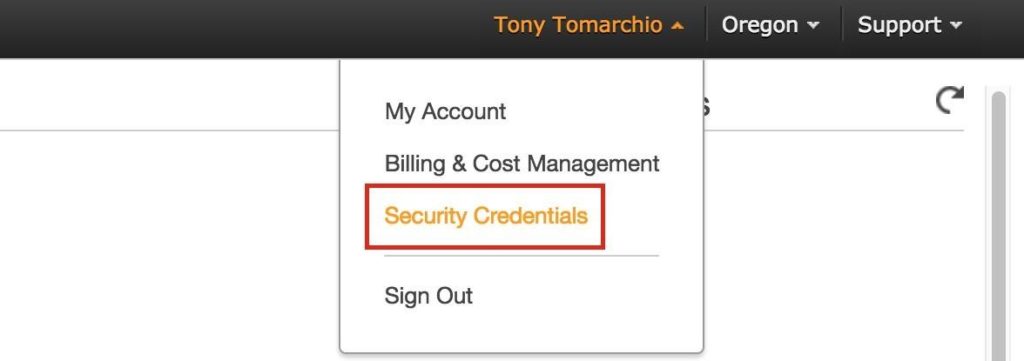
EC2 대시 보드의 오른쪽 상단에서 이름을 클릭하고 아래 드롭 다운에서 "보안 자격 증명"을 선택합니다.

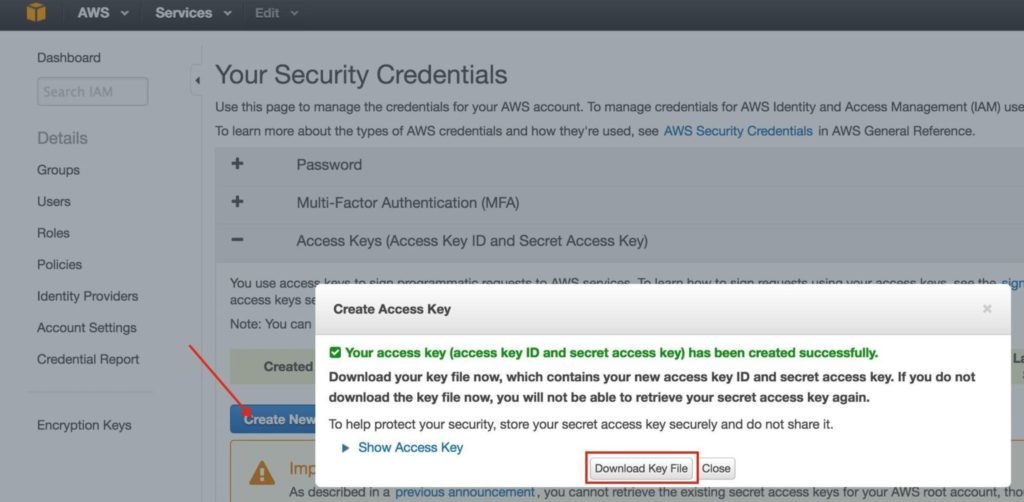
표의 "액세스 키 (액세스 키 ID 및 보안 액세스 키)"섹션을 확장하고 "새 액세스 키 만들기"를 클릭합니다. 키 파일을 다운로드하여 안전한 위치에 저장하십시오.

11 단계 : Linux OS 구성

Linux 인스턴스에 연결합니다.

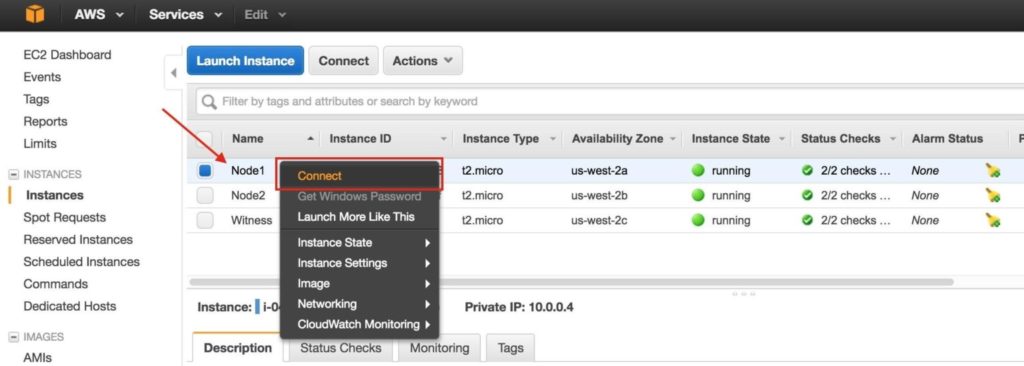
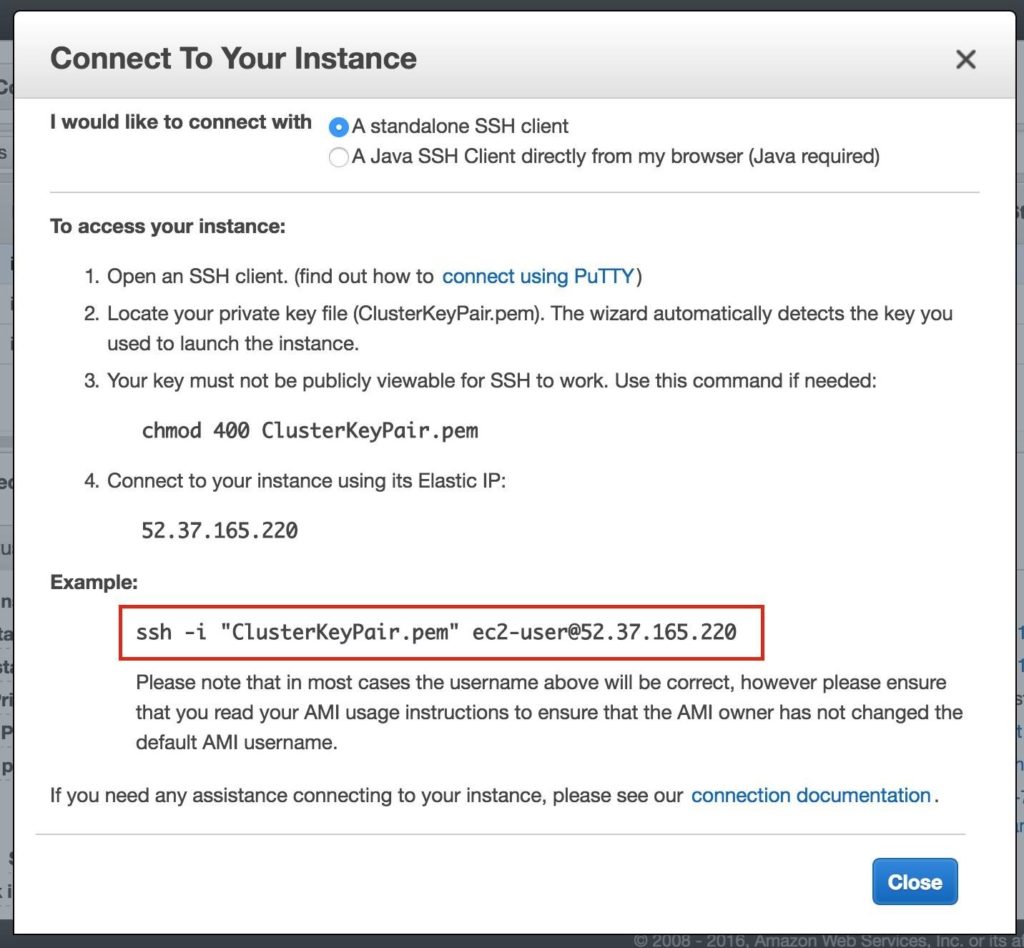
새로 생성 된 Linux 인스턴스 (SSH를 통해)에 연결하려면 인스턴스를 마우스 오른쪽 버튼으로 클릭하고 "연결"을 선택합니다. 그러면 인스턴스에 연결하기위한 지침이 표시됩니다. 이전 단계에서 생성 / 다운로드 한 개인 키 파일이 필요합니다.

예:

여기에서 잠시 동안 EC2 대시 보드를 떠나 명령 줄에서 손을 더럽힐 것입니다. Linux 관리자로서 지금까지는 익숙해야합니다.

AWS의 Linux VM (또는 기본 "ec2-user"계정)에 대한 루트 암호가 제공되지 않으므로 연결 한 후 "sudo"명령을 사용하여 루트 권한을 얻습니다.

$ sudo su –

DNS 서버를 이미 설정하지 않은 경우 3 개의 서버 모두에 호스트 파일 항목을 생성하여 nameEdit / etc / hosts로 서로를 올바르게 해결할 수 있도록합니다.

/ etc / hosts 파일 끝에 다음 행을 추가하십시오.

10.0.0.4 노드 1
10.0.1.4 노드 2
10.0.2.4 증인
10.1.0.10 mysql-vip

SELinux 비활성화

/ etc / sysconfig / linux를 편집하고“SELINUX = disabled”를 설정합니다.

# vi / etc / sysconfig / selinux


#이 파일은 시스템에서 SELinux의 상태를 제어합니다. # SELINUX =는 다음 세 가지 값 중 하나를 취할 수 있습니다.

# 시행 – SELinux 보안 정책이 시행됩니다.

# permissive – SELinux는 강제하는 대신 경고를 출력합니다.

# disabled – SELinux 정책이로드되지 않았습니다.

SELINUX = 비활성화

# SELINUXTYPE =은 다음 두 값 중 하나를 사용할 수 있습니다.

# 타겟팅 – 타겟팅 된 프로세스가 보호됨, # mls – 다단계 보안 보호.

SELINUXTYPE = 타겟팅

호스트 이름 설정

기본적으로 이러한 Linux 인스턴스에는 "ip-10-0-0-4.us-west-2.compute.internal"과 같이 서버의 IP 주소를 기반으로하는 호스트 이름이 있습니다.

호스트 이름을 "정상적인"방법 (예 : / etc / sysconfig / network 편집 등)으로 수정하려고하면 재부팅 할 때마다 원래 이름으로 되돌아갑니다 !! 재부팅 후 호스트 이름을 실제로 정적으로 유지하는 방법을 설명하는 AWS 토론 포럼에서 훌륭한 스레드를 찾았습니다.

세부 정보 : https://forums.aws.amazon.com/message.jspa?messageID=560446

“/etc/cloud/cloud.cfg”파일에서 호스트 이름을 설정하는 모듈을 주석 처리합니다. 다음 모듈은 #을 사용하여 주석 처리 할 수 있습니다.

# – set_hostname

# – update_hostname

다음으로 / etc / hostname에서 호스트 이름도 변경하십시오.

클러스터 노드 재부팅

SELinux가 비활성화되고 호스트 이름 변경 사항이 적용되도록 3 개의 인스턴스를 모두 재부팅합니다.

VNC (및 관련 패키지) 설치 및 구성

Linux 서버의 GUI에 액세스하고 나중에 클러스터를 설치 및 구성하려면 VNC 서버와 몇 가지 다른 필수 패키지를 설치하십시오 (클러스터 소프트웨어에는 redhat-lsb 및 패치 rpms 필요).

# yum groupinstall“X Window System”

# yum groupinstall 'GUI 포함 서버'

# yum install tigervnc-server xterm wget unzip patch redhat-lsb

# vncpasswd

다음 URL은 RHEL 7 / CentOS 7 : For RHEL 7.x / CentOS7.x에서 VNC 서버를 실행하는 데 유용한 가이드입니다.

https://www.digitalocean.com/community/tutorials/how-to-install-and-configure-vnc-remote-access-for-the- gnome-desktop-on-centos-7

참고 :이 예시 구성은 디스플레이 2 (: 2, 일명 포트 5902) 및 루트 (안전하지 않음)에서 VNC를 실행합니다. 그에 따라 조정하십시오!

# cp /lib/systemd/system/vncserver@.service /etc/systemd/system/vncserver@:2.serv

# vi /etc/systemd/system/vncserver@:2.service

[Service]

유형 = 포킹

# /tmp/.X11-unix 환경에서 기존 파일 정리 ExecStartPre = / bin / sh -c‘/ usr / bin / vncserver -kill % i> / dev / null 2> & 1 || :’

ExecStart = / sbin / runuser -l root –c“/ usr / bin / vncserver % i –geometry 1024 × 768”PIDFile = / root / .vnc / % H % i.pid

ExecStop = / bin / sh -c‘/ usr / bin / vncserver -kill % i> / dev / null 2> & 1 || :’

# systemctl 데몬 새로 고침

# systemctl 사용 vncserver @ : 2.service

# vncserver : 2 -geometry 1024 × 768

RHEL / CentOS 6.x 시스템의 경우 :

# vi / etc / sysconfig / vncservers


VNCSERVERS =”2 : root”VNCSERVERARGS [2]=”-geometry 1024 × 768 ″


# 서비스 vncserver 시작

# chkconfig vncserver on

VNC 클라이언트를 열고 <ElasticIP : 2>에 연결합니다. 얻을 수 없다면 Linux 방화벽이 방해가 될 수 있습니다. 여기에서 사용중인 VNC 포트 (포트 5902)를 열거 나 지금은 방화벽을 비활성화합니다 (생산 환경에 권장되지 않음).

# systemctl 방화벽 중지

# systemctl 방화벽 사용 중지

"데이터"디스크 분할 및 포맷

Linux 인스턴스가 시작되고 보호 할 애플리케이션 데이터를 저장하기 위해 각 클러스터 노드에 추가 디스크가 추가되었을 때. 이 경우 MySQL 데이터베이스입니다.

두 번째 디스크는 / dev / xvdb로 나타나야합니다. "fdisk -l"명령을 실행하여 확인할 수 있습니다. 당신은 그것을 볼 수 있습니다
/ dev / xvda (OS)가 이미 사용되고 있습니다.

# fdisk -l

# 시작 끝 크기 유형 이름 디스크 / dev / xvda : 10.7GB, 10737418240 바이트, 20971520 섹터 단위 = 1 * 512 = 512 바이트 섹터
섹터 크기 (논리 / 물리) : 512 바이트 / 512 바이트 I / O 크기 (최소 / 최적) : 512 바이트 / 512 바이트 디스크 레이블 유형 : gpt

1 2048 4095 1M BIOS 부팅 부분
2 4096 20971486 10G Microsoft 기본
디스크 / dev / xvdb : 2147MB, 2147483648 바이트, 4194304 섹터 단위 = 1 * 512 = 512 바이트의 섹터
섹터 크기 (논리 / 물리) : 512 바이트 / 512 바이트 I / O 크기 (최소 / 최적) : 512 바이트 / 512 바이트

여기서는 파티션 (/ dev / xvdb1)을 만들고 포맷 한 다음 MySQL의 기본 위치에 마운트합니다.
/ var / lib / mysql. "node1"및 "node2"모두에서 다음 단계를 수행하십시오.

# fdisk / dev / xvdb

fdisk (util-linux 2.23.2)에 오신 것을 환영합니다.


변경 사항은 작성하기로 결정할 때까지 메모리에만 남아 있습니다. 쓰기 명령을 사용하기 전에주의하십시오.


장치에 인식 된 파티션 테이블이 없습니다.

디스크 식별자 0x8c16903a로 새 DOS 디스크 레이블을 작성합니다.


명령어 (m for help) : n

파티션 유형 :

p 기본 (기본 0 개, 확장 0 개, 무료 4 개) e 확장

선택 (기본값 p) : p

파티션 번호 (1-4, 기본값 1) : 1

첫 번째 섹터 (2048-4194303, 기본값 2048) : <enter>

기본값 2048 사용

마지막 섹터, + sectors 또는 + size {K, M, G} (2048-4194303, 기본값 4194303) : <enter>

기본값 4194303 사용

Linux 유형 및 크기 2GiB의 파티션 1이 설정 됨


Command (m for help) : w

파티션 테이블이 변경되었습니다!

ioctl ()을 호출하여 파티션 테이블을 다시 읽습니다. 디스크 동기화.

# mkfs.ext4 / dev / xvdb1
# mkdir / var / lib / mysql

node1에서 파일 시스템을 마운트합니다.

# 마운트 / dev / xvdb1 / var / lib / mysql

EC2 API 도구 (EC2 CLI)는 각 클러스터 노드에 설치해야 클러스터 소프트웨어가 나중에 라우팅 테이블을 조작하여 가상 IP에 연결할 수 있습니다.

12 단계 : EC2 API 도구 설치

다음 URL은이를 설정하는 훌륭한 가이드입니다.

http://docs.aws.amazon.com/AWSEC2/latest/CommandLineReference/set-up-ec2-cli-linux.html

주요 단계는 다음과 같습니다.
CLI 도구를 다운로드하고 압축을 풀고 표준 위치 (/ opt / aws)로 이동합니다.

# wget http://s3.amazonaws.com/ec2-downloads/ec2-api-tools.zip

# ec2-api-tools.zip 압축을 풉니 다.

# mv ec2-api-tools-1.7.5.1 / / opt / aws /

# export EC2_HOME =”/ opt / aws”

Java가 아직 설치되어 있지 않은 경우 (확인하려면 "which java"실행) 설치합니다.

# yum install java-1.8.0-openjdk

# export JAVA_HOME =”/ usr / lib / jvm / java-1.8.0-openjdk-1.8.0.71-

예 (RHEL 7.2 시스템의 기본 구성 기준. 그에 따라 조정)

AWS 액세스 키와 AWS 보안 키가 필요합니다. 이러한 값은 나중에 클러스터 설정 중에도 필요하므로 편리하게 유지하십시오! 자세한 내용은 다음 URL을 참조하십시오.

https://console.aws.amazon.com/iam/home?#security_credential

# export AWS_ACCESS_KEY = your-aws-access-key-id

# export AWS_SECRET_KEY = your-aws-secret-key

CLI 유틸리티 기능 테스트 :

# / opt / aws / bin / ec2-describe-regions
지역 eu-west-1 ec2.eu-west-1.amazonaws.com
지역 ap-southeast-1 ec2.ap-southeast-1.amazonaws.com
지역 ap-southeast-2 ec2.ap-southeast-2.amazonaws.com
지역 eu-central-1 ec2.eu-central-1.amazonaws.com
지역 ap-northeast-2 ec2.ap-northeast-2.amazonaws.com
지역 ap-northeast-1 ec2.ap-northeast-1.amazonaws.com
지역 us-east-1 ec2.us-east-1.amazonaws.com
지역 sa-east-1 ec2.sa-east-1.amazonaws.com
지역 us-west-1 ec2.us-west-1.amazonaws.com
지역 us-west-2 ec2.us-west-2.amazonaws.com

13 단계 : MySQL 설치 및 구성

다음으로 MySQL 패키지를 설치하고 샘플 데이터베이스를 초기화 한 다음 MySQL의 "루트"비밀번호를 설정합니다. RHEL7.X에서 MySQL 패키지는 MariaDB 패키지로 대체되었습니다.

"node1"에서 :

# yum mariadb mariadb-server 설치

# 마운트 / dev / xvdb1 / var / lib / mysql

# / usr / bin / mysql_install_db –datadir =”/ var / lib / mysql /”–user = mysql

# mysqld_safe –user = root –socket = / var / lib / mysql / mysql.sock –port = 3306 –datadi

#

# # 참고 :이 다음 명령은 모든 호스트에서 원격 연결을 허용합니다.  좋은 # echo "update user set Host =’%’여기서 Host =’node1 ′; 플러시 권한 | mysql mys #

# #MySQL의 루트 비밀번호를‘SIOS’로 설정

# echo“update user set Password = PASSWORD (‘SIOS’) where User =’root’; 플러시

MySQL 구성 파일을 생성합니다. 데이터 디스크 (나중에 복제됩니다.
/var/lib/mysql/my.cnf). 예:

# vi /var/lib/mysql/my.cnf


[mysqld] datadir = / var / lib / mysql

소켓 = / var / lib / mysql / mysql.sock

pid-file = / var / run / mariadb / mariadb.pid user = root

port = 3306

# 다양한 보안 위험을 방지하기 위해 심볼릭 링크를 비활성화하는 것이 좋습니다. 심볼릭 링크 = 0

[mysqld_safe]

log-error = / var / log / mariadb / mariadb.log pid-file = / var / run / mariadb / mariadb.pid


[client] 사용자 = 루트 암호 = SIOS

원래 MySQL 구성 파일이있는 경우 옆으로 이동합니다.

# mv /etc/my.cnf /etc/my.cnf.orig

“node2”에서는 MariaDB / MySQL 패키지 만 설치하면됩니다. 다른 단계는 필요하지 않습니다. "node2"에서 :

[root@node2 ~]# yum mariadb mariadb-server 설치

14 단계 : 클러스터 설치 및 구성

이제 클러스터를 설치하고 구성 할 준비가되었습니다. Linux 용 SIOS Protection Suite (일명 SPS-Linux)는이 가이드에서 클러스터링 기술로 사용됩니다. 단일 통합 솔루션에서 고 가용성 장애 조치 클러스터링 기능 (LifeKeeper)과 실시간 블록 수준 데이터 복제 (DataKeeper)를 모두 제공합니다. SPS-Linux를 사용하면 "SANLess"클러스터 (일명 "비공유"클러스터)를 배포 할 수 있습니다. 즉, EC2 인스턴스의 경우처럼 클러스터 노드에는 공유 스토리지가 없습니다.

Linux 용 SIOS Protection Suite 설치

VM 3 개 (node1, node2, 감시) 모두에서 다음 단계를 수행합니다.

SPS-Linux 설치 이미지 파일 (sps.img)을 다운로드하고 평가판 라이센스를 얻거나 영구 라이센스를 구입하십시오. 자세한 내용은 SIOS에 문의하십시오.

루프백 마운트하고 루트 (또는 루트 쉘을 얻으려면 먼저 "sudo su-")로 내부에서 "setup"스크립트를 실행합니다. 예 :

# mkdir / tmp / install

# mount -o loop sps.img / tmp / install

# cd / tmp / install

# ./설정

설치 스크립트가 진행되는 동안 여러 질문에 답하라는 메시지가 표시됩니다. 거의 모든 화면에서 Enter 키를 눌러 기본값을 적용합니다. 다음 예외에 유의하십시오.

  • "고 가용성 NFS"라는 화면에서 고 가용성 NFS 서버를 만들지 않을 것이므로 "n"을 선택할 수 있습니다.
  • 설치 스크립트가 끝날 무렵 지금 또는 나중에 평가판 라이센스 키를 설치하도록 선택할 수 있습니다. 나중에 라이센스 키를 설치하므로이 시점에서 "n"을 안전하게 선택할 수 있습니다.
  • "설정"의 마지막 화면에서 화면에 표시된 목록에서 설치할 ARK (응용 프로그램 복구 키트, 즉 "클러스터 에이전트")를 선택합니다.
    • ARK는 "node1"및 "node2"에서만 필요합니다. "witness"에 설치할 필요는 없습니다. 위쪽 / 아래쪽 화살표로 목록을 탐색하고 스페이스 바를 눌러 다음을 선택하십시오.
        • lkDR – Linux 용 DataKeeper
        • lkSQL – LifeKeeper MySQL RDBMS 복구 키트
      • 그러면“node1”및“node2”에 다음과 같은 추가 RPM이 설치됩니다.
        • steeleye-lkDR-9.0.2-6513.noarch.rpm steeleye-lkSQL-9.0.2-6513.noarch.rpm

Witness / Quorum 패키지 설치

LifeKeeper 코어의 기존 장애 조치 프로세스와 결합 된 LifeKeeper 용 Quorum / Witness Server 지원 패키지 (steeleye-lkQWK)를 사용하면 전체 네트워크 장애가 일반적 일 수있는 상황에서보다 확실하게 시스템 장애 조치를 수행 할 수 있습니다. 즉, "분할 브레인"상황의 위험을 크게 줄이면서 장애 조치를 수행 할 수 있습니다.

3 개 노드 (node1, node2, witness) 모두에 Witness / Quorum rpm을 설치합니다.

# cd / tmp / install / quorum

# rpm -Uvh steeleye-lkQWK-9.0.2-6513.noarch.rpm

3 개 노드 (node1, node2, Witness) 모두에서 / etc / default / LifeKeeper를 수정하고 NOBCASTPING = 1로 설정합니다.
Witness 서버 ( 'witness')에서만 / etc / default / LifeKeeper를 수정하고 WITNESS_MODE = off / none을 설정합니다.

EC2 복구 키트 패키지 설치

SPS-Linux는 리소스가 서로 다른 가용성 영역 및 지역의 노드간에 장애 조치를 취할 수 있도록하는 특정 기능을 제공합니다. 여기서 EC2 복구 키트 (즉, 클러스터 에이전트)는 가상 IP에 대한 연결이 활성 클러스터 노드로 라우팅되도록 라우팅 테이블을 조작하는 데 사용됩니다.

EC2 rpm (node1, node2)을 설치합니다.

# cd / tmp / install / amazon

# rpm -Uvh steeleye-lkECC-9.0.2-6513.noarch.rpm

라이센스 키 설치

3 개 노드 모두에서 "lkkeyins"명령을 사용하여 SIOS에서 얻은 라이센스 파일을 설치합니다.

# / opt / LifeKeeper / bin / lkkeyins <파일 경로> / <파일 이름> .lic

LifeKeeper 시작

3 개 노드 모두에서 "lkstart"명령을 사용하여 클러스터 소프트웨어를 시작합니다.

# / opt / LifeKeeper / bin / lkstart

LifeKeeper GUI에 대한 사용자 권한 설정

3 개의 노드 모두에서 새 Linux 사용자 계정 (예 :이 예에서는 "tony")을 만듭니다. / etc / group을 편집하고 "tony"사용자를 "lkadmin"그룹에 추가하여 LifeKeeper GUI에 대한 액세스 권한을 부여합니다. 기본적으로 "root"만 그룹의 구성원이며 여기에는 루트 암호가 없습니다.


# useradd tony

# 암호 토니

# vi / etc / group


lkadmin : x : 1001 : 루트, 토니

LifeKeeper GUI 열기

node1의 탄력적 IP (공용 IP) 주소에 VNC 연결을 설정합니다. 위의 VNC 구성에 따라 앞에서 지정한 VNC 암호를 사용하여 <Public_IP> : 2에 연결합니다. 로그인 한 후 터미널 창을 열고 다음 명령을 사용하여 LifeKeeper GUI를 실행하십시오.

# / opt / LifeKeeper / bin / lkGUIapp &

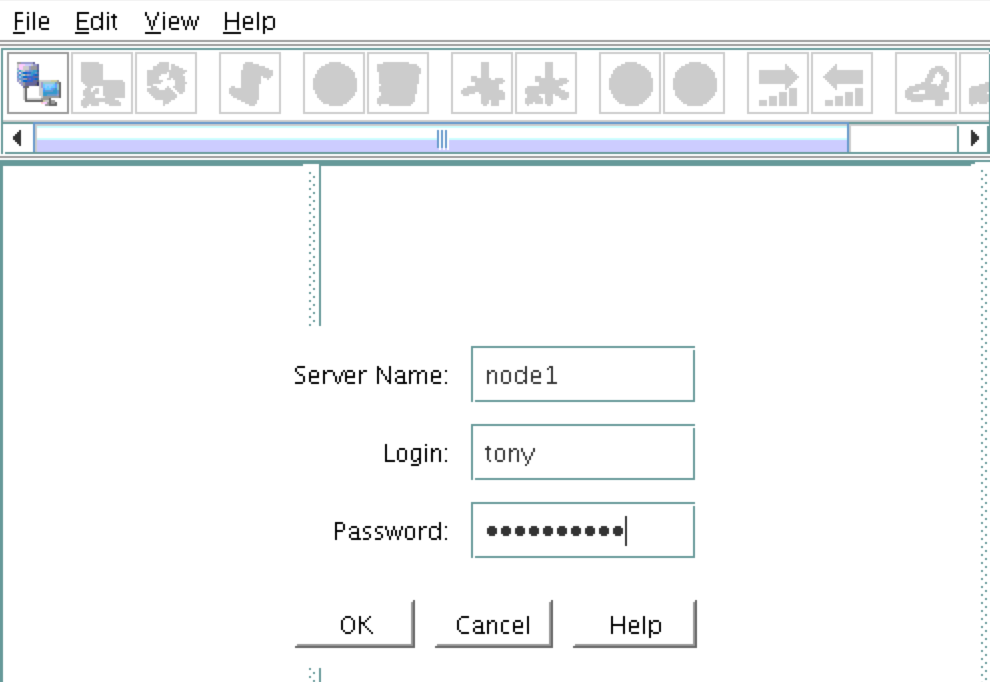
첫 번째 클러스터 노드 ( "node1")에 연결하라는 메시지가 표시됩니다. VM 생성 중에 지정된 Linux 사용자 ID 및 비밀번호를 입력하십시오.

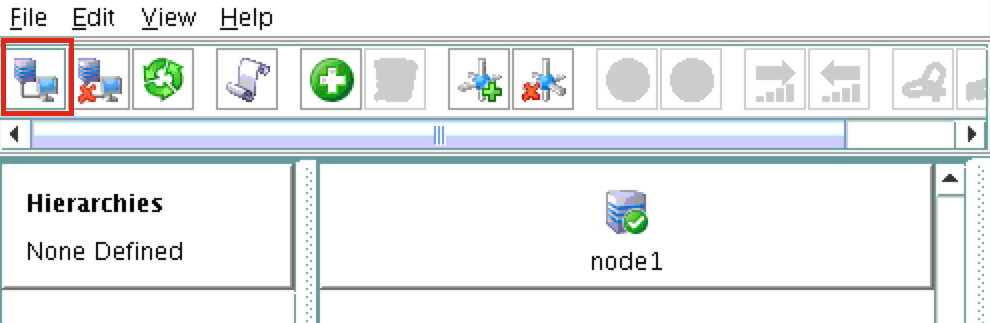
다음으로, 다음 스크린 샷에 강조 표시된 "서버에 연결"버튼을 클릭하여 "node2"와 "witness"모두에 연결합니다.

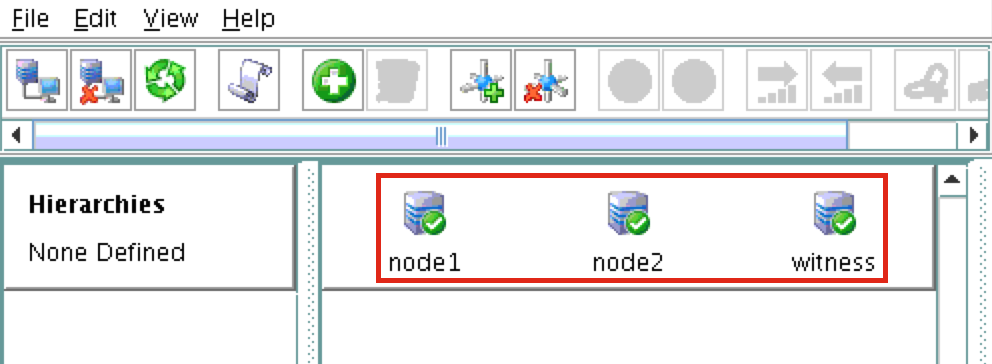
이제 GUI에 3 개의 서버가 모두 온라인 상태이고 정상임을 나타내는 녹색 확인 표시 아이콘이 표시됩니다.

통신 경로 생성

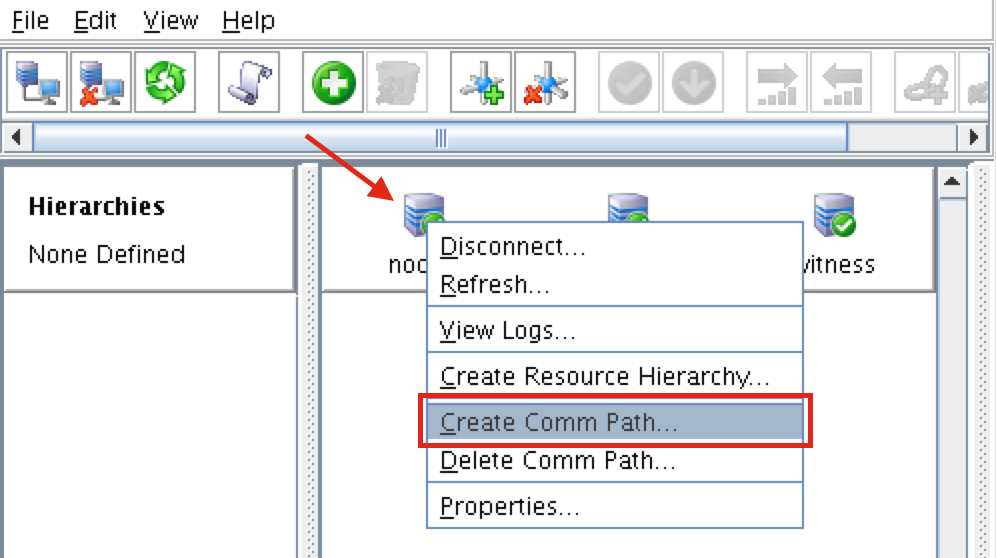
"node1"을 마우스 오른쪽 버튼으로 클릭하고 통신 경로 생성을 선택합니다.

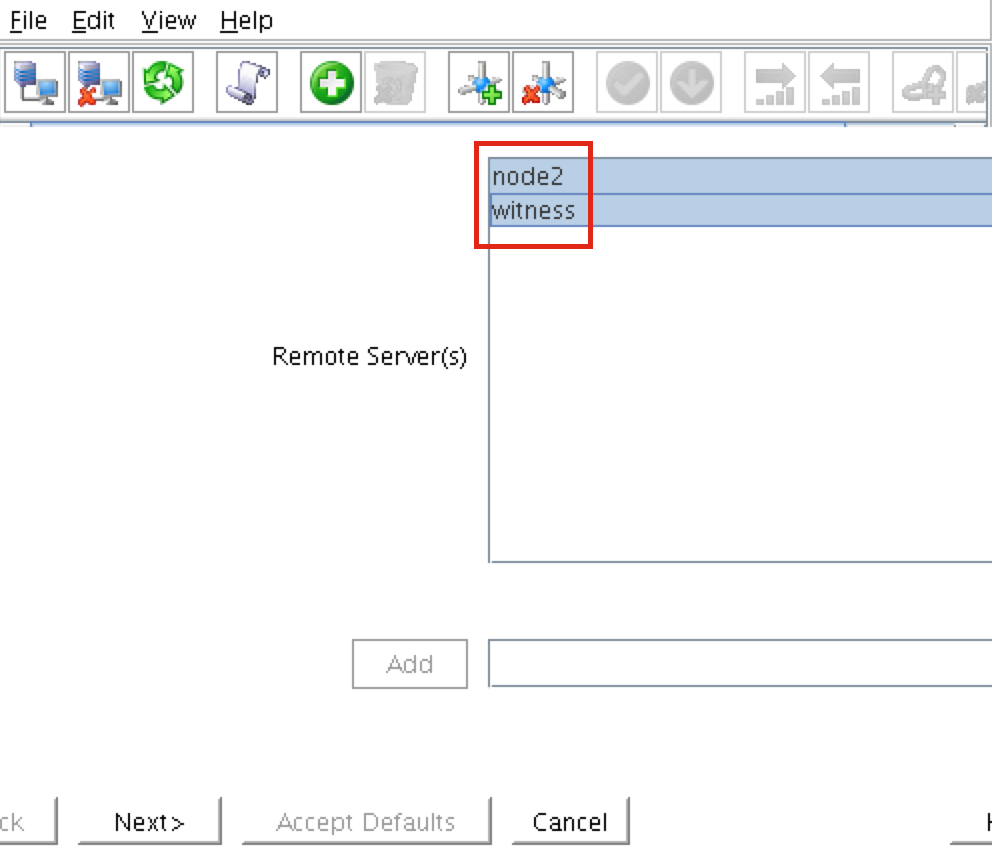
"node2"와 "witness"를 모두 선택한 다음 마법사를 따릅니다. 그러면 다음 사이에 통신 경로가 생성됩니다.


node1 및 node2 node1 및 감시


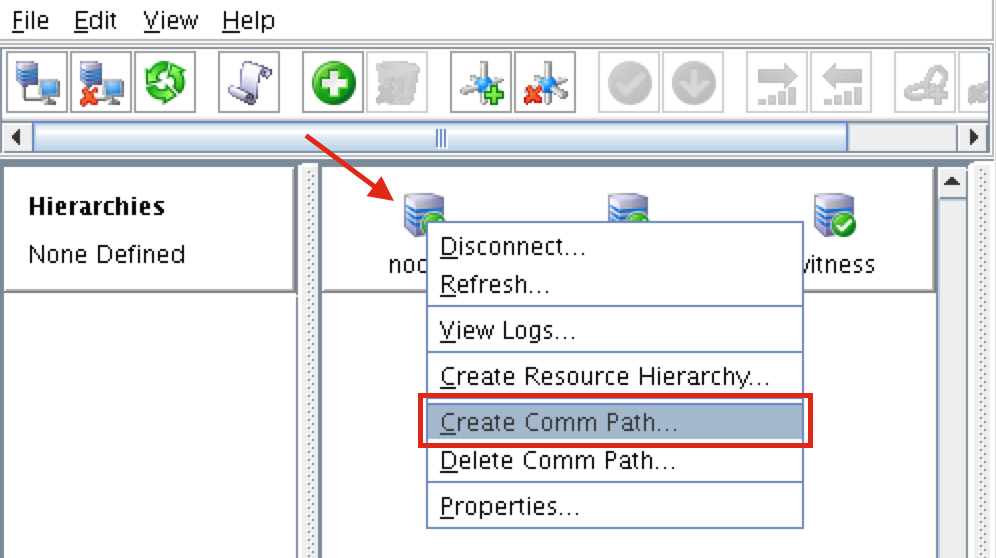
node2와 감시 사이에 통신 경로를 생성해야합니다. "node2"를 마우스 오른쪽 단추로 클릭하고 통신 경로 작성을 선택하십시오. 마법사를 따라 원격 서버로 "witness"를 선택합니다.


이 시점에서 다음과 같은 통신 경로가 생성되었습니다.

node1 <—> node2 node1 <—> 감시 node2 <—> 감시

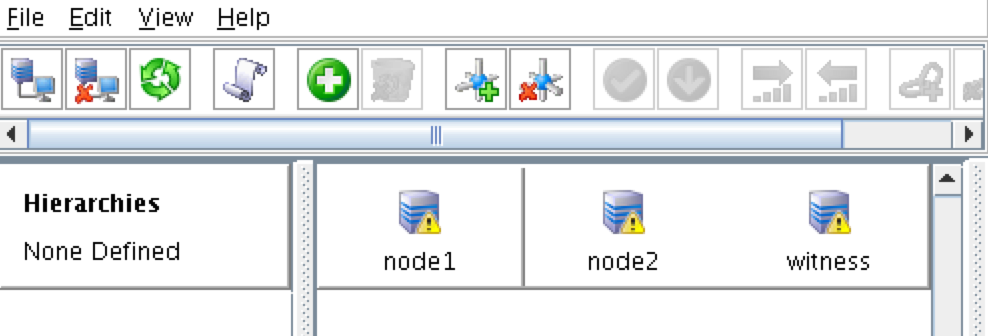
서버 앞의 아이콘이 녹색 "확인 표시"에서 노란색 "위험 표시"로 변경되었습니다. 이는 노드간에 통신 경로가 하나뿐이기 때문입니다.

VM에 여러 NIC가있는 경우 (여러 NIC로 Azure VM을 만드는 방법에 대한 정보는 여기에서 찾을 수 있지만이 문서에서는 다루지 않음) 각 서버간에 중복 통신 경로를 만듭니다.


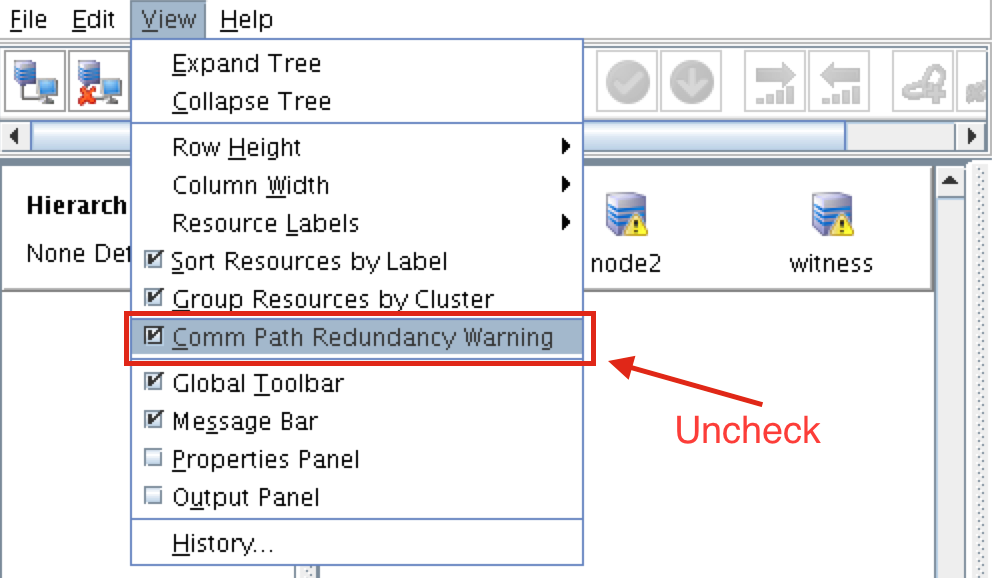
경고 아이콘을 제거하려면보기 메뉴로 이동하여 "통신 경로 중복 경고"를 선택 취소하십시오.


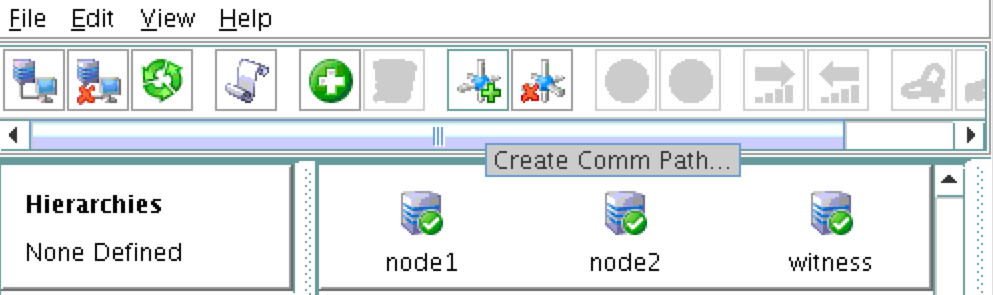
결과:


통신 경로 확인

클러스터 자원의 상태를 보려면 "lcdstatus"명령을 사용하십시오. 다음 명령을 실행하여 관련된 다른 두 서버에 대한 각 노드에서 통신 경로를 올바르게 작성했는지 확인하십시오.

# / opt / LifeKeeper / bin / lcdstatus -q -d node1
머신 네트워크 주소 / 장치 상태 PRIO node2 TCP 10.0.0.4/10.0.1.4

ALIVE 1 감시 TCP 10.0.0.4/10.0.2.4 ALIVE 1
# / opt / LifeKeeper / bin / lcdstatus -q -d node2
머신 네트워크 주소 / 장치 상태 PRIO node1 TCP 10.0.1.4/10.0.0.4

ALIVE 1 감시 TCP 10.0.1.4/10.0.2.4 ALIVE 1
# / opt / LifeKeeper / bin / lcdstatus -q -d 감시

머신 네트워크 주소 / 장치 상태 PRIO node1 TCP 10.0.2.4/10.0.0.4
ALIVE 1 node2 TCP 10.0.2.4/10.0.1.4 ALIVE 1

데이터 복제 클러스터 리소스 (예 : 거울)

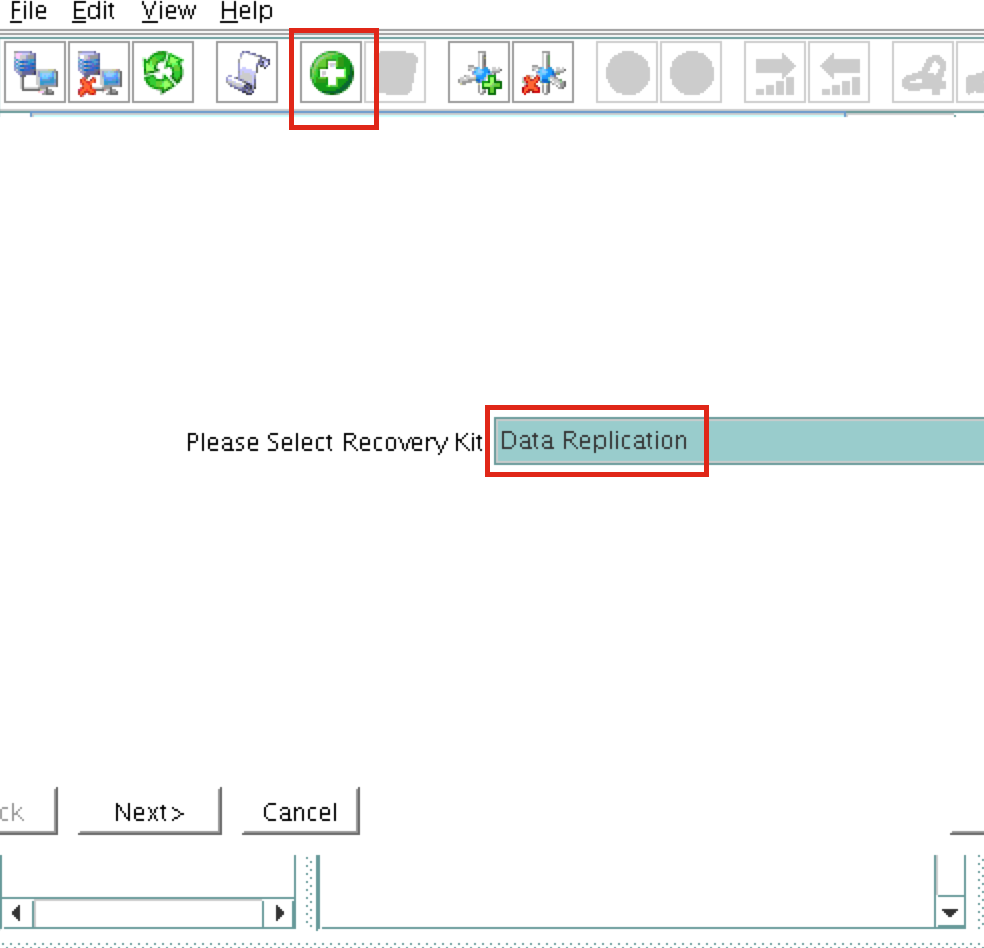
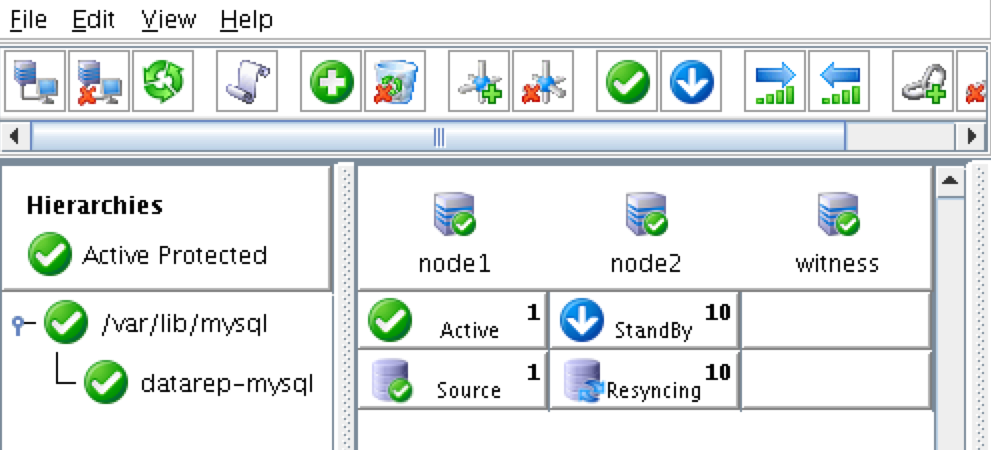
다음으로 데이터 복제 리소스를 생성하여 / var / lib / mysql 파티션을 node1 (소스)에서 node2 (대상)로 복제합니다. "녹색 더하기"아이콘을 클릭하여 새 리소스를 만듭니다.


다음 선택 사항으로 마법사를 따릅니다.

복구 키트를 선택하십시오 : 데이터 복제 스위치 백 유형 : 지능형

서버 : node1

계층 유형 : 기존 파일 시스템 복제

기존 마운트 포인트 : / var / lib / mysql

데이터 복제 리소스 태그 : datarep-mysql

파일 시스템 리소스 탭 : / var / lib / mysql

비트 맵 파일 : (기본값)

비동기 복제 활성화 : 아니요

리소스가 생성되면 "확장"(즉, 백업 서버 정의) 마법사가 나타납니다.

다음 선택을 사용하십시오.

대상 서버 : node2 스위치 백 유형 : 지능형 템플릿 우선 순위 : 1

대상 우선 순위 : 10 대상 디스크 : / dev / xvdb1

데이터 복제 리소스 태그 : datarep-mysql 비트 맵 파일 : (기본값)

복제 경로 : 10.0.0.4/10.0.1.4 마운트 지점 : / var / lib / mysql

루트 태그 : / var / lib / mysql

클러스터는 다음과 같습니다.

가상 IP 생성

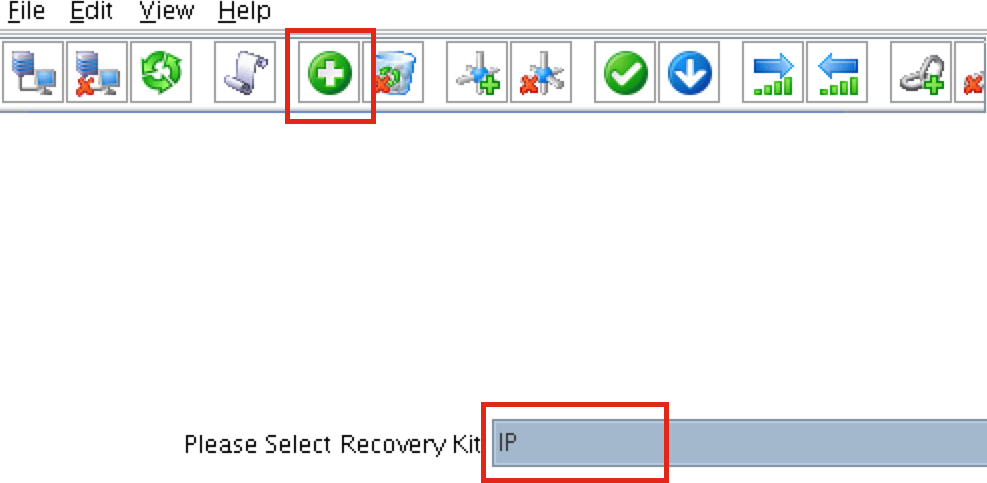
다음으로 가상 IP 클러스터 리소스를 만듭니다. "녹색 더하기"아이콘을 클릭하여 새 리소스를 만듭니다.


마법사를 따라 다음 선택 사항으로 IP 리소스를 만듭니다.

복구 키트 선택 : IP 스위치 백 유형 : 지능형 IP 리소스 : 10.1.0.10

넷 마스크 : 255.255.255.0

네트워크 인터페이스 : eth0

IP 리소스 태그 : ip-10.1.0.10

다음 선택 사항으로 IP 자원을 확장하십시오.

스위치 백 유형 : 지능형 템플릿 우선 순위 : 1

타겟 우선 순위 : 10

IP 리소스 : 10.1.0.10

넷 마스크 : 255.255.255.0

네트워크 인터페이스 : eth0

IP 리소스 태그 : ip-10.1.0.10

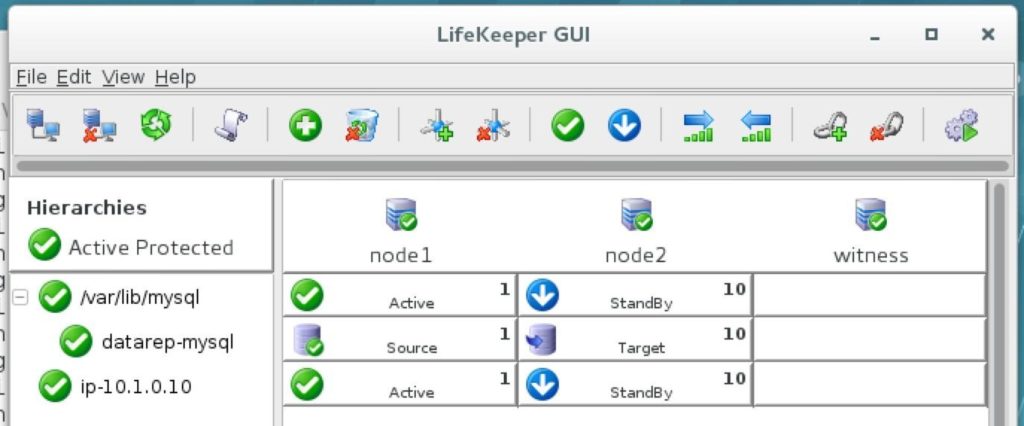
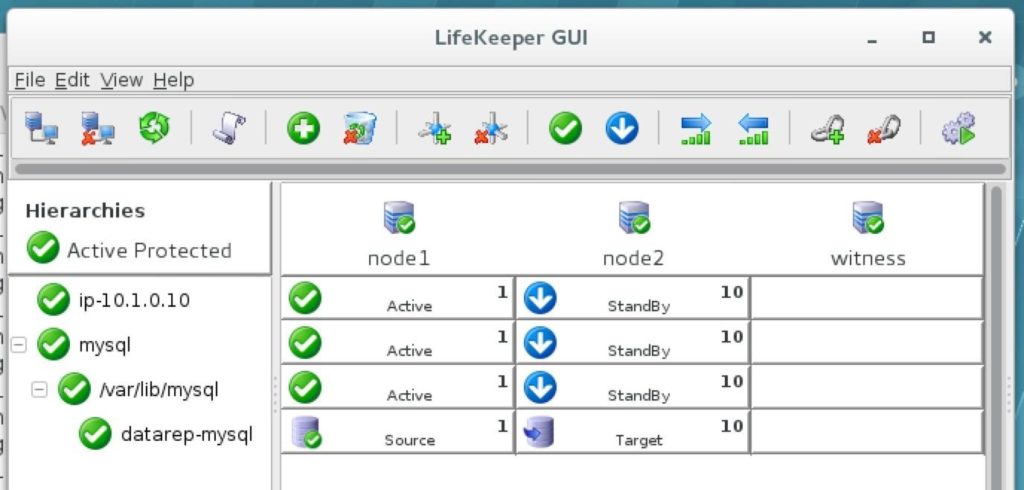
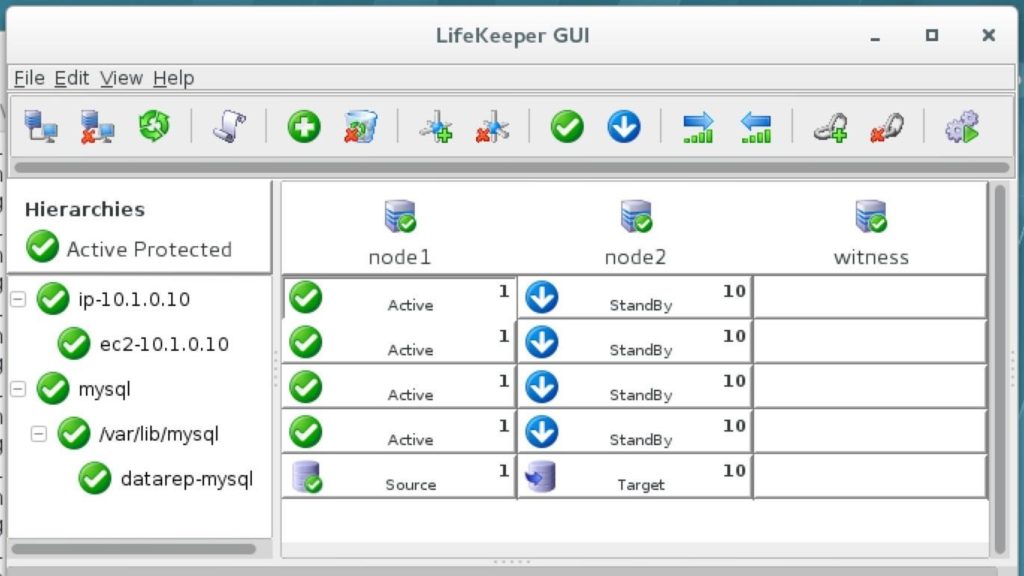
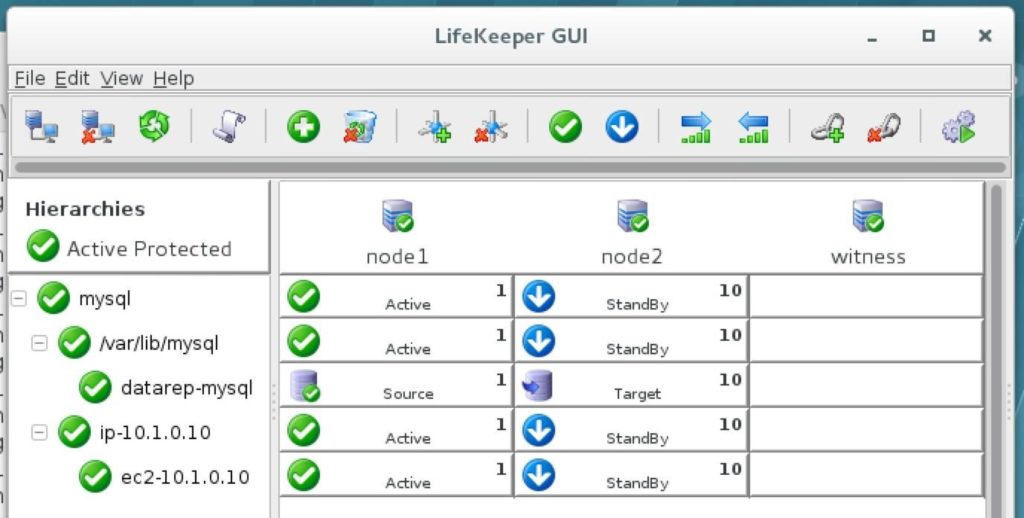
클러스터는 이제 미러 및 IP 리소스가 모두 생성 된 다음과 같이 표시됩니다.

IP 리소스에 대한 Ping 목록 구성

기본적으로 SPS-Linux는 브로드 캐스트 핑을 수행하여 IP 리소스의 상태를 모니터링합니다. 많은 가상 및 클라우드 환경에서 브로드 캐스트 핑이 작동하지 않습니다. 이전 단계에서 "NOBCASTPING = 1"을
/ etc / default / LifeKeeper는 브로드 캐스트 핑 검사를 해제합니다. 대신 핑 목록을 정의합니다.

이 IP 리소스에 대한 IP 상태 확인 중에 핑할 IP 주소 목록입니다.

이 가이드에서는 감시 서버 (10.0.2.4)를 핑 목록에 추가합니다.

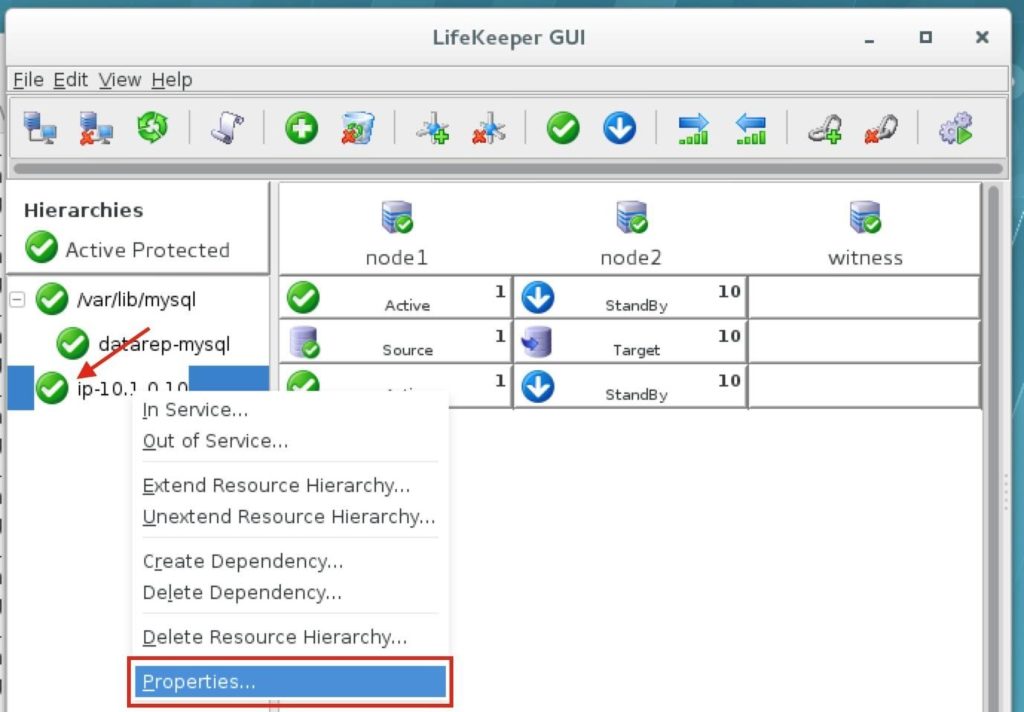
IP 리소스 (ip-10.1.0.10)를 마우스 오른쪽 버튼으로 클릭하고 속성을 선택합니다.

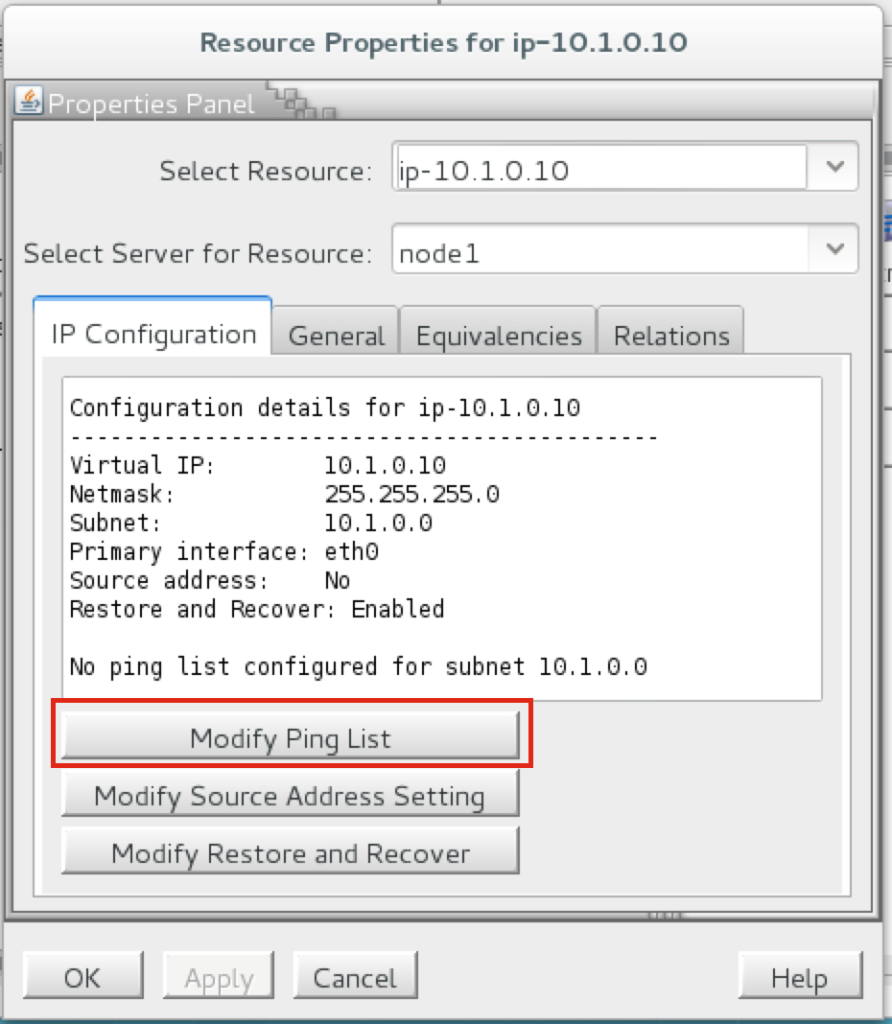
처음에는 10.1.0.0 서브넷에 대해 핑 목록이 구성되어 있지 않음을 알 수 있습니다. "Ping 목록 수정"을 클릭합니다.

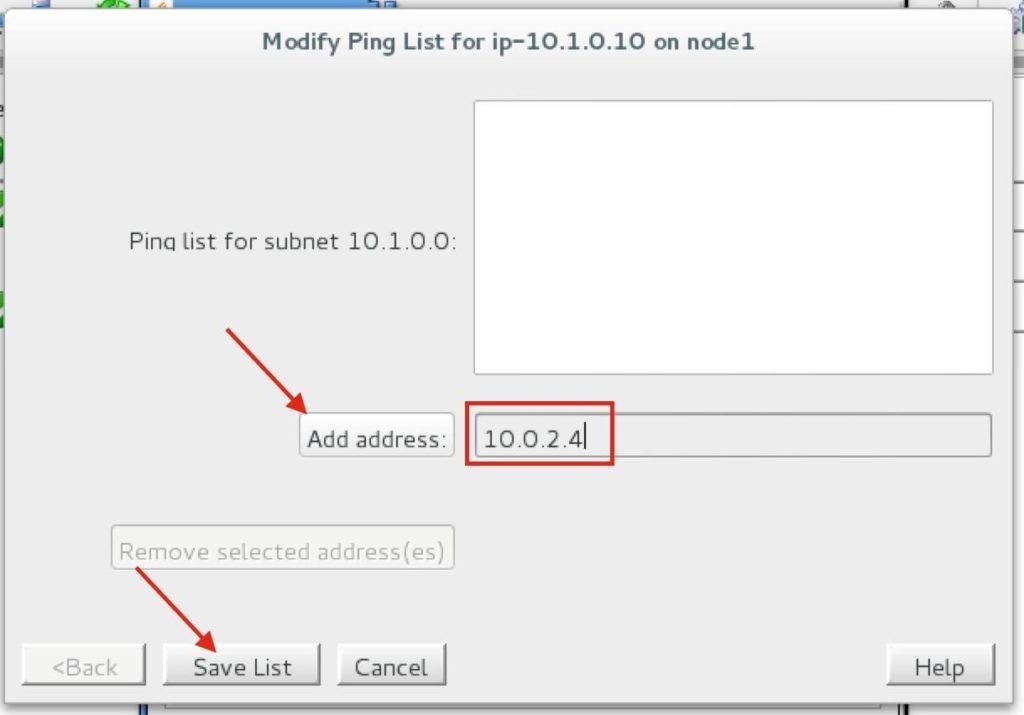
"10.0.2.4"(감시 서버의 IP 주소)를 입력하고 "주소 추가"를 클릭 한 다음 마지막으로 "목록 저장"을 클릭합니다.


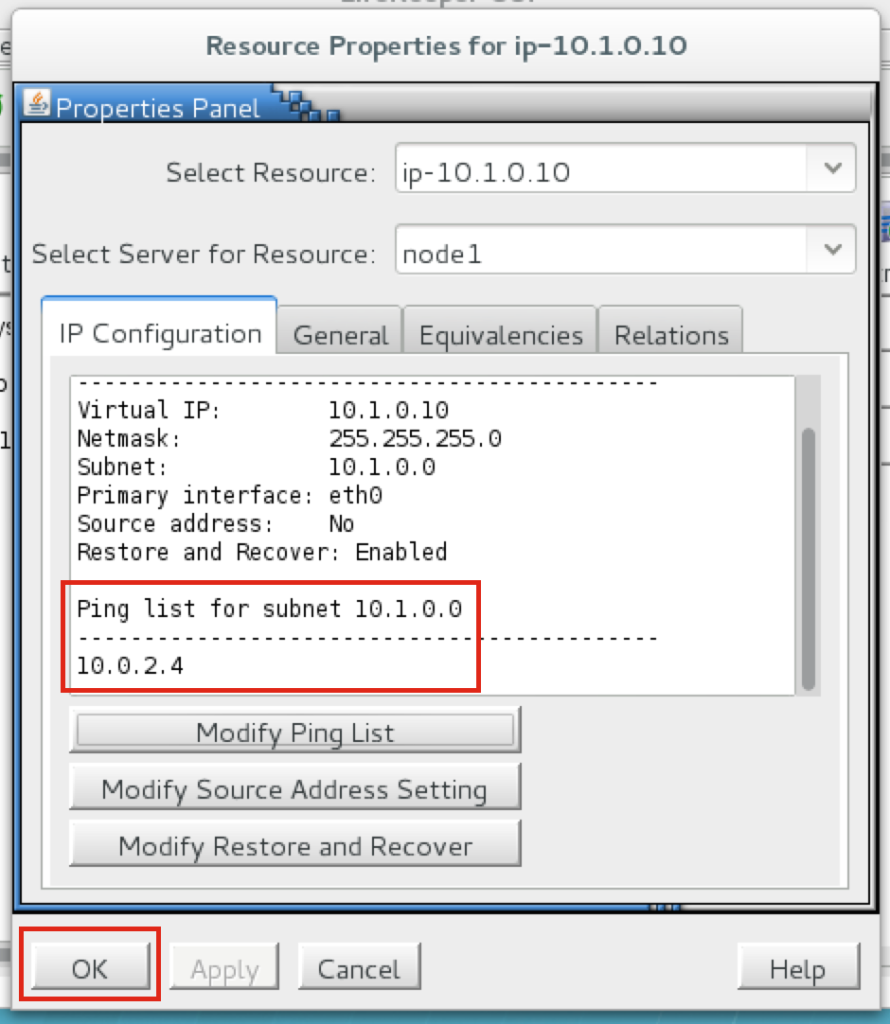
IP 속성 패널로 돌아가서 10.0.2.4가 핑 목록에 추가되었는지 확인할 수 있습니다. 확인을 클릭하여 창을 닫습니다.

MySQL 리소스 계층 만들기

다음으로 MySQL 클러스터 리소스를 생성합니다. MySQL 리소스는 MySQL 데이터베이스의 중지 / 시작 / 모니터링을 담당합니다.

MySQL 리소스를 만들기 전에 데이터베이스가 실행 중인지 확인하십시오. “ps -ef | grep sql”을 확인하십시오.

실행 중이라면 할 일이 없습니다. 그렇지 않은 경우 데이터베이스 백업을 시작하십시오.

# mysqld_safe –user = root –socket = / var / lib / mysql / mysql.sock –port = 3306 –datadi

마법사를 따라 다음 선택 항목으로 IP 리소스를 생성합니다. 생성하려면 "녹색 더하기"아이콘을 클릭하여 새 리소스를 생성합니다.

복구 키트 선택 : MySQL 데이터베이스 전환 유형 : 지능형 서버 : node1

my.cnf의 위치 : / var / lib / mysql

MySQL 실행 파일의 위치 : / usr / bin

데이터베이스 태그 : mysql

다음 선택 사항으로 IP 자원을 확장하십시오.

대상 서버 : node2 스위치 백 유형 : 지능형 템플릿 우선 순위 : 1

타겟 우선 순위 : 10

결과적으로 클러스터는 다음과 같이 보입니다. 데이터 복제 리소스는 항상 데이터베이스보다 먼저 온라인 상태가되도록 데이터베이스 아래로 자동으로 이동되었습니다 (종속성이 자동으로 생성됨).

장애 조치시 라우팅 테이블을 관리하기위한 EC2 리소스 생성

SPS-Linux는 리소스가 서로 다른 가용성 영역 및 지역의 노드간에 장애 조치를 취할 수 있도록하는 특정 기능을 제공합니다. 여기서 EC2 복구 키트 (즉, 클러스터 에이전트)는 가상 IP에 대한 연결이 활성 클러스터 노드로 라우팅되도록 라우팅 테이블을 조작하는 데 사용됩니다.

만들려면 "녹색 더하기"아이콘을 클릭하여 새 리소스를 만듭니다.


마법사를 따라 다음 선택 사항으로 EC2 리소스를 생성합니다.

복구 키트 선택 : Amazon EC2 스위치 백 유형 : 지능형 서버 : node1

EC2 홈 : / opt / aws

EC2 URL : ec2.us-west-2.amazonaws.com

AWS 액세스 키 : (이전에 얻은 액세스 키 입력) AWS 보안 키 : (이전에 얻은 보안 키 입력) EC2 리소스 유형 : RouteTable (백엔드 클러스터)

IP 리소스 : ip-10.1.0.10

EC2 리소스 태그 : ec2-10.1.0.10

다음 선택 사항으로 IP 자원을 확장하십시오.

대상 서버 : node2 스위치 백 유형 : 지능형 템플릿 우선 순위 : 1

타겟 우선 순위 : 10

EC2 리소스 태그 : ec2-10.1.0.10

클러스터는 다음과 같습니다. EC2 리소스가 IP 리소스 아래에 어떻게 있는지 확인하십시오.

IP 리소스와 MySQL 데이터베이스 리소스 사이에 종속성 만들기

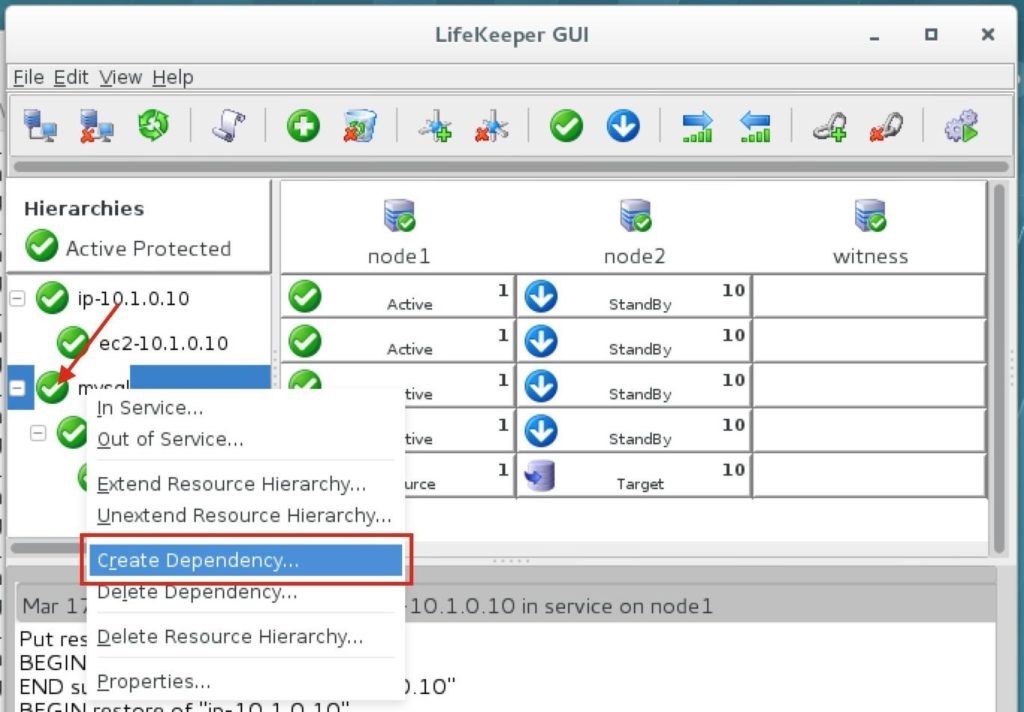
IP 리소스와 MySQL 데이터베이스 리소스 사이에 종속성을 만들어 그룹으로 함께 장애 조치합니다. "mysql"리소스를 마우스 오른쪽 버튼으로 클릭하고 "종속성 생성"을 선택합니다.

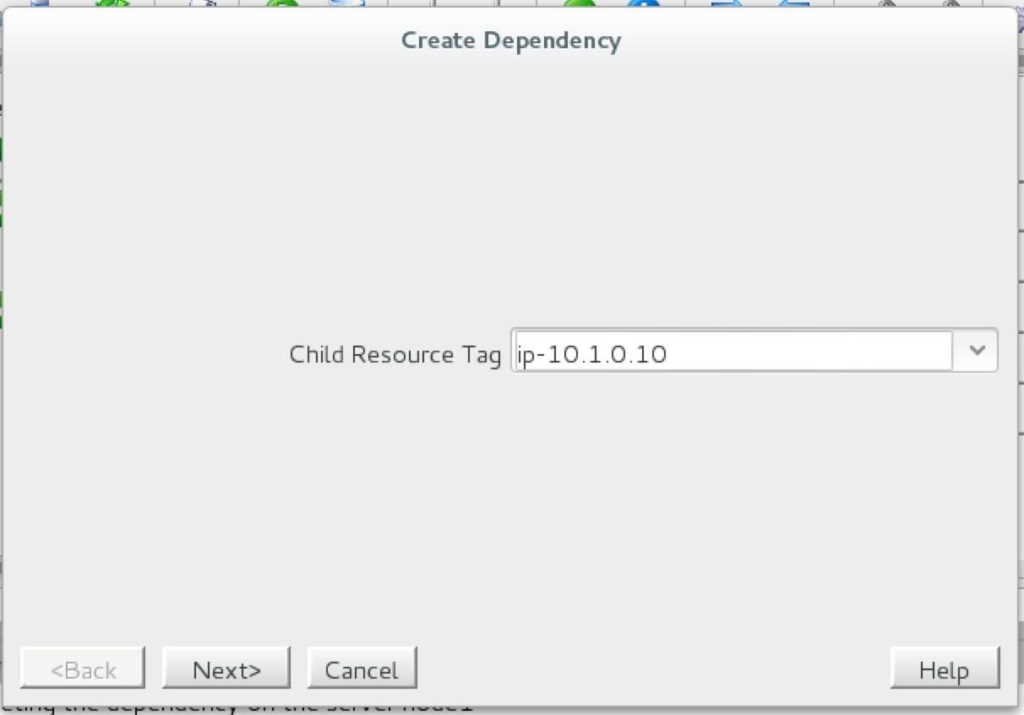
다음 화면에서 "ip-10.1.0.10"리소스를 종속성으로 선택합니다. 다음을 클릭하고 마법사를 계속합니다.

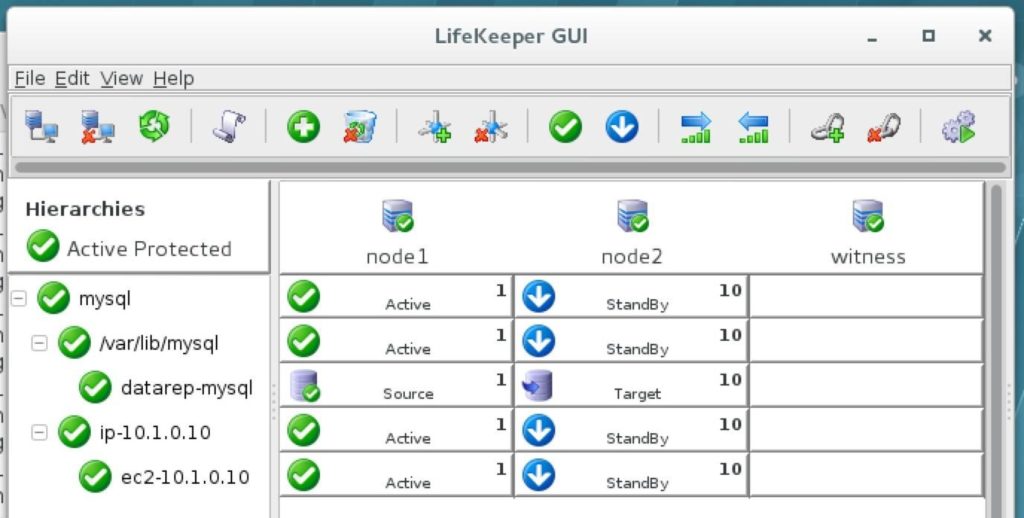
이 시점에서 SPS-Linux 클러스터 구성이 완료되었습니다. 리소스 계층 구조는 다음과 같습니다.

15 단계 : 클러스터 연결 테스트

이제 모든 Amazon EC2 및 클러스터 구성이 완료되었습니다! 클러스터 리소스는 현재 node1에서 활성화되어 있습니다.

미러링 모니터 서버 (또는 다른 Linux 인스턴스가있는 경우)에서 클러스터에 대한 연결을 테스트하여 미러링 모니터 서버 "sudo su-"로 연결하여 루트 액세스 권한을 얻습니다. 필요한 경우 mysql 클라이언트를 설치합니다.

[root@witness ~]# yum -y mysql 설치

클러스터에 대한 MySQL 연결을 테스트합니다.

[root@witness ~]# mysql –host = 10.1.0.10 mysql -u root -p

다음 MySQL 쿼리를 실행하여 활성 클러스터 노드의 호스트 이름을 표시합니다.

MariaD[mysql]B> @@ hostname 선택;

++

| @@ hostname |

++

| node1 |

++

세트의 행 1 개 (0.00 초) MariaDB[mysql]>

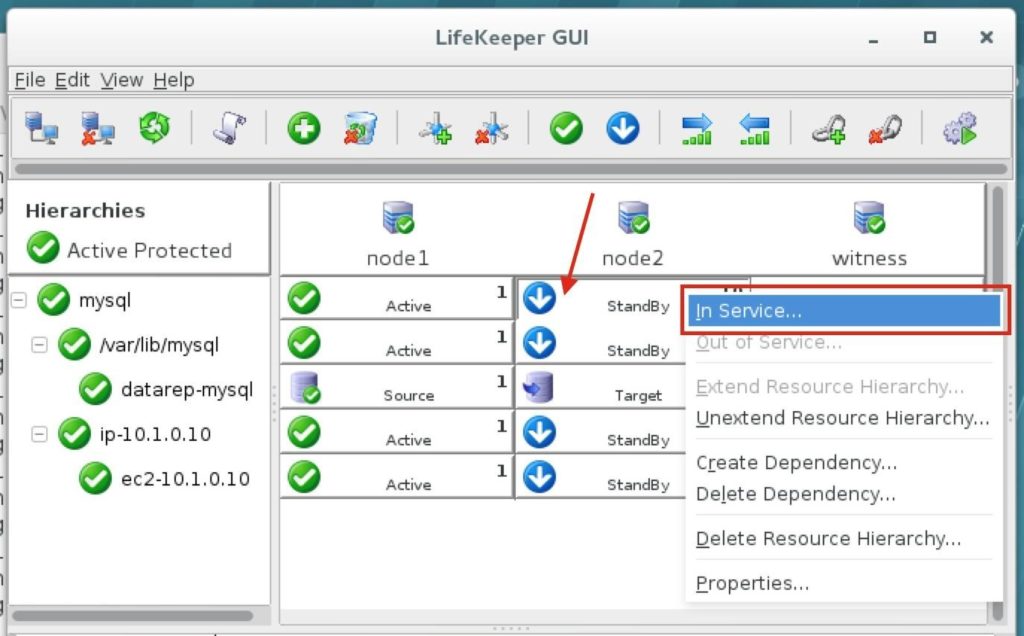
LifeKeeper GUI를 사용하여 Node1에서 장애 조치-> Node2 ″. node2 아래의 mysql 리소스를 마우스 오른쪽 버튼으로 클릭하고 "In Service…"를 선택합니다.

장애 조치가 완료된 후 MySQL 쿼리를 다시 실행합니다. MySQL 클라이언트가 세션이 손실되었음을 감지하고 (장애 조치 중에) 자동으로 다시 연결됩니다.

다음 MySQL 쿼리를 실행하여 활성 클러스터 노드의 호스트 이름을 표시하고 이제 "node2"가 활성 상태인지 확인합니다.

MariaD[mysql]B> @@ hostname 선택;

오류 2006 (HY000) : MySQL 서버가 사라졌습니다. 연결이 없습니다. 다시 연결하는 중…

연결 ID : 12

현재 데이터베이스 : mysql

++

| @@ hostname |

++

| node2 |

++

세트의 행 1 개 (0.53 초) MariaDB[mysql]>

SIOS의 허가를 받아 복제


Filed Under: 서버 클러스터 단순화 Tagged With: AWS, 리눅스, 아마존

비디오 : SIOS 클러스터링 이점

6월 24, 2019 by Jason Aw Leave a Comment

SIOS 비디오 SIOS 클러스터링 이점

비디오 : SIOS 클러스터링 이점

매년 귀하의 작업은 기존 인프라를 사용하여 더 높은 수준의 서비스를 제공하고 IT 예산은 더 적을 것입니다. 가동 중지 시간 또는 데이터 손실에 대한 허용 오차가 사라졌습니다.  애플리케이션은 연중 무휴로 작동해야하며 서버 중단, 네트워킹 중단, 애플리케이션 중단 또는 전체 데이터 센터 손실의 경우에도 보호해야합니다. 중단 시간과 데이터 손실 양은 "0"으로 수렴 할 것으로 예상됩니다. IT 전문가는 물리적 서버, 가상 서버 또는 클라우드 기술의 배포 여부에 관계없이 최종 사용자를 지원하는 방법에 대한 그 어느 때보 다 많은 옵션을 보유하고 있습니다. 솔루션을 선택하는 것은 비즈니스 목표, 기술 요구 사항 및 예산 제한을 이해하는 것뿐만 아니라 항상 환경을 보호하여 중단 시간이나 데이터 손실이 없는지 확인하는 방법을 이해해야 할 필요성을 이해하는 데 있습니다. 이는 일반적으로 몇 가지 유형의 공유 저장 장치에 연결된 둘 이상의 서버를 포함하는 전통적인 SAN 기반 클러스터를 구현함으로써 수행됩니다. 문제가있는 경우 응용 프로그램을 종료하고 모든 것을 온라인 상태로 되돌립니다. SIOS 소프트웨어는이를 지원하고 쉽게 설정하고 관리 할 수 있습니다. SAN 기반 클러스터는 로컬 고 가용성에 적합하지만 SAN은 일반적으로 클러스터 아키텍처의 높은 비용, 복잡성, 잠재적 장애를 나타내며 재해 복구 문제를 해결하는 데 도움이되지 않습니다. SIOS 소프트웨어를 사용하면 선택한 하드웨어를 사용하지만 로컬 스토리지를 활용하여 클러스터를 구축 할 수 있습니다. SIOS는 완전히 클러스터 인식 및 통합 된 실시간 블록 레벨 데이터 복제 기능을 제공하므로 클러스터 구성에서 매우 빠른 로컬 스토리지를 활용할 수 있습니다. 또한 SANLess 클러스터를 채택하면 SAN을 제거하여 전체 솔루션 비용을 줄일 수 있습니다. 결과적으로 SAN 하드웨어의 비용을 절감했을뿐만 아니라 SAN 라이센스 절감과 함께 SAN 인프라 및 관리 비용을 절감 할 수 있습니다. 또한 클러스터링 아키텍처에서 단일 장애 지점을 제거하여 전체 환경을 감소시키지 않습니다. 또한 실시간 블록 레벨 데이터 복제 기술이 로컬 스토리지를 동기화 상태로 유지하기 때문에 데이터 손실을 방지 할 수 있습니다. 이 소프트웨어에는 사용자 친화적 인 마법사 기반 사용자 인터페이스가 있습니다. SIOS는 물리적 환경, 가상 환경 또는 클라우드 환경에서 미션 크리티컬 애플리케이션과 데이터를 보호 할 수있는 유연성을 제공합니다.  고 가용성 솔루션에 대해 자세히 알아보십시오.

SIOS 클러스터링 소프트웨어로 애플리케이션을 쉽게 보호하는 방법에 대해 알아보십시오.

Filed Under: 뉴스 및 이벤트 Tagged With: AWS QuickStart, HA 클러스터 - 클라우드, SQL Server 장애 조치 (failover) 클러스터, 고성능 스토리지, 리눅스, 물리적 서버

비디오 : SIOS 클러스터링 이점

4월 20, 2019 by Jason Aw Leave a Comment

SIOS 클러스터링 이점

SIOS 클러스터링 이점

SIOS 클러스터링 소프트웨어로 애플리케이션을 쉽게 보호하는 방법에 대해 알아보십시오.

매년 귀하의 작업은 기존 인프라를 사용하여 더 높은 수준의 서비스를 제공하고 IT 예산은 더 적을 것입니다. 가동 중지 시간 또는 데이터 손실에 대한 허용 오차가 사라졌습니다.  애플리케이션은 연중 무휴로 작동해야하며 서버 중단, 네트워킹 중단, 애플리케이션 중단 또는 전체 데이터 센터 손실의 경우에도 보호해야합니다. 다운 타임의 양과 데이터 손실 양은 "0"으로 수렴 할 것으로 예상됩니다.

IT 전문가는 실제 서버, 가상 서버 또는 클라우드 기술의 배포 여부에 관계없이 최종 사용자를 지원하는 방법에 대한 그 어느 때보 다 많은 옵션을 보유하고 있습니다. 솔루션을 선택하는 것은 비즈니스 목표, 기술 요구 사항 및 예산 제한을 이해하는 것뿐만 아니라 항상 환경을 보호하여 중단 시간이나 데이터 손실이 없는지 확인하는 방법을 이해해야 할 필요성을 이해하는 데 있습니다.

이는 일반적으로 몇 가지 유형의 공유 저장 장치에 연결된 둘 이상의 서버를 포함하는 전통적인 SAN 기반 클러스터를 구현함으로써 수행됩니다. 문제가있는 경우 응용 프로그램을 종료하고 모든 것을 온라인 상태로 되돌립니다. SIOS 소프트웨어는이를 지원하고 쉽게 설정하고 관리 할 수 있습니다. SAN 기반 클러스터는 로컬 고 가용성에 적합하지만 SAN은 일반적으로 클러스터 아키텍처의 높은 비용, 복잡성, 잠재적 장애를 나타내며 재해 복구 문제를 해결하는 데 도움이되지 않습니다.

SIOS 소프트웨어를 사용하면 선택한 하드웨어를 사용하지만 로컬 스토리지를 활용하여 클러스터를 구축 할 수 있습니다. SIOS는 완전히 클러스터 인식 및 통합 된 실시간 블록 레벨 데이터 복제 기능을 제공하므로 클러스터 구성에서 매우 빠른 로컬 스토리지를 활용할 수 있습니다. 또한 SANLess 클러스터를 채택하면 SAN을 제거하여 전체 솔루션 비용을 줄일 수 있습니다. 결과적으로 SAN 하드웨어의 비용을 절감했을뿐만 아니라 SAN 라이센스 절감과 함께 SAN 인프라 및 관리 비용을 절감 할 수 있습니다. 또한 클러스터링 아키텍처에서 단일 장애 지점을 제거하여 전체 환경을 감소시키지 않습니다. 또한 실시간 블록 레벨 데이터 복제 기술이 로컬 스토리지를 동기화 상태로 유지하기 때문에 데이터 손실을 방지 할 수 있습니다. 이 소프트웨어에는 사용자 친화적 인 마법사 기반 사용자 인터페이스가 있습니다.

SIOS는 물리적 환경, 가상 환경 또는 클라우드 환경에서 미션 크리티컬 애플리케이션과 데이터를 보호 할 수있는 유연성을 제공합니다.  고 가용성 솔루션에 대해 자세히 알아보십시오.

Filed Under: 뉴스 및 이벤트 Tagged With: AWS QuickStart, HA 클러스터 - 클라우드, SQL Server 장애 조치 (failover) 클러스터, 고성능 스토리지, 리눅스, 물리적 서버

  • « Previous Page
  • 1
  • 2
  • 3
  • 4
  • Next Page »

최근 게시물

  • (제목 없음)
  • 인공지능은 빠르게 발전하고 있습니다. 핵심 애플리케이션은 여전히 ​​가동되어야 합니다.
  • 고가용성(HA)이란 무엇인가요?
  • 금요일 밤의 시스템 충돌에서 살아남기: 초라한 베어메탈에서 완벽한 데이터 복제까지
  • Grounded: 암스테르담에서 열린 Percona Live에 참석하지 못한 것이 제게 HA에 대해 가르쳐준 것

가장 인기있는 게시물

우리의 메일 링리스트에 가입하세요

Copyright © 2026 · Enterprise Pro Theme on Genesis Framework · WordPress · Log in