SIOS SANless clusters

SIOS SANless clusters High-availability Machine Learning monitoring

  • Home
  • Products
    • SIOS DataKeeper for Windows
    • SIOS Protection Suite for Linux
  • การทดสอบอาหารสัตว์
  • ข่าวสารและกิจกรรม
  • ทำให้เข้าใจง่ายเซิร์ฟเวอร์คลัสเตอร์
  • เรื่องราวความสำเร็จ
  • ติดต่อเรา
  • English
  • 中文 (中国)
  • 中文 (台灣)
  • 한국어
  • Bahasa Indonesia
  • ไทย

ความเร็วเครือข่ายระหว่างภูมิภาค Azure เชื่อมต่อกับ Peering เครือข่ายเสมือน

ตุลาคม 18, 2018 by Jason Aw Leave a Comment

ความเร็วของเครือข่ายระหว่างภูมิภาค Azure เชื่อมต่อกับ Peering เครือข่ายเสมือนเป็นอย่างไร

นี่คือคำถามที่ฉันถามตัวเองในวันนี้ แน่นอนฉันไม่สามารถหาเหตุผลที่อยู่เบื้องหลังความเร็วของเครือข่ายระหว่างภูมิภาค Azure เชื่อมต่อกับ Peering เครือข่ายเสมือนจริงเอกสารที่ใดก็ได้ ฉันสมมติว่าไม่มีการรับประกันใด ๆ อาจขึ้นอยู่กับการใช้ประโยชน์ในปัจจุบัน ฯลฯ ถ้าฉันผิดคนกรุณาชี้ฉันไปที่เอกสารที่ระบุความเร็วที่ใช้ได้ ส่วนใหญ่ฉันมองที่นี่และที่นี่ ดังนั้นฉันจึงติดตั้ง Windows V3 instance ของ Windows 2016 D4s ไว้ที่หนึ่งในอเมริกากลางและเป็นหนึ่งใน US US US Dollar 2 ทั้งคู่เป็นพื้นที่ที่จับคู่ ถ้าคุณไม่ทราบว่า peering คืออะไรคุณสามารถเชื่อมต่อเครือข่ายเสมือน Azure สองแบบได้โดยง่าย Peering เป็นเรื่องง่ายมากที่จะติดตั้ง เพียงตรวจสอบให้แน่ใจว่าคุณได้กำหนดค่าจากทั้ง Virtual Networks เมื่อมีการกำหนดค่าอย่างถูกต้องแล้วจะมีลักษณะดังนี้

การทดสอบ

เครือข่าย peered ที่ทำงานอย่างถูกต้องใน Azure [/ caption]

จากนั้นผมก็ดาวน์โหลด iPerf3 ในแต่ละเซิร์ฟเวอร์และเริ่มการทดสอบของฉัน ตอนแรกฉันมีผลลัพธ์ที่น่าผิดหวังมาก แต่จากนั้นเมื่อทำวิจัยบางอย่างผมพบว่าการเรียกใช้หลายเธรดและการเพิ่มขนาดหน้าต่างรายงานการวัดแบนด์วิธที่มีอยู่ได้แม่นยำมากขึ้น ฉันลองตั้งค่าที่ต่างกันเล็กน้อย ดูเหมือนว่าจะมีขนาดสูงสุดที่ประมาณ 1.9 Gbps โดยเฉลี่ยดีกว่า 45 Mbps! ฉันใช้พารามิเตอร์ของลูกค้าและให้ผลลัพธ์ที่ดีที่สุด ดูดังนี้

iperf3.exe -c 10.0.3.4 -w32M -P 4 -t 30

ตัวอย่างของผลลัพธ์นั้นมีลักษณะดังนี้

- - - - - - - - - - - - - - - - - - - - - - - - -
 [4] 2.00-3.00 วินาที 34.1 MBytes 286 Mbits / วินาที
 [6] 2.00-3.00 วินาที 39.2 MBytes 329 Mbits / วินาที
 [8] 2.00-3.00 วินาที 56.1 MBytes 471 Mbits / วินาที
 [10] 2.00-3.00 วินาที 73.2 MBytes 615 Mbits / วินาที
 [SUM] 2.00-3.00 วินาที 203 MBytes 1.70 Gbits / วินาที
 - - - - - - - - - - - - - - - - - - - - - - - - -
 [4] 3.00-4.00 วินาที 37.5 MBytes 315 Mbits / วินาที
 [6] 3.00-4.00 วินาที 19.9 เมกะไบต์ 167 Mbits / วินาที
 [8] 3.00-4.00 วินาที 97.0 เมกะไบต์ 814 Mbits / วินาที
 [10] 3.00-4.00 วินาที 96.8 MBytes 812 Mbits / วินาที
 [SUM] 3.00-4.00 วินาที 251 MBytes 2.11 Gbits / วินาที
 - - - - - - - - - - - - - - - - - - - - - - - - -
 [4] 4.00-5.00 วินาที 34.6 MBytes 290 Mbits / วินาที
 [6] 4.00-5.00 วินาที 24.6 MBytes 207 Mbits / วินาที
 [8] 4.00-5.00 วินาที 70.1 เมกะไบต์ 588 Mbits / วินาที
 [10] 4.00-5.00 วินาที 97.8 MBytes 820 Mbits / วินาที
 [SUM] 4.00-5.00 วินาที 227 MBytes 1.91 Gbits / วินาที
 - - - - - - - - - - - - - - - - - - - - - - - - -
 [4] 5.00-6.00 วินาที 34.5 MBytes 289 Mbits / วินาที
 [6] 5.00-6.00 วินาที 31.9 เมกะไบต์ 267 Mbits / วินาที
 [8] 5.00-6.00 วินาที 73.9 MBytes 620 Mbits / วินาที
 [10] 5.00-6.00 วินาที 86.4 MBytes 724 Mbits / วินาที
 [SUM] 5.00-6.00 วินาที 227 MBytes 1.90 Gbits / วินาที
 - - - - - - - - - - - - - - - - - - - - - - - - -
 [4] 6.00-7.00 วินาที 35.4 MBytes 297 Mbits / วินาที
 [6] 6.00-7.00 วินาที 32.1 MBytes 269 Mbits / วินาที
 [8] 6.00-7.00 วินาที 80.9 เมกะไบต์ 678 Mbits / วินาที
 [10] 6.00-7.00 วินาที 78.5 MBytes 658 Mbits / วินาที
 [SUM] 6.00-7.00 วินาที 227 MBytes 1.90 Gbits / วินาที

ฉันเห็น spikes สูงถึง 2.5 Gbps และต่ำสุดที่ 1.3 Gbps

อัปเดตจาก Twitter

ดังนั้นฉันได้รับข้อเสนอแนะจาก @jvallery ที่ฉันต้องลอง ความเร็วของเครือข่ายระหว่างภูมิภาค Azure เชื่อมต่อกับ Peering เครือข่ายเสมือนเป็นอย่างไร สิ่งแรกที่ฉันทำคือการชนกับอินสแตนซ์ที่มีอยู่ของฉันไปยัง D64sv3 และใช้ -P 64 ผมเห็นการเพิ่มขึ้นอย่างมีนัยสำคัญ

iperf3.exe -c 10.0.3.4 -w32M -P 64 -t 30

[SUM] 0.00-1.00 วินาที 2.55 กิกะไบต์ 21.8 Gbits / วินาที

จากนั้นฉันได้หมุนเวียนอินสแตนซ์ F72v2 บางอย่างตามที่แนะนำไว้และเห็นผลลัพธ์ที่ดียิ่งขึ้น

iperf3.exe -c 10.0.2.5 -w32M -P 72 -t 30

[SUM] 0.00-1.00 วินาที 2.86 กิกะไบต์ 24.5 Gbits / วินาที

  ฉันไม่ค่อยเชี่ยวชาญใน Linux ดูเหมือนว่าจะมีแบนด์วิธที่เหมาะสมระหว่างภูมิภาค Azure เมื่อใช้เครือข่าย peered ถ้ามีคนต้องการทำซ้ำการทดสอบนี้โดยใช้ Linux เป็น @jvallery แนะนำผมจะยินดีที่จะโพสต์ผลลัพธ์ของคุณที่นี่! ดูเหมือนว่าจะมีความเป็นไปได้ที่จะเปลี่ยนแปลงความเร็วของเครือข่ายระหว่างภูมิภาค Azure ที่เชื่อมต่อกับ Peering เครือข่ายเสมือนจริง

การใช้ SIOS DataKeeper สำหรับการกู้คืนภัยพิบัติ

สำหรับลูกค้ารายใดรายหนึ่งของฉันฉันเลือกที่จะใช้ทั้งสองเครือข่าย peered เพื่อแก้ไขปัญหาการกู้คืนความเสียหายของ SQL Server โดยใช้ SIOS DataKeeper เพื่อจำลองข้อมูล SQL ระหว่างกันในแบบอะซิงโครนัสสำหรับการกู้คืนระบบแบบอะซิงโครนัส

SIOS DataKeeper ทำซ้ำข้อมูลจาก Azure EAST US 2 ถึง CENTRAL US [/ caption]

ในสถานการณ์เฉพาะนี้เราได้วัด RPO ที่วัดได้เป็นมิลลิวินาที ดังที่คุณจะเห็นในวิดีโอด้านล่างในระหว่างการทดสอบ DISKSPD มีวัตถุประสงค์เพื่อจำลองภาระงาน SQL Server โดยทั่วไป RPO อยู่ที่ <1 วินาที ฉันต้องการรับฟังจากคุณเกี่ยวกับประสบการณ์ของคุณเกี่ยวกับความเร็วเครือข่ายที่คุณวัดใน Azure และวิธีที่คุณใช้เครือข่ายแบบ peered ใน Azure มีคำถามเกี่ยวกับความเร็วเครือข่ายระหว่างภูมิภาค Azure ที่เชื่อมต่อกับ Peering เครือข่ายเสมือนจริงหรือไม่? อ่านบล็อกของเราหรือติดต่อเรา! ทำซ้ำโดยได้รับอนุญาตจาก ClusteringForMereMortals.com
Filed Under: ทำให้เข้าใจง่ายเซิร์ฟเวอร์คลัสเตอร์ Tagged With: ความเร็วเครือข่าย, ความเร็วเครือข่ายระหว่างภูมิภาคสีฟ้าที่เชื่อมต่อกับเครือข่ายเสมือน peering, ภูมิภาค Azure, เครือข่ายเสมือน Peering

แปลงคลัสเตอร์ Azure ไปยังดิสก์ที่มีการจัดการ

กันยายน 11, 2018 by Jason Aw Leave a Comment

ทำไมคุณควรแปลงกลุ่มสีฟ้าเป็นดิสก์ที่มีการจัดการ

ทำไมคุณควรเปลี่ยนคลัสเตอร์ Azure ให้กับดิสก์ที่มีการจัดการ

คุณอาจเคยได้ยินเกี่ยวกับปัญหาการหยุดทำงานของพื้นที่จัดเก็บข้อมูลล่าสุดซึ่งส่งผลกระทบต่อบางกรณีในภูมิภาคอเมริกาตะวันออกในวันที่ 16 มีนาคม มีการโพสต์การวิเคราะห์สาเหตุของการหยุดทำงานที่นี่ 16 มีนาคมหน่วยเก็บข้อมูลตะวันออกของสหรัฐฯ

ผลกระทบจากลูกค้า

กลุ่มย่อยของลูกค้าที่ใช้พื้นที่เก็บข้อมูลในภูมิภาคอเมริกาตะวันออกอาจมีข้อผิดพลาดและหมดเวลาในขณะที่เข้าถึงบัญชีพื้นที่เก็บข้อมูลของตนในหน่วยเก็บข้อมูลพื้นที่เดียว คุณอาจจะถามว่า "หน่วยจัดเก็บข้อมูลขนาดเดียวคืออะไร" ดีคุณสามารถคิดเป็นกลุ่มการจัดเก็บเดียวหรือ SAN เดียวหรืออย่างไรก็ตามคุณต้องการคิดเกี่ยวกับเรื่องนี้ ฉันไม่คิดว่า Azure เผยแพร่โครงสร้างพื้นฐานที่แน่นอนของพวกเขา แม้ว่าคุณอาจจะคิดว่าเบื้องหลังพวกเขาใช้ Scale Out File Servers สำหรับการจัดเก็บแบ็กเอนด์

รอดตายด้วยการหยุดทำงานน้อยที่สุด

คำถามก็คือฉันจะมีชีวิตรอดได้อย่างไรด้วยการหยุดทำงานน้อยที่สุด? ถ้าคุณอ่านต่อไปว่าการวิเคราะห์รากสาเหตุคุณพบว่านักเก็ตตัวเล็ก ๆ คนนี้

เครื่องเสมือนที่ใช้ดิสก์ที่มีการจัดการในชุดความพร้อมใช้งานจะมีความพร้อมใช้งานในระหว่างเหตุการณ์นี้ ดังนั้นจึงถึงเวลาที่ต้องแปลงคลัสเตอร์ Azure ไปยังดิสก์ที่มีการจัดการ

ดิสก์ที่มีการจัดการอย่างไร?

เมื่อวันที่ 8 กุมภาพันธ์ Corey Sanders ประกาศ GA ของ Managed Disks ดิสก์ที่มีการจัดการจะช่วยในการหยุดทำงานนี้ เนื่องจากโดยการใช้ชุดค่าว่างพร้อมกับไดรฟ์ที่มีการจัดการแต่ละอินสแตนซ์ในชุดความพร้อมใช้งานของคุณจะเชื่อมต่อกับ "หน่วยจัดเก็บข้อมูลขนาดใหญ่" ที่แตกต่างกัน ดังนั้นในกรณีนี้เฉพาะหนึ่งโหนดคลัสเตอร์จะล้มเหลวออกจากโหนดที่เหลือเพื่อรับภาระงาน ก่อนที่ดิสก์มีการจัดการจะพร้อมใช้งาน (ไม่มีอะไรที่นำมาใช้ก่อนวันที่ 2/8/2016) ไม่มีวิธีใดที่จะทำให้มั่นใจได้ว่าพื้นที่จัดเก็บข้อมูลที่แนบกับเซิร์ฟเวอร์ของคุณจะอาศัยอยู่กับหน่วยจัดเก็บข้อมูลที่แตกต่างกัน แน่นอนว่าคุณสามารถใช้บัญชีที่เก็บข้อมูลต่างๆกันได้สำหรับแต่ละกรณี แต่ในความเป็นจริงไม่ได้รับประกันว่า Storage Accounts จะจัดเตรียมพื้นที่จัดเก็บข้อมูลไว้ในหน่วยจัดเก็บข้อมูลขนาดต่างๆ เหตุผลอื่น ๆ ในการแปลงคลัสเตอร์ Azure ไปยังดิสก์ที่มีการจัดการ ดังนั้นในขณะที่ชุดความพร้อมใช้งานทำให้แน่ใจได้ว่าอินสแตนซ์ของคุณอาศัยอยู่ในโดเมนฟอลต์ที่แตกต่างกันและอัปเดตโดเมนเพื่อให้แน่ใจว่ามีอินสแตนซ์ตัวเองอยู่แล้วพื้นที่เก็บข้อมูลเพิ่มเติมที่แนบมากับแต่ละอินสแตนซ์จริงๆถือว่าเป็นจุดล้มเหลวเพียงจุดเดียว แม้ว่าตัวเก็บข้อมูลจะมีความยืดหยุ่นสูงมีสำเนาข้อมูลและตัวเลือกสำรองข้อมูลทางภูมิศาสตร์ 3 ชุดในกรณีนี้ที่มีการสูญเสียพลังงานหน่วยเก็บข้อมูลทั้งหมดที่จัดเก็บลงไปพร้อมกับเซิร์ฟเวอร์ทั้งหมดที่เชื่อมต่ออยู่ เรื่องยาวดังนั้นสั้น … แปลงกลุ่ม Azure ไปยังดิสก์ที่มีการจัดการโดยเร็วที่สุดเพื่อช่วยลดการหยุดทำงาน https://docs.microsoft.com/en-us/azure/virtual-machines/virtual-machines-windows-migrate-to จัดการดิสก์และถ้าคุณต้องการลดเวลาหยุดทำงานคุณควรพิจารณาการนำ Cloud Deployment ของ Hybrid ซึ่งครอบคลุมผู้ให้บริการระบบคลาวด์หรือระบบเติมเงินให้เมฆ! ทำซ้ำโดยได้รับอนุญาตจาก Clusteringformeremortals.com

Filed Under: ทำให้เข้าใจง่ายเซิร์ฟเวอร์คลัสเตอร์ Tagged With: Fault Doma, ชุดการมีจำหน่าย, หน่วยเก็บข้อมูลที่เก็บข้อมูล, อัปเดตโดเมน, แปลงกลุ่มสีฟ้าไปยังดิสก์ที่มีการจัดการ, ไดรฟ์ที่มีการจัดการ

Cloud Witness สร้าง SQL Server Failover Cluster ใน SQL Server แบบหลายกรณี

กันยายน 10, 2018 by Jason Aw Leave a Comment

คุณสมบัติ Azure ILB ใหม่ช่วยให้คุณสามารถสร้างคลัสเตอร์ล้มเหลว SQL Server แบบหลายกรณีใน Azure

คุณสมบัติ Azure ILB ใหม่ช่วยให้คุณสามารถสร้างคลัสเตอร์ล้มเหลว SQL Server แบบหลายกรณีใน Azure

คุณลักษณะใหม่ Cloud Witness เป็นที่ชื่นชอบในขณะนี้ ก่อนที่เราจะดูที่คุณลักษณะใหม่ขององค์ประชุมใน Windows Server 2016 ฉันคิดว่าสิ่งสำคัญคือต้องรู้ว่าเรามาจากที่ใด ในบทความก่อนหน้าของฉันการทำความเข้าใจเกี่ยวกับองค์รวมของเซิร์ฟเวอร์ Windows Server 2003 ในคลัสเตอร์ Windows Server 2012 ฉันเข้าสู่รายละเอียดบางอย่างเกี่ยวกับประวัติและวิวัฒนาการของ quorum ของคลัสเตอร์ ขอแนะนำให้คุณตรวจสอบว่าโพสต์เข้าใจว่าโควรัมทำงานได้อย่างไรใน Windows Server 2012 R2 นอกจากนี้คุณลักษณะใหม่ ๆ ของ Windows Server 2016 จะทำให้การปรับใช้คลัสเตอร์ของคุณมีความยืดหยุ่นมากขึ้นได้อย่างไร

พยานเมฆ

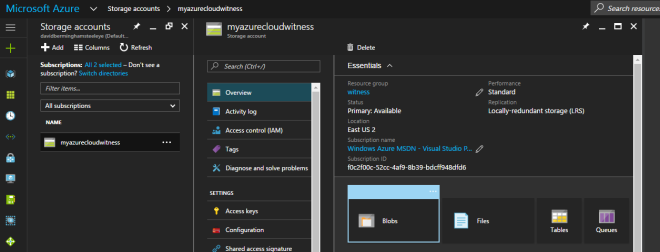
พยาน Cloud ช่วยให้คุณสามารถใช้ Azure Blob Storage เพื่อทำหน้าที่เป็นพยานให้กับกลุ่มของคุณได้ พยานคนนี้จะอยู่ในสถานที่ของพยานดิสก์หรือแบ่งปันไฟล์พยาน การกำหนดค่าของ Cloud Witness ทำได้ง่ายมาก จากประสบการณ์ของฉันค่าใช้จ่ายถัดไปไม่มีอะไรที่จะเป็นเจ้าภาพใน Azure ข้อเสียเพียงอย่างเดียวคือโหนดคลัสเตอร์จะต้องสามารถสื่อสารผ่านอินเทอร์เน็ตได้ด้วย Azure Blob Storage ของคุณ บ่อยครั้งที่โหนดคลัสเตอร์ห้ามไม่ให้สื่อสารกับอินเทอร์เน็ตสาธารณะ ดังนั้นคุณจะต้องประสานงานกับทีมรักษาความปลอดภัยของคุณหากคุณต้องการเปิดใช้งาน Cloud Witness มีเหตุผลที่น่าสนใจมากมายสำหรับการใช้ Cloud Witness เพื่อสร้างคลัสเตอร์ล้มเหลวของ SQL Server แบบหลายอินสแตนซ์ใน Azure แต่สำหรับฉันมันทำให้รู้สึกมากที่สุดในสามสภาพแวดล้อมที่เฉพาะเจาะจงมาก: Failover Cluster ใน Azure, Branch Office Clusters และ Multisite Clusters

เมื่อมองใกล้

ลองดูที่แต่ละสถานการณ์เพื่อดูว่า Cloud Witness สามารถช่วยได้อย่างไร รูปที่ 1 – เมื่อคุณกำลังพยายามสร้าง SQL Serveคุณลักษณะ ILB ใหม่สำหรับคลัสเตอร์ Failover SQL Server แบบหลายอินสแตนซ์ใน Azurer Failover Cluster แบบหลายอินสแตนซ์ใน Azure บัญชีเก็บข้อมูลระบบคลาวด์ควรได้รับการกำหนดค่าที่เก็บข้อมูลแบบ redundant Storage ตามปกติ (LRS) [/ คำอธิบาย]
การใช้งานที่มีการใช้งานสูง

หากคุณกำลังย้ายไปที่ Azure (หรือผู้ให้บริการระบบคลาวด์จริงๆ) คุณจะต้องการให้แน่ใจว่าการปรับใช้ของคุณมีให้ใช้งานได้มาก หากคุณกำลังดำเนินการเกี่ยวกับ SQL Server, File Servers, SAP หรือภาระงานอื่น ๆ ที่รวมกลุ่มกันแบบคลัสเตอร์กับ Windows Server Failover Clustering คุณจะต้องใช้พยานแชร์ไฟล์หรือ Cloud Witness เนื่องจากไม่สามารถใช้ Disk Witness ใน Azure ได้ ด้วย Windows Server 2012 R2 หรือ Windows Server 2008 R2 คุณจะต้องใช้ Share Share Share กับ Witness Windows Server 2016 ทำให้สามารถใช้ Cloud Witness ได้ ข้อได้เปรียบของ Cloud Witness คือคุณไม่จำเป็นต้องรักษาอินสแตนซ์อื่นของ Windows ใน Azure เพื่อโฮสต์ไฟล์แชร์ แต่ Microsoft ช่วยให้คุณสามารถใช้ประโยชน์จากพื้นที่เก็บข้อมูลแบบหยดได้  วิธีนี้จะช่วยให้คุณได้รับโซลูชันที่มีราคาไม่แพงซึ่งเป็นวิธีที่ง่ายในการจัดการและยืดหยุ่นมากขึ้น

ที่ตั้ง

เมื่อมองไปที่การปรับใช้คลัสเตอร์ในสำนักงานสาขาค่าใช้จ่ายและการบำรุงรักษาอยู่เสมอพิจารณา สำหรับห่วงโซ่การค้าปลีกที่มีสถานที่นับร้อยหรือหลายพันแห่งการมี SAN ในแต่ละตำแหน่งอาจเป็นสิ่งที่ต้องห้ามปราม แต่ละตำแหน่งอาจเรียกใช้โหนดคลัสเตอร์ Hyper-V สองโหนดในคอนฟิกูเรชันที่ผสานรวม Hyper-S2D หรือโซลูชันการจำลองแบบของ บริษัท อื่นเพื่อโฮสต์เครื่องเสมือนหลายเครื่อง ตอนนี้สิ่งที่ Cloud Witness สามารถทำได้คือช่วยให้ธุรกิจหลีกเลี่ยงค่าใช้จ่ายในการเพิ่มเซิร์ฟเวอร์ทางกายภาพเพิ่มเติมในแต่ละตำแหน่งเพื่อทำหน้าที่เป็น Share Share Share หรือเพิ่มต้นทุนในการเพิ่ม SAN ไปยังสถานที่แต่ละแห่ง

ขจัดความต้องการศูนย์ข้อมูลที่ 3

และในที่สุดเมื่อใช้งานกลุ่มแบบหลายกลุ่ม Cloud Witness ช่วยลดความจำเป็นในการเป็นศูนย์กลางข้อมูลที่ 3 เพื่อเป็นเจ้าภาพจัดการแชร์ไฟล์ ก่อนที่จะมีการนำ Cloud Witness แนวทางที่ดีที่สุดจะชี้ให้เห็นว่าพยานแชร์ไฟล์อาศัยอยู่ในตำแหน่งที่ 3 การเข้าถึงดาต้าเซ็นเตอร์อันดับที่ 3 เพื่อเป็นเจ้าภาพในการเป็นพยานร่วมกันของไฟล์ไม่ได้เป็นไปได้เสมอไปและยังได้นำเสนออีกหนึ่งชั้นของความซับซ้อน การใช้ Cloud Witness ทำให้คุณไม่จำเป็นต้องรักษาตำแหน่งที่ตั้งที่ 3 และสามารถเข้าถึงพยานได้จากอินเทอร์เน็ตสาธารณะลดความต้องการของเครือข่ายด้วย

การรับรู้ไซต์

เมื่อสร้างกลุ่ม multisite มีปัญหาอื่น ๆ อยู่เสมอ การควบคุม failover เพื่อให้เหมาะกับไซต์ในท้องถิ่นเป็นไปไม่ได้ แม้ว่าคุณจะสามารถระบุเจ้าของที่ต้องการได้การตั้งค่าเจ้าของที่ต้องการจะเข้าใจผิดโดยทั่วไป ผู้ดูแลระบบอาจไม่ได้ตระหนักถึงสิ่งนี้ แต่คุณรู้หรือไม่แม้ว่าจะไม่ได้ระบุเซิร์ฟเวอร์ว่าเป็น Preferred Owner เซิร์ฟเวอร์จะถูกผนวกโดยอัตโนมัติไปยังจุดสิ้นสุดของรายการ Preferred Owners ที่จัดทำโดยคลัสเตอร์ ผลลัพธ์ของความเข้าใจผิดนี้คือแม้ว่าคุณอาจระบุเฉพาะเซิร์ฟเวอร์ภายในเครื่องเป็น Preferred Owners คุณอาจมี failover ทรัพยากรคลัสเตอร์ไปยังไซต์ DR และนี่คือแม้กระทั่งเมื่อมีโหนดที่สมบูรณ์แบบที่ดีที่มีอยู่ในไซต์ท้องถิ่น เห็นได้ชัดว่านี่ไม่ใช่สิ่งที่คุณคาดหวังและการใช้การรับรู้ไซต์จะช่วยขจัดปัญหานี้ให้ก้าวไปข้างหน้า การรับรู้ไซต์ช่วยแก้ปัญหานี้ได้โดยเลือกไซต์ท้องถิ่นเสมอเมื่อตัดสินใจเลือกโหนดเพื่อนำทางออนไลน์ ดังนั้นในกรณีปกติภาระงานที่คลัสเตอร์จะเข้าแทนที่โหนดภายในเสมอจนกว่าคุณจะหยุดทำงานโดยสมบูรณ์ ในกรณีที่หนึ่งในโหนด DR จะมาออนไลน์ เดียวกันถือเป็นจริงเมื่อคุณกำลังทำงานอยู่ในไซต์ DR คลัสเตอร์จะกู้คืนปริมาณงานบนเซิร์ฟเวอร์ในไซต์ DR ถ้าทำงานก่อนหน้านี้บนโหนดในไซต์ DR การรับรู้ไซต์มักจะชอบโหนดภายใน

โดเมนข้อบกพร่อง

การสร้างความตระหนักในไซต์เป็นโดเมนฟอรัม โดเมนข้อบกพร่องจะไปอีกขั้นและช่วยให้คุณสามารถกำหนดตำแหน่งโหนด Chasse และ Rack นอกเหนือจากไซต์ได้ โดเมนข้อบกพร่องมีประโยชน์สามประการคือความเกี่ยวข้องกับการจัดเก็บในกลุ่มแบบยืดอายุการเก็บข้อมูลที่เพิ่มขึ้นทำให้พื้นที่เก็บข้อมูลมีความยืดหยุ่นเพิ่มขึ้น ช่วยเพิ่มการแจ้งเตือนเกี่ยวกับบริการสุขภาพโดยการรวมข้อมูลเมตาเกี่ยวกับตำแหน่งของแหล่งข้อมูลที่เกี่ยวข้องซึ่งเป็นการปลุก ความเกี่ยวข้องในการจัดเก็บจะช่วยให้แน่ใจได้ว่ากลุ่มงานและพื้นที่เก็บข้อมูลของคุณทำงานอยู่ในตำแหน่งเดียวกัน คุณไม่ต้องการให้ VM อ่านและเขียนข้อมูลที่อยู่ใน CSV ในเมืองอื่น อย่างไรก็ตามผมคิดว่าผู้ชนะที่ใหญ่ที่สุดในที่นี้คือ Space Space Storage (S2D) SD2 จะใช้ประโยชน์จากข้อมูลที่คุณระบุเกี่ยวกับตำแหน่งของคลัสเตอร์โหนด (ไซต์แร็คแชสซี) เพื่อให้แน่ใจว่าสำเนาข้อมูลที่เขียนขึ้นเพื่อความซ้ำซ้อนทั้งหมดจะอยู่ในโดเมนฟอรัมที่แตกต่างกัน ช่วยให้แน่ใจได้ว่าการจัดวางข้อมูลได้รับการปรับให้เหมาะสมเพื่อให้ความล้มเหลวของ Single Node, Chassis, Rack หรือ Site ไม่สามารถลดการใช้งาน S2D ทั้งหมดได้  คอสมอสดาร์วินมีวิดีโอยอดเยี่ยมในช่อง 9 ซึ่งอธิบายถึงแนวคิดนี้อย่างละเอียด

สรุป

Windows Server 2016 เพิ่มการปรับปรุงใหม่ ๆ ให้กับองค์รวมของคลัสเตอร์ซึ่งจะให้ประโยชน์ในทันทีกับการปรับใช้คลัสเตอร์ของคุณ นอกจากนี้โปรดตรวจสอบการปรับปรุงคลัสเตอร์ใหม่ ๆ ที่น่าสนใจอื่น ๆ เช่นการปรับรุ่นระบบกลิ้ง, ความยืดหยุ่นของเครื่องเสมือน, Workgroup และกลุ่มโดเมนหลายแห่งและอื่น ๆ หากต้องการอ่านเกี่ยวกับเคล็ดลับอื่น ๆ เช่นการสร้าง SQL Server Failover Cluster In-One แบบหลายอินสแตนซ์ใน Azure กับ Cloud Witness โปรดอ่านบทความของเรา ทำซ้ำโดยได้รับอนุญาตจาก Clusteringformeremortals.com

Filed Under: ทำให้เข้าใจง่ายเซิร์ฟเวอร์คลัสเตอร์ Tagged With: Load Balance, PowerShell, Windows Server 2012, การทำซ้ำ, การปรับใช้, ตัวจัดการการกำหนดค่าระบบศูนย์, ผู้จัดการทรัพยากร Azure, พยานเมฆ, เซิร์ฟเวอร์ SQL หลายอินสแตนซ์

S2D สำหรับ SQL Server Failover Cluster Instances 

กันยายน 8, 2018 by Jason Aw Leave a Comment

พื้นที่จัดเก็บข้อมูลโดยตรง (S2D) สำหรับอินสแตนซ์คลัสเตอร์ของ SQL Server Failover Cluster

พื้นที่เก็บข้อมูลโดยตรงสำหรับ SQL Server Failover Cluster Instances

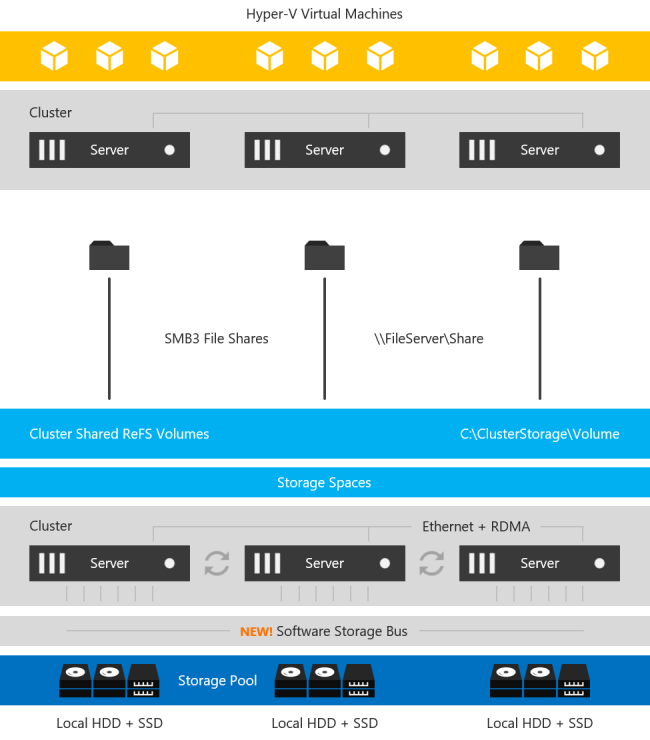
ด้วยการนำเสนอ Windows Server 2016 Datacenter Edition คุณลักษณะใหม่ที่เรียกว่า Storage Spaces Direct (S2D) ในระดับที่สูงมาก S2D สำหรับอินสแตนซ์คลัสเตอร์ล้มเหลวของ SQL Server ช่วยให้คุณสามารถรวมแอ็ตทริบิวต์ที่เก็บอยู่ในระบบและนำเสนอไปยังคลัสเตอร์เป็น CSV เพื่อใช้ใน Scale Out File Server จากนั้นจะสามารถเข้าถึงได้ผ่าน SMB 3 และใช้เพื่อเก็บข้อมูลคลัสเตอร์เช่นไฟล์ Hyper-V VMDK นอกจากนี้ยังสามารถกำหนดค่าในรูปแบบ Hyper-converged (HCI) เพื่อให้แอ็พพลิเคชันและข้อมูลสามารถทำงานได้บนชุดเซิร์ฟเวอร์เดียวกัน  นี่เป็นคำอธิบายง่ายกว่าที่เข้าใจง่าย แต่สำหรับรายละเอียดคุณจะต้องการดูที่นี่

พื้นที่เก็บข้อมูลกองโดยตรง ภาพที่ถ่ายจาก https://docs.microsoft.com/th-th/windows-server/storage/storage-spaces/storage-spaces-direct-overview กรณีการใช้งานหลักที่กำหนดเป้าหมายเป็นโครงสร้างพื้นฐานแบบ hyper-converged สำหรับการใช้งาน Hyper-V อย่างไรก็ตามมีกรณีการใช้งานอื่น ๆ รวมถึงการใช้ประโยชน์จากพื้นที่จัดเก็บ SMB นี้เพื่อจัดเก็บข้อมูล SQL Server เพื่อใช้ในอินสแตนซ์ของคลัสเตอร์ล้มเหลวของ SQL Server

ทำไมทุกคนต้องการทำอย่างนั้น?

ดีสำหรับตอนเริ่มต้นคุณสามารถสร้าง SQL Server Failover Cluster Instance (2) โหนด SQL Server Edition (FCI) พร้อม SQL Server Standard Edition ได้โดยไม่ต้องใช้ที่เก็บข้อมูลที่ใช้ร่วมกัน ก่อนหน้านี้ถ้าคุณต้องการ HA โดยไม่ใช้ SAN คุณจะได้รับสิทธิซื้อ SQL Server Enterprise Edition และใช้ Always On Availability Groups หรือซื้อ SIOS DataKeeper และใช้โซลูชันของ บริษัท อื่นซึ่งช่วยให้คุณสามารถสร้างกลุ่ม SANless กับ Windows หรือ Windows รุ่นใดก็ได้ SQL Server SQL Server Enterprise Edition สามารถขับค่าใช้จ่ายของโครงการของคุณได้โดยเฉพาะอย่างยิ่งหากคุณซื้อเฉพาะสำหรับคุณลักษณะกลุ่มการมีส่วนร่วมเท่านั้น นอกเหนือจากค่าใช้จ่ายที่เกี่ยวข้องกับกลุ่มความพร้อมใช้แล้วมีสาเหตุทางเทคนิคอื่น ๆ อีกหลายประการที่ทำให้คุณอาจต้องการ Failover Cluster ผ่าน AG ความเข้ากันได้ของแอ็พพลิเคชันเช่นกับการป้องกันระดับฐานข้อมูลฐานข้อมูลจำนวนมากการสนับสนุน DTC พนักงานที่ผ่านการฝึกอบรม ฯลฯ เป็นเพียงเหตุผลทางเทคนิคบางประการที่คุณอาจต้องการติดตั้ง Failover Cluster Instance

โซลูชัน DataScheeper ของ SIOS กับ S2D สำหรับอินสแตนซ์คลัสเตอร์ล้มเหลวของ SQL Server 

Microsoft แสดงทั้งโซลูชัน SIOS DataKeeper และโซลูชัน S2D เป็นสองโซลูชันที่สนับสนุนสำหรับ SQL Server FCI ในเอกสารของตนที่นี่ S2D สำหรับ SQL Server Failover Cluster Instances  https://docs.microsoft.com/en-us/azure/virtual-machines/windows/sql/virtual-machines-windows-sql-high-availability-dr เมื่อเปรียบเทียบสองโซลูชันนี้คุณต้องคำนึงถึงว่า SIOS ได้อนุญาตให้คุณสร้าง SANless Clusters ตั้งแต่ปี 2542 แต่ S2D สำหรับ SQL Server Failover Cluster Instances ยังอยู่ในวัยเด็ก  มีกล่าวว่ามีขอบเขตเป็นบางพื้นที่ที่ S2D มีบาง catching ถึงทำ. หรือเพียงแค่คุณลักษณะที่พวกเขาไม่เคยสนับสนุนเพียงเพราะข้อ จำกัด ของเทคโนโลยี

ก่อนที่จะเลือกโซลูชันคลัสเตอร์ SANless ของคุณ

ดูตารางต่อไปนี้เพื่อดูภาพรวมของสิ่งที่คุณควรพิจารณาก่อนที่คุณจะเลือกโซลูชันคลัสเตอร์ SANless ของคุณ S2D สำหรับ SQL Server Failover Cluster Instances  ถ้าเราดูกราฟนี้เราจะเห็นว่า SIOS DataKeeper มีข้อได้เปรียบที่สำคัญอย่างชัดเจน สำหรับหนึ่ง DataKeeper สนับสนุนช่วงกว้างมากของแพลตฟอร์มไปตลอดทางกลับไปที่ Windows Server 2008 R2 และ SQL Server 2008 R2 โซลูชัน S2D รองรับเฉพาะรุ่นล่าสุดของ Windows และ SQL Server 2016/2017 เท่านั้น นอกจากนี้ S2D ยังต้องการ Windows Datacenter Edition ซึ่งจะช่วยเพิ่มค่าใช้จ่ายในการติดตั้งของคุณได้เป็นอย่างมาก นอกจากนี้ SIOS ยังให้บริการโซลูชัน HA / DR สำหรับ SQL Server บน Linux ที่ใช้งานได้ทั้งบน prem และในระบบคลาวด์

การวิเคราะห์ความแตกต่าง

แต่นอกเหนือจากข้อ จำกัด ด้านค่าใช้จ่ายและแพลตฟอร์มฉันคิดว่าช่องว่างที่แจ่มชัดที่สุดเกิดขึ้นเมื่อเราเริ่มพิจารณาตัวเลือกการกู้คืนระบบสำหรับกลุ่ม SANless ของคุณ Allan Hirt, guru กลุ่ม SQL Server และเพื่อน Microsoft Cloud และ Datacenter Management MVP โพสต์เมื่อเร็ว ๆ นี้เกี่ยวกับข้อ จำกัด S2D นี้ ในบทความของเขา Revisiting Storage Space ตรงและ SQL Server FCIs Allan ชี้ให้เห็นว่าเนื่องจากการขาดการสนับสนุนสำหรับการยืดกลุ่ม S2D ข้ามไซต์หรือรวมกลุ่มที่ใช้ S2D เป็นส่วนหนึ่งของ Always On Availability Group ตัวเลือกที่ดีที่สุดสำหรับ DR ใน สถานการณ์ S2D เป็น log shipping! อย่าทำให้ฉันผิด การจัดส่งบันทึกได้รับรอบตลอดไปและอาจจะเป็นรอบนานหลังจากที่ฉันไป แต่นั่นก็เป็นก้าวที่ยิ่งใหญ่เมื่อเราคิดถึงโซลูชันการกู้คืนระบบทั้งหมดที่เราคุ้นเคยเช่นกลุ่มไซต์หลายแห่งกลุ่มความพร้อมใช้งาน ฯลฯ ตรงกันข้ามโซลูชั่น SIOS DataKeeper รองรับ Always On Availability Groups ยังดีกว่า – สามารถช่วยให้คุณสามารถยืด FCI ข้ามไซต์เพื่อให้ได้โซลูชัน HA / DR ที่ดีที่สุดที่คุณอาจหวังว่าจะบรรลุในแง่ของ RTO / RPO ในสภาพแวดล้อม Azure DataKeeper ยังสนับสนุน Azure Site Recovery (ASR) ทำให้คุณมีทางเลือกมากขึ้นในการกู้คืนระบบ ส่วนที่เหลือของแผนภูมินี้เป็นคำอธิบายที่น่าสนใจ โดยทั่วไปจะประกอบด้วยฮาร์ดแวร์รายการความต้องการในการเก็บข้อมูลและระบบเครือข่ายที่ต้องได้รับก่อนที่คุณจะสามารถใช้งานกลุ่ม S2D ได้ มีการเก็บรักษารายการข้อกำหนด S2D อย่างละเอียดไว้ที่นี่  https://docs.microsoft.com/en-us/windows-server/storage/storage-spaces/storage-spaces-direct-hardware-requirements

SIatus Datakeeper อะไรดี

โซลูชั่น SIOS DataKeeper มีมากขึ้นผ่อนปรน สนับสนุนการจัดเก็บข้อมูลที่แนบมาภายในเครื่องและตราบเท่าที่ฮาร์ดแวร์ผ่านการตรวจสอบคลัสเตอร์เป็นการกำหนดค่าคลัสเตอร์ที่สนับสนุน โซลูชันการจำลองแบบระดับบล็อกทำงานได้ดีตั้งแต่ 1 Gbps ถือว่าเป็น LAN ที่รวดเร็วและการเชื่อมต่อ T1 WAN ถือเป็นความหรูหรา การจัดกลุ่มแบบไม่ใช้ SAN เป็นสิ่งที่น่าสนใจอย่างยิ่งสำหรับการใช้งานระบบคลาวด์ ระบบคลาวด์ไม่ได้เสนอทางเลือกในการจัดเก็บข้อมูลแบบเดิมสำหรับกลุ่ม ดังนั้นสำหรับผู้ใช้ที่อยู่ตรงกลางของ "ยกและเปลี่ยน" ไปยังคลาวด์ที่ต้องการนำกลุ่มของพวกเขาเข้ากับพวกเขาพวกเขาต้องมองหาโซลูชันการจัดเก็บสำรอง สำหรับการใช้งานระบบคลาวด์ SIOS ได้รับการรับรองสำหรับ Azure, AWS และ Google และพร้อมให้บริการในตลาดคลาวด์ที่เกี่ยวข้อง แม้ว่าจะไม่มีอะไรที่ขัดขวางการใช้งานกลุ่มที่ใช้ S2D ใน Azure หรือ Google แต่ก็มีข้อบกพร่องที่ชัดเจนในเอกสารเกี่ยวกับเอกสารหรือคำชี้แจงสนับสนุนจาก Microsoft สำหรับแพลตฟอร์มเหล่านั้น

สร้างทางเลือกที่ปลอดภัย

SIOS DataKeeper ทำเช่นนี้ตั้งแต่ปี 2542 SIOS ได้ฟังคำขอคุณลักษณะทั้งหมดเปิดเผยข้อบกพร่องทั้งหมดและมีโซลูชันแบบ solid solid สำหรับกลุ่ม SANless ที่ผ่านการทดสอบและพิสูจน์แล้ว ในขณะที่ Microsoft S2D เป็นเทคโนโลยีที่มีแนวโน้มว่าจะเป็นผลิตภัณฑ์รุ่นที่ 1 ฉันจะรอจนกว่าฝุ่นจะตกลงและช่องว่างบางช่องว่างจะปิดก่อนที่ฉันจะพิจารณาการใช้งานที่สำคัญทางธุรกิจของฉัน

หากต้องการทราบข้อมูลเพิ่มเติมเกี่ยวกับ S2D สำหรับ SQL Server Failover Cluster Instances โปรดดูที่นี่ SIOS DataKeeper ทำซ้ำโดยได้รับอนุญาตจาก Clusteringformeremortals.com

Filed Under: Datakeeper, ทำให้เข้าใจง่ายเซิร์ฟเวอร์คลัสเตอร์ Tagged With: s2d สำหรับอินสแตนซ์ของคลัสเตอร์ failover เซิร์ฟเวอร์ sql, SIOS, SQL Server Failover Cluster

อินสแตนซ์ของคลัสเตอร์ล้มเหลวของ SQL Server แบบไม่มีเงื่อนไขใน Google Cloud Platform

กันยายน 7, 2018 by Jason Aw Leave a Comment

วิธีการสร้างอินสแตนซ์ของคลัสเตอร์ failover cluster ของเซิร์ฟเวอร์แบบไม่มีคลัสเตอร์ในแพลตฟอร์ม Google Cloud

วิธีการสร้างอินสแตนซ์คลัสเตอร์ล้มเหลวของ SQL Server แบบไม่ใช้ Sanless ใน Google Cloud Platform

หากคุณต้องการโฮสต์ SQL Server บน Google Cloud Platform (GCP) คุณจะต้องการให้แน่ใจว่าสามารถใช้งานได้อย่างเต็มที่ หนึ่งในวิธีที่ดีที่สุดและประหยัดที่สุดในการทำเช่นนี้คือการสร้างอินสแตนซ์ของคลัสเตอร์ล้มเหลวของ SQL Server ใน Google Cloud Platform

ต้นทุนที่มีประสิทธิภาพ

เนื่องจาก SQL Server Standard Edition สนับสนุน Failover Clustering เราจึงสามารถหลีกเลี่ยงค่าใช้จ่ายที่เกี่ยวข้องกับ SQL Server Enterprise Edition ซึ่งจำเป็นสำหรับ Always On Availability Group นอกจากนี้ SQL Server Failover Clustering เป็นโซลูชันที่มีประสิทธิภาพมากขึ้นเนื่องจากปกป้องทั้ง SQL Server ไม่มีข้อ จำกัด ในแง่ของการสนับสนุน DTC (Distributor Transaction Coordinator) และง่ายต่อการจัดการ นอกจากนี้ยังสนับสนุนเวอร์ชันก่อนหน้าของ SQL Server ที่คุณยังคงมีอยู่เช่น SQL 2012 ผ่าน SQL 2017 ล่าสุด ไม่สนับสนุน SQL 2008 R2 เนื่องจากไม่มีการสนับสนุน failover ข้ามซับเน็ต

อะไรที่แตกต่างกันกับ Datacontrol SIOS?

ตามเนื้อผ้า SQL Server FCI ต้องการให้คุณมี SAN หรืออุปกรณ์จัดเก็บข้อมูลที่ใช้ร่วมกันบางประเภท ในระบบคลาวด์ไม่มีที่เก็บข้อมูลแชร์ที่รู้จักกันแบบคลัสเตอร์ แทนที่ SAN เราจะสร้างคลัสเตอร์ SANless โดยใช้ SIOS DataKeeper Cluster Edition (DKCE) DKCE ใช้การจำลองแบบระดับบล็อกเพื่อให้แน่ใจว่าที่จัดเก็บข้อมูลที่แนบมาเฉพาะในแต่ละอินสแตนซ์จะยังคงซิงค์กันอยู่ นอกจากนี้ยังทำงานร่วมกับ Windows Server Failover Clustering ผ่านทรัพยากรชั้นเก็บข้อมูลของตัวเองที่เรียกว่า DataKeeper Volume ซึ่งใช้แทนทรัพยากรดิสก์ทางกายภาพ เท่าที่คลัสเตอร์เป็นห่วงปริมาณ SIOS DataKeeper ดูเหมือนดิสก์ทางกายภาพ แต่แทนที่จะควบคุมการจอง SCSI ควบคุมทิศทางของกระจกเพื่อให้แน่ใจว่ามีเพียงเซิร์ฟเวอร์ที่ใช้งานอยู่เท่านั้นที่เขียนลงในดิสก์และเซิร์ฟเวอร์ passive จะได้รับการเปลี่ยนแปลงทั้ง synchronously หรือ asynchronously

เริ่มต้นใช้งานอินสแตนซ์คลัสเตอร์ล้มเหลวของ SQL Server แบบ Sanless ใน Google Cloud Platform

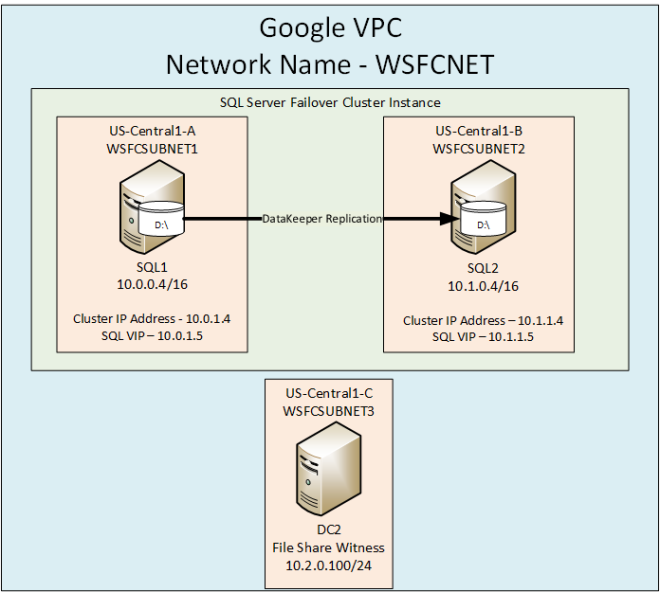
ในคู่มือนี้เราจะดำเนินขั้นตอนในการสร้างคลัสเตอร์ failover 2 โหนดระหว่างสองอินสแตนซ์ในภูมิภาคเดียวกัน แต่ในโซนต่างๆภายใน GCP ดังแสดงในรูปที่ 1 อินสแตนซ์ของคลัสเตอร์ล้มเหลวของ SQL Server แบบไม่มีเงื่อนไขใน Google Cloud Platform หากต้องการข้อมูลเพิ่มเติมเกี่ยวกับอินสแตนซ์ของคลัสเตอร์ Failover Cluster ของ Sanless ในแพลตฟอร์ม Google Cloud โปรดดาวน์โหลดเอกสารสีขาวทั้งhttps://us.sios.com/sios-resources/white-paper-build-sql-server-failover-cluster-gcp/หมดที่  ค้นหาข้อมูลเพิ่มเติมเกี่ยวกับ SIOS DataKeeper ทำซ้ำได้รับอนุญาตจาก Clusteringformeremortals.com

Filed Under: Datakeeper, ทำให้เข้าใจง่ายเซิร์ฟเวอร์คลัสเตอร์ Tagged With: ตัวอย่างเช่นการจัดกลุ่มการแยกย่อย, เซิร์ฟเวอร์คลัสเตอร์ล้มเหลวแบบคลัสเตอร์ sql ในแพลตฟอร์ม Google Cloud

  • « Previous Page
  • 1
  • …
  • 88
  • 89
  • 90
  • 91
  • 92
  • …
  • 112
  • Next Page »

โพสต์ล่าสุด

  • ระบบความพร้อมใช้งานสูง (High Availability หรือ HA) คืออะไร?
  • เอาตัวรอดจากวิกฤตการณ์วันศุกร์: จากระบบคอมพิวเตอร์แบบดิบๆ สู่การจำลองข้อมูลที่ราบรื่น
  • ติดดิน: สิ่งที่การพลาดชม Percona Live Amsterdam สอนฉันเกี่ยวกับ HA
  • เปรียบเทียบ SIOS LifeKeeper กับ Red Hat High Availability Add-On:
  • สถานะของความยืดหยุ่นของแอปพลิเคชัน: ผลสำรวจความพร้อมใช้งานสูงของ SIOS ปี 2026

กระทู้ยอดนิยม

เข้าร่วมรายชื่อผู้รับจดหมายของเรา

Copyright © 2026 · Enterprise Pro Theme on Genesis Framework · WordPress · Log in